temperature 0 으로 두 번 돌렸더니 93문항 중 28문항의 근거가 바뀌었는데, 합계는 그대로였습니다
temperature 0, seed 0 으로 같은 설정을 하루 간격으로 두 번 돌렸습니다. 93문항 중 28문항에서 LLM 이 근거로 고른 조문·판례가 바뀌었고, 11문항에서 예/아니오 결론이 바뀌었습니다. 그런데 합계는 46 → 46, 43 → 42 였습니다. 문항은 3분의 1 가까이 흔들렸는데 합계는 거의 그대로였습니다.
이 측정 덕분에 설정 묶음끼리 2~3문항 차이 난 결과를 '차이'로 말하지 않기로 했습니다. 어떻게 쟀고 어떤 규칙을 남겼는지 정리합니다.
설정을 바꿀 때마다 점수가 2~3문항씩 움직였습니다
자사 영상 콘텐츠용으로 노동법 예/아니오 질문 100문항 시험지를 만들었습니다. 채점 대상은 99문항입니다. 로컬 LLM 에 법령·판례 검색을 붙인 자사 법령 질의응답 측정 도구로, 설정을 한 번에 하나씩 바꿔 가며 돌렸습니다.
같은 시험지로 검색 모델을 바꿔 가며 잰 기록은 따로 정리해 두었습니다.
모델은 Gemma 4 26B-A4B 이고, LM Studio 로 로컬에서 실행했습니다. 설정 묶음끼리 '정답 조문을 근거로 댔나' 점수를 비교하니 62 · 63 · 60 처럼 몇 문항씩 오르내렸습니다. 영상에서 '이 설정이 더 낫다'고 말하려면 그 몇 문항이 진짜 차이인지부터 알아야 했습니다.
설정을 그대로 두고 하루 뒤 한 번 더 돌렸습니다
방법은 단순합니다. 아무것도 바꾸지 않은 같은 설정 묶음을 한 번 더 돌리고, 두 회차를 문항 단위로 맞대 봤습니다. 조건은 아래와 같습니다.
프롬프트·검색 방식·데이터·모델 모두 동일
temperature 0, seed 0, 동시 요청 3
하루 간격으로 두 번 실행
두 회차 모두 정상으로 답한 93문항만 비교 (첫 회차에서 6문항은 실행 실패로 빠짐)
결론 채점은 서로의 판정을 모르는 채점자 둘이 매기고, 둘이 다르게 본 칸은 우리 시스템에 불리한 쪽으로 처리
LLM 이 근거로 고른 조문·판례 목록을 여기서는 '근거 카드'라고 부릅니다. 근거 카드는 순서까지 같아야 같은 것으로 셌습니다.
비교 항목 | 두 회차가 같았던 문항 | 바뀐 문항 | 합계 (1회차 → 2회차) |
|---|---|---|---|
근거 카드 (순서 포함) | 65 / 93 | 28 | 정답 조문 46 → 46 |
예/아니오 결론 | 82 / 93 | 11 | 결론 맞음 43 → 42 |
설정을 하나도 안 바꿨는데 근거 카드는 문항의 30%, 결론은 12% 가 바뀌었습니다. 합계 차이는 0~1 이었습니다.
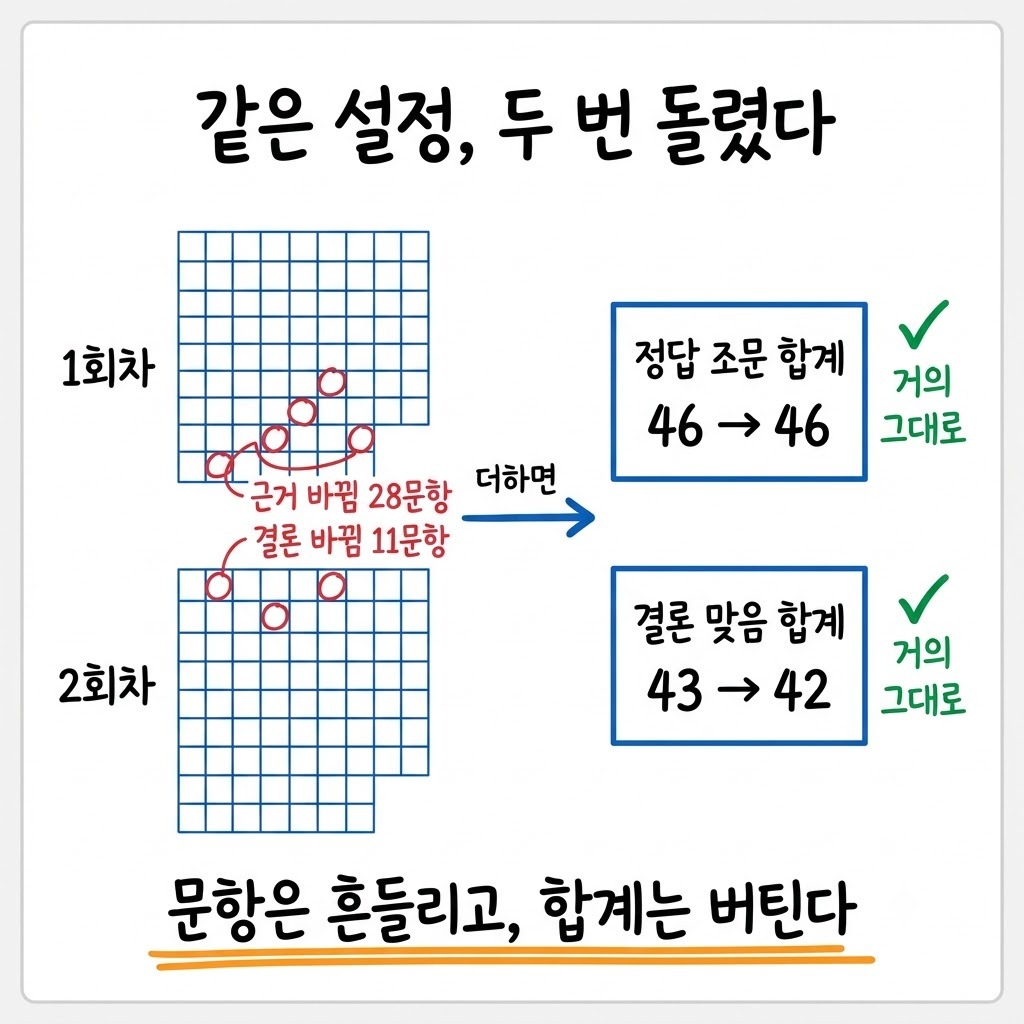
합계만 봤다면 '재현된다'고 적었을 겁니다
합계 46 → 46 만 보면 이 시스템은 재현이 잘 되는 것처럼 보입니다. 실제로는 문항 단위 변화가 서로 상쇄돼서 합계가 남은 것입니다. 한 회차에서 맞힌 문항 몇 개를 다른 회차에서 틀리고, 틀렸던 다른 문항 몇 개를 맞히면 합계는 그대로입니다.
이걸 모르고 합계만 봤다면 '재현된다'고 판정했을 겁니다. 그 판정을 믿고 '이 문항은 새 설정 덕분에 맞혔다'고 한 문항씩 짚었다면, 그 설명은 근거가 없었을 겁니다. 같은 설정에서도 그 문항은 바뀔 수 있기 때문입니다.
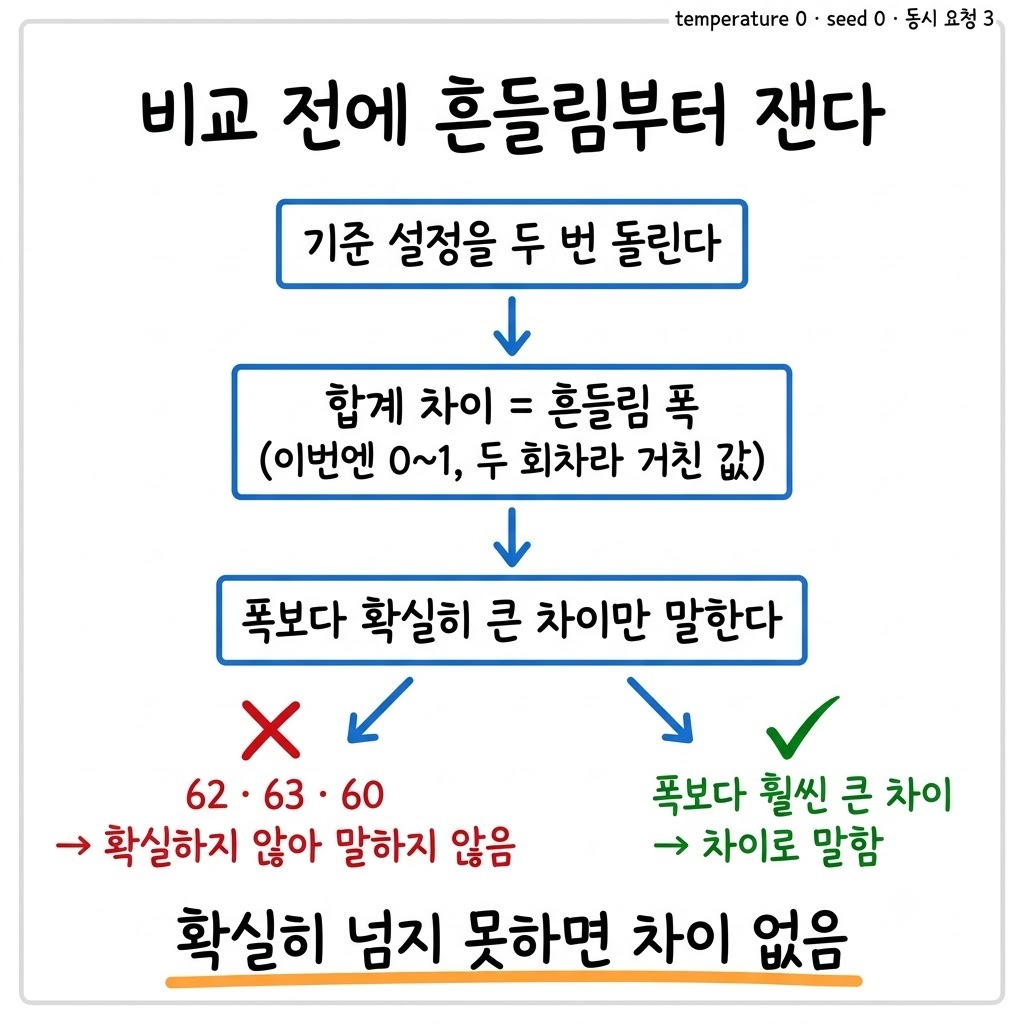
설정 묶음끼리의 62 · 63 · 60 도 같은 눈으로 다시 봤습니다. 같은 설정 두 번의 합계 흔들림은 0~1 이었습니다. 숫자로는 2~3 이 더 크지만, 회차가 둘뿐이라 이 폭은 거친 값이고 문항 단위로는 28문항이 흔들렸습니다. 2~3문항 차이가 흔들림을 확실히 넘는다고 말할 근거가 없었습니다. 그래서 영상과 결과 정리에서 이 차이를 '어느 설정이 낫다'는 근거로 쓰지 않았습니다.
temperature 0 은 같은 답의 보장이 아니었습니다
temperature 0 과 seed 고정이면 같은 입력에 같은 출력이 나올 거라고 생각하기 쉽습니다. 이번 측정에서는 그렇지 않았습니다. 같은 질문, 같은 검색 결과를 받아도 LLM 이 고르는 근거와 결론이 달라졌습니다.
원인은 확인하지 않았습니다. 후보로 보는 것은 둘입니다. 하나는 동시 요청을 묶어 한 번에 처리하는 방식이고, 다른 하나는 GPU 수치 연산의 비결정성(같은 계산도 더하는 순서에 따라 끝자리가 달라지는 성질)입니다. 동시 요청을 1 로 두고 두 번 돌려 보지는 않았으므로, 어느 쪽인지는 아직 모릅니다.
LLM 출력이 흔들려서 일일 정리 본문을 코드로 되돌린 적도 있습니다.
그래서 정한 규칙 넷
설정끼리 비교하기 전에 **같은 설정을 한 번 더 돌려 흔들림 폭부터 잽니다.** 그 폭을 확실히 넘지 못하는 차이는 '차이 없음'으로 말합니다
문항 하나를 짚어 '이 설정 때문에 맞혔다'고 말하지 않습니다. 같은 설정에서도 그 문항은 바뀔 수 있습니다
답의 흔들림 자체를 줄여야 하면 같은 문항을 여러 번 물어 다수결로 정합니다. 측정만 하려면 반복 회차를 돌리는 쪽이 비용이 덜 듭니다
동시 요청 수처럼 결과와 무관해 보이는 실행 설정도 결과 파일에 같이 기록합니다. 묶음 처리 크기가 수치에 영향을 줄 수 있습니다
4번은 바로 반영했습니다. 동시 요청 수를 환경 변수로 조절하게 바꾸고, 그 값을 결과 파일에 남기도록 했습니다. 설정끼리 조건을 맞추려고 값은 3으로 고정했습니다. 결과 정리 문서에는 '같은 설정 두 번의 흔들림' 절을 따로 넣었습니다.
이 측정이 말해 주지 못하는 것
회차가 2개뿐이라 흔들림 폭 0~1 은 거친 추정입니다. 회차를 늘리면 폭이 더 넓게 나올 수 있습니다
흔들림이 묶음 처리 때문인지 확인하지 않았습니다
한 모델·한 시험지·한 설정 묶음 기준입니다. 다른 조건에서도 폭이 같은지는 모릅니다
차이가 폭보다 훨씬 크면(예: 상용 모델과의 수십 문항 차이) 이 규칙은 결론을 바꾸지 않습니다. 문제는 몇 문항짜리 차이를 해석할 때입니다
문항을 짝지어 비교하는 통계 검정까지는 하지 않았고, 반복 회차로 폭을 보는 데서 멈췄습니다
프롬프트 A/B 에도, 검색기 교체에도 같은 순서입니다
이 순서는 노동법 시험지에만 해당하지 않습니다. 프롬프트를 A/B 로 비교할 때, RAG 검색기를 바꿀 때, 모델을 바꿀 때 모두 같습니다. 기준선을 두 번 돌리고, 흔들림 폭을 재고, 그 폭을 확실히 넘는 차이만 말합니다.
일반 소프트웨어 성능 측정에서 같은 빌드를 여러 번 재서 편차를 보는 것과 같은 이야기입니다. 100문항 규모 시험지에서는 2~3문항이 곧 2~3%p 입니다. 시험지가 작을수록 몇 문항짜리 우연을 개선으로 읽기 쉽습니다. 설정을 바꾸기 전에 아무것도 안 바꾼 회차를 한 번 더 넣어 두는 것을 권합니다.