일일 정리를 LLM에 통째로 맡기지 않은 이유 — 본문은 코드로 되돌렸습니다
매일 쌓이는 운영 활동을 자동으로 한 장으로 정리해주는 기능을 만들었습니다. 그날 끝난 작업, 바뀐 항목, 그 외 활동을 모아 markdown 한 파일로 남기는 기능입니다. 그런데 이 정리본은 단순 기록이 아니라, 이후 다른 작업의 1차 소스로 쓰입니다.
1차 소스라는 점이 핵심입니다. 여기서 날짜 하나, 건수 하나가 틀리면 그 위에 쌓는 모든 작업이 같이 틀어집니다. 그래서 "자연어로 매끄럽게"보다 "사실이 정확하게"가 훨씬 중요했습니다.
LLM에 통째로 맡기면 매끄럽지만, 사실이 흔들립니다
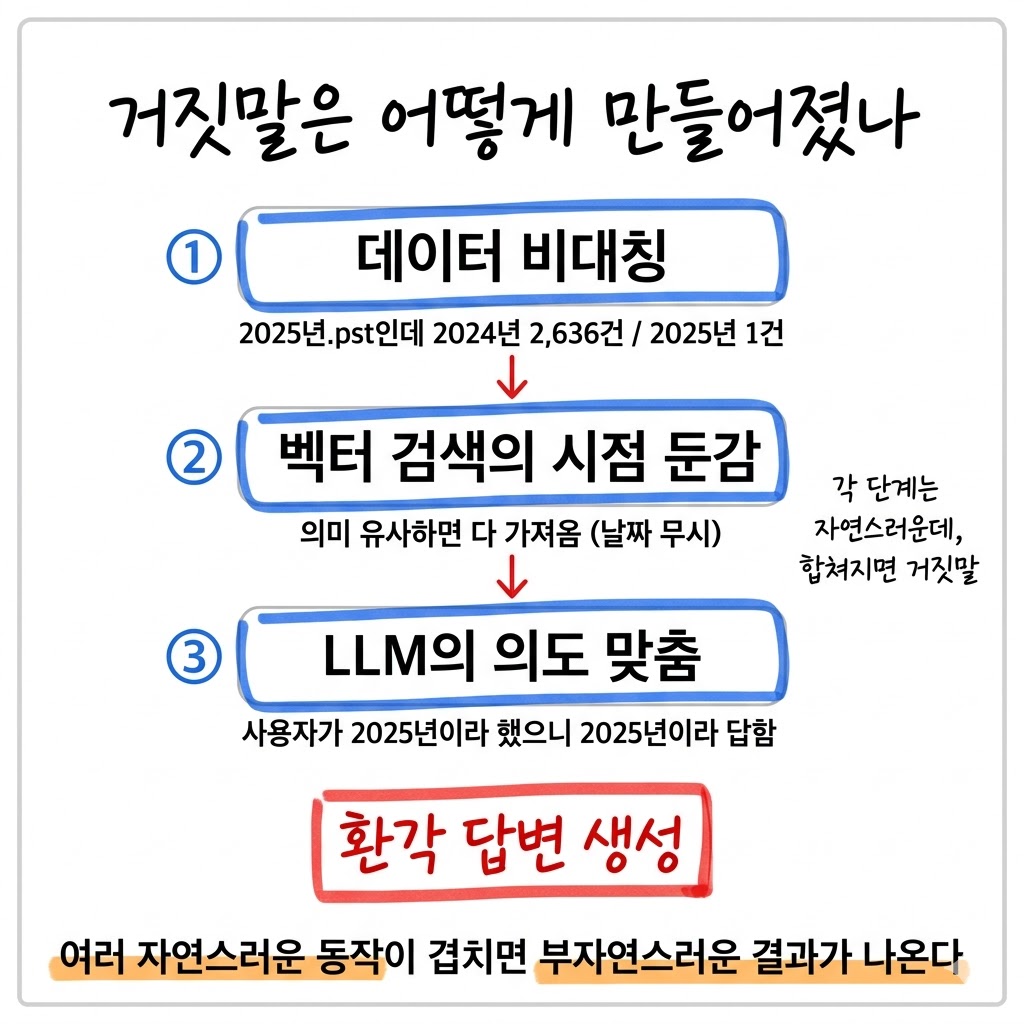
처음엔 LLM에게 데이터를 던지고 정리본을 통째로 써달라고 하는 방법을 생각했습니다. 자연어는 매끄럽게 나옵니다. 문제는 LLM이 사실을 그대로 보존하지 않는다는 점입니다.
비슷한 경험이 이미 있었습니다. "2025년 프로젝트 알려줘"라고 물었더니 LLM이 날짜를 슬쩍 1년 당겨 답한 적이 있습니다. 데이터와 질문 의도가 어긋날 때, LLM은 의도에 맞춰 사실을 살짝 바꾸는 성향이 있습니다.
1차 소스에서 이런 일이 벌어지면 치명적입니다. 매끄러운 문장 속에 틀린 숫자가 섞여 있으면, 검토하는 사람도 쉽게 잡아내지 못합니다.
세 가지 선택지를 두고 고민했습니다
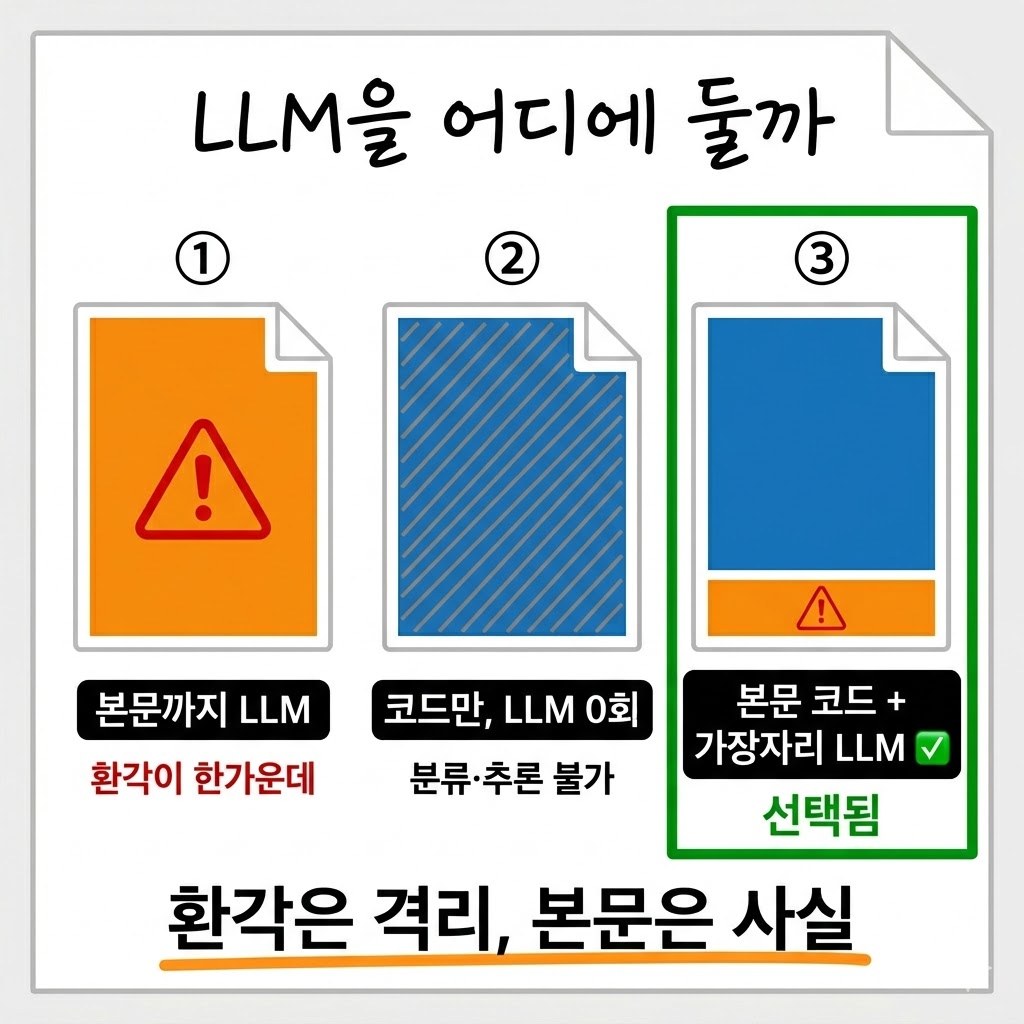
선택지는 세 가지였습니다.
1번은 LLM이 본문까지 다 쓰는 방식입니다. 표현은 자유롭지만 환각 위험이 본문 한가운데 박힙니다.
2번은 결정적 코드만 쓰고 LLM은 한 번도 부르지 않는 방식입니다. 환각은 0이지만, 노드를 분류하거나 "이건 글감이 될 만하다"고 라벨을 다는 추론은 못 합니다.
3번은 본문은 결정적 코드로 만들고, LLM은 가장자리에만 두는 방식입니다. 환각 위험을 본문 밖, 별도 섹션으로 격리하는 구조입니다. 결국 3번을 골랐습니다.
본문은 코드가, 해석은 LLM이 맡습니다
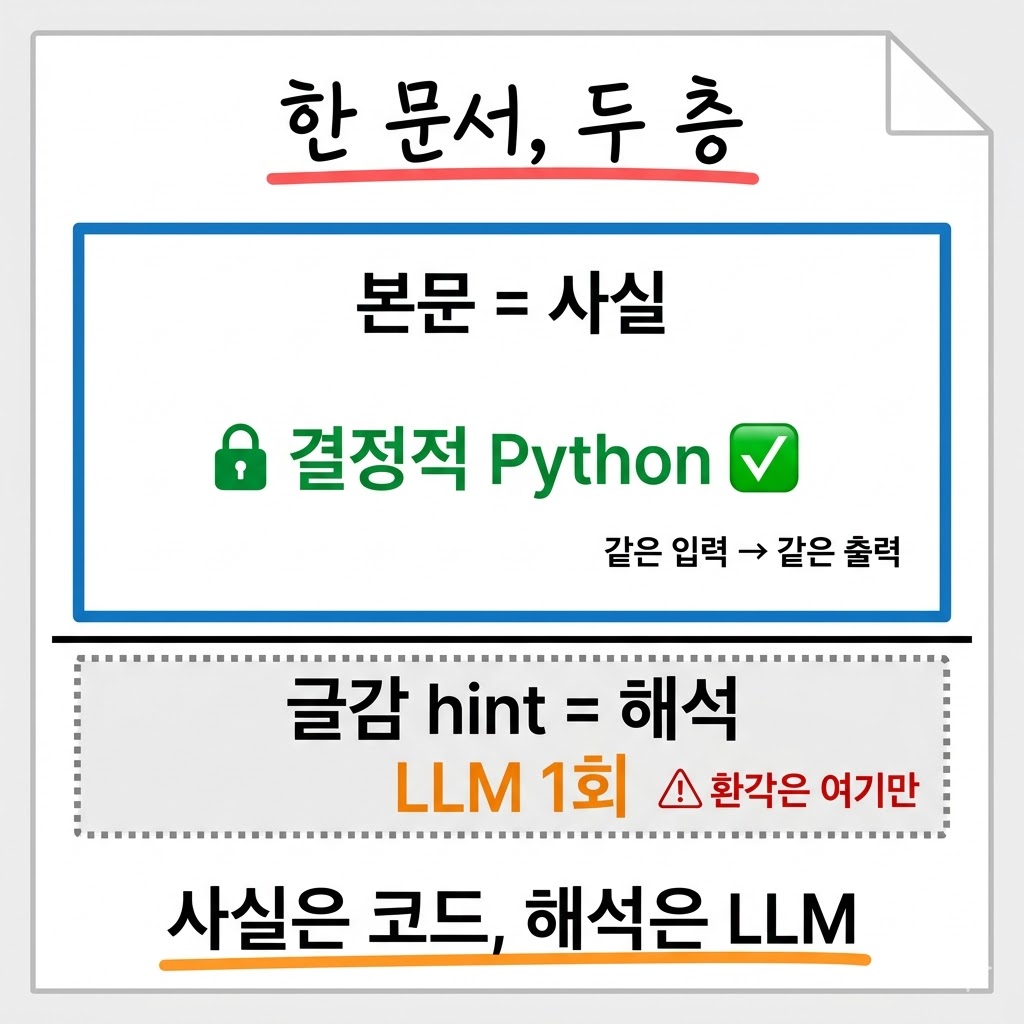
본문은 Python으로 결정적으로 만듭니다. 그날 끝난 작업, 변경된 항목, 기타 활동을 정해진 쿼리로 뽑아 정해진 포맷으로 찍습니다. 같은 입력이면 항상 같은 출력이 나옵니다.
LLM은 딱 한 번, "글감 후보" 섹션에서 노드를 분류하는 용도로만 부릅니다. 이 섹션에서 LLM이 헛소리를 해도, 본문의 사실은 영향을 받지 않습니다. 환각이 생길 수 있는 영역이 한 군데로 명확히 표시돼 있으니, 사람이 검토할 때도 거기만 집중하면 됩니다.
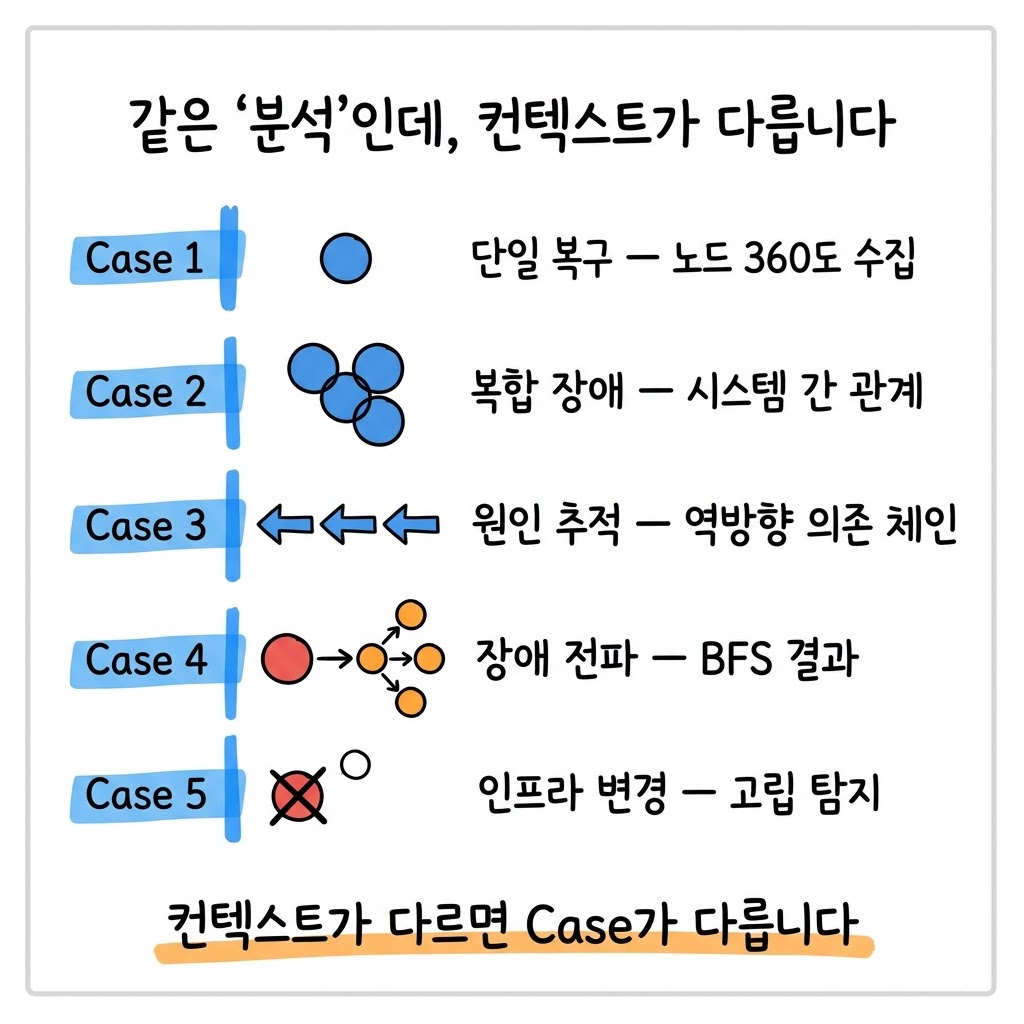
같은 원리로, 작업을 분기하고 컨텍스트를 모으는 일은 코드가, 판단만 LLM이 맡는 구조를 다른 곳에도 적용한 적이 있습니다.
동일 입력에 동일 출력이 보장되니 재생성도 안전합니다. 이미 파일이 있으면 기본은 충돌로 막고, 강제 재생성할 때만 머지합니다. 이때 사용자가 직접 적은 메모 영역과 후속 워크플로우가 남긴 마커는 그대로 보존합니다. 자동으로 다시 채우는 영역, 사람이 쓴 영역, 다음 작업이 남긴 흔적을 분리해 둔 셈입니다.
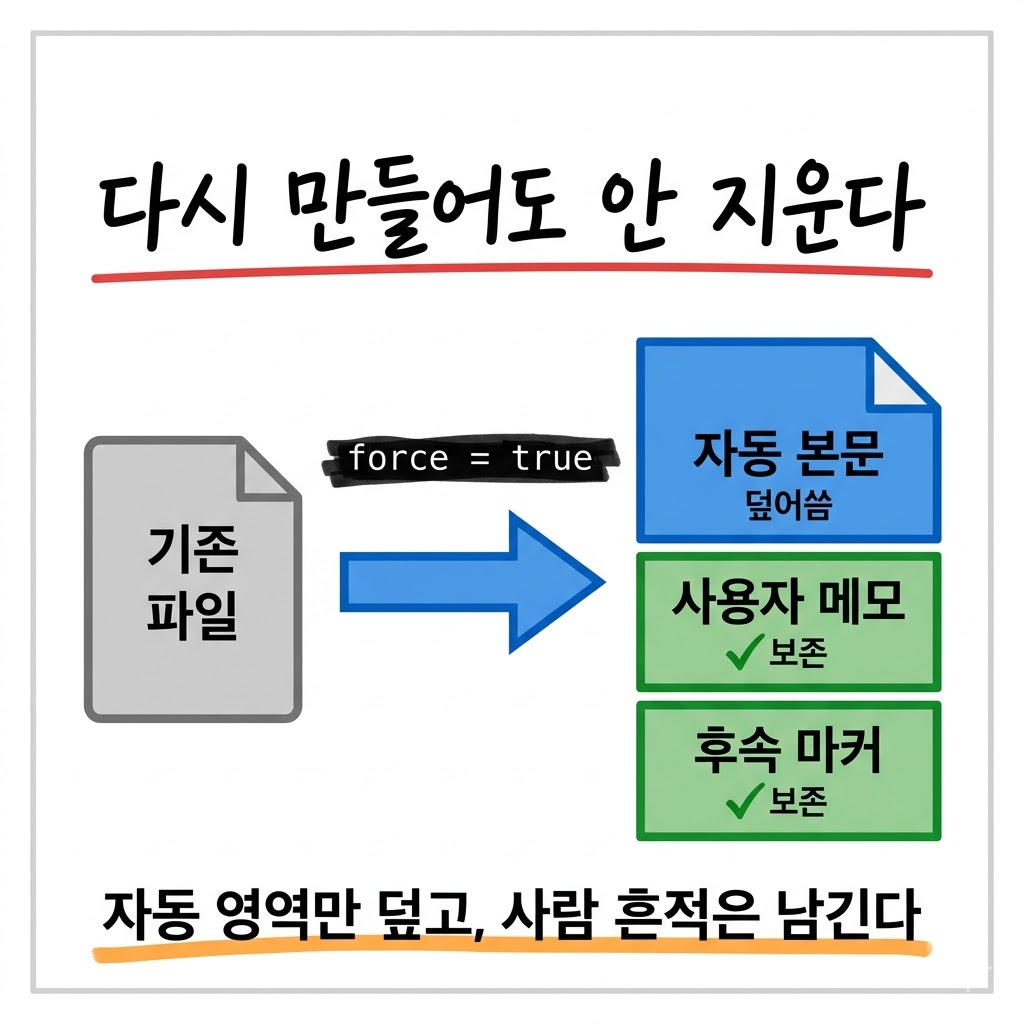
사실은 코드로, 해석은 LLM으로 나눕니다
이 설계의 핵심은 단순합니다. LLM의 가치는 자유로운 해석이고, 위험은 환각입니다. 둘은 같은 능력의 양면이라, 능력을 살리면서 위험만 떼어내려면 LLM을 둘 자리를 골라야 합니다.
사실 보존이 본질인 콘텐츠라면, 본문은 결정적 코드로 만들고 LLM은 가장자리(분류·요약·hint)에만 두는 게 안전합니다. 환각이 생겨도 격리된 섹션 안에 머물고, 사람의 검토도 그곳으로 모입니다.
추가로, 이 자동 생성 기능을 한 군데(공통 스킬)로 모으면 모든 LLM 호출이 자동으로 추적됩니다. 누가 언제 무엇을 생성했는지가 부산물로 남습니다. 비슷하게 시간 처리를 자동화하다 작성자 추적이 따라온 경험도 있습니다.
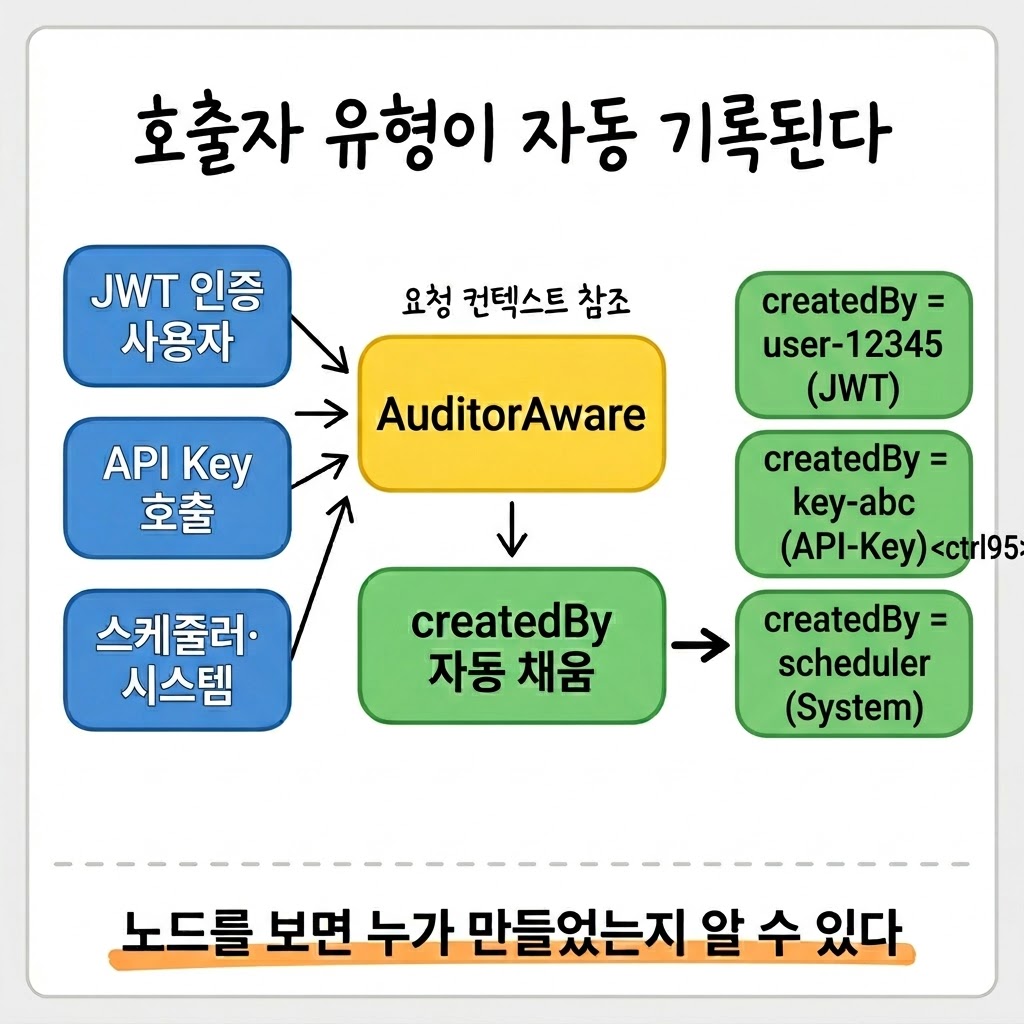
점검 체크리스트
자동 생성에 LLM을 어디까지 쓸지 정할 때 다음을 점검하면 환각 위험을 통제하기 쉽습니다.
이 콘텐츠는 사실 보존이 본질인가, 아니면 해석·창작이 본질인가
사실 영역과 해석 영역을 물리적으로 분리했는가 (섹션·파일 단위)
같은 입력에 같은 출력이 나오는가 (재생성 안전성)
재생성 시 사람이 쓴 영역과 자동 영역을 구분해 보존하는가
LLM 호출 지점이 한곳에 모여 추적 가능한가
빼는 게 아니라, 자리를 옮기는 결정입니다
LLM을 빼는 게 아니라, 둘 자리를 옮기는 결정이었습니다. 사실이 틀리면 안 되는 본문에서 LLM을 빼고, 분류와 hint라는 가장자리로 옮겼습니다. 그 결과 본문의 신뢰도는 코드가 보장하고, LLM의 자유로운 해석은 격리된 영역에서만 작동합니다. 사실 보존이 본질인 자동 생성이라면, LLM 역할을 본문 밖으로 미는 것만으로 환각 위험의 상당 부분이 사라집니다.