문서 파싱 띄어쓰기를 코퍼스에 물었더니, 제가 넣어둔 답이 돌아왔습니다
문서 검색 도구를 운영하면서 가장 설명하기 어려운 장애는 에러가 안 나는 장애입니다. 화면은 정상이고 로그도 깨끗한데, 분명히 그 문서에 있는 말을 검색하면 그 문서가 안 나옵니다. 사용자는 '검색이 좀 이상하다'고만 말하고, 그 말로는 어디를 봐야 할지 알 수 없습니다.
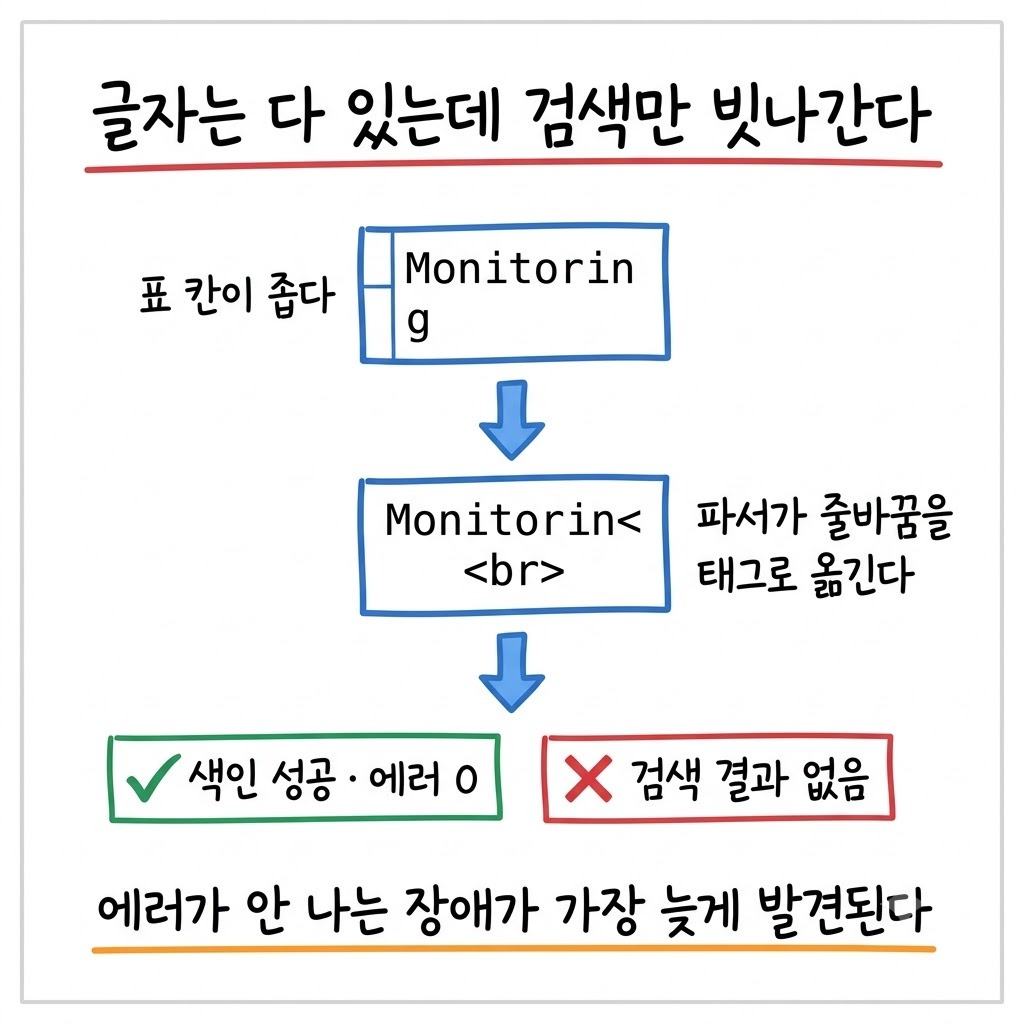
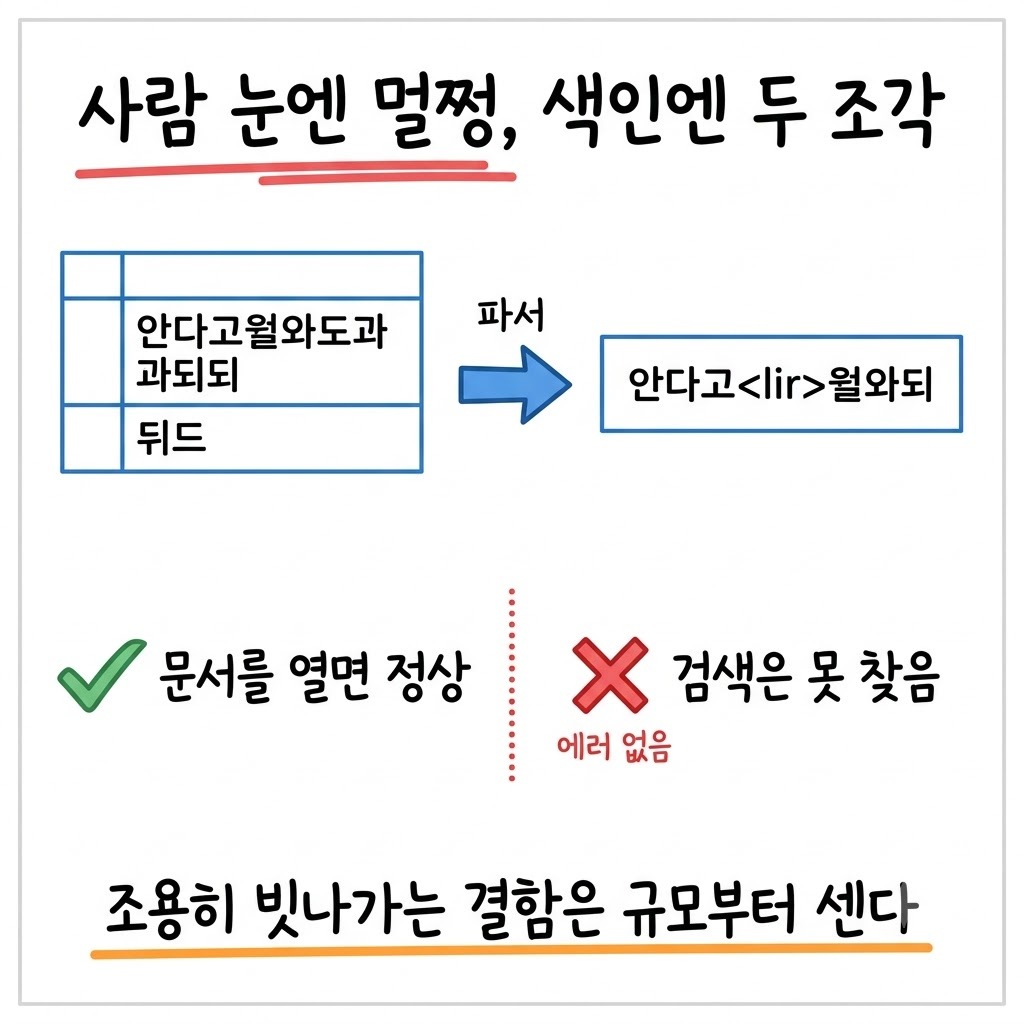
이번에 찾은 범인은 문서 파서였습니다. 한글 문서를 본문으로 바꿀 때, 표 칸이 좁아 두 줄로 줄바꿈된 자리를 파서가 `<br>` 태그로 옮깁니다. 그래서 낱말 한가운데가 갈립니다. 'Monitorin<br>g' 이 되고 '요구사항<br>고유번호' 가 됩니다. 글자는 하나도 없어지지 않았는데 검색어와 모양만 달라졌으니, 색인은 성공하고 검색만 조용히 빗나갑니다.
고칠 자리는 찾았는데 고치는 규칙이 안 나왔습니다
갈린 자리를 세어 보니 대상이 4,421곳이었습니다. 우리 쪽 색인에서 809청크(문서를 쪼갠 조각)·52문서, 같은 자를 쓸 예정이던 옆 프로젝트 색인에서 26,134청크·1,567문서였습니다. 규모는 금방 잡혔습니다. 문제는 그다음이었습니다.
태그를 무엇으로 바꿀지가 한 방향으로 안 풀립니다. 'Monitorin g' 는 붙여야 하고 'API Exchange' 는 띄워야 합니다. 둘 다 표 안에서 두 줄이 된 자리인데 정답이 반대입니다. 규칙을 머리로 정하려니 예시를 볼 때마다 결론이 바뀌었습니다.
그래서 코퍼스에 묻기로 했습니다. 갈린 자리를 붙인 형태와 띄운 형태로 각각 만들어, 같은 문서 더미 안에서 어느 쪽이 실제로 더 많이 쓰였는지 세는 방식입니다. 사람이 감으로 정하는 대신 데이터가 쓰고 있는 쪽을 따르자는 뜻이었습니다.
첫 결과가 너무 깨끗했습니다
처음 센 결과는 공백 70% · 붙이기 0% 였습니다. 받아들이기 좋은 숫자였습니다. 전부 공백으로 바꾸면 되고, 예외 처리도 필요 없다는 뜻입니다. 결론을 그대로 적고 넘어갈 수 있는 결과였습니다.
걸린 것은 70% 가 아니라 0% 였습니다. 4,421곳을 다 봤는데 붙여 쓴 사례가 하나도 없다는 것은, 사람이 쓴 문서 더미의 분포로는 너무 깨끗합니다. 영문 약어와 한글 복합명사가 섞인 문서에서 붙여 쓴 형태가 정확히 0 이 되기는 어렵습니다.
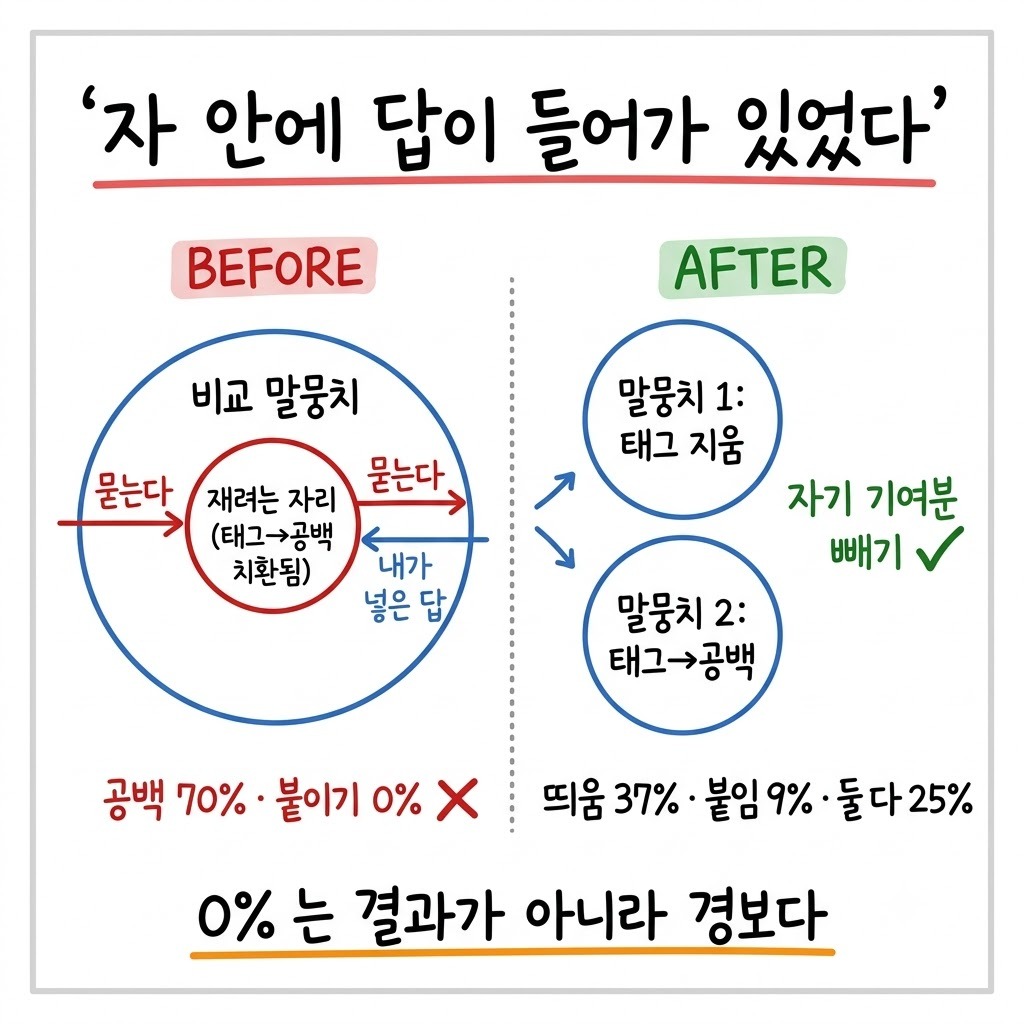
그래서 결과를 해석하는 대신 자를 뜯었습니다. 비교에 쓴 말뭉치를 어떻게 만들었는지 보니, 태그를 공백으로 바꾼 본문이었습니다. 즉 재려던 자리 자신이 이미 'a b' 형태로 말뭉치에 들어가 있었습니다. 띄운 형태가 당연히 있다는 답이 측정 전에 박혀 있었고, 붙인 형태는 어디에도 없으니 0 이 나올 수밖에 없었습니다.
재려는 대상이 자 안에 들어가 있으면 코퍼스는 제가 넣어둔 답을 그대로 돌려줍니다. 결과가 깨끗해서 다시 보지 않았다면 그 답을 근거로 4,421곳을 한 방향으로 고쳤을 겁니다.
자를 고치고 다시 세니 분포가 벌어졌습니다
고친 방식은 두 가지입니다. 말뭉치를 두 벌로 만들고, 갈린 자리 자신의 개수를 양쪽에서 뺐습니다.
비교 말뭉치를 두 벌 만듭니다 — 태그를 지운 것(붙인 형태가 들어 있는 벌)과 태그를 공백으로 바꾼 것(띄운 형태가 들어 있는 벌)
각 벌에서 세기 전에, 이번에 판정하려는 자리 자신이 만들어낸 개수를 뺍니다
남은 개수로만 어느 형태가 실제 문서에서 쓰이는지 비교합니다
다시 센 결과는 이렇게 갈렸습니다.
판정 | 자리 수 | 비율 |
|---|---|---|
띄워 쓴 사례만 있다 | 1,654곳 | 37% |
붙여 쓴 사례만 있다 | 377곳 | 9% |
둘 다 쓰인다 | 1,113곳 | 25% |
0% 가 9% 가 되고, 네 자리 중 하나는 둘 다 쓰인다는 애매한 칸으로 들어왔습니다. 처음 결과보다 지저분하지만 이쪽이 실제 분포입니다.
분포만으로 정하지 않았습니다
분포는 띄어쓰기로 기울었지만, 그것만으로 정하기에는 '둘 다 쓰인다' 가 25% 였습니다. 그래서 다른 근거를 하나 더 봤습니다. 틀렸을 때 어느 쪽이 더 아픈가입니다.
손해가 비대칭입니다. 붙여야 할 것을 띄우면 '컨설 턴트' 가 됩니다. 두 조각으로 쪼개졌어도 각 조각이 검색에 걸립니다. 반대로 띄워야 할 것을 붙이면 'APIExchange' 가 됩니다. 사전에도 없고 사용자가 치지도 않는 문자열이라 어디에도 안 걸립니다. 같은 확률로 틀려도 한쪽은 부분 적중이 남고 다른 쪽은 아무것도 안 남습니다.
분포와 손해를 같이 보고 공백으로 정했습니다. 코퍼스 투표만 믿은 결정은 아니었습니다. 오탈자가 다수인 코퍼스에서는 다수결이 오탈자를 고르니, 분포 하나만 근거일 때는 그 결정을 못 밀었을 겁니다.
적용은 파서를 다시 돌리지 않고 이미 색인된 본문만 고쳤습니다. 재파싱하면 비용을 들여 얻은 OCR 전사가 같이 지워집니다. 갈린 자리 809청크는 0 이 됐고, 회귀 검사는 15문항 중 15문항 통과를 유지했으며 나빠진 문항은 없었습니다.
이 파서 교체가 검색 품질을 어떻게 흔들었는지는 따로 정리해 뒀습니다.
같은 자를 넘겼더니 답이 정반대로 나왔습니다
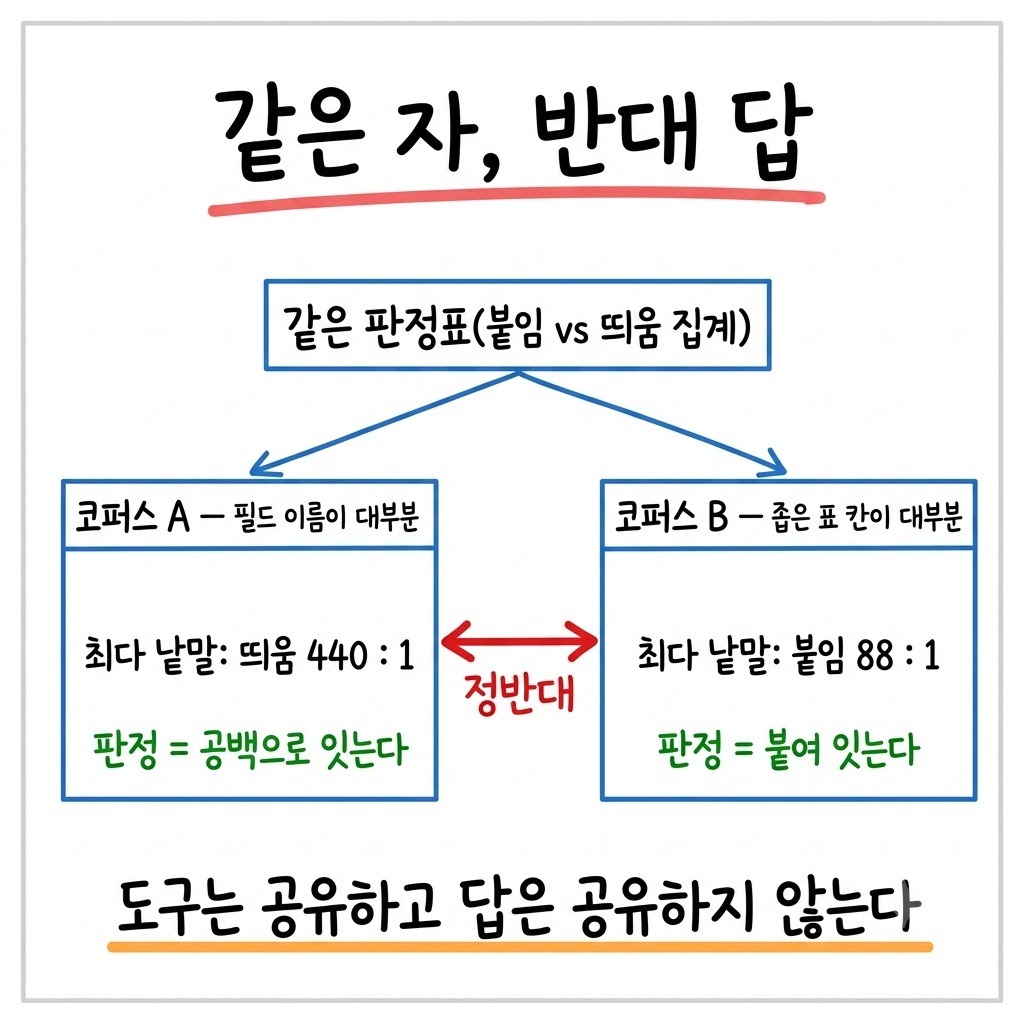
같은 판정표를 쓸 예정이던 옆 프로젝트에 자를 넘겼습니다. 이때 자만 넘기지 않고, 그 자가 한 번 틀렸던 방식까지 같이 적어 보냈습니다. 도구만 넘기면 받는 쪽이 같은 순환을 처음부터 다시 밟습니다.
그쪽 코퍼스에서 돌린 결과는 정반대였습니다. 우리 쪽에서 가장 많이 걸린 낱말은 띄워 쓴 쪽이 440:1 로 압도적이었는데, 그쪽에서 가장 많이 걸린 낱말은 붙여 쓴 쪽이 88:1 이었습니다. 우리 코퍼스는 원래 띄어 쓰는 필드 이름이 대부분이고, 그쪽은 표 칸이 좁아 두 줄이 된 자리가 대부분이었습니다.
판정표는 같이 쓸 수 있지만 답은 각자 코퍼스에 대 봐야 합니다. 한쪽 결론을 그대로 복사했으면 그쪽 색인은 지금보다 나빠졌을 겁니다.
다른 코퍼스에 대 보고 나서야 우리 쪽이 틀렸던 걸 알게 된 사례도 있었습니다.
측정 도구를 만들면 먼저 보는 것
이번 일에서 남은 점검 항목은 네 개입니다. 측정을 설계하는 자리면 어디든 같습니다.
재려는 대상이 이 도구 안에 들어가 있지 않은가 — 들어가 있으면 답은 측정 전에 정해져 있습니다
결과가 0% 나 100% 로 나왔으면 결과를 해석하기 전에 자를 봅니다. 실제 분포는 대개 그렇게 깨끗하지 않습니다
이게 아니라면 무엇이 보일까를 묻습니다. 똑같이 보인다면 그 검사는 아무것도 하지 않습니다
도구를 다른 팀에 넘길 때는 그 도구가 틀렸던 방식도 같이 넘깁니다. 답은 넘기지 않습니다
다만 극단값이 늘 오류인 것은 아닙니다. 진짜로 0 인 경우가 있고, 그때 자를 계속 의심하면 시간만 듭니다. 이번에 본 것도 '0 은 틀렸다' 가 아니라 '왜 0 인가' 까지였습니다. 그 질문에 자가 답을 미리 넣어뒀다는 설명이 붙었으니 자를 고친 것입니다.
순환 자체가 문제인 것도 아닙니다. 부트스트랩이나 자기 학습처럼 일부러 자기 출력을 입력으로 넣는 방법이 있습니다. 문제는 순환이 있다는 것을 모른 채 결과를 읽는 쪽입니다.
결과가 깨끗할 때가 가장 위험합니다
문제가 생기면 자를 의심하게 됩니다. 반대로 숫자가 바로 결론으로 이어지면 자를 보지 않고 결론부터 적습니다. 이번에 자를 다시 본 유일한 이유는 첫 결과가 너무 깨끗했다는 것이었습니다.
측정 도구를 만들었으면 결과를 읽기 전에 한 번은 거꾸로 봅니다. 이 도구가 이 답 말고 다른 답을 낼 수 있었는지입니다. 못 냈다면 그 도구는 측정이 아니라 제가 미리 적어둔 답을 되읽어 주는 장치입니다.