문서 파싱에서 갈린 낱말 4,421곳, 붙일지 띄울지를 코퍼스에 물어 정했습니다
사내 문서를 수집해 청크로 나누고 검색 색인에 넣는 일을 하고 있습니다. 표를 구조로 살려 읽는 공개 한글 문서 파서를 쓰는데, 이 파서는 칸이 좁아 줄바꿈된 자리를 줄바꿈 태그로 그대로 옮깁니다. 밑줄 같은 서식 태그도 낱말 한가운데에 들어갑니다.
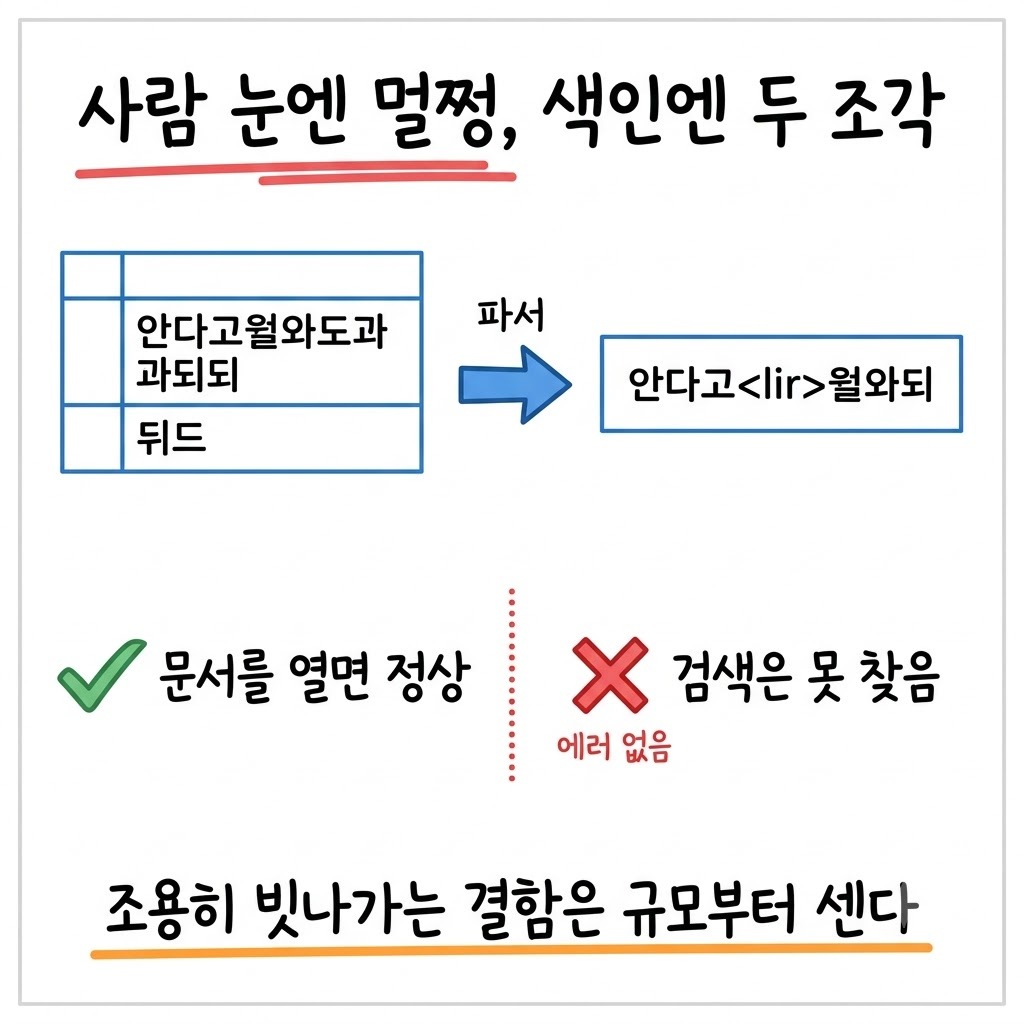
사람이 문서를 열면 멀쩡합니다. 그런데 색인된 본문에는 낱말이 두 조각으로 갈려 있습니다. 표 머리말 그대로 검색하는데 본문에 그 낱말이 없는 상태입니다.
에러는 안 납니다. 파싱은 정상 종료하고 검색만 조용히 빗나갑니다. 그래서 영향 규모를 측정하기 전에는 수정 우선순위조차 정할 수 없었습니다. 제 코퍼스에서는 809청크 · 52문서가 이 상태였습니다.
갈린 모양은 세 가지였습니다
실제 필드 이름과 문서 이름은 적지 않고 형태만 적습니다. 어디가 갈렸나가 문제지 무엇이 갈렸나는 문제가 아니었습니다.
영문 한 낱말이 글자 사이에서 갈린 것 — 끝 글자 하나만 떨어져 나간 형태입니다. 붙여야 맞습니다
영문 두 낱말이 낱말 경계에서 갈린 것 — 원래 띄어 쓰는 이름입니다. 띄워야 맞습니다
한글 두 낱말짜리 표 머리말이 갈린 것 — 원문이 붙여 쓰는 말인지 띄어 쓰는 말인지에 따라 답이 갈립니다
서식 태그가 낱말 안쪽에 들어간 것도 같은 유형의 문제입니다. 여는 태그와 닫는 태그가 낱말 가운데를 감싸고 있습니다. 이미지 파일 10건도 같이 걸렸는데, 상용 멀티모달 OCR도 같은 줄바꿈 태그를 냅니다. 이 파서 하나만의 일이 아니었습니다.
하나의 치환 규칙으로는 해결되지 않습니다
갈린 자리를 이을 때 태그를 빈 문자열로 지울지 공백으로 바꿀지가 문제였습니다. 붙여야 맞는 자리와 띄워야 맞는 자리가 같은 코퍼스 안에 섞여 있습니다. 한쪽으로 통일하면 다른 유형의 낱말이 잘못 처리됩니다.
방법 | 살아나는 것 | 틀어지는 것 |
|---|---|---|
전부 빈 문자열로 붙인다 | 좁은 칸에서 줄바꿈된 한 낱말 | 원래 띄어 쓰는 두 낱말이 붙어 버린다 |
전부 공백으로 띄운다 | 띄어 쓰는 이름 | 한 낱말이 두 조각으로 남는다 |
규칙으로 가른다 | 이론상 둘 다 | 규칙 자체를 검증할 자가 없다 |
세 번째 방안인 규칙 기반 판별은 선택하지 않았습니다. 앞뒤 글자 종류나 끝 글자 길이, 대소문자로 판별 규칙을 지을 수는 있습니다. 그런데 그 규칙이 맞는지를 또 코퍼스에 물어야 합니다. 그럴 거면 처음부터 코퍼스에 묻는 쪽이 한 단계 짧습니다.
그래서 코퍼스의 실제 용례를 확인했습니다
질의는 한 문장으로 정리됩니다. '이 둘을 붙인 형태가 이 코퍼스의 다른 곳에 실제로 존재하나'. 갈린 자리 4,421곳 전수에 대고 셌습니다.
판정 | 자리 | 비율 |
|---|---|---|
다른 데서 띄워 쓴다 → 공백 | 1,654 | 37% |
다른 데서 붙여 쓴다 → 빈 문자열 | 377 | 9% |
둘 다 나온다 | 1,113 | 25% |
'둘 다'로 잡힌 것도 실제 등장 횟수를 보면 한쪽이 압도적이었습니다. 가장 많이 걸린 낱말 조합이 붙여 1 대 띄워 440 이었습니다.
첫 측정에는 결론이 입력에 포함돼 있었습니다
비교할 말뭉치를 만들면서 태그를 공백으로 바꾼 본문을 썼습니다. 그러면 지금 판정하려는 갈린 자리 자신이 이미 띄어진 형태로 그 말뭉치에 들어가 있습니다. 당연히 띄운 형태가 다른 데 있다는 답이 나옵니다.
첫 결과는 공백 70% · 붙이기 0% 였습니다. 붙이기 0% 라는 극단값이 신호였습니다. 어떤 입력에서도 한쪽 결론만 내는 검사는 두 방안을 비교하지 못합니다.
말뭉치를 두 벌로 만들었습니다. 공백으로 이은 것과 붙여서 이은 것입니다. 그리고 갈린 자리 자신의 개수를 양쪽에서 빼고 다시 셌습니다. 위 표가 다시 센 값입니다.
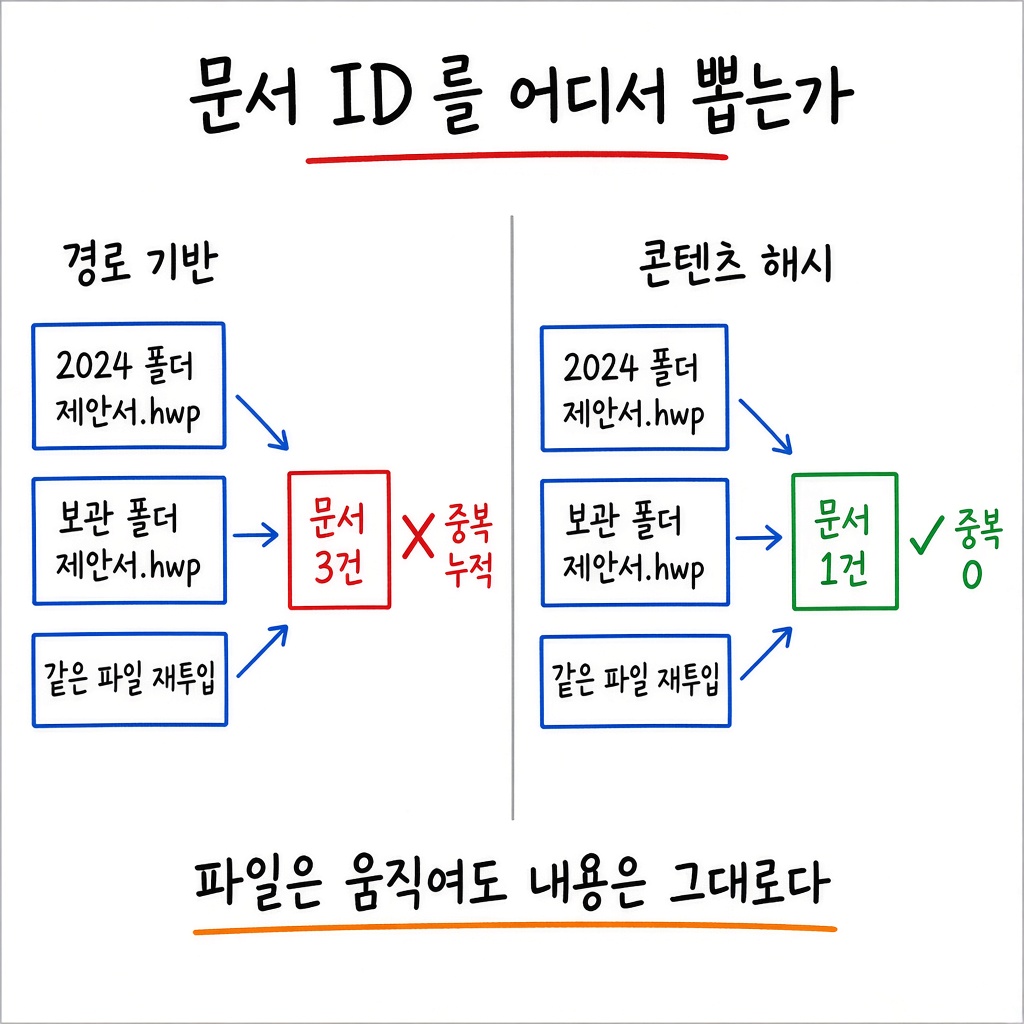
넣는 쪽을 잘못 만들면 뒤에 붙은 검색이 아무리 좋아도 답이 안 나옵니다. 같은 자리를 다른 각도에서 겪은 기록도 같이 두었습니다.
같은 증상인데 관련 프로젝트에서는 정반대 결과가 나왔습니다
같은 처리 구조를 먼저 적용한 프로젝트가 하나 있었습니다. 그쪽이 자기 색인에서 갈린 자리를 세어 알려 줬고, 제가 같은 기준으로 제 코퍼스를 측정했습니다. 규모도 형식 분포도 달랐습니다. 그쪽은 26,134청크 · 1,567문서에 한글 문서가 주력이고, 제 쪽은 809청크 · 52문서에 PDF 가 주력입니다.
가장 많이 걸린 낱말 조합의 판정 | |
|---|---|
먼저 적용한 프로젝트 | 붙여 157,328 : 띄워 1,787 — 88 대 1로 붙이기 |
제 쪽 | 붙여 1 : 띄워 440 — 압도적으로 띄우기 |
같은 계열 문서인데 답이 반대입니다. 그쪽에서 걸린 것은 칸이 좁아 두 줄이 된 붙여 쓰는 낱말이었고, 제 쪽에서 걸린 것은 원래 띄어 쓰는 필드 이름이었습니다. 결정표는 같이 쓰되 값은 각자 코퍼스에 대 봐야 한다는 것이 이걸로 네 번째 사례가 됐습니다.
서로 대 보면서 나온 것이 셋 있었습니다.
그쪽이 알려 준 '칸 경계에 줄바꿈 태그가 있으면 두 칸이 붙어 버린다'를 제 쪽에서 재 보니 0건이었습니다. 전역 치환을 그대로 뒀습니다
제가 찾아 넘긴 것은 두 규칙이 같이 놓치는 자리였습니다. 점이나 하이픈 뒤에서 갈린 문자열은 양쪽이 모두 글자·숫자·한글이어야 한다는 검사에 안 걸립니다. 30건에 46개가 그 상태였습니다
서식 태그를 낱말 한가운데만 지웠더니 짝이 안 맞는 태그가 남았습니다. 서식 태그는 어디에 있든 지우는 쪽이 맞습니다. 제 쪽은 처음부터 전역이었는데 판단이 아니라 운이었습니다
결정은 비율이 아니라 손해의 비대칭이 내렸습니다
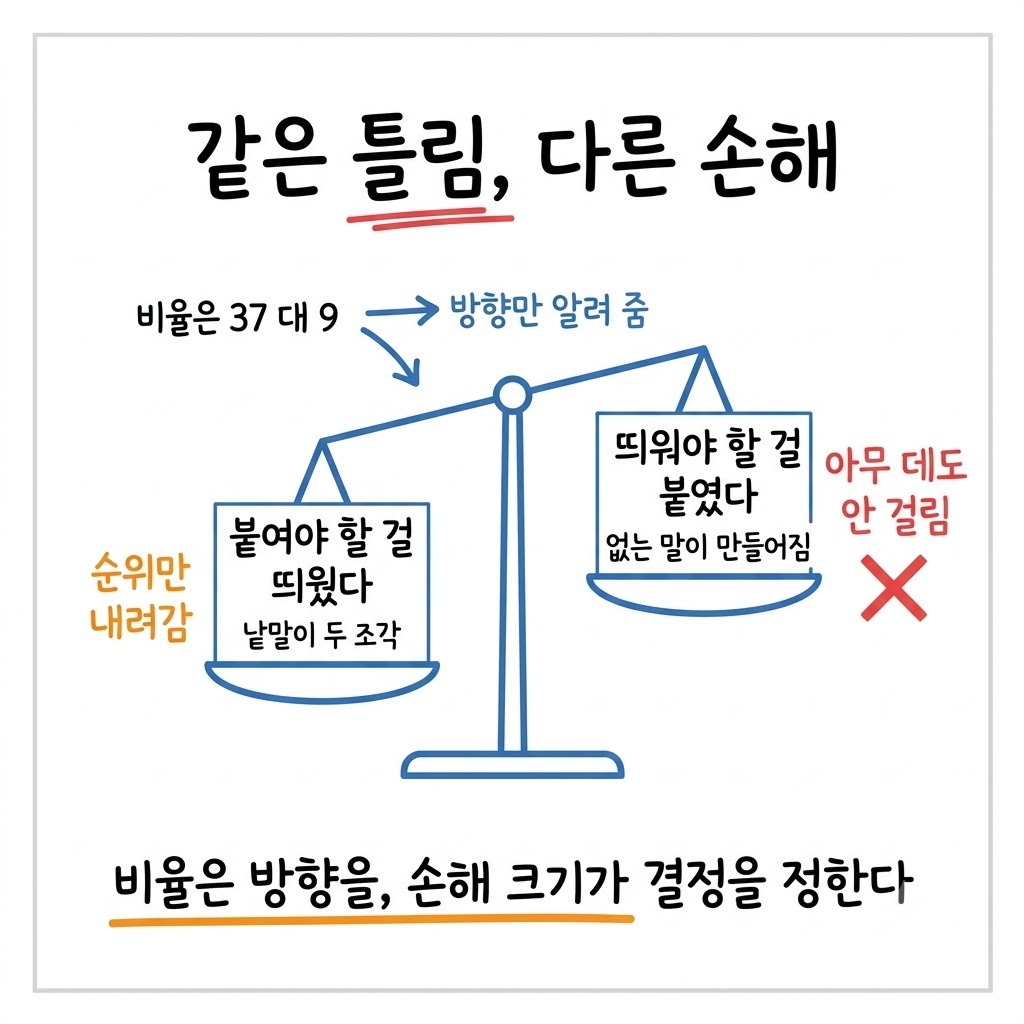
공백으로 갔습니다. 37 대 9 라는 비율은 방향만 확인해 줬습니다. 실제로 결정을 내린 것은 틀렸을 때의 손해 크기였습니다.
붙여야 할 것을 잘못 띄우면 낱말이 두 조각이 됩니다. 검색은 조각으로도 걸립니다. 순위가 내려갈 뿐입니다
띄워야 할 것을 잘못 붙이면 어느 문서에도 없는 말이 됩니다. 아무 데도 안 걸립니다
둘 다 잘못된 결과지만, 한쪽은 검색 순위가 낮아지고 다른 쪽은 검색되지 않습니다. 어느 쪽이 맞나로 한 방향으로 안 풀리는 선택은 틀렸을 때 어느 쪽이 더 손해인가로 풉니다. 비율과 손해가 같은 답을 가리키면 다행이고, 갈리면 손해 쪽을 따릅니다.
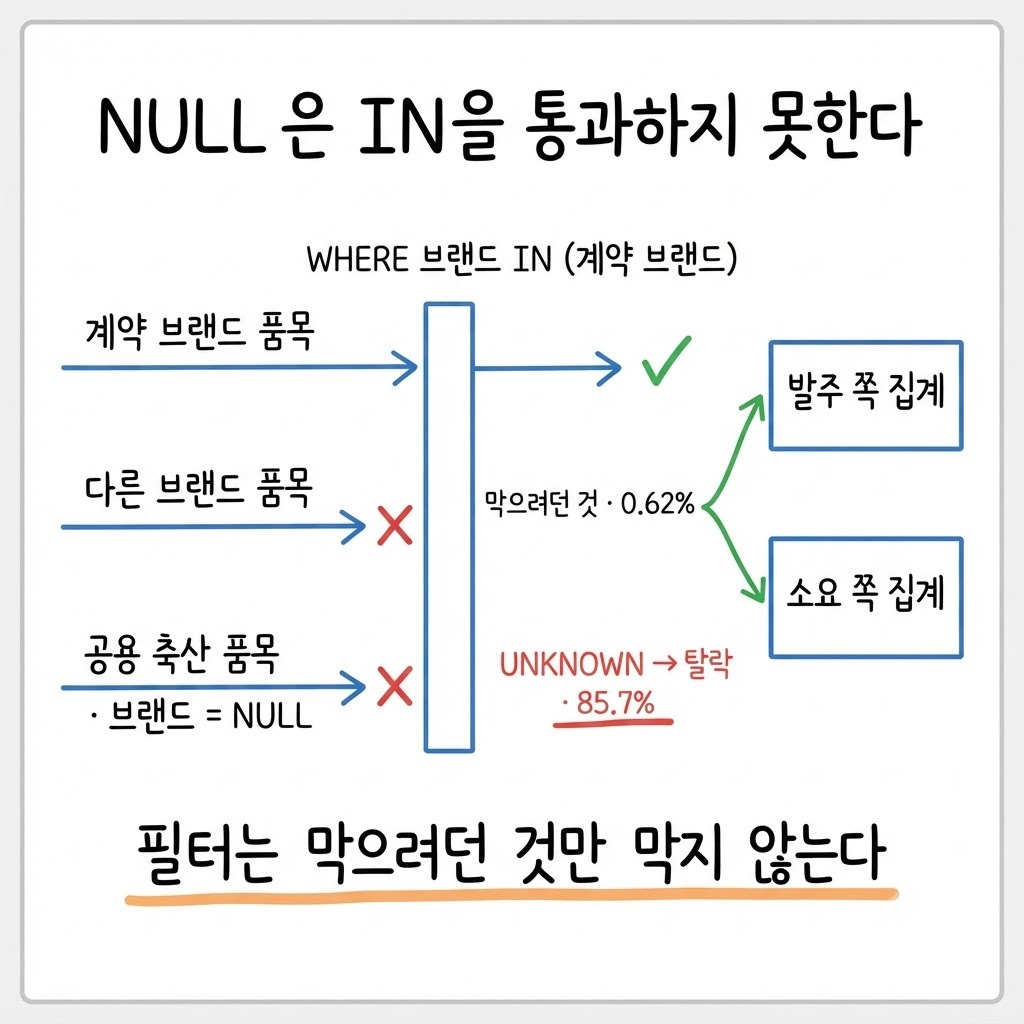
막는 쪽과 버리는 쪽의 크기가 달라서 결정이 뒤집히는 구조는 검색 근거 필터에서도 같은 모양으로 나옵니다.
고친 자리와 안 고친 자리
처리를 넣은 곳은 청크를 만드는 한 자리입니다. 반복 붕괴 가드와 빈 표 행 제거, 줄바꿈 정규화가 이미 모여 있는 곳입니다. 같은 성격의 정리를 한군데로 모으면 다음에 하나 더 붙일 때 찾을 자리가 정해져 있습니다.
파서는 다시 안 돌렸습니다. 색인된 본문만 고쳤습니다. 다시 파싱하면 돈을 주고 얻은 OCR 전사 결과가 지워지는데, 그 전사는 종량제라 회차마다 비용이 듭니다. 먼저 적용한 프로젝트는 재전사 규모가 훨씬 크므로 같은 방식을 쓰도록 스크립트를 넘기기로 했습니다.
적용 뒤 결과는 이렇습니다.
갈린 자리 809청크 → 0
회귀 15문항 15/15 유지 · 나빠진 문항 0
답의 근거로 올라오는 파일이 바뀐 것 6문항
다만 색인 본문만 고친 것은 임시 처방입니다. 다시 파싱하면 갈린 상태가 되살아납니다. 재색인 절차에 같은 처리를 걸어 두지 않으면 다음 회차에 원위치합니다. '둘 다'로 잡힌 25% 도 결국 한쪽으로 몰아서 처리했으니, 그중 일부는 지금도 틀린 채로 남아 있습니다.
같은 자리에서 볼 것
조용히 빗나가는 결함은 우선순위가 안 잡힙니다. 청크 수와 문서 수를 먼저 세고 손댈지 정합니다
판별 규칙을 짓기 전에 자기 자료에 먼저 물어봅니다. 규칙을 지으면 그 규칙의 검증이 또 필요해집니다
측정에 쓴 말뭉치가 측정 대상으로 만들어져 있지 않은지 봅니다. 극단값은 발견이 아니라 의심 신호입니다
검사에 쓴 경계 조건이 곧 못 보는 자리입니다. 걸러낸 조건을 세어 보면 놓친 규모가 나옵니다
같은 결정표를 공유하는 이웃 프로젝트라도 값은 각자 잽니다
국소 처치는 짝 안 맞는 잔해를 남깁니다. 이런 정리는 대개 전역이 맞습니다
조건이 바뀌면 이 결정도 바뀝니다. 코퍼스가 작으면 '다른 데 있나'라는 질의가 우연에 좌우되므로 그때는 규칙 쪽이 낫습니다. 코드 식별자 위주 코퍼스라면 잘못 띄우는 쪽이 더 치명적이라 손해의 비대칭이 뒤집힙니다. 검색 엔진이 부분 일치를 잘 하면 두 손해의 거리가 좁아져 이 근거 자체가 약해집니다.
규모가 작을 때 이렇게까지 재는 것은 과합니다. 809청크에 이 품을 들인 것은 상대 쪽에 26,134청크가 있었고 결정을 같이 쓸 것이었기 때문입니다. 혼자 쓰는 규칙이었으면 공백으로 바로 갔어도 됐습니다.