검색 끈 상용 모델엔 이겼던 로컬 RAG, 웹 검색을 켜자 33 대 25로 졌습니다
최신 노동법 20문항에서 로컬 법 데이터를 붙인 우리 AI가 17개, OpenAI 모델이 12개를 맞혔습니다. 이 결과로 '최신 법 개정은 로컬 법 데이터를 붙인 AI가 강하다'는 영상을 준비하고 있었습니다. 그런데 그 비교에서 OpenAI 모델은 웹 검색을 끈 상태였습니다.
검색을 켜고 같은 시험지로 다시 측정했습니다. 결론 정답은 33 대 25로 OpenAI 쪽이 앞섰습니다. 우리 AI에 남은 우위는 정답 근거 조문을 대는 수 하나였습니다. 이 글은 그 재측정의 조건과 결과, 그리고 거기서 정한 규칙을 정리한 기록입니다.
검색을 끈 판에서만 이긴 결과였습니다
자사 영상 콘텐츠 프로젝트에서 법령 질의응답 측정을 해 왔습니다. 보여 주고 싶었던 것은 하나였습니다. 법이 막 바뀌었을 때는 최신 조문을 직접 넣어 둔 로컬 AI가 상용 모델보다 정확하다는 것입니다.
다른 측정을 하던 중에 검색을 켠 OpenAI 모델이 정답 근거인 고용노동부 해석을 직접 찾아오는 것을 봤습니다. 그 뒤로 '검색 끈 판만으로는 공정하지 않다'는 지적이 나왔습니다. 상용 모델은 원래 웹 검색을 쓸 수 있습니다. 그 기능을 끄고 비교한 것은 우리가 이기는 조건을 고른 것과 다르지 않았습니다.
선택지는 두 가지였습니다.
검색 끈 판 결과만으로 간다. 빠르지만 영상을 보는 사람이 '검색 켜면요?'라고 물으면 답이 없습니다
검색 켬·검색 끔·우리 AI 셋을 같은 시험지로 다시 측정한다. 결과가 불리하게 나올 수 있습니다
두 번째를 골랐습니다. 시험지를 늘리고 채점도 처음부터 다시 했습니다.
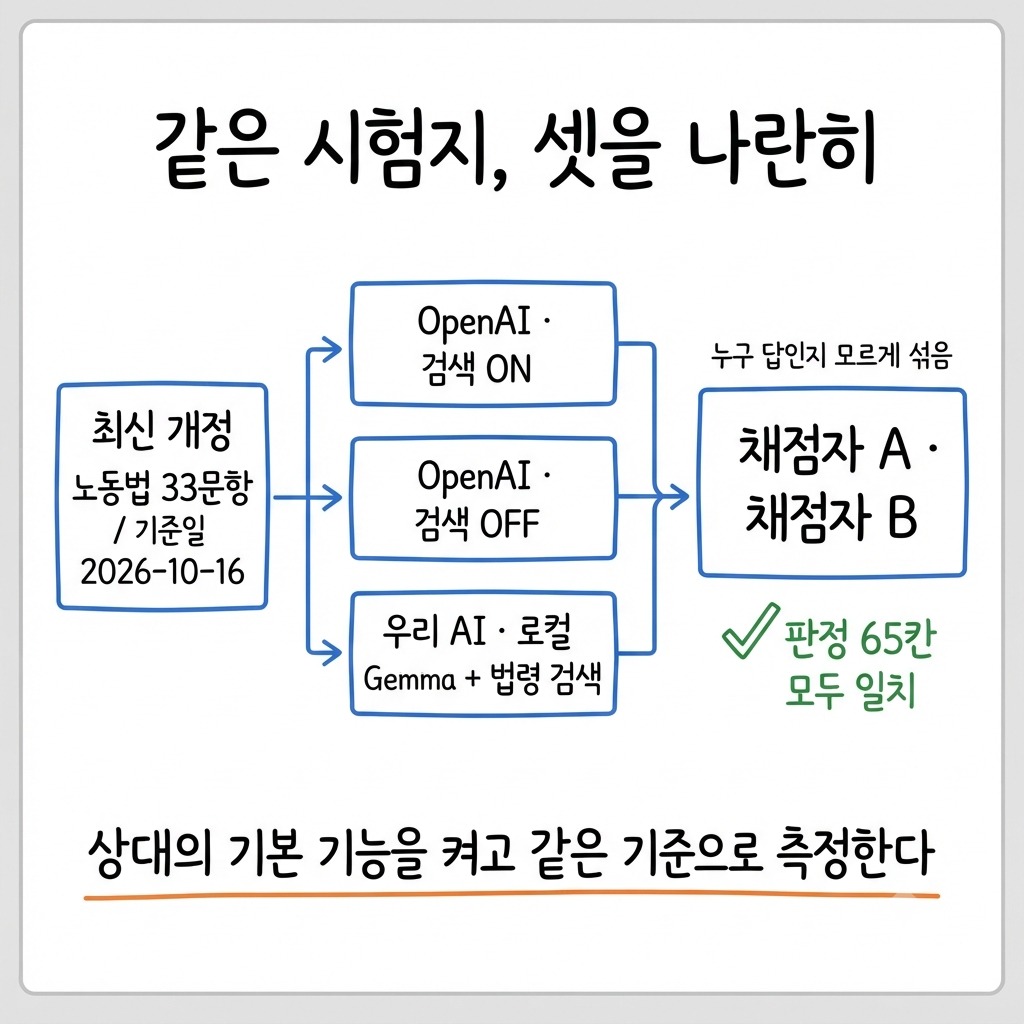
같은 시험지와 같은 채점으로 셋을 다시 측정했습니다
우리 AI는 앞선 측정에서 쓰던 구성을 그대로 썼습니다. 측정 당시 OpenAI 쪽은 gpt-6.1-sol 이었고, 이름은 시점이 지나면 바뀔 수 있습니다.
우리 AI | OpenAI | |
|---|---|---|
모델 | Gemma 4 26B-A4B (LM Studio, 생각 켬, temperature 0) | gpt-6.1-sol (Codex CLI, 추론 high) |
근거 | KURE-v2 기반 법령·판례 검색, 기준일에 시행 중인 조문만 넣음 | 검색 켬 / 검색 끔 두 판 |
질문 방식 | 결론 방향을 먼저 말하게 한 프롬프트 | 질문 문장만 그대로, 문항마다 새 세션 |
비용 | 로컬 실행이라 0 | 구독 사용량 |
OpenAI 쪽은 개인 설정이 섞이지 않게 설정 폴더와 홈 폴더를 빈 폴더로 두고, 빈 작업 폴더에서 읽기 전용으로 실행했습니다. 평소 쓰던 지시문이 답에 영향을 주면 비교가 무의미해지기 때문입니다.
시험지의 기준일은 2026-10-16 입니다. 그날 시행 중인 법이 정답이고, 공포만 되고 아직 시행 전인 개정은 옛 법 쪽이 정답입니다. 앞선 20문항에 2026년 시행·공포 개정 15문항을 더해 35문항을 만들었습니다. 채점 뒤 정답 자체가 틀린 2문항을 '정오표'(시험지의 틀린 정답을 따로 모아 둔 목록)로 빼서 33문항으로 셌습니다.
채점은 Claude 에이전트 둘이 서로 다른 지시문으로 맡았습니다. 어느 AI의 답인지 모르게 섞어서 매기는 '블라인드 채점'이었고, 두 채점자의 판정 65칸이 모두 같았습니다.
결론은 33 대 25, 근거 조문은 30 대 17
결론 맞음 | 틀림 | 결론 안 냄 | 정답 조문을 댐 | |
|---|---|---|---|---|
OpenAI 검색 켬 | 33 | 0 | 0 | 17 |
OpenAI 검색 끔 | 21 | 10 | 2 | 20 |
우리 AI | 25 | 2 | 6 | 30 |
'예'로만 답한 기준선 | 19 |
검색을 켠 OpenAI는 33문항을 전부 맞혔습니다. 검색을 끈 판은 21개로, 모든 문항에 '예'라고만 답한 기준선 19개와 2개 차이였습니다. 우리 AI는 25개로 두 판 사이에 섰습니다.
차이는 최신 개정 문항에서 크게 벌어졌습니다.
2026년 공포 개정 18문항: 검색 켬 18 · 우리 AI 12 · 검색 끔 6. 검색 끔이 틀린 답은 대부분 옛 법 기준으로 낸 결론이었습니다
이미 시행된 2026년 개정 13문항만 보면 검색 끔 2 · 검색 켬 13
문항 짝으로 보면 둘 다 맞힘 25 · 검색 켬만 맞힘 8 · 우리 AI만 맞힘 0
가장 무겁게 남은 숫자는 마지막 줄의 0 입니다. 우리 AI가 맞힌 문항은 검색을 켠 OpenAI도 전부 맞혔습니다. 결론만 놓고 보면 이번 시험지에서 우리 AI가 더해 준 문항은 하나도 없었습니다.
비용도 같이 기록했습니다. 검색 켬 35문항은 14분, 270만 토큰(문항당 약 7.7만 토큰)이었고 사용 한도는 넘지 않았습니다. 검색 끔 15문항은 5분에 28만 토큰, 우리 AI 15문항은 로컬에서 9.5분이었습니다.
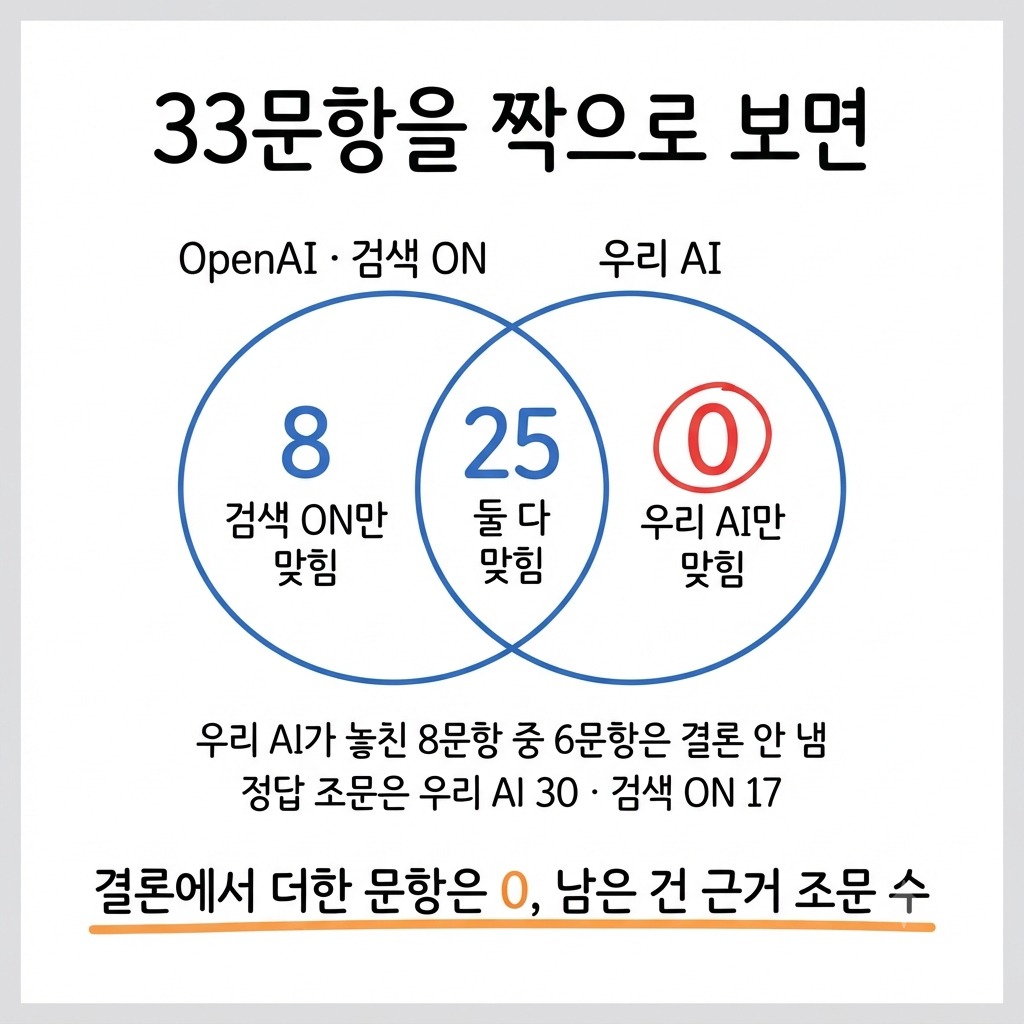
우리 AI는 근거를 가장 많이 대고 결론을 내지 않았습니다
우리 AI가 놓친 8문항 중 6문항은 틀린 답이 아니라 결론을 내지 않은 답이었습니다. 정답 조문을 댄 수는 30개로 셋 중 가장 많았습니다. 앞선 측정에서 본 '근거는 찾아오고 결론에서 진다'는 모습이 이번에도 그대로 나왔습니다.
지식그래프를 붙여 근거를 더 찾게 했을 때도 결론 정답률은 그대로였습니다.
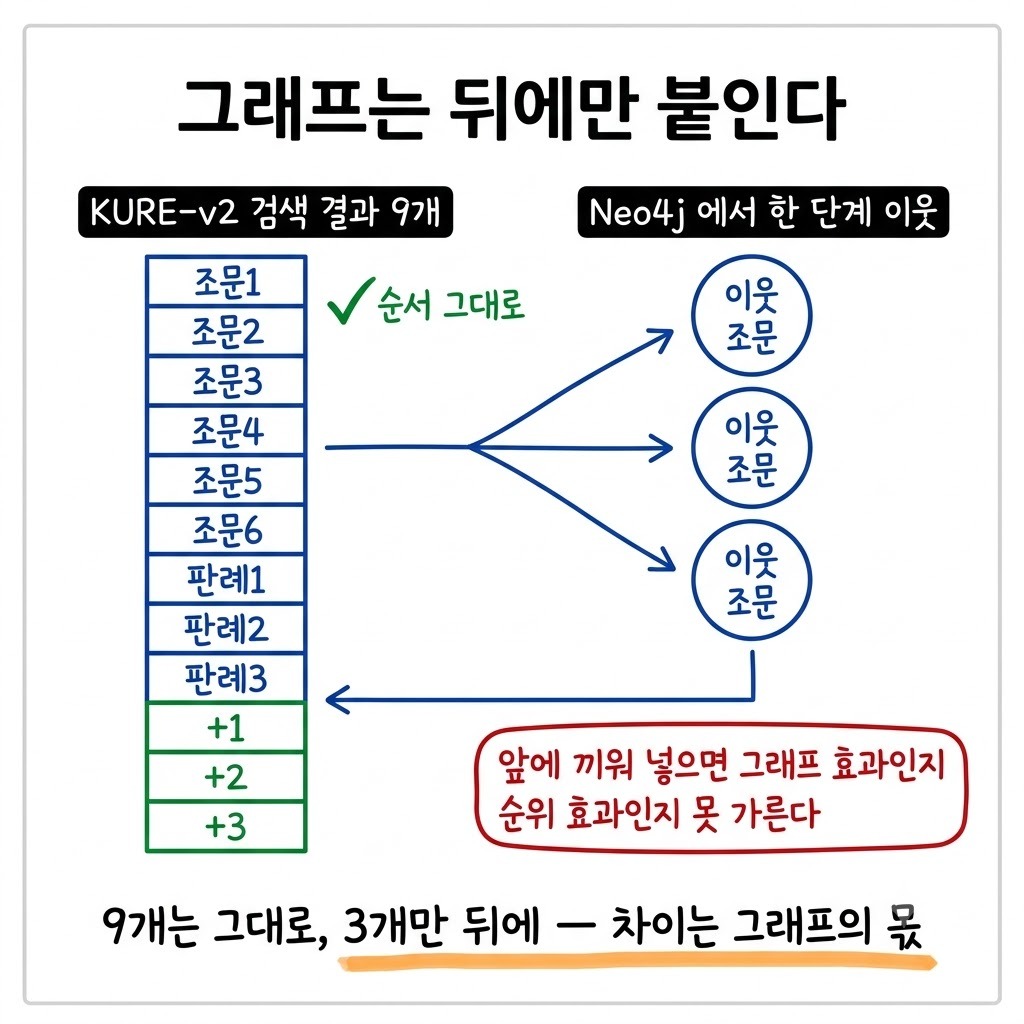
우리 색인에 아예 없는 법인 직업안정법 문항에서는 검색 결과가 0건이었고, 우리 AI는 결론을 내지 않았습니다. 답의 질은 그 전에 무엇을 찾아왔는지에서 먼저 정해집니다.
사내 문서 AI가 엉뚱한 답을 할 때도 같은 순서로 봅니다.
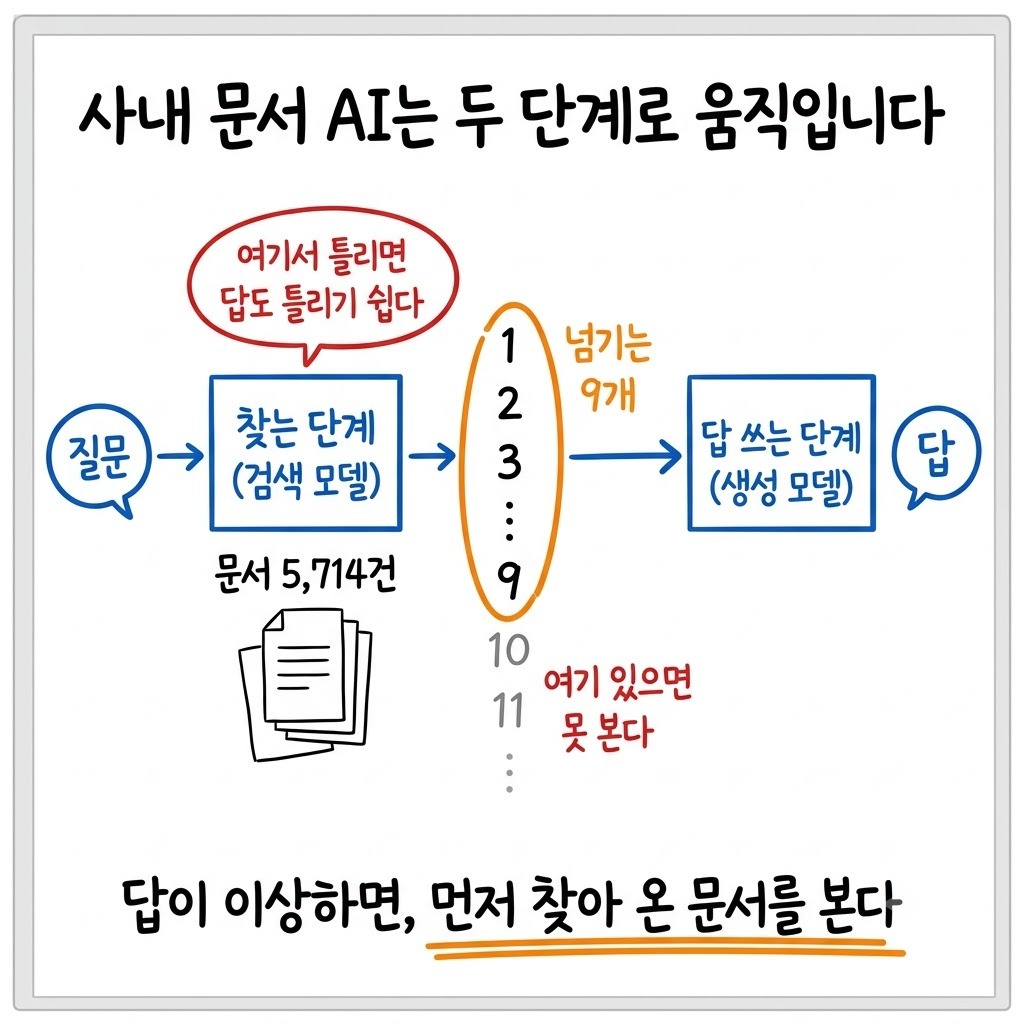
정답이 틀렸던 2문항에서도 같은 차이가 드러났습니다. 시험지는 조문만 보고 만들었는데, 기준일 직전에 나온 고용노동부 행정지침이 두 문항의 결론을 바꿔 놓았습니다. 검색을 켠 OpenAI 모델이 시험지를 만든 우리보다 그 최신 해석을 먼저 찾아왔습니다.
로컬 데이터는 넣은 시점에 멈춰 있습니다. 법이 바뀐 뒤 정부가 행정지침으로 적용 범위를 좁히는 일은 조문 데이터에 들어오지 않습니다. '최신'만 놓고 보면 데이터를 넣어 두는 쪽보다 웹 검색이 빠를 수 있었습니다.
결론 우위 주장은 거두고 규칙을 남겼습니다
검색을 켠 상용 모델 대비로는 이번 측정에서 결론 우위가 없었습니다. 그래서 그 주장은 거뒀습니다. 남은 우위는 근거 조문을 대는 수(30 대 17)이고, 그것도 결론을 내지 않는 약점과 같이 옵니다. 이번 일로 정한 규칙은 넷입니다.
상용 모델과 최신 정보를 겨룰 때는 검색 켬과 검색 끔을 둘 다 측정합니다
로컬 데이터의 강점은 '검색 없는 모델' 대비로만 말합니다
정답 오류는 결과를 본 뒤 고치지 않습니다. 정오표로 빼고 누가 어떻게 찾았는지 기록합니다
블라인드 채점자에게 '정답이 의심스러우면 판정은 규칙대로 하고 메모에 정답 확인 필요를 적으라'는 칸을 줍니다
영상의 방향도 '로컬이 이긴다'에서 '최신 법은 검색을 켜고 물어라'로 바꿨습니다. 불리한 결과였지만 보는 사람에게는 오히려 바로 쓸 수 있는 결론이 됐습니다. 공개 전에는 법제처에서 시행일을 한 번 더 확인하기로 했습니다.
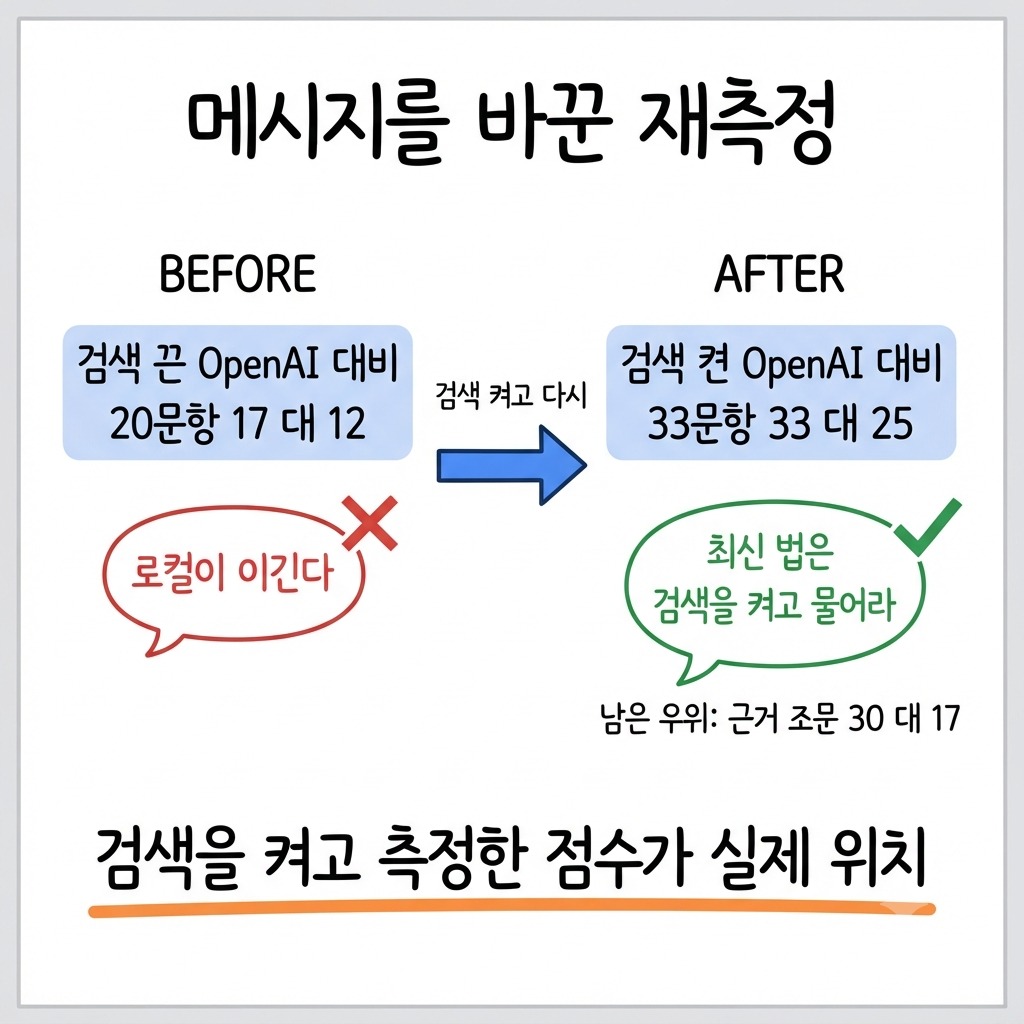
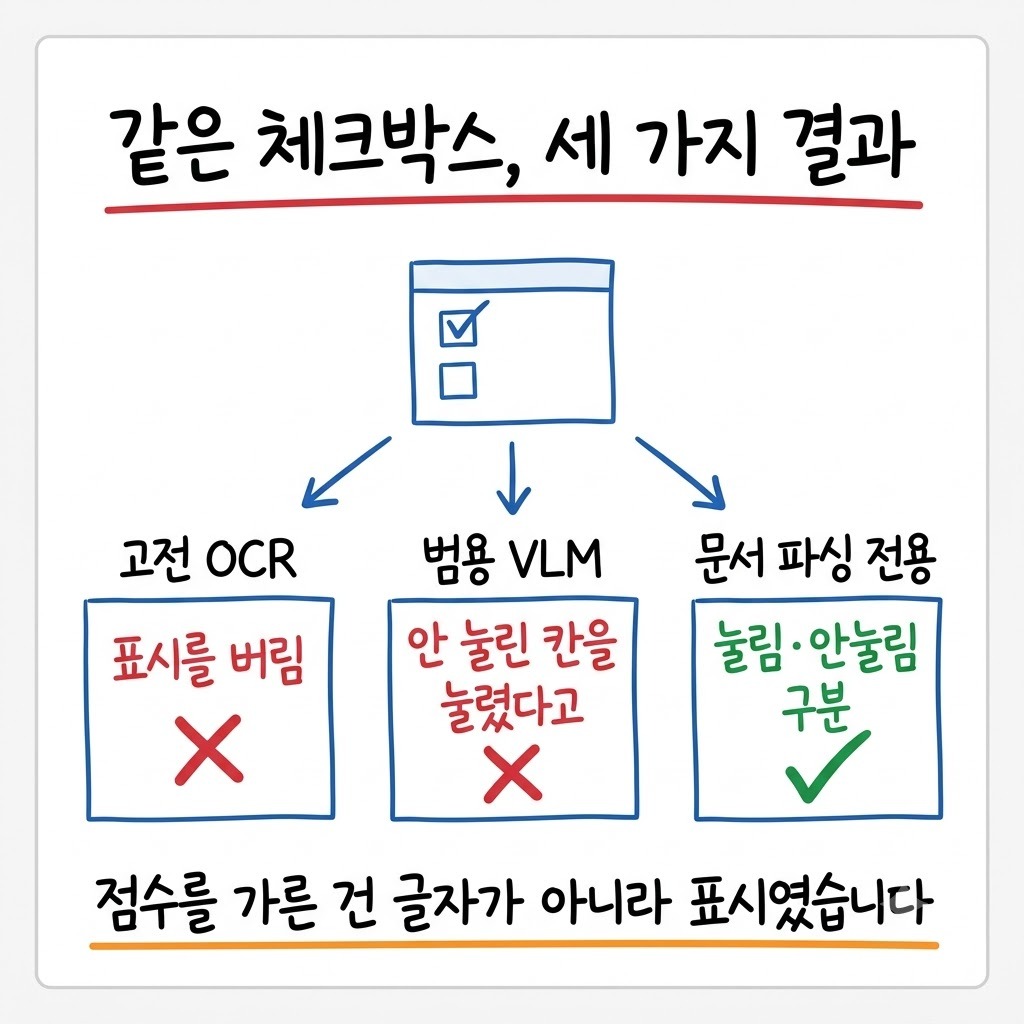
같은 기준으로 다시 측정하니 결론이 바뀐 일은 OCR 비교에서도 있었습니다.
이번 측정으로는 말할 수 없는 것
검색 켬 판은 한 회차뿐입니다. 같은 설정으로 다시 실행하면 몇 문항이 바뀌는지는 측정하지 않았습니다
우리 AI의 결론 안 냄 6문항을 줄이면 차이가 얼마나 줄어드는지 측정하지 않았습니다
우리 검색 결과를 강한 상용 모델에 주고 결론만 맡기는 조합은 측정하지 않았습니다. 실무에서는 이 조합이 답일 수 있습니다
노동법 33문항 한 분야라 다른 법 분야로 넓혀 말하기엔 표본이 작습니다
로컬 실행의 장점(비용 0, 데이터가 밖으로 나가지 않음)은 정답률 비교에 잡히지 않습니다
temperature 0으로 두 번 실행해도 답이 같다는 보장은 없었습니다.
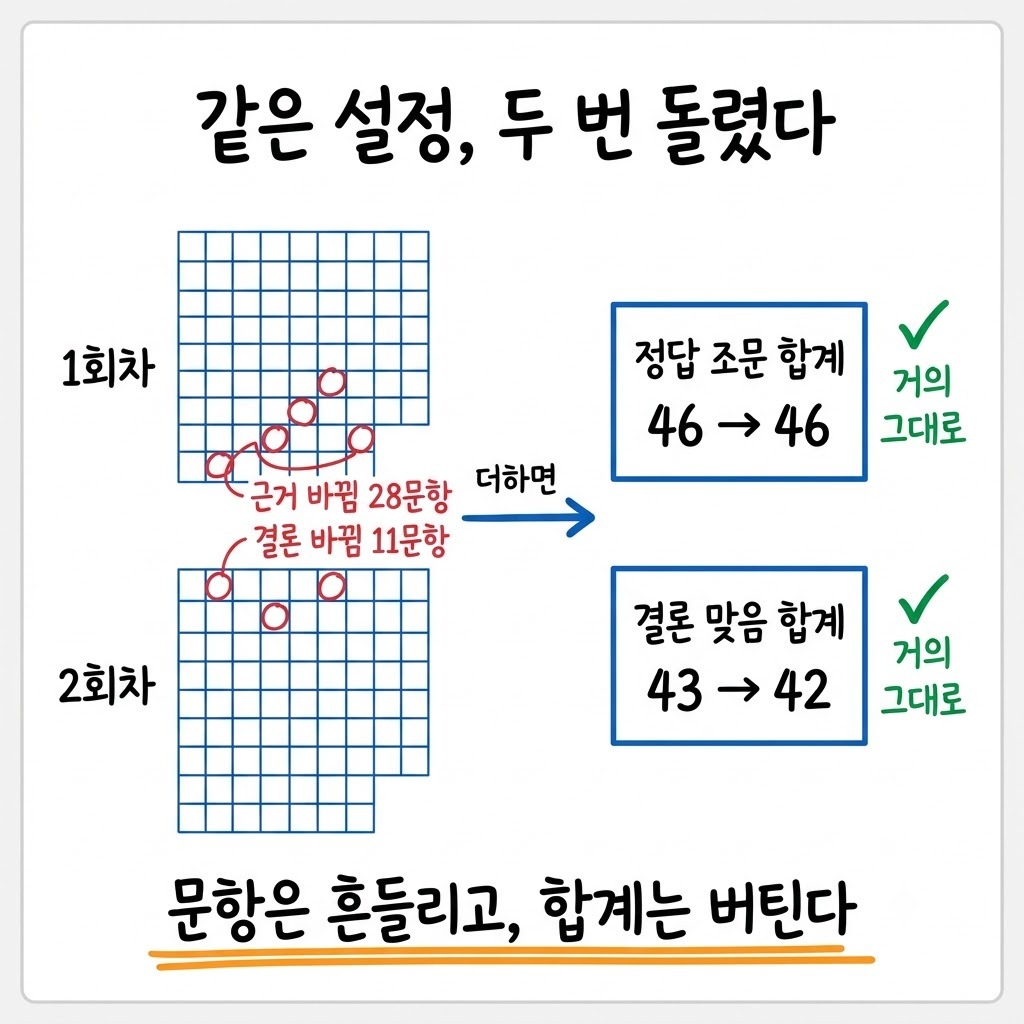
상용 모델과 최신 정보를 겨루는 측정을 준비한다면 상대의 웹 검색부터 켜 두는 편이 낫습니다. 켜고 측정해서 졌다면 그 점수가 실제 위치입니다. 내세울 자리는 결론·근거·비용·로컬 실행으로 나눠 볼 때 정직하게 남습니다.