지식그래프를 붙이니 근거는 더 찾아왔는데, 결론 정답률은 그대로였습니다
지식그래프를 들이고 싶어 하는 회사가 가장 먼저 묻는 질문은 늘 같습니다. '그래프를 붙이면 우리 문서 AI 의 답이 좋아집니까?' 저희도 이 질문에 숫자로 답한 적이 없었습니다. 그래서 법령 질문으로 직접 재 보기로 했습니다.
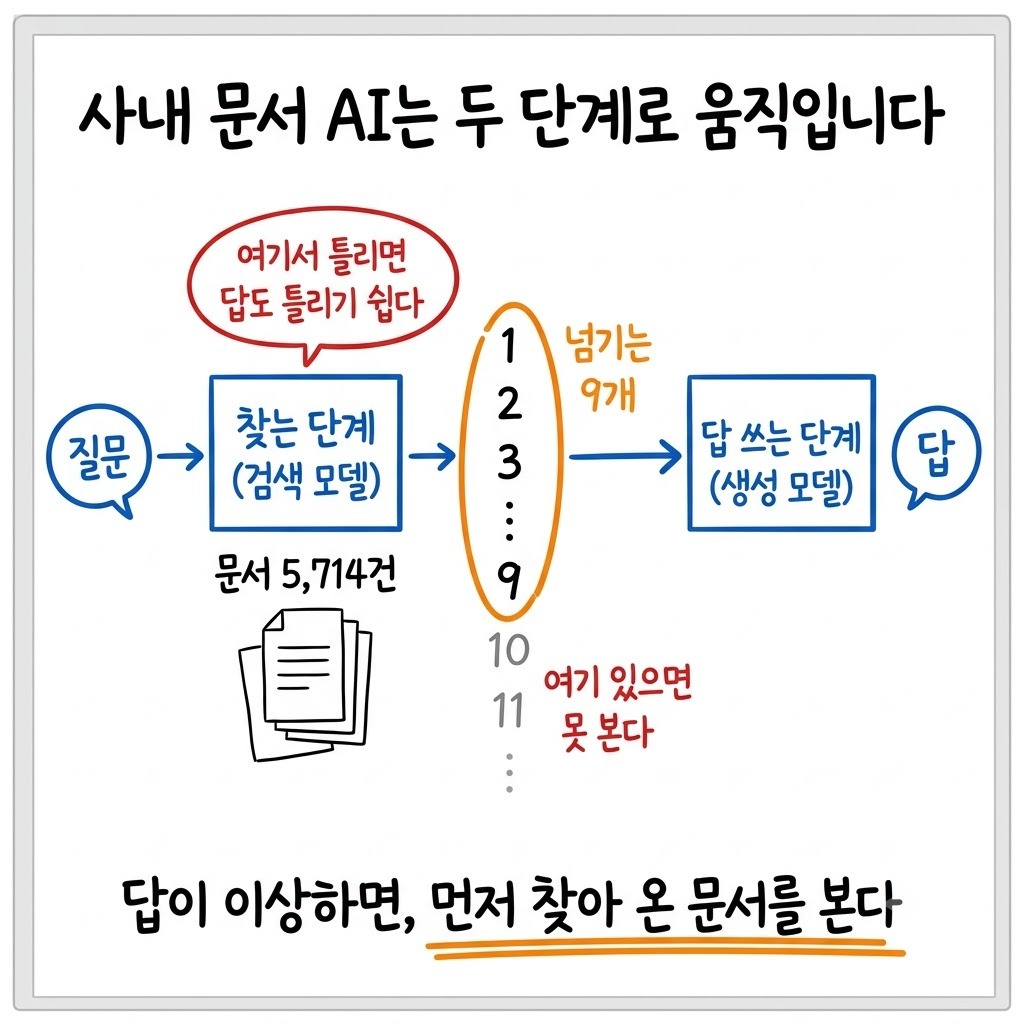
앞 글에서는 문서 AI 가 엉뚱한 답을 하면 답보다 찾는 단계부터 보라고 적었습니다. 이번 글은 그다음 질문입니다. 찾기를 더 잘하게 만들면 답도 같이 나아지는지 확인했습니다.
그래프만 켜고 끄도록 조건을 맞췄습니다
시험지는 자사 법령 질의응답 측정 도구에 들어 있는 노무 질문 100문항입니다. 시험지 자체에 오류가 있던 1문항을 빼고 99문항을 채점했습니다. 이 글에서는 '노동법 99문항'이라고 부릅니다.
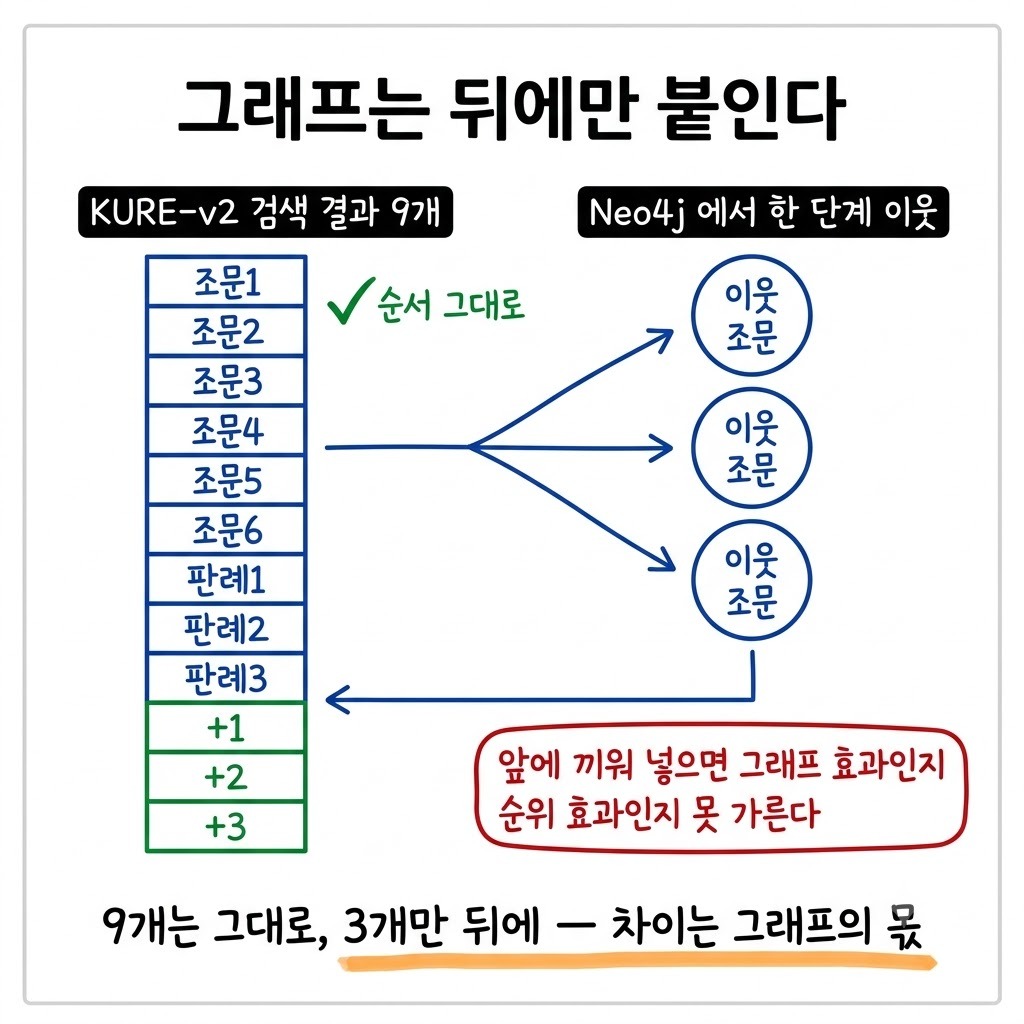
검색: 한국어 임베딩 모델 KURE-v2 로 조문 6개와 판례 3개를 찾습니다. 기준일에 시행 중인 조문만 씁니다
그래프: Neo4j 에 조문이 다른 조문을 가리키는 관계와 판례가 조문·판례를 인용한 관계를 넣었습니다
그래프를 켜면: 검색 결과 9개를 출발점으로 바로 이웃한 조문을 찾고, 출발점들이 많이 가리키는 순서로 3개를 골라 목록 뒤에 붙입니다
답 모델: Gemma 4 31B 를 GPU 서버에서 온도 0 으로 돌렸습니다. 생각 단계를 끈 조건과 켠 조건을 각각 두 번씩 돌렸습니다
채점: 어느 쪽 답인지 가린 블라인드 채점, 채점자 둘. 둘이 갈리면 불리한 쪽으로 정했습니다
가장 신경 쓴 것은 기존 9개의 순서를 건드리지 않는 것입니다. 그래프가 찾은 조문을 앞으로 끼워 넣으면 순위가 바뀌고, 결과가 달라져도 그래프 덕인지 순위 덕인지 가를 수 없습니다. 뒤에 붙이기만 해야 차이가 온전히 그래프의 몫으로 남습니다.
찾기는 분명히 나아졌습니다
아래 숫자는 생각 단계를 켠 두 회차 기준입니다. 이 글에서 '판'은 같은 설정으로 99문항을 한 번 돌린 것을 말하고, 그래프를 끈 판8과 켠 판9를 비교했습니다.
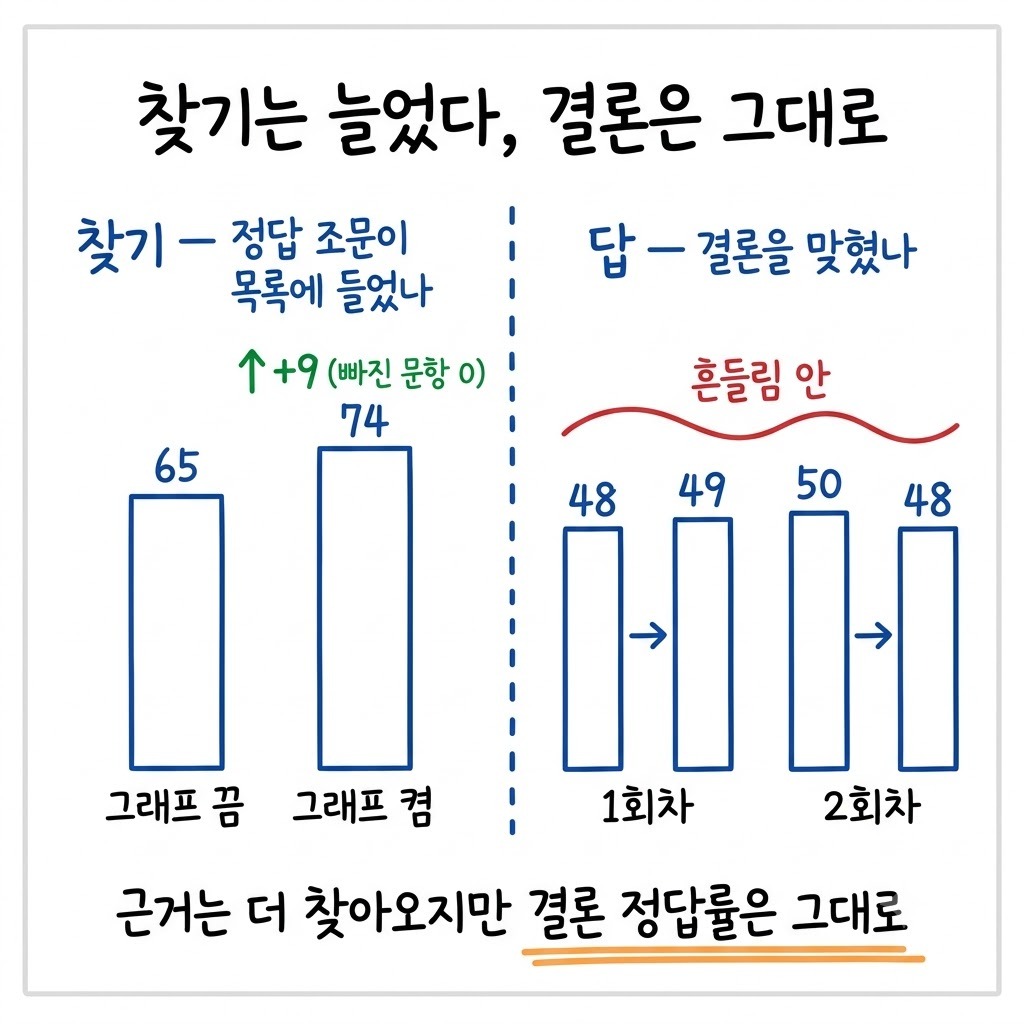
먼저 정답 조문이 AI 에게 넘긴 목록 안에 들어 있었는지 셌습니다. 흔히 보는 '정답이 10위 안에 든 비율'과는 다릅니다. 모델이 실제로 받아 본 9개, 그래프를 켜면 12개 안에 정답이 있었느냐입니다.
항목 | 그래프 끔 | 그래프 켬 | 차이 |
|---|---|---|---|
정답 조문이 목록에 든 문항 | 65 | 74 | 들어옴 9 : 빠짐 0, p=0.004 |
답에 정답 조문을 댄 문항 (1회차) | 63 | 71 | p=0.02 |
답에 정답 조문을 댄 문항 (2회차) | 62 | 72 | p=0.002 |
그래프 때문에 목록에 새로 들어온 정답 조문이 9문항이었습니다. 그래프 때문에 빠진 문항은 0이었습니다. 순서를 건드리지 않았으니 빠질 길이 없는 구조이기도 합니다. 모델이 답에서 정답 조문을 대는 문항도 두 회차 모두 8~10문항 늘었습니다.
결론을 맞힌 문항 수는 움직이지 않았습니다
그런데 질문에 대한 결론을 맞혔는지로 보면 이야기가 달라집니다. 1회차는 48에서 49, 2회차는 50에서 48이었습니다. 한 회차는 하나 늘고 한 회차는 둘 줄었습니다.
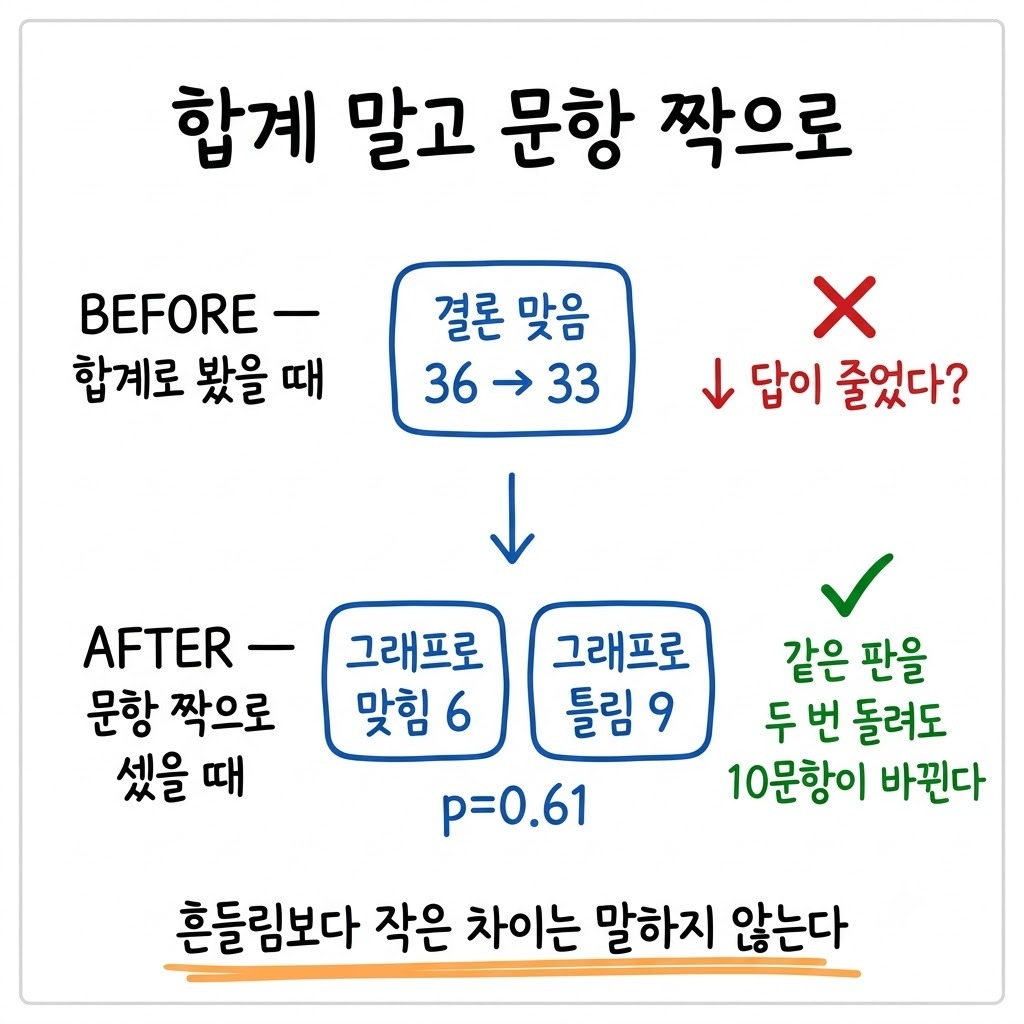
비교는 합계가 아니라 '문항 짝'으로 했습니다. 같은 문항을 두 조건에서 놓고 한쪽만 맞힌 문항이 몇 개인지 세는 방법입니다(McNemar 검정 — 그 개수로 차이가 우연일 확률 p 를 냅니다). 같은 설정을 두 번만 돌려도 결론이 2~3문항 바뀌기 때문에 합계 차이 1~2문항은 그 흔들림 안에 듭니다.
생각 단계를 끈 조건까지 네 번 비교했는데 넷 다 의미 있는 차이가 아니었습니다. 그래프를 켜서 새로 맞힌 문항이 2~3개, 새로 틀린 문항이 1~4개였습니다.
정답 조문을 넣어 줘도 결론이 바뀌지 않았습니다
생각을 켠 두 회차를 문항별로 나눠 보니 그래프의 몫이 더 또렷하게 보였습니다.
변화 없음: 85문항
정답 조문이 새로 들어갔는데 결론은 그대로: 7문항
회차마다 결과가 갈린 흔들림: 5문항
그래프를 켜서 맞힌 문항: 1문항 (정답 조문과 무관한 문항)
그래프를 켜서 틀린 문항: 1문항
**그래프가 넣어 준 정답 조문 덕분에 결론까지 바뀐 문항은 하나도 없었습니다.** 그래프로 맞힌 한 문항도 정답 조문과 관계없는 문항이었습니다. 정답 근거를 손에 쥐여 줘도 결론이 그대로라면 막힌 곳은 검색이 아닙니다. 받은 근거로 결론을 내리는 모델의 판단 쪽입니다.
답 모델을 로컬 맥의 Gemma 4 26B-A4B(LM Studio, 생각 켬)로 바꿔 한 번 더 돌렸습니다. 답에 정답 조문을 댄 문항은 62에서 68로 늘었고, 결론을 맞힌 문항은 49 대 49였습니다. 한쪽만 맞힌 문항이 7 대 7, p=1.0 이었습니다. 모델을 바꿔도 같은 모양이 나왔습니다.
이렇게 적었는데 틀렸습니다
사실 이 측정 전에 같은 그래프를 다른 모델·다른 프롬프트에 처음 붙여 본 판이 있었습니다. 정답 조문이 목록에 든 문항은 56에서 61로 늘었고, 결론을 맞힌 문항은 36에서 33으로 줄었습니다. 저는 그 합계를 보고 '찾는 건 늘었는데 답은 줄었다'고 적었습니다.
문항 짝으로 다시 세니 그래프로 맞힌 문항 6, 그래프로 틀린 문항 9였습니다. p=0.61 로 의미 있는 차이가 아니었습니다. 그 설정은 같은 판을 두 번 돌려도 결론이 10문항쯤 바뀌는 범위였습니다. 합계 3문항 차이는 그 안에 넉넉히 들어갑니다.
그 메모대로 정리했다면 '그래프가 결론을 망친다'는 문장이 그대로 남았을 겁니다. 그렇게 말할 근거는 없었습니다. 합계만 보면 흔들림과 효과가 같은 숫자로 보입니다.
그래프를 붙이기 전에 해 볼 순서
그래프를 검토하는 쪽이라면 아래 순서로 먼저 재 볼 것을 권합니다.
내 문서로 질문과 정답 근거를 짝지은 시험지를 만듭니다
그래프를 붙이기 전과 후를 같은 조건에서 그래프만 바꿔 잽니다. 기존 검색 결과 순서는 건드리지 않고 뒤에 붙입니다
찾기(정답 근거가 AI 에게 넘어갔나)와 답(결론이 맞았나)을 따로 셉니다
같은 설정을 두 번 돌려 흔들림부터 잽니다. 결론은 합계가 아니라 문항 짝으로 보고, 흔들림보다 작은 차이는 말하지 않습니다
찾기만 늘고 결론이 그대로면 검색을 더 고치기보다 답하는 쪽(프롬프트·더 강한 모델)을 잽니다
이 측정이 말하지 못하는 것
이 결과를 그대로 넓히기 전에 걸리는 점이 넷 있습니다.
로컬 26B 는 한 회차만 돌렸습니다. 흔들림 범위는 두 회차를 돌린 31B 기준으로 대신 판단했습니다
채점자 둘이 같은 계열 모델이라 일치율(373건 중 371건)이 서로 독립인 채점보다 높게 나왔을 수 있습니다
결론이 아니라 설명의 질, 곧 근거를 더 정확히 대는지로 보면 그래프가 나을 수 있습니다. 이건 재지 않았습니다
조문이 많고 인용이 더 촘촘한 다른 분야(세무 등)에서는 재지 않았습니다
마무리
노동법 99문항에서 지식그래프는 **근거는 더 찾아오지만 결론 정답률은 그대로**였습니다. 정답 조문이 목록에 든 문항은 65에서 74로 늘었고, 결론을 맞힌 문항은 48~50 사이에 머물렀습니다. 이 결과는 '그래프는 쓸모없다'는 뜻이 아닙니다. 붙이기 전에 찾기와 답을 따로 재 봐야 돈을 어디에 써야 할지 보인다는 뜻입니다.
저희가 다음에 잴 곳도 검색이 아니라 답하는 모델의 판단 쪽입니다. 다른 프로젝트에서도 정답률을 올린 것은 모델 교체가 아니었고, 틀린 문항을 하나씩 열어 보니 원인이 따로 있었습니다.
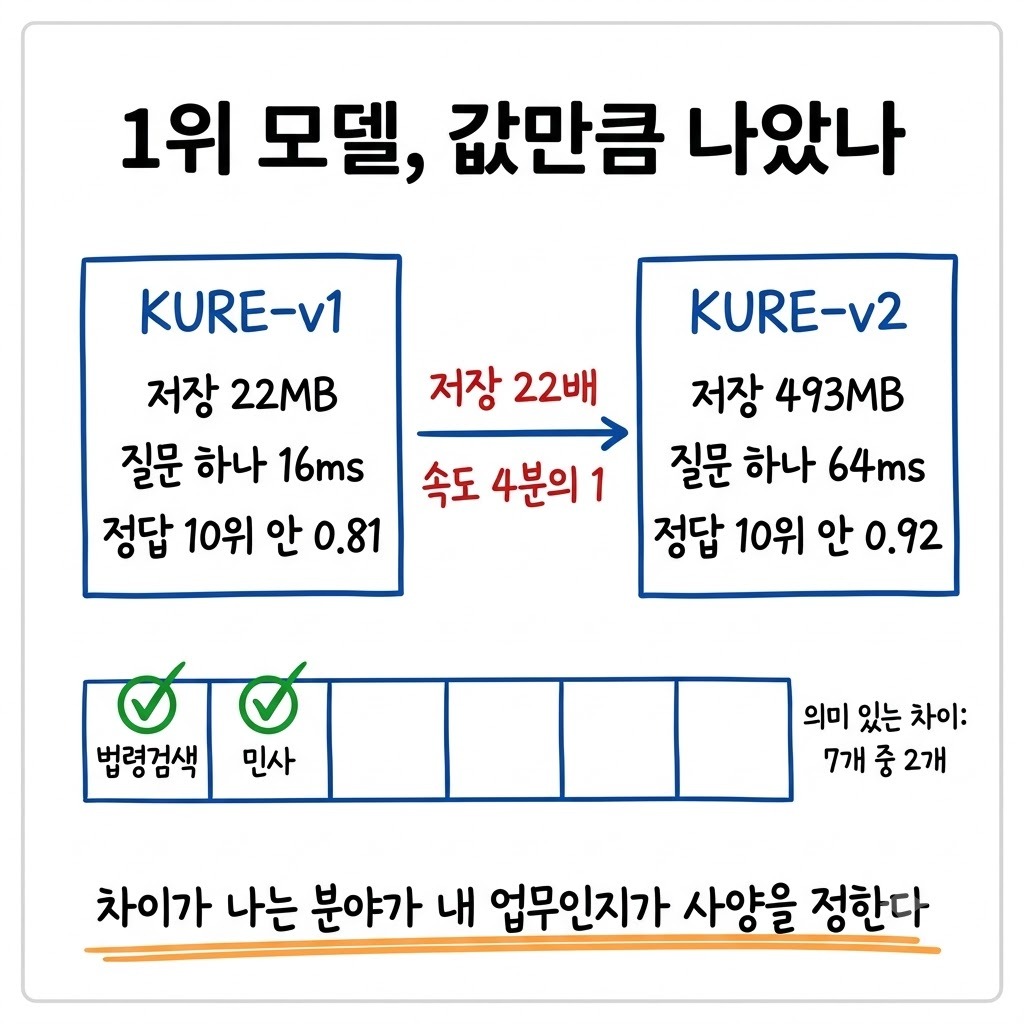
앞 글에서는 같은 노동법 99문항으로 임베딩 모델과 컴퓨터 크기를 비교했습니다. 1위 모델과 큰 서버가 값만큼 낫지 않았던 결과는 그 글에 있습니다.