사내 문서 AI, GPU 서버부터 살 필요는 없었습니다
사내 문서 AI를 검토하는 대표님에게서 가장 자주 듣는 질문이 있습니다. '이거 하려면 GPU 서버부터 사야 합니까?' 견적서에 서버 한 줄이 들어가면 금액 단위가 달라집니다. 그래서 이 질문에는 감으로 답하지 않고, 저희가 직접 잰 숫자로 답해 보려 합니다.
앞 글에서는 같은 노동법 시험지에서 문서를 찾는 모델만 바꿨더니 정답 판례가 1위에도, 89위에도 왔다는 이야기를 했습니다. 답을 쓰는 AI보다 찾아 온 문서부터 봐야 한다는 내용이었습니다. 그러면 바로 다음 질문이 나옵니다. 가장 좋은 모델을 쓰면 되지 않나, 그러려면 큰 컴퓨터가 필요하지 않나.
문서 AI는 두 단계라서, 사양 고민도 두 번 합니다
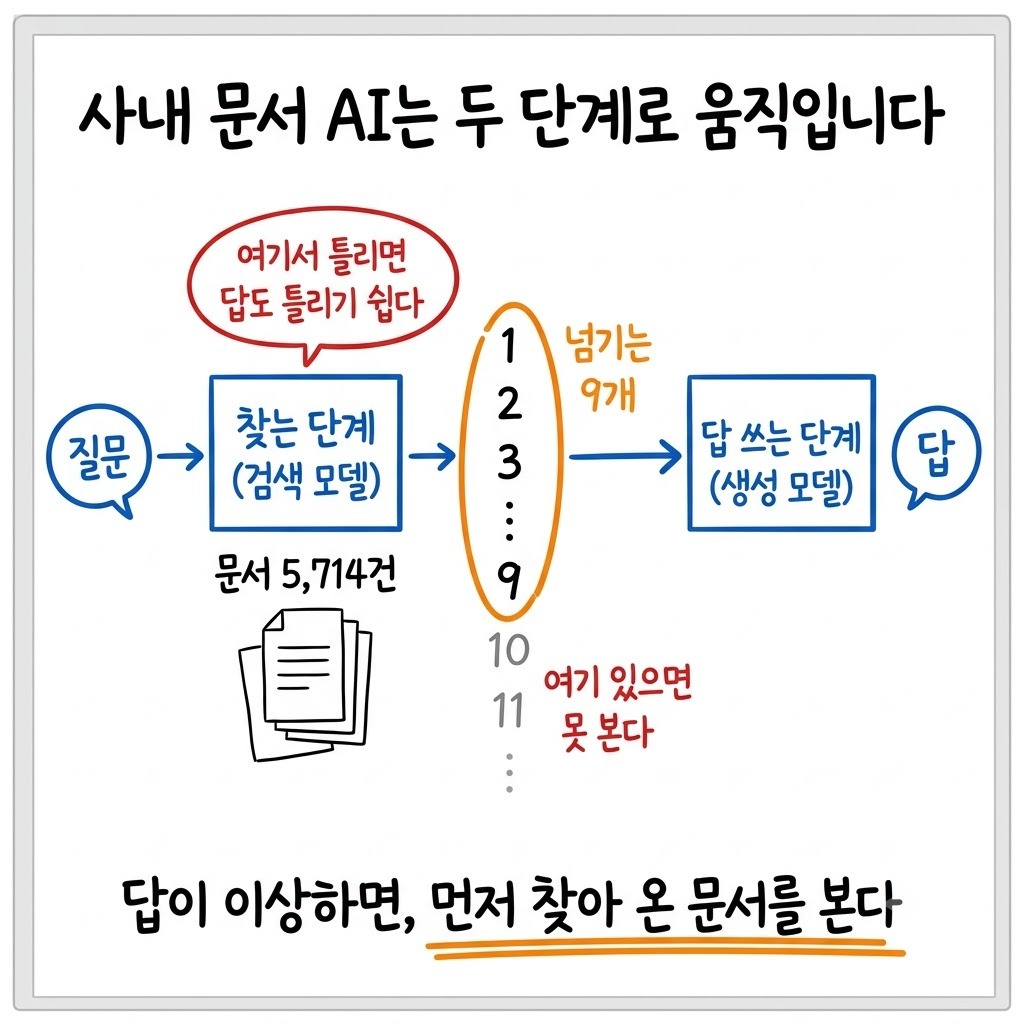
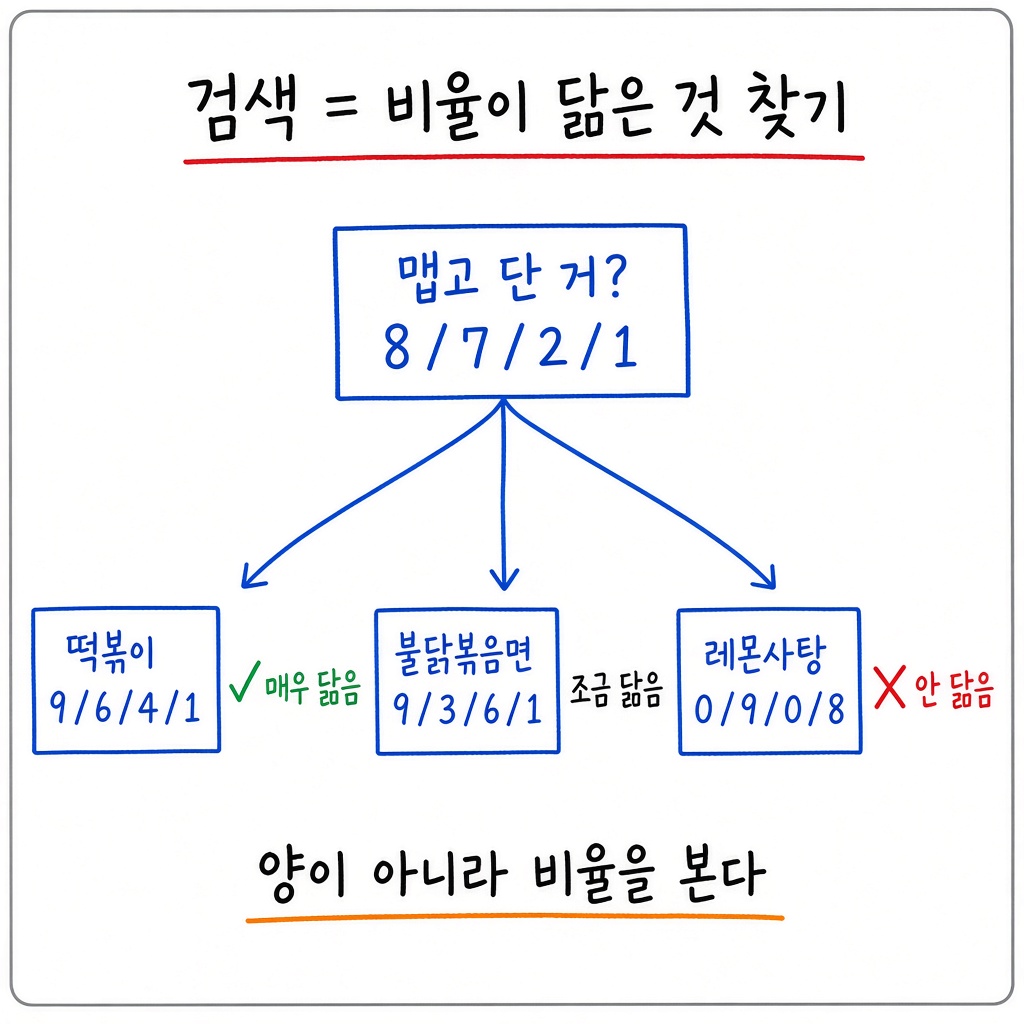
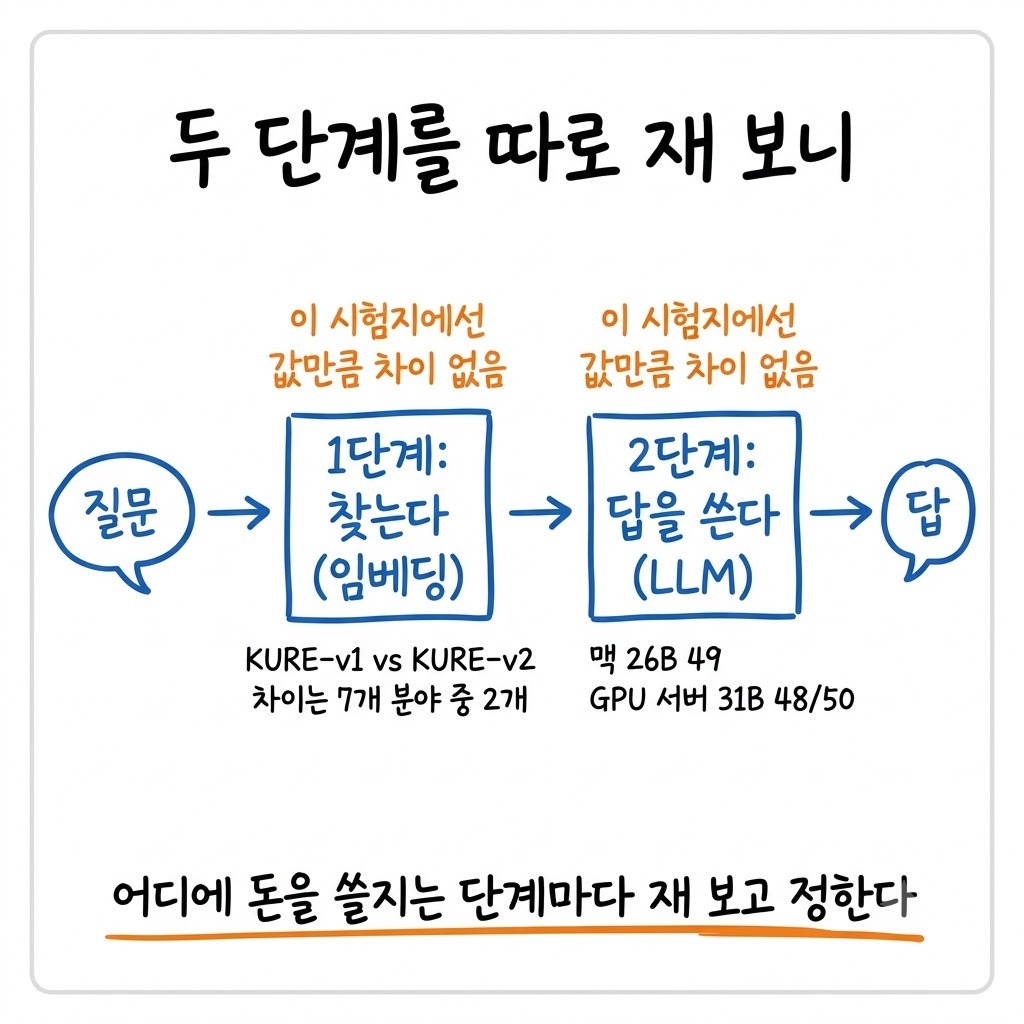
사내 문서 AI는 크게 두 단계로 움직입니다. 먼저 질문과 관련된 문서를 **찾는** 모델이 있고, 찾아 온 문서를 읽고 **답을 쓰는** AI가 있습니다. 찾는 쪽은 보통 '임베딩 모델'(문장을 숫자 벡터로 바꿔 비슷한 것을 찾게 해 주는 모델)이고, 답 쓰는 쪽은 우리가 흔히 LLM이라고 부르는 모델입니다.
두 단계는 필요한 장비도, 돈이 드는 방식도 다릅니다. 그래서 저희는 2026년 10월에 찾는 모델 여섯 개와 답 쓰는 AI 두 가지를 같은 시험지로 따로 쟀습니다. 질문은 하나였습니다. 가장 크고 무거운 쪽이 그 값만큼 나은가.
찾는 단계 — 1위 모델은 얼마나 나았나
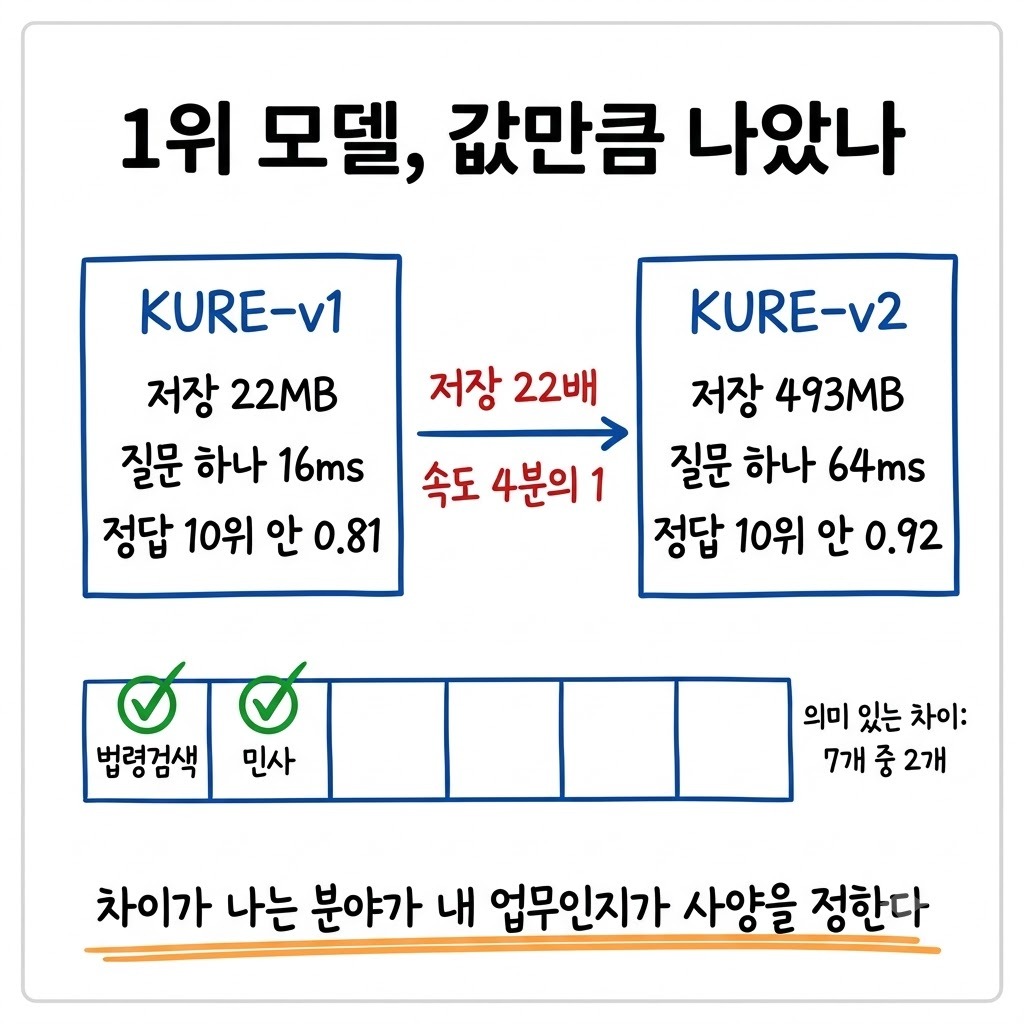
법령 문서 5,714건으로 만든 시험지에서 한국어 임베딩 모델 KURE-v1 과 그 다음 세대인 KURE-v2 를 비교했습니다. 기준은 '정답 문서가 10위 안에 들어오는가'입니다. 법령검색 분야에서 KURE-v2 가 0.92, KURE-v1 이 0.81 이었습니다. 7개 법 분야 평균으로도 KURE-v2 0.724 · KURE-v1 0.677 · bge-m3 0.647 순이었습니다. 점수만 보면 1위는 분명히 KURE-v2 입니다.
항목 | KURE-v1 | KURE-v2 |
|---|---|---|
정답이 10위 안 (법령검색) | 0.81 | 0.92 |
7개 분야 평균 | 0.677 | 0.724 |
질문 하나 처리 시간 | 16ms | 64ms (약 4배) |
저장 공간 (법령검색) | 22MB | 493MB (22배) |
그런데 분야를 나눠 보니 그림이 달라졌습니다. 두 모델의 차이가 통계적으로 의미 있게 나온 분야는 7개 중 **법령검색과 민사 둘뿐**이었습니다. 법령검색에서는 KURE-v2 만 맞힌 문항이 13개, KURE-v1 만 맞힌 문항이 2개였습니다. 나머지 다섯 분야에서는 우연으로 설명되는 수준의 차이였습니다. 평균으로 보이던 차이가 실제로는 일부 분야에 몰려 있었던 것입니다.
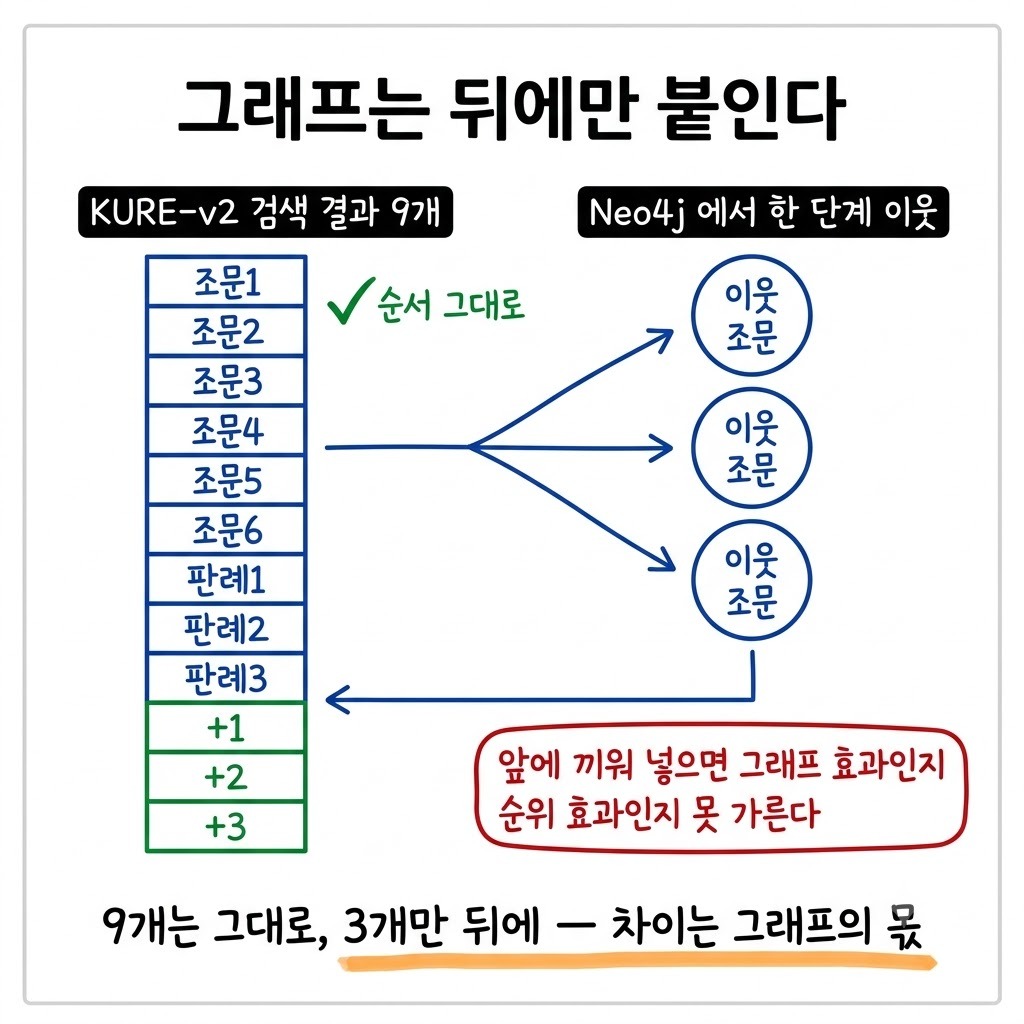
비용 쪽 차이는 훨씬 컸습니다. 다른 모델을 모두 내리고 단독으로 쟀을 때 질문 하나 처리에 KURE-v1 은 16ms, KURE-v2 는 64ms 가 걸렸습니다. 저장 공간은 22MB 대 493MB 로 22배였습니다. 분야별로 계산해 봐도 15~27배 사이였습니다.
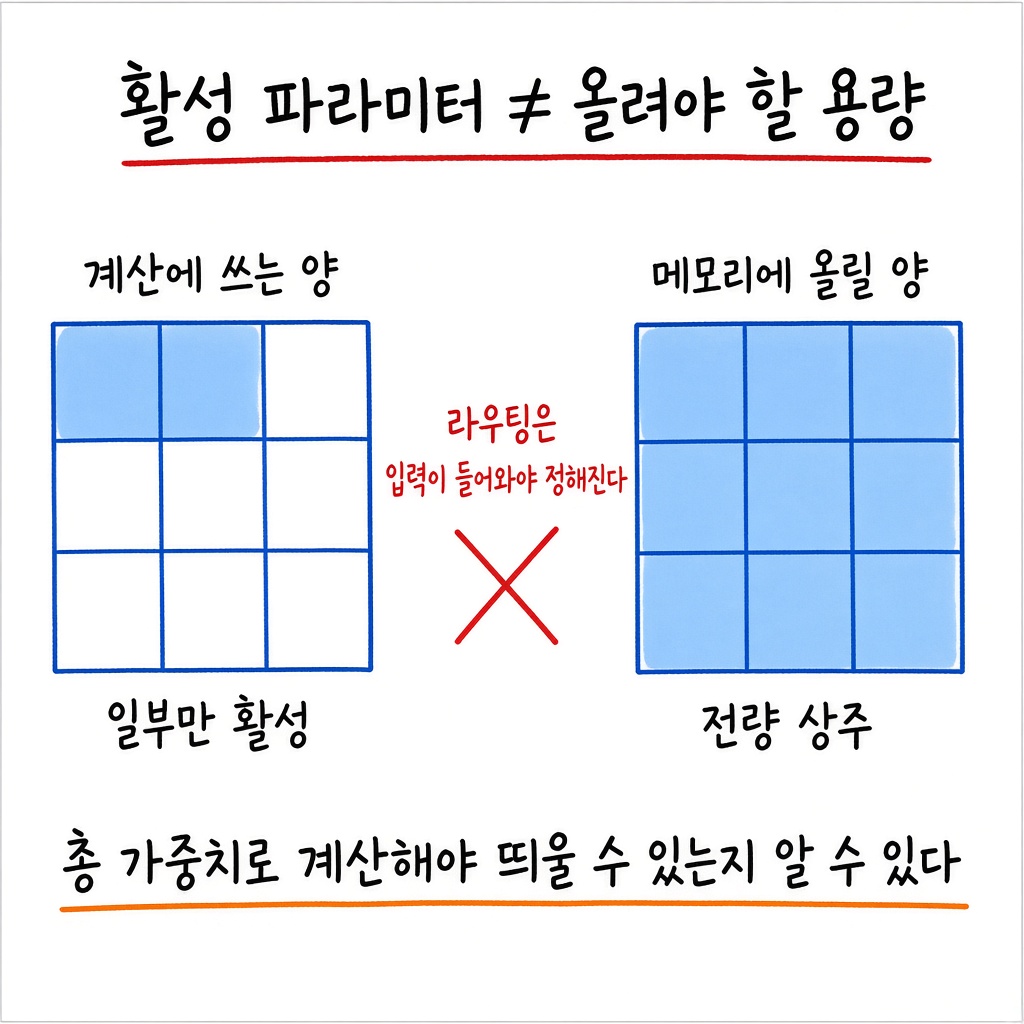
왜 이렇게 무거운지는 저장 방식에서 나옵니다. KURE-v1 은 문서 하나를 벡터 하나로 저장합니다. KURE-v2 는 '다중 벡터' 방식(ColBERT)이라 문서를 낱말 조각으로 나눠 조각마다 벡터를 하나씩 저장합니다. 문서가 길수록 저장할 벡터 수가 그만큼 늘어납니다. 다만 두 모델은 바탕 모델도 다르기 때문에, 점수 차이를 이 저장 방식 하나의 효과로 보지는 않습니다.
실제 서비스 규모에 넣으니 순위가 뒤집혔다
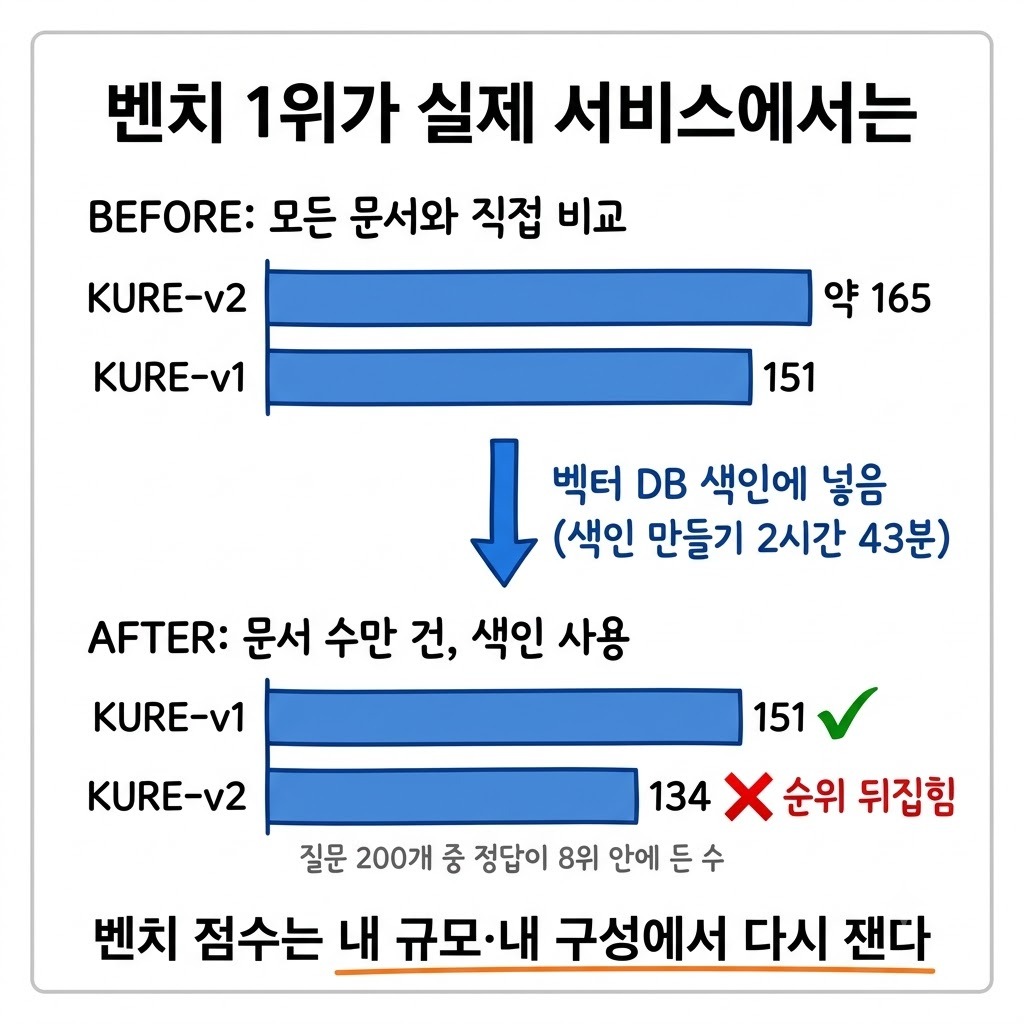
벤치 점수에는 조건이 하나 숨어 있습니다. 질문을 모든 문서와 하나하나 직접 비교한 결과라는 점입니다. 문서가 많아지면 실제 서비스에서는 이렇게 하지 않고, 벡터 DB의 '색인'(전부 비교하지 않고 가까운 후보만 빠르게 추리는 구조)을 씁니다.
한 고객사의 사내 문서 검색(수만 건 규모)에 KURE-v2 를 벡터 DB(Qdrant)의 다중 벡터 색인으로 그대로 넣어 봤습니다. 색인을 만드는 데만 2시간 43분이 걸렸습니다. 문장형 질문 200개로 정답이 8위 안에 들어온 수를 세니 결과는 이랬습니다.
KURE-v1: 151개
KURE-v2, 색인을 거친 경우: 134개
KURE-v2, 모든 문서와 직접 비교한 경우: 약 165개
직접 비교로는 1위였던 모델이 색인을 거치자 **한 단계 아래 모델보다 낮게** 나왔습니다. 다른 방식으로 후보를 먼저 추린 뒤 다시 순위를 매기는 구성을 붙이면 164개까지 되찾을 수는 있었습니다. 대신 검색 한 번이 KURE-v1 단독의 0.04초에서 0.15~0.24초로 늘고, 별도 실행 환경이 하나 더 필요했습니다. 되찾을 수는 있지만 그 대가로 비용이 붙습니다.
답 쓰는 단계 — 맥과 GPU 서버가 같은 수를 맞혔다
두 번째 단계도 같은 방식으로 쟀습니다. 노동법 질문 99문항을 두 환경에 똑같이 넣고 결론이 맞았는지를 셌습니다. 한쪽은 로컬 맥에서 LM Studio 로 돌린 Gemma 4 26B-A4B 이고, 다른 쪽은 H200 GPU 서버에서 vLLM 으로 돌린 더 큰 Gemma 4 31B 입니다. 둘 다 '생각 단계'(답하기 전에 추론 과정을 거치는 모드)를 켰습니다.
로컬 맥 | H200 GPU 서버 | |
|---|---|---|
모델 | Gemma 4 26B-A4B | Gemma 4 31B |
99문항 중 맞힌 수 | 49 | 48 / 50 (두 회차) |
맞힌 수는 사실상 같았습니다. 한쪽만 맞힌 문항 수도 6 대 7, 7 대 6 으로 엇갈려 통계적으로 차이가 없었습니다. 흥미로운 점은 맞힌 문항이 서로 달랐다는 것입니다. 어느 한쪽이 전체적으로 나은 것이 아니라 틀리는 자리가 달랐습니다. 채점은 어느 모델의 답인지 가리고 했고, 채점자 둘의 판정은 99문항 중 97문항에서 일치했습니다.
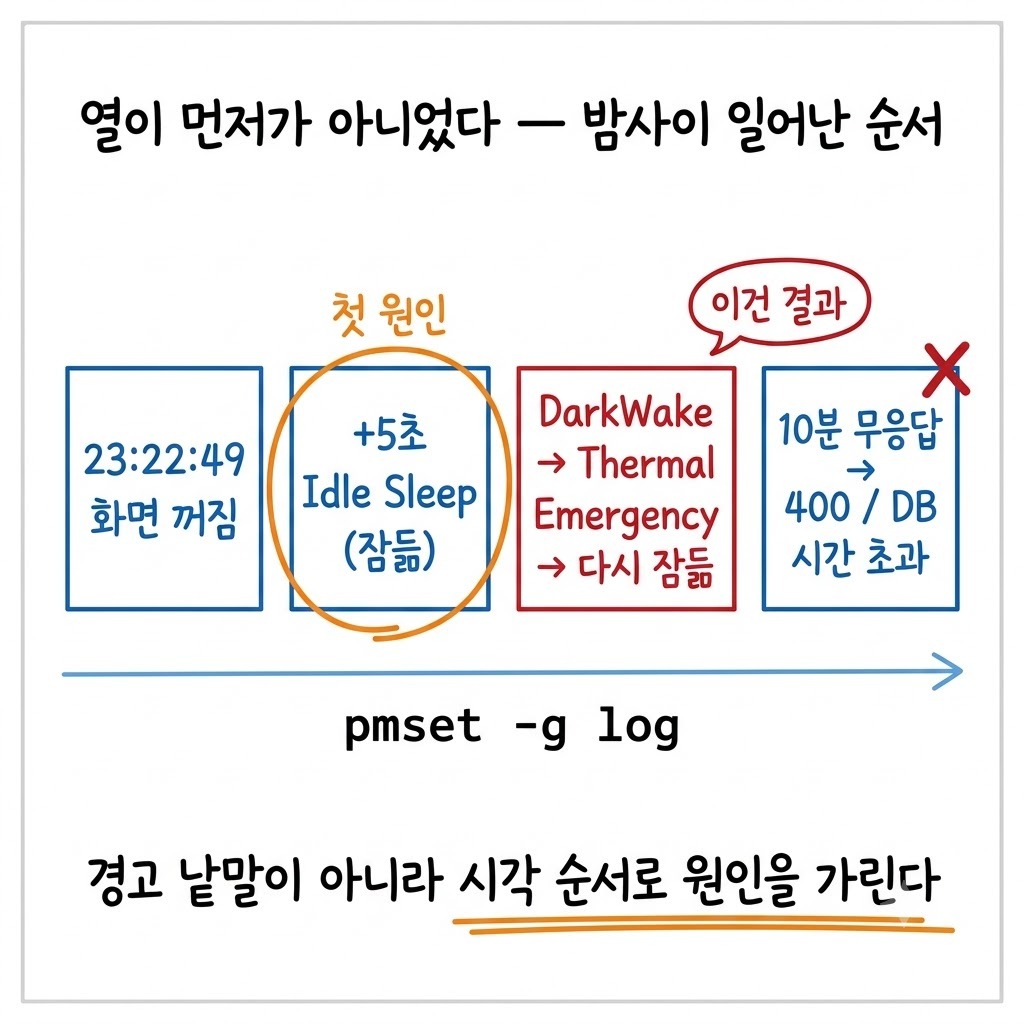
이 측정도 한 번에 끝나지는 않았습니다. 밤새 돌리던 맥이 잠들어 마지막 세 문항에서 멈췄고, 이어 돌리기로 마무리했습니다. 그 과정은 따로 정리해 두었습니다.
이 비교에서 저희가 중요하게 본 것은 '내 장비에서 돌릴 수 있는가'였습니다. 맥에서 도는 모델이 같은 점수를 내면, GPU 서버는 시작할 때 꼭 필요한 장비가 아니라 나중에 붙일 수 있는 선택지가 됩니다.
서버를 사기 전에 해 볼 순서
이 결과를 '작은 게 낫다'로 읽으면 안 됩니다. 조문 정확도가 가장 중요한 업무라면 법령검색처럼 KURE-v2 가 확실히 앞선 분야가 있었습니다. 저희도 운영 후보는 KURE-v1 으로 두고, 그런 곳에만 KURE-v2 를 다시 순위 매기는 구성으로 붙이기로 했습니다. 답 쓰는 AI는 로컬 26B 로 시작합니다. 사기 전에 해 볼 순서는 이렇습니다.
문서 AI를 찾는 단계와 답 쓰는 단계로 나눠서 생각합니다. 사양 고민은 단계마다 따로 합니다
내 문서로 질문 10~20개짜리 시험지를 만듭니다
찾는 모델은 가벼운 것과 1위 모델을 둘 다 재 봅니다. 차이가 어느 분야에서 나는지 봅니다
문서가 많으면 실제 서비스 구성, 즉 색인을 붙인 상태에서 다시 잽니다
답 쓰는 AI도 작은 것과 큰 것을 같은 시험지로 잽니다. 결과가 같으면 작은 쪽으로 시작합니다
이 측정이 말하지 않는 것
법 분야 시험지입니다. 다른 분야 문서에서도 같을지는 모릅니다
답 쓰는 쪽 비교는 노동법 99문항 하나이고, 실행 환경(LM Studio 와 vLLM)과 회차(1회와 2회)가 다릅니다
고객사 문서 실측에서 색인 설정값을 바꿔 가며 재지는 않았습니다. 134개가 더 오를 여지는 확인하지 않았습니다
그래서 이 글의 결론은 '큰 컴퓨터가 필요 없다'가 아닙니다. 이 시험지에서는 큰 쪽이 값만큼 낫지 않았다는 것까지입니다. 큰 모델과 큰 서버는 나중에 붙여도 됩니다. 작은 쪽으로 시작해서 시험지로 모자란 곳을 찾고, 그 자리에만 돈을 쓰는 편이 비용이 덜 듭니다. 어디에 돈을 쓸지는 내 문서로 단계마다 재 보고 정합니다.
같은 99문항으로 이번에는 지식그래프를 붙였다 떼며 다시 쟀습니다. 근거는 더 찾아왔지만 결론 정답률은 그대로였습니다.