회귀 테스트 두 문항이 떨어졌는데, 틀린 건 평가 스크립트였습니다
사내 문서 지식그래프 검색 도구의 채팅 기능에 회귀 평가 21문항을 두고 운영하고 있습니다. 문항마다 기대한 답을 적어 두고, 고칠 때마다 전부 다시 돌려 '맞음 / 부분 / 실패'를 셉니다. 고친 것이 좋아졌는지 나빠졌는지를 사람 감각 대신 숫자로 보려고 만든 장치입니다.
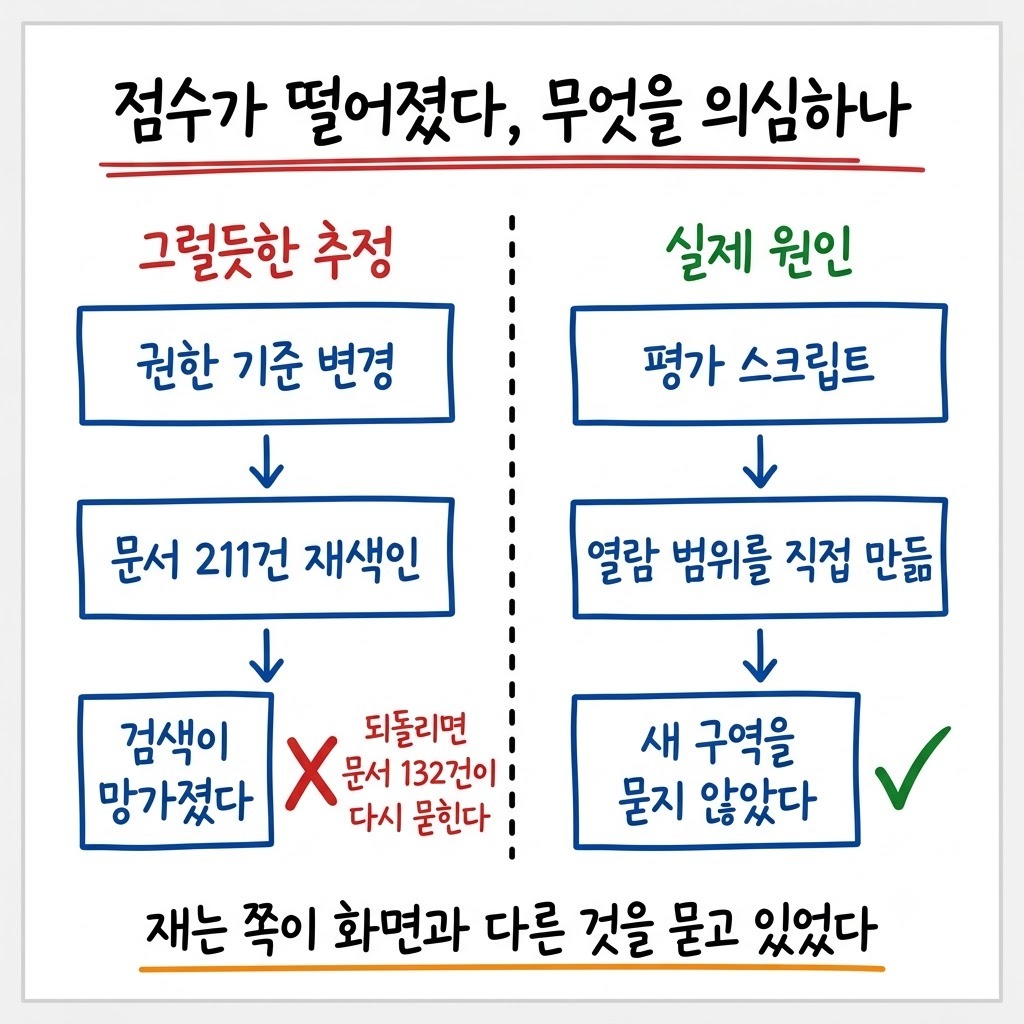
그날 권한 설계를 한 번 손보고 효과를 재려고 회귀를 다시 돌렸습니다. 21문항 중 두 건이 '맞음'에서 '확인되지 않습니다'로 떨어졌습니다. 그리고 떨어진 두 건은 하필 방금 제가 건드린 자리의 문서를 근거로 삼는 문항이었습니다.
떨어진 두 문항이 하필 방금 만진 자리였습니다
손본 내용은 열람 범위의 기준을 바꾸는 작업입니다. 그전에는 문서가 어느 협업 공간에 속했는지로 누가 볼 수 있는지를 정했습니다. 이걸 우리 화면에 실제로 보이는 구역 이름 기준으로 옮기고, 문서 211건을 다시 색인했습니다.
그러니 점수 하락은 설명이 너무 잘 됐습니다. '재색인이 뭔가를 망가뜨렸다', '범위 기준을 바꾸면서 일부 문서가 검색에서 빠졌다'는 식입니다. 무관한 문항이 떨어졌으면 그 자리에서 평가 쪽을 봤을 겁니다. 하지만 떨어진 두 건이 정확히 방금 만진 구역이었기 때문에 인과가 맞아 보였습니다.
그대로 믿었으면 재색인을 되돌렸을 겁니다. 그러면 그 작업으로 겨우 찾을 수 있게 된 문서 132건이 다시 아무도 못 찾는 자리로 돌아갔을 겁니다. 고친 것을 하락으로 읽고 되돌리는 쪽이 운영에서는 더 비쌉니다.
공통 함수를 부르는 네 번째 자리가 평가 스크립트였습니다
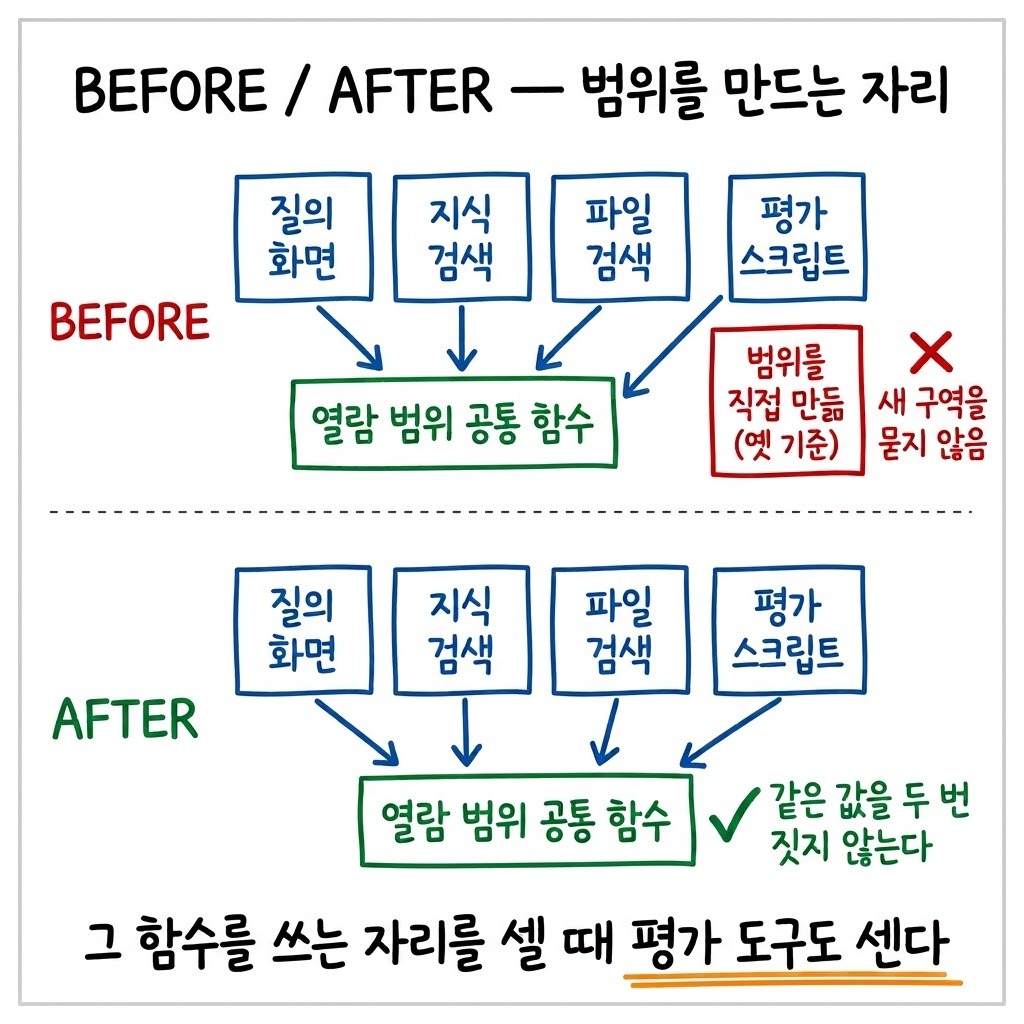
코드를 열어 보니 평가 스크립트가 열람 범위 목록을 스스로 만들고 있었습니다. 협업 공간 번호로만 범위를 짜 넣었고, 새로 생긴 구역 이름은 아예 묻지 않았습니다. 즉 평가 스크립트는 사용자가 화면에서 실제로 받는 결과가 아니라, 자기가 만든 옛 범위로 검색한 결과를 채점하고 있었습니다.
같은 날 범위 기준을 옮기면서 화면 쪽은 제대로 정리해 뒀습니다. 질의, 지식 검색, 파일 검색 세 화면이 열람 범위를 만드는 공통 함수 하나를 부르게 묶었습니다. 그 함수를 쓰는 자리를 셀 때 화면 세 곳만 센 것이 문제였습니다. 평가 스크립트가 네 번째 자리였고, 하필 그 자리가 고친 것을 못 보는 쪽이 됐습니다.
같은 회차에서 좋아진 것도 못 봤습니다. 한 문항은 기대한 답을 새로 찾아냈는데, 하락 두 건에 묻혀 눈에 들어오지 않았습니다. 재는 쪽이 틀리면 점수는 한 방향으로만 틀리지 않습니다. 고친 것이 하락으로도, 상승으로도 보입니다.
고친 방법은 단순합니다. 평가 스크립트가 범위를 직접 만들던 코드를 지우고, 화면이 부르는 그 공통 함수를 그대로 부르게 했습니다. 화면이 답에 붙여 주는 참고 자료도 똑같이 붙였습니다. 답을 가르는 입력을 두 군데서 만들지 않는 것이 요점입니다.
급히 만든 판정이 두 건을 오탐했습니다
하락 원인을 좁히려고 그 자리에서 간단한 판정 규칙을 하나 만들었습니다. 답변 안에 '확인되지 않'이라는 표현이 들어가면 실패로 센다는 문구 매칭입니다. 21문항을 매번 사람이 읽을 수는 없으니 후보를 줄이는 용도였습니다.
그 판정이 두 건을 오탐했습니다. 한 건은 오히려 더 좋아진 답이었습니다. 근거 문서를 정확히 찾아 놓고, 끝에 솔직한 한계 표시를 한 줄 붙인 것이 걸렸습니다.
진행 중인 업무라 완료 여부는 확인되지 않습니다
이 문장은 좋은 답변의 특징입니다. 모르는 것을 모른다고 적은 답이 문구 매칭 때문에 실패로 잡혔습니다. 내부 검수 절차 문서에 이미 경고로 적어 둔 자리였는데도 같은 데를 밟았습니다. 그래서 규칙을 하나 더 적는 대신 쓰는 범위를 좁혔습니다. 자동 판정은 사람이 읽을 후보를 줄이는 데만 쓰고, 결론은 원문을 본 사람이 냅니다.
이걸 지키지 않으면 점수 자체를 아무도 쓰지 않게 됩니다. 근거가 그대로인데 핵심 낱말만 다르게 쓰인 답을 '나빠짐'이라고 부르기 시작하면, 다음부터 팀 안의 누구도 그 점수를 안 봅니다.
바로 다음 작업에서 같은 종류를 또 밟았습니다
교훈을 기록에 적은 바로 다음 작업에서 같은 종류를 한 번 더 밟았습니다. 검수 2차 결과를 1차와 대 보려고 표를 나란히 놓다가, 두 회차의 조건이 셋이나 다른 것을 발견했습니다.
재는 엔진이 개발 환경에서 운영 환경으로 옮겨졌습니다
열람 범위 규칙이 그사이에 바뀌었습니다
답에 붙이는 참고 자료가 달라졌습니다
이번에는 방향이 반대였습니다. 네 문항이 '좋아짐'으로 보였습니다. 그중 둘에는 제가 '새로 올린 파일 덕에 저절로 고쳐졌다'고 적어 두기까지 했습니다. 그 파일을 열어 보니 그 글자는 원래부터 있었고, 개발 환경에서만 검색 결과가 0건이었습니다. 그 재색인을 운영 환경에서만 돌린 탓입니다.
그래서 좋아짐 네 건을 '확인 안 됨'으로 내렸습니다. 전후 비교는 조건이 하나만 달라야 근거가 됩니다. 조건이 여럿 바뀐 두 회차에서는 하락도 상승도 근거가 못 되고, 좋아 보이는 쪽을 같이 버리는 것이 정상입니다. 기록에는 믿을 수 있는 수치는 마지막 회차뿐이라고 적었습니다. 그 회차 숫자가 맞음 18 · 부분 2 · 실패 1 입니다.
규칙을 더 적는 대신 그 자리를 없앴습니다
같은 종류를 이틀에 두 번 밟고 나서 정리한 것은 네 가지입니다. 규칙 문서를 한 줄 늘리는 쪽이 아니라, 틀릴 수 있는 자리를 아예 없애는 쪽으로 골랐습니다.
평가 도구는 화면이 부르는 함수를 그대로 부릅니다. 열람 범위처럼 답을 가르는 입력을 두 군데서 만들지 않습니다
평가 스크립트를 버전 추적 대상에 넣었습니다. 추적 밖에 있으면 고쳐도 다음 사람 기계에는 옛 기준이 남습니다
회귀는 운영 엔진에 붙여 돌립니다. 앞 두 회차는 개발 환경 엔진을 재고 있어서 재색인도, 새로 올린 문서도 보지 못했습니다
다음 작업에서 답에 붙이는 자료를 바꿀 때 평가 도구에도 같이 붙였습니다. 네 번째 자리를 또 만들지 않으려는 조치입니다
반대로 평가 도구가 화면 함수를 그대로 불러서는 안 되는 때도 있습니다. 검색 엔진만 따로 재려고 만든 평가는 화면이 붙이는 자료를 일부러 빼고 돌립니다. 그때는 무엇을 안 붙였는지를 도구 머리말에 적어 두는 쪽이 맞습니다. 다만 그 도구가 낸 숫자를 화면 품질이라고 말하면 안 됩니다.
조건을 하나만 바꿔 재는 것이 늘 가능하지도 않습니다. 배포가 묶여 한꺼번에 나가면 회차가 통째로 섞입니다. 그때 할 수 있는 것은 이 회차 점수는 쓰지 않는다고 적어 두는 것이고, 그게 손실이 아니라 정상입니다.
도입 검토자용 점검 항목
평가 지표를 운영에 쓰는 팀이라면, 지표를 늘리기 전에 아래 네 가지를 먼저 봐도 좋습니다.
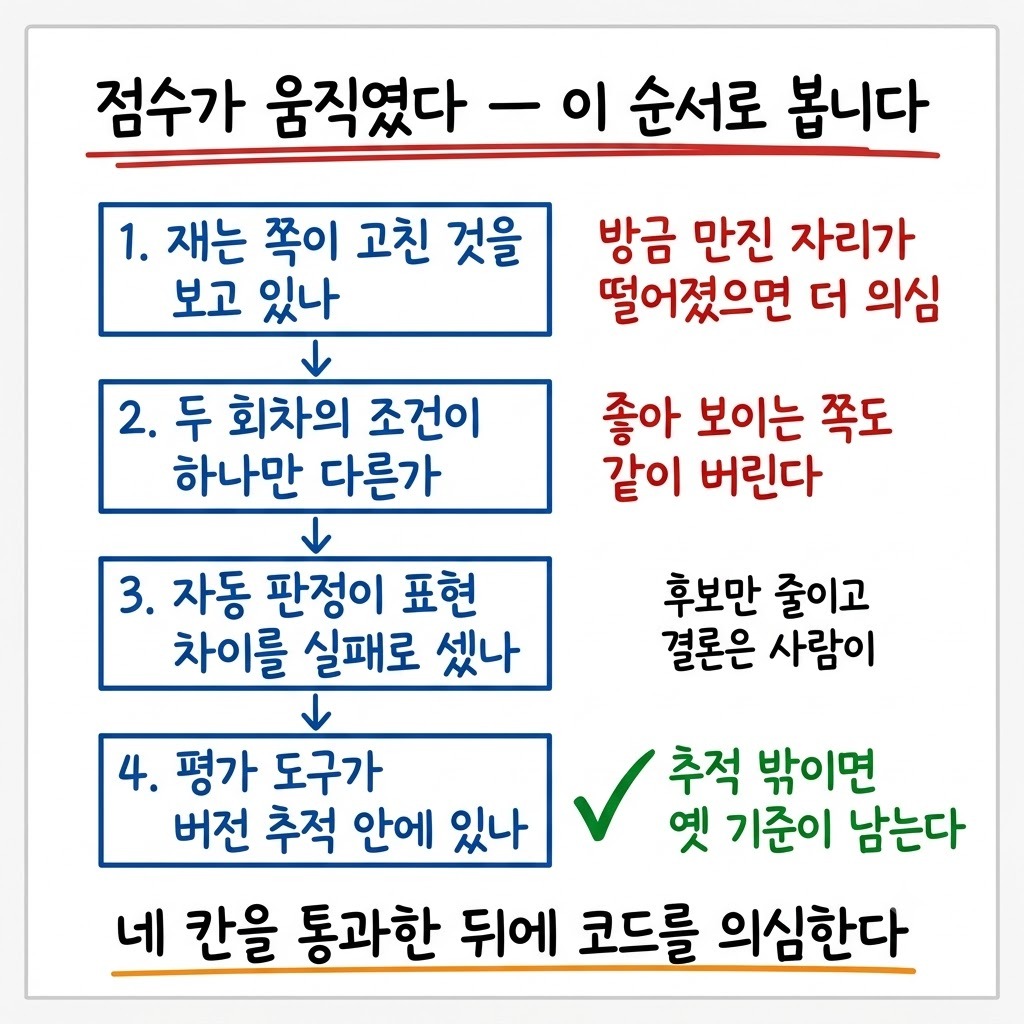
평가 도구가 사용자 화면과 같은 코드를 지나가는지 확인합니다. 지나가지 않으면 그 점수는 사용자 경험이 아니라 다른 것을 재는 숫자입니다
답을 가르는 입력을 만드는 함수의 사용처를 셀 때 화면뿐 아니라 평가·배치·명령줄 도구까지 셉니다
전후 비교 보고에 조건이 몇 개 달랐는지를 같이 적습니다. 둘 이상이면 점수를 비교에 쓰지 않습니다
평가 도구가 버전 추적 안에 있는지 봅니다. 추적 밖이면 고친 것이 다음 사람에게 가지 않습니다
측정 도구를 먼저 의심하는 태도는 다른 글에서도 같은 자리로 돌아옵니다. 문서 읽기 도구 다섯 개를 같은 기준으로 다시 재면서 결론이 두 번 뒤집힌 기록이 있습니다.
원인을 말하기 전에 재는 순서도 같습니다. 느린 이유를 먼저 단정하고 나서 실제로 측정했던 기록은 아래에 있습니다.
회귀 점수가 움직이면 무엇이 바뀌었는지보다 재는 쪽이 그걸 보고 있었는지를 먼저 봅니다. 떨어진 항목이 방금 만진 자리면 인과가 맞아 보이기 때문에 더 의심하는 편이 안전합니다. 저는 이 순서를 이틀에 두 번 틀리고 나서야 평가 스크립트를 화면과 같은 코드 위에 올려 뒀습니다.