제안서의 '그래프 적용', Graph API·그래프 DB·온톨로지 중 무엇을 말하는지부터 봅니다
문서 검색 AI를 검토하다 보면 제안서와 소개 자료에서 '그래프'라는 말을 자주 만납니다. Microsoft Graph, 그래프 DB, 지식그래프처럼 이름도 비슷합니다.
이름이 비슷해도 하는 일은 다릅니다. Microsoft 공식 문서(learn.microsoft.com/graph/overview, 2026-04-15판 기준)는 Microsoft Graph 를 Microsoft 365 데이터로 들어가는 gateway, 즉 통로로 정의합니다. 데이터를 저장하는 DB 가 아니라 데이터에 접근하는 API 입니다.
'그래프'라는 말에는 서로 다른 세 가지가 섞이기 쉽습니다. 데이터를 가져오는 통로, 관계를 담는 저장소, 뜻을 정하는 정의서입니다.
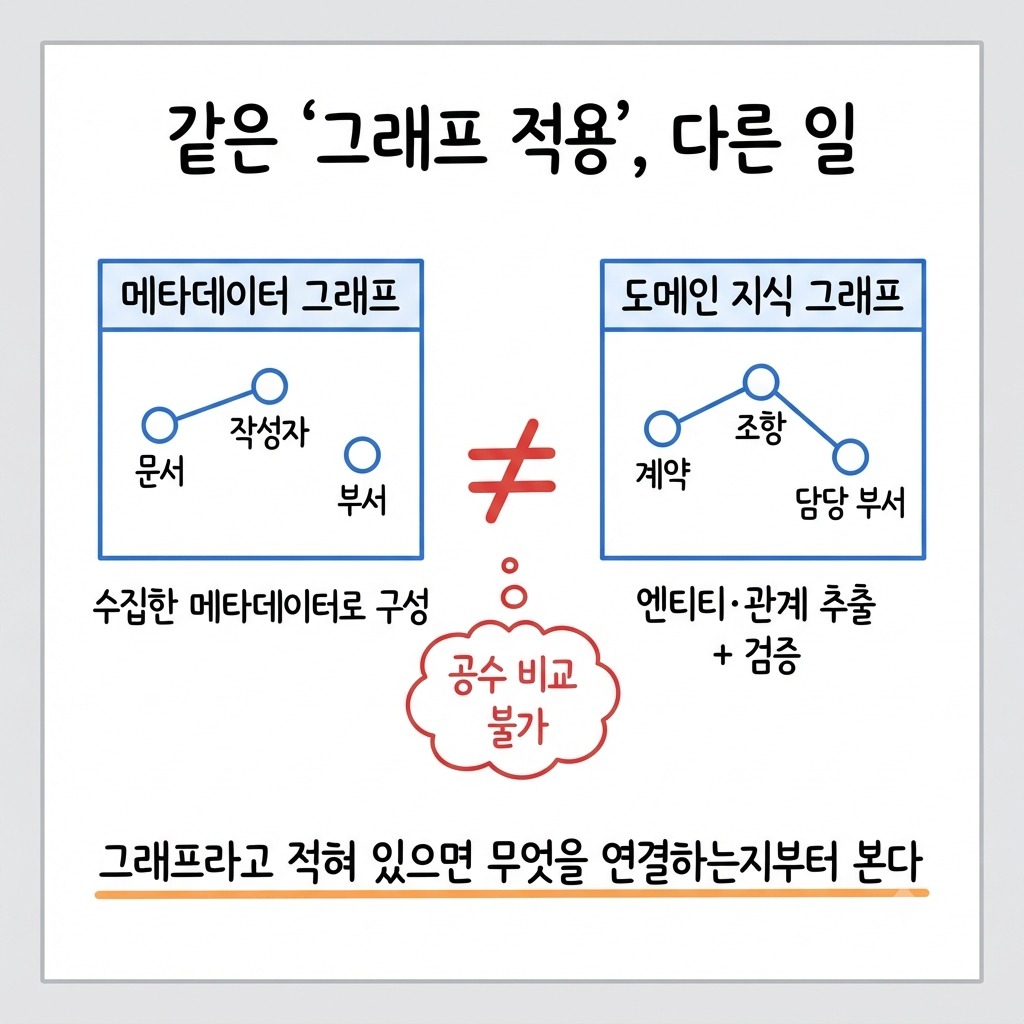
셋을 같은 '그래프'로 읽으면 구축 공수와 효과를 잘못 비교하게 됩니다. 한쪽은 수집한 정보를 연결하는 일이고 다른 쪽은 문서 내용에서 대상을 추출해 검증하는 일인데, 이름이 같으면 같은 일처럼 보입니다.
세 가지는 맡는 일이 다릅니다
먼저 이름별로 맡는 일을 나눠 보겠습니다.
이름 | 역할 | 맡는 일 |
|---|---|---|
Microsoft Graph API | Microsoft 365 데이터에 접근하는 통로 | SharePoint 파일·권한·조직 정보 조회 |
그래프 DB(Neo4j 등) | 관계 저장과 탐색 | 누가 누구와 연결되어 있는지 조회 |
온톨로지 | 개념과 규칙의 정의 | 그것이 무엇을 의미하는지 정의하고 추론의 근거가 됨 |
셋은 서로를 대신하지 않습니다. Graph API 로 가져온 정보의 일부를 그래프 DB 에 저장합니다. 온톨로지는 저장된 것들이 무슨 뜻이고 어떤 규칙을 따르는지를 따로 정의합니다.
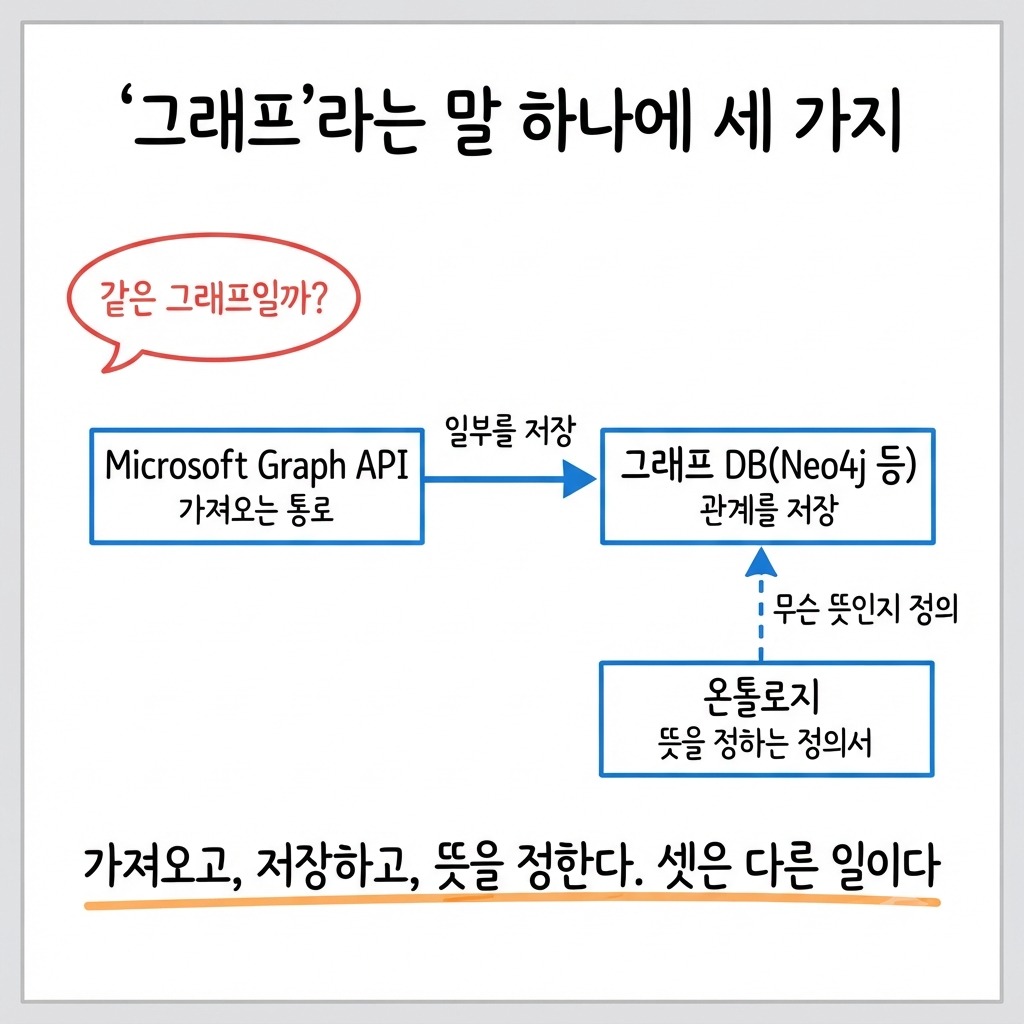
이렇게 나누면 구성도를 읽을 때 칸마다 묻는 말이 달라집니다. 통로 칸에는 어떤 데이터를 가져오는지, 저장소 칸에는 무엇을 연결하는지, 정의서 칸에는 누가 설계하는지를 묻게 됩니다.
가져오는 일과 담는 일은 다릅니다
Microsoft Graph API 는 SharePoint 의 파일과 권한, 조직 정보를 조회하는 API 입니다. 호출한다고 해서 관계 그래프가 어딘가에 쌓이지는 않습니다. 가져온 결과를 어디에 어떤 모양으로 저장할지는 별도의 설계입니다.
'Graph'라는 낱말이 같다고 두 칸을 하나로 합치면 빠지는 것이 생깁니다. 수집 작업과 저장소 구축이 한 줄로 묶이고, 저장소를 운영하는 일은 구성도에서 보이지 않습니다.
담는 일과 뜻을 정하는 일도 다릅니다
그래프 DB 는 대상과 대상 사이의 연결을 저장하고 경로를 탐색합니다. Neo4j 는 LPG(Labeled Property Graph, 노드와 관계에 레이블과 속성을 저장하는 데이터 구조)를 씁니다.
저장소인 만큼 운영하는 일도 따로 생깁니다. 저희도 그래프 DB 가 응답을 멈춘 일을 겪었습니다.
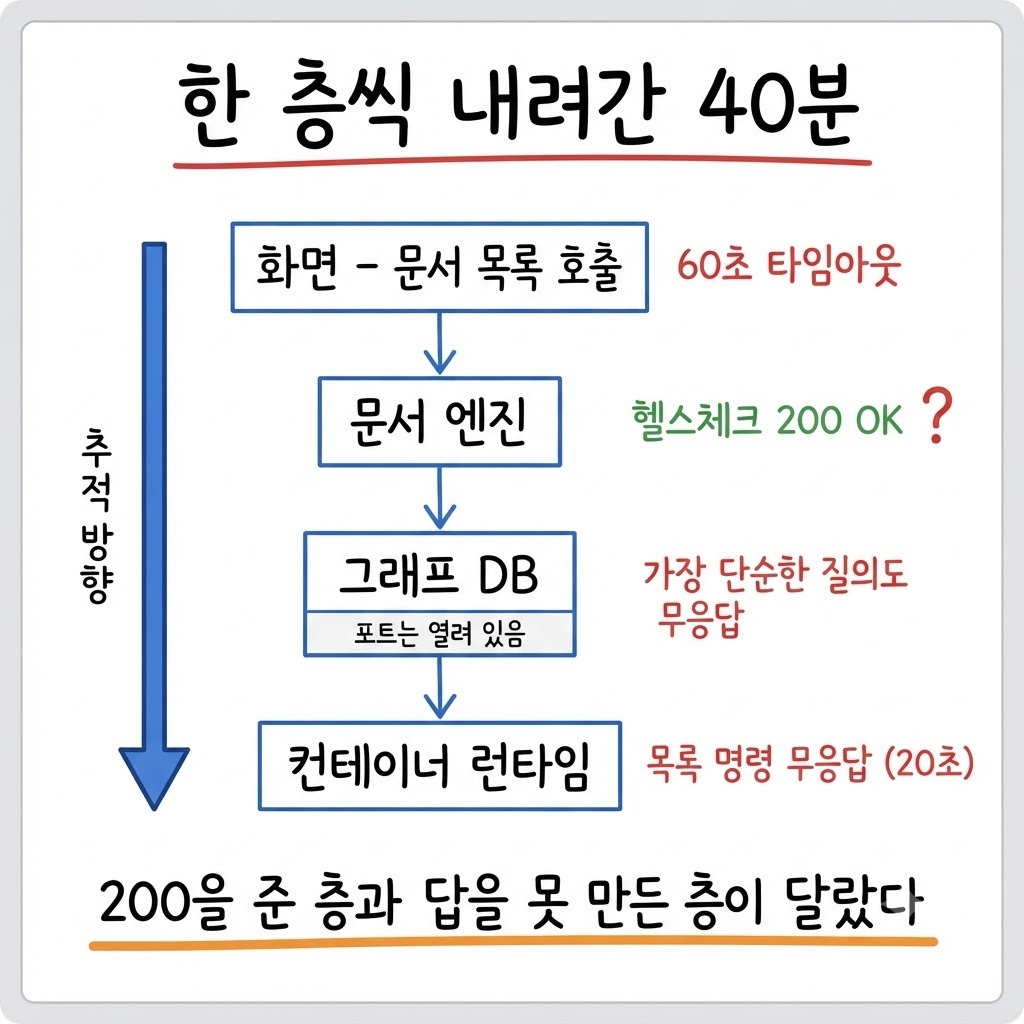
온톨로지는 저장소가 아닙니다. 어떤 개념이 있고 그 개념들이 어떤 규칙을 따르는지 사람이 설계한 정의서입니다. 보통 RDF/OWL(개념과 관계의 의미를 형식적으로 기술하는 표준)로 적습니다.
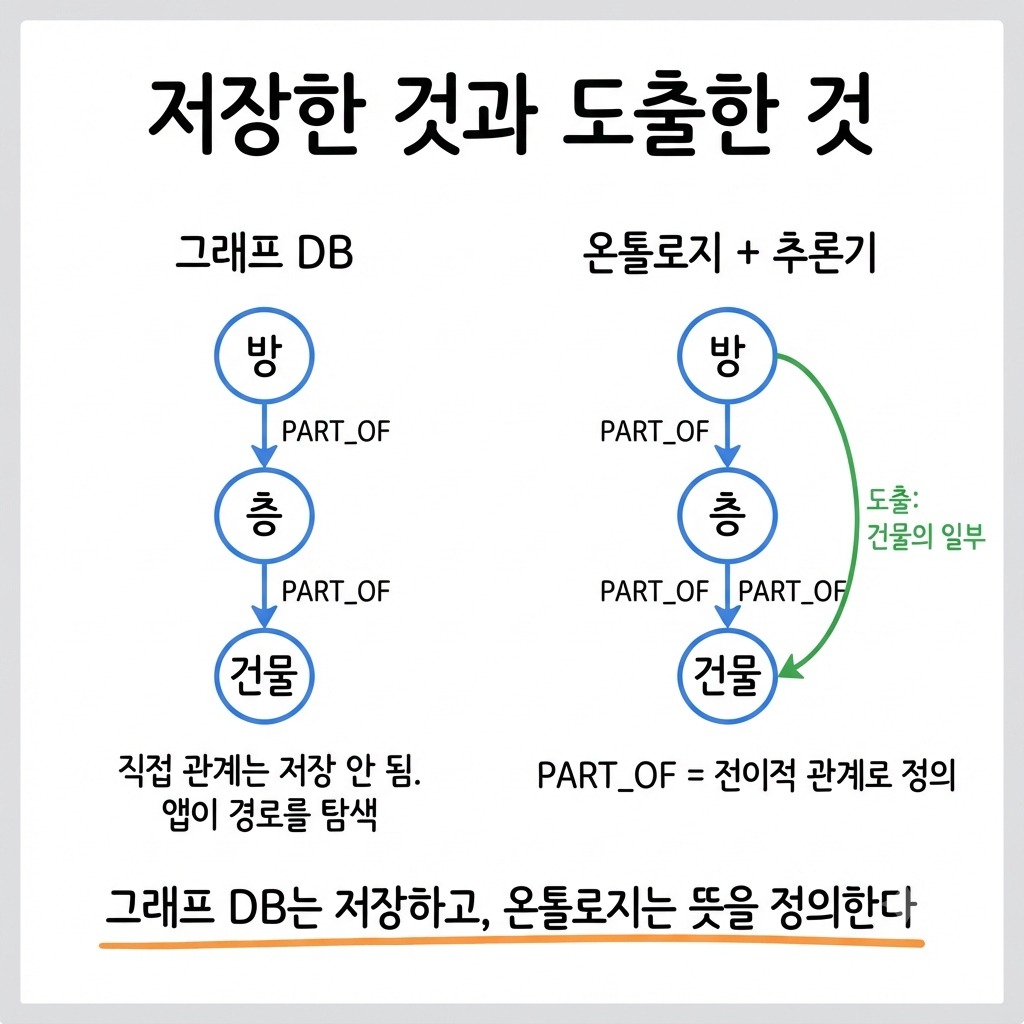
설명용 예시로 차이를 보겠습니다. 그래프 DB 에 아래 두 관계를 저장했다고 하겠습니다.
방 -[PART_OF]-> 층
층 -[PART_OF]-> 건물
여기에는 방과 건물의 직접 관계가 저장되어 있지 않습니다. 방이 건물의 일부인지 알려면 애플리케이션이 경로를 탐색해 판단합니다.
온톨로지에서 PART_OF 를 '전이적 관계'(A가 B의 일부이고 B가 C의 일부이면 A도 C의 일부)로 정의하면 달라집니다. 추론기가 저장되지 않은 '방은 건물의 일부'라는 사실을 도출합니다. 추론기는 정의된 규칙으로 새 사실을 도출하는 프로그램으로, Jena·Pellet·HermiT 등이 있습니다.
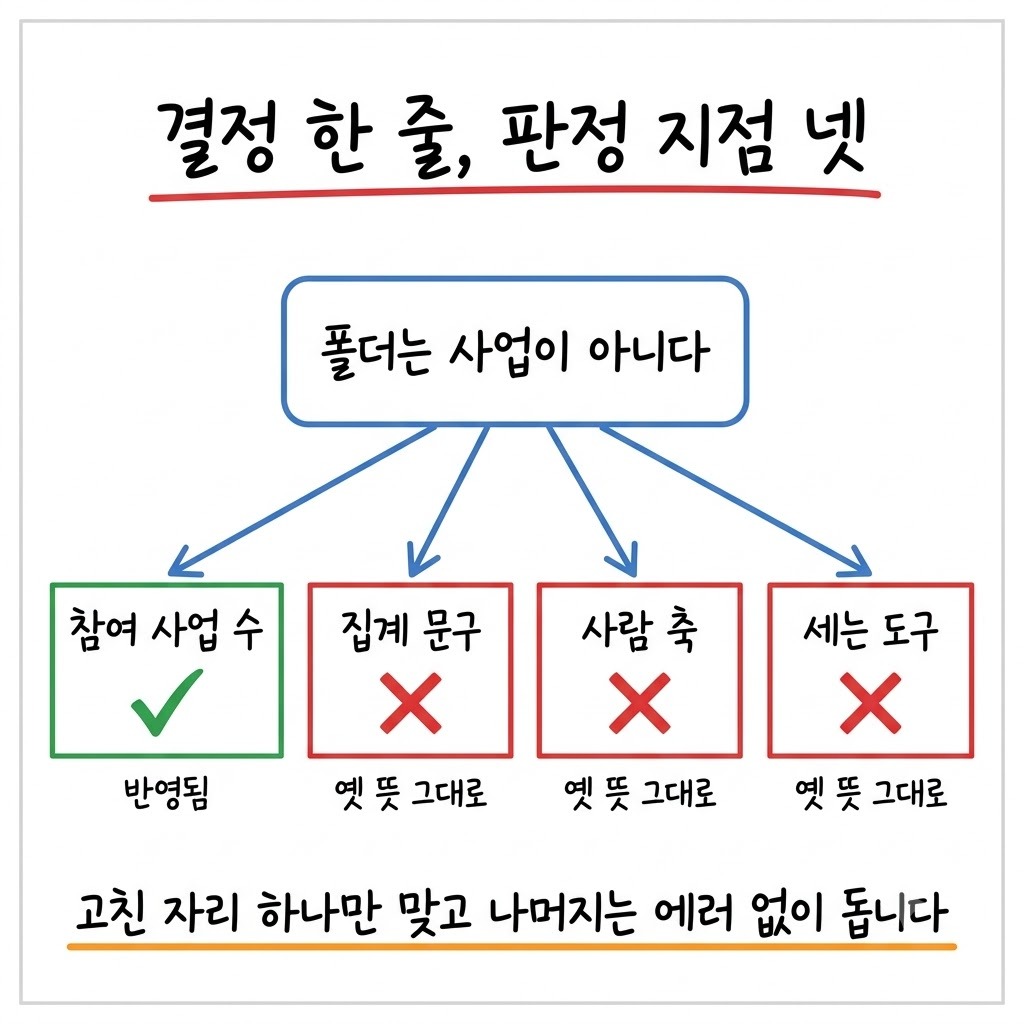
정의서라는 성격 때문에 생기는 일도 있습니다. 뜻을 하나 바꾸면 그 뜻을 쓰던 판정 지점을 모두 찾아 맞춰야 합니다.
낱말 선택도 영향을 줍니다. 온톨로지를 '모델'이라고 적으면 학습된 AI 모델이나 사야 하는 제품으로 읽힙니다. '온톨로지 스키마(RDF/OWL)'로 적으면 사람이 설계한 정의서라는 사실이 그대로 전달됩니다.
Neo4j 와 OWL 추론의 관계는 확인이 더 필요합니다. 한 실무자의 공개 글(2025년 2월, 한국어 번역본)이 한계를 지적했지만, 저희가 직접 실험하지는 않았습니다. 그래서 불가능하다고 단정하지 않습니다.
다만 Neo4j 만으로 OWL 추론이 된다고도 적지 않습니다. 외부 추론 결과를 적재하는 구성으로 적습니다. 그 글의 원문 댓글에는 Neosemantics(n10s) 라이선스 조건에 대한 지적도 있었습니다. 도입 전에 확인할 항목입니다.
그래프 DB 안에서도 두 종류로 나뉩니다
셋을 나눠도 구분할 것이 하나 더 남습니다. 같은 그래프 DB 안에서도 무엇을 연결하느냐에 따라 필요한 일이 달라집니다.
구분 | 메타데이터 그래프 | 도메인 지식 그래프 |
|---|---|---|
연결하는 것 | 문서·작성자·부서·버전 | 계약·조항·담당 부서처럼 문서 내용의 대상 |
만드는 데 필요한 일 | 수집한 메타데이터로 구성 | 엔티티·관계 추출과 검증 |
답할 수 있는 질문의 예 | 이 문서를 어느 부서가 작성했는가 | 이 조항이 어떤 계약과 연결되는가 |
엔티티는 문서에 등장하는 대상입니다. 계약, 조항, 담당 부서 같은 것입니다. 도메인 지식 그래프는 문서 안에서 이 대상과 관계를 추출하고, 추출이 맞는지 검증하는 단계가 따로 필요합니다.
같은 '그래프 적용'이라는 말도 한쪽은 메타데이터 그래프이고 다른 쪽은 도메인 지식 그래프일 수 있습니다. 필요한 작업이 달라서 공수와 효과를 나란히 비교할 수 없습니다.
구분하는 방법은 문서 내용에서 대상과 관계를 추출하고 검증하는 단계가 있는지 보는 것입니다. 그 단계가 없으면 문서 내용의 대상을 연결한 그래프는 나오기 어렵습니다.
그래프의 효과는 좁게 말합니다
저희가 노동법 99문항으로 자체 측정했을 때, 그래프를 붙이자 정답 조문이 검색 결과에 포함된 문항이 65개에서 74개로 늘었습니다. 결론을 맞힌 문항은 48~50개로 유의한 변화가 없었습니다.
근거를 찾는 일은 나아졌지만 결론 정답률은 달라지지 않았다는 뜻입니다. 그래서 저희는 그래프가 환각을 없앤다고 쓰지 않습니다.
이 측정은 법령 조문과 판례의 인용 관계로 한 것입니다. 다른 문서, 다른 종류의 그래프에도 같은 결과가 나온다고 말할 수 없습니다. 온톨로지를 적용했을 때 답변 품질이 얼마나 달라지는지는 저희 데이터로 측정한 적이 없습니다.
제안서를 읽을 때와 쓸 때 확인하는 것
제안서에서 '그래프를 쓴다'는 문장을 보면 아래 세 가지를 물어볼 수 있습니다.
데이터를 어디서 가져오는가 (예: Microsoft Graph API 로 SharePoint 에서)
관계를 어디에 저장하는가 (예: Neo4j 같은 그래프 DB)
무엇을 연결하는가 (문서 정보인가, 문서 내용인가)
자료를 쓰는 쪽에서 저희는 아래 네 가지를 기준으로 삼습니다.
수집 API 와 관계 저장소는 다른 칸에 적습니다
'그래프 적용'이라고 쓸 때 메타데이터 그래프인지 도메인 지식 그래프인지 밝힙니다
Neo4j 만으로 OWL 추론이 된다고 쓰지 않고, 외부 추론 결과를 적재하는 구성으로 적습니다
그래프가 환각을 제거한다고 쓰지 않습니다
이 구분은 제안서와 소개 자료를 읽을 때의 기준입니다. 이미 세 가지를 나눠 쓰는 팀에는 새로운 이야기가 아닙니다.
기술 이름을 적을 때 그 이름이 맡는 일까지 같이 적으면 비슷한 이름이 같은 것으로 읽히지 않습니다. 같은 이름의 두 사례를 비교할 때는 같은 것을 가리키는지부터 봅니다. 그 확인 한 번으로 공수 비교의 출발점이 맞춰집니다.