RAG를 하루에 세 번 멈춰 세우며 올린 이유
운영에 들어갈 RAG는 한 번에 다 지으면 위험합니다. 임베딩과 검색과 재정렬을 한 덩어리로 올려 두면, 나중에 검색 품질이 떨어졌을 때 어느 단계가 문제인지 짚을 근거가 남지 않습니다. 검증 없이 쌓은 층은 무너질 때 통째로 무너집니다.
그래프 DB 기반의 내부 프로젝트 관리 도구에 RAG를 붙인 회고를 정리했습니다. 같은 날 세 단계로 나눠 올렸고, 각 단계 사이에 검증을 끼워 넣었습니다. 결과만 보면 벡터 검색에 Hybrid Retrieval과 LLM rerank까지 얹은 구성이지만, 중요한 것은 그 순서였습니다.
한 번에 다 짓지 않고 세 정지점으로
RAG를 한 스프린트에 완성하려는 유혹은 큽니다. 임베딩 파이프라인과 벡터 DB와 검색기와 재정렬을 몰아 넣으면 데모는 그럴듯하게 나옵니다. 문제는 그다음입니다. 검색이 엉뚱한 문서를 물어 왔을 때, 임베딩 모델 탓인지 검색 방식 탓인지 재정렬 탓인지 분리할 수가 없습니다.
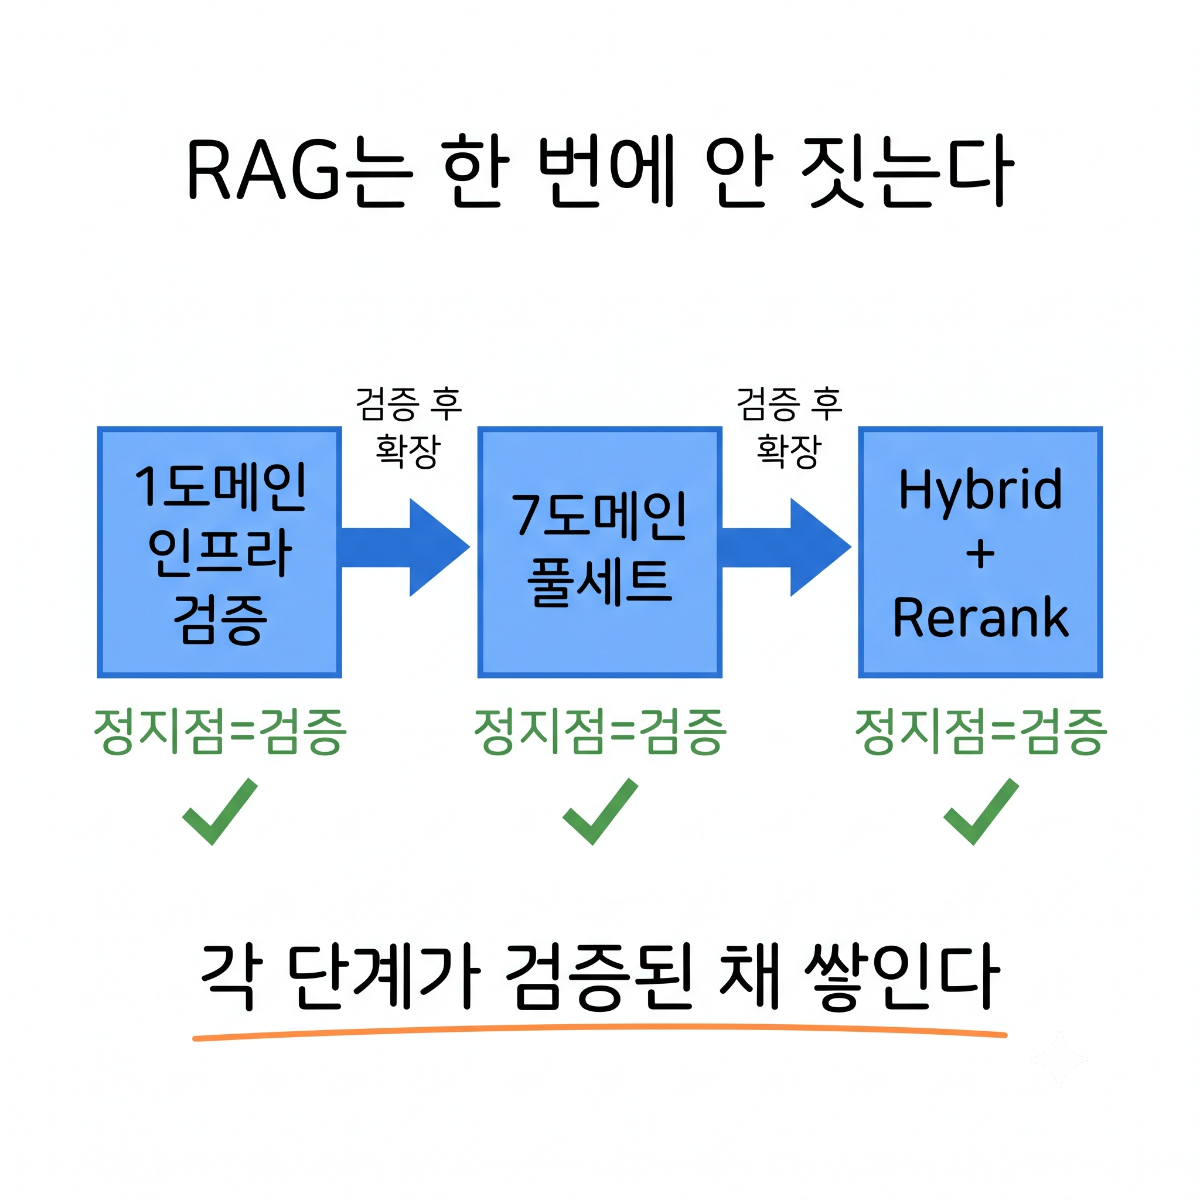
그래서 세 개의 정지점을 뒀습니다. 도메인 하나로 인프라만 검증하고, 7도메인 풀세트로 확장한 뒤, 마지막에 Vector와 Graph와 Fulltext를 결합하고 LLM rerank를 얹었습니다. 각 정지점은 다음 단계로 넘어가기 전에 반드시 확인해야 할 질문 하나씩을 갖고 있었습니다.
1단계, 메모 한 건으로 인프라만 검증하다
첫 단계는 인프라 검증이었습니다. Qdrant 1.14.1을 새로 띄우고, notes 컬렉션 하나를 1536차원 cosine으로 만들었습니다. 임베딩 모델은 Gemini의 gemini-embedding-001이고, MRL로 1536차원을 뽑았습니다. 여기까지 네 시간이 걸렸습니다.
핵심은 도구 호출 없이 메모가 컨텍스트에 끼어드는 구조였습니다. Note를 등록하거나 수정할 때 임베딩 서버를 호출해 Qdrant에 적재하고, AI 채팅이 프로젝트 맥락을 인식하면 사용자 질문을 임베딩해 관련도가 높은 메모를 응답 앞에 자동으로 붙였습니다. LLM이 검색 도구를 쓸지 판단하지 않아도 메모가 이미 컨텍스트에 들어와 있는 것, 그게 가장 큰 가치였습니다.
임베딩 적재는 best-effort로 뒀습니다. Qdrant 호출이 실패해도 본 흐름을 깨지 않고, 실패한 건은 나중에 백필로 회복합니다. 메모 저장이 벡터 DB 사정 때문에 막히는 상황은 피해야 했습니다.
Note를 등록하면 Qdrant의 points_count가 자동으로 늘고 줄었습니다
새 노트를 넣고 질문하면 응답이 해당 노트를 인용했습니다
2단계, 7개 도메인으로 넓히자 검증이 가능해지다
메모 한 건만 임베딩된 상태로는 RAG를 검증할 수 없었습니다. 검색 대상이 하나뿐이면 top-K도 rerank도 의미가 없습니다. 그래서 풀세트로 넓혔습니다.
도메인이 늘기 전에 공통 추상화를 먼저 잡았습니다. 임베딩 서버에 도메인별 라우터를 두고, 백엔드에는 도메인 enum과 제네릭 클라이언트 메서드를 뒀습니다. Qdrant에는 노트, 노하우, 플랜, 회의록, QnA, 역량, 요구사항 일곱 개 컬렉션을 만들고, 각 도메인 서비스의 생성·수정·삭제에 임베딩 훅을 걸었습니다. 도메인별 일괄 임베딩용 백필 도구도 함께 만들었습니다. 여섯 시간이 걸렸습니다.
확장하고 나서 원본 노드 수와 Qdrant 포인트 수를 맞춰 봤습니다. 대부분 정확히 일치했지만 플랜 도메인에서 드리프트가 나왔습니다.
도메인 | 노드 | Qdrant | drift |
|---|---|---|---|
노트 | 2 | 2 | 0 |
노하우 | 7 | 7 | 0 |
회의록 | 11 | 11 | 0 |
QnA | 37 | 37 | 0 |
역량 | 4 | 4 | 0 |
요구사항 | 38 | 38 | 0 |
플랜 | 647 | 636 | 11 |
플랜의 드리프트 11건은 원인이 뚜렷했습니다. 부모를 잃은 고아 플랜 9건, 본문이 빈 1건, Gemini 타임아웃 1건이었습니다. 숫자만 보면 불일치지만, 각각은 정상적인 사유가 있는 불일치였습니다.
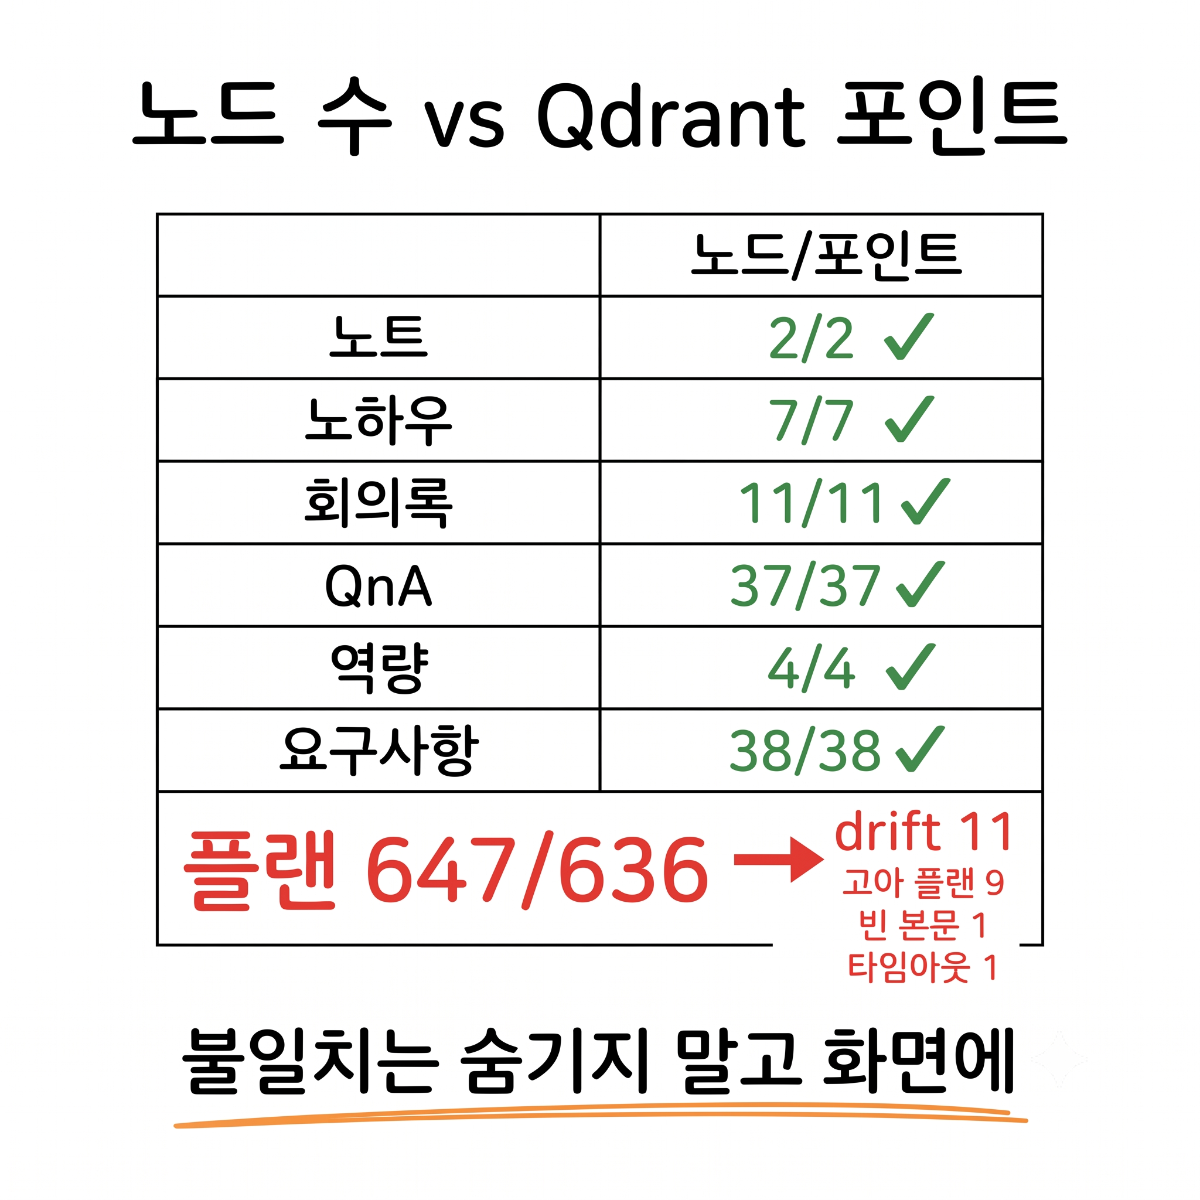
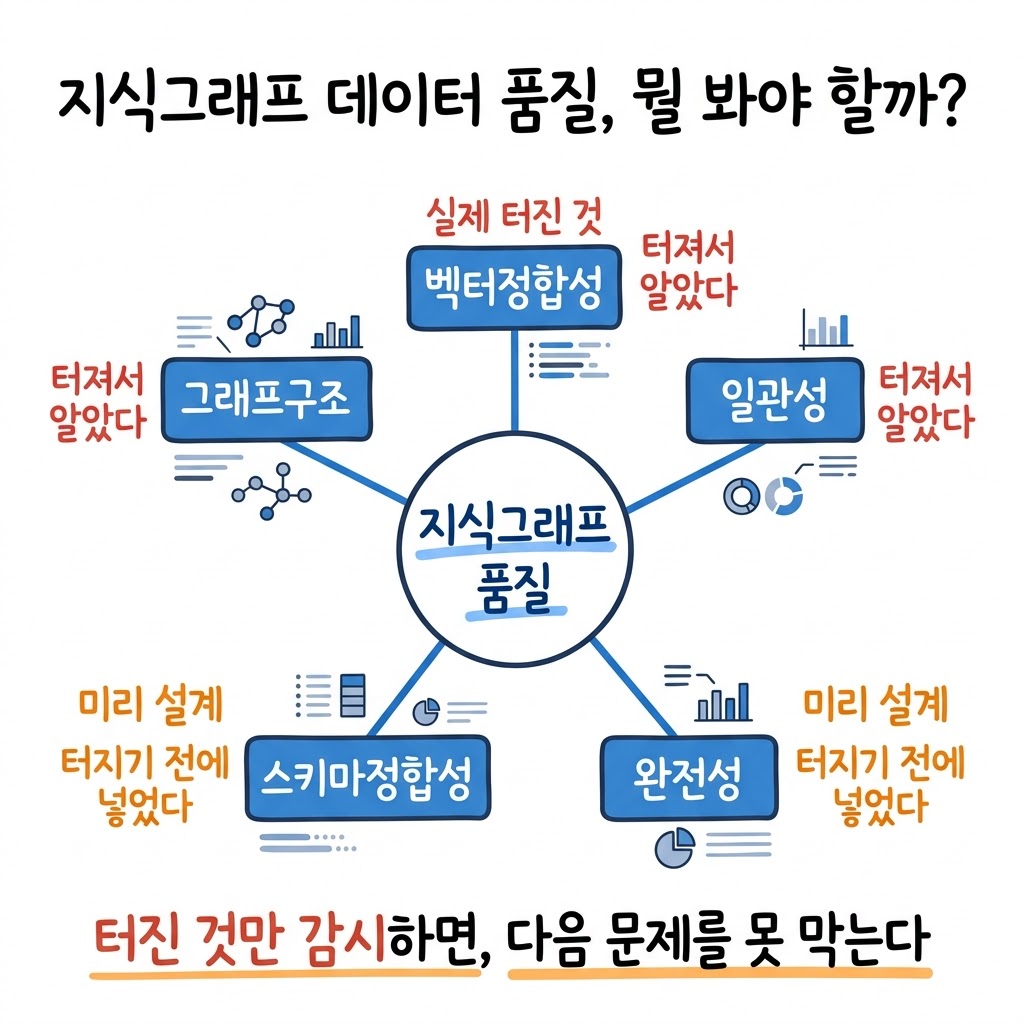
그래서 이 드리프트를 숨기지 않고 운영 화면에 그대로 드러냈습니다. 도메인별 드리프트 수와 임베딩 모델 정보와 백필 버튼과 통계를 한 화면에 뒀습니다. 불일치가 0인지 아닌지, 0이 아니면 왜인지를 운영자가 즉시 볼 수 있어야 벡터 DB와 원본 사이의 신뢰가 유지됩니다.
3단계, 벡터 top-K만으로는 부족했다
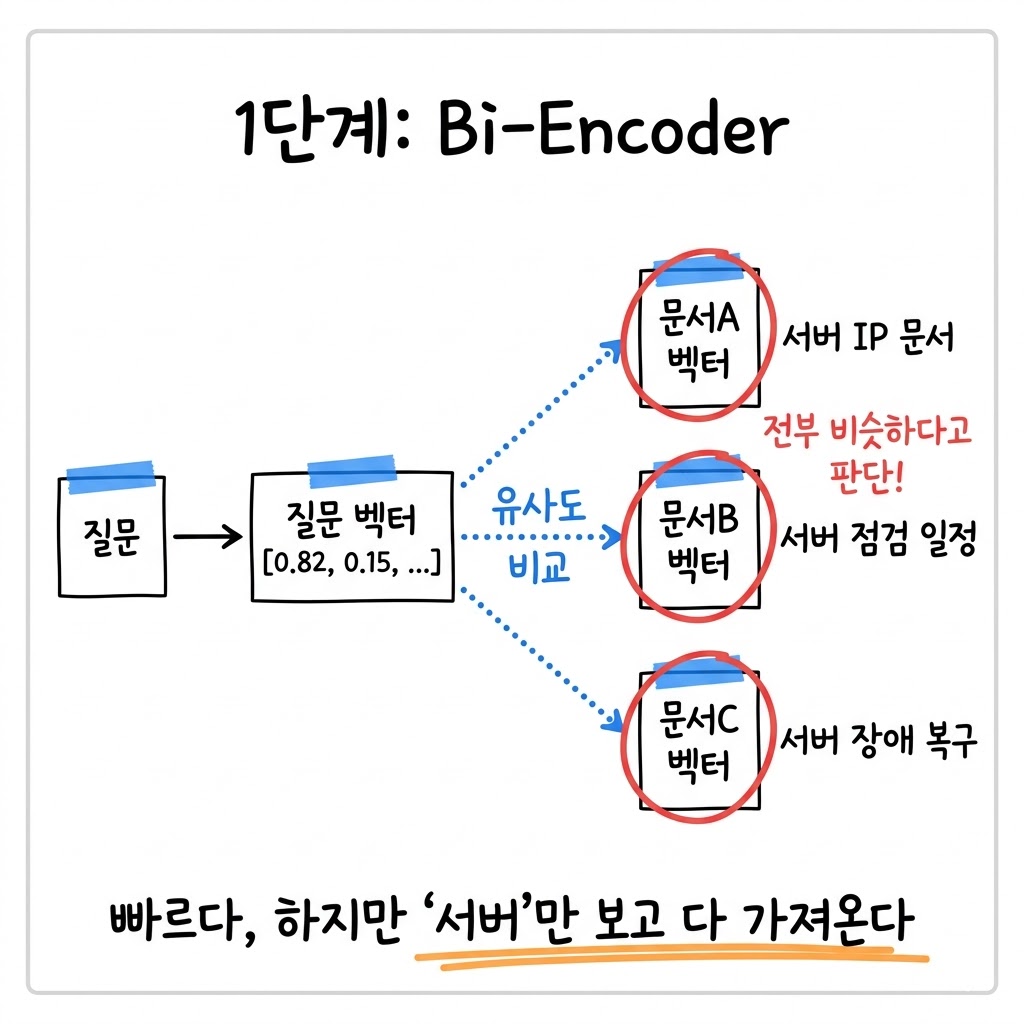
여기까지도 검색은 단순 벡터 top-K였습니다. 질문을 임베딩해 가까운 순서대로 뽑아 그대로 앞에 붙였습니다. 그런데 이 방식은 무관한 결과를 끌어들이고, 그래프 DB가 가진 관계 정보를 전혀 쓰지 못했습니다.
그래서 검색기를 세 종류로 나누고 다시 합쳤습니다.
VectorRetriever: 7개 도메인을 스레드 풀로 병렬 교차 검색, 약 1.4초
GraphRetriever: 그래프 DB에서 1-hop 이웃 탐색
FulltextRetriever: 그래프 DB CONTAINS 기반, injection 방지 처리
HybridRetriever: 세 소스 통합, 중복 제거, 다중 출처 보너스, 상한 50건
합친 결과 위에 LLM Reranker를 얹었습니다. Gemini Flash 2.5로 각 후보에 0에서 10점을 매겨, 벡터 점수 순서를 의미 기반으로 다시 정렬했습니다. 벡터 점수는 표면이 얼마나 닮았는지를 보고, rerank는 질문에 실제로 답이 되는지를 봅니다.
이 차이가 드러난 장면이 있었습니다. 소셜 로그인 관련 질문에 대해 세 후보의 점수가 이렇게 갈렸습니다.
후보 | 벡터 점수 | rerank |
|---|---|---|
비밀번호 재설정 요구사항 | 0.612 (높음) | 4 |
카카오 소셜 로그인 플랜 | 0.787 | 10 |
소셜 로그인 안티패턴 노하우 | 0.500 (중간) | 9 |
비밀번호 재설정 요구사항은 벡터 점수가 0.612로 높았지만 질문과는 무관해 rerank가 4점으로 내렸습니다. 반대로 소셜 로그인 안티패턴 노하우는 벡터 점수가 0.500으로 중간이었지만 질문에 직접 답이 되어 9점으로 올라갔습니다. 벡터 점수만 봤다면 무관한 문서를 위에, 정답에 가까운 문서를 아래에 놨을 겁니다.
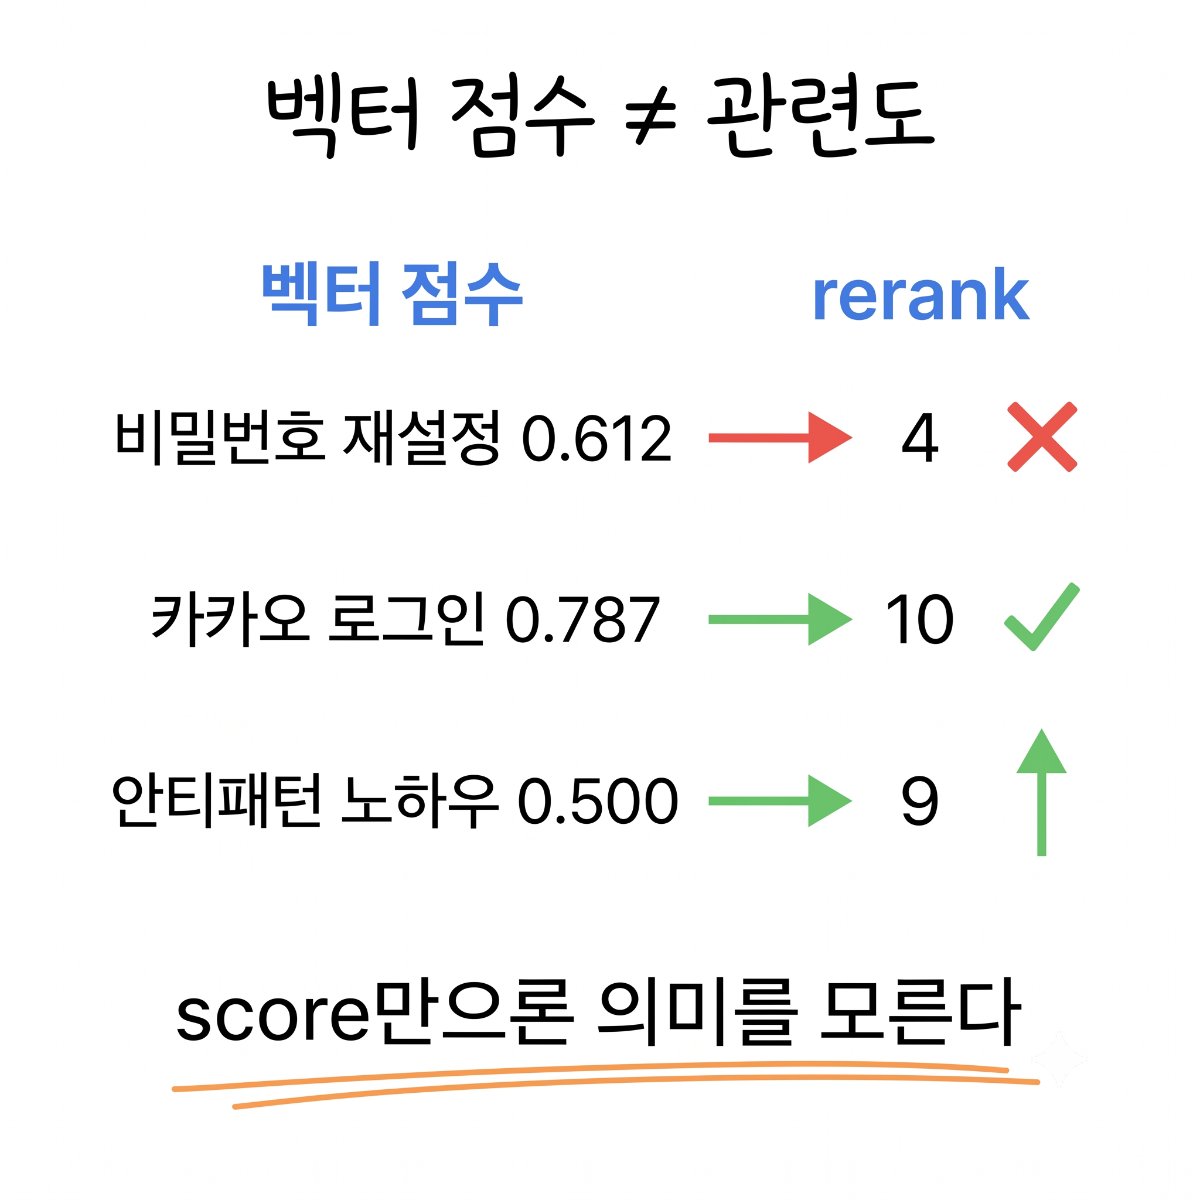
rerank가 점수를 다시 매기는 원리는 검색 파이프라인의 마지막 관문입니다. 다만 이 관문은 벤치마크 숫자가 아니라 이런 정성 사례로 검증해야 신뢰가 갑니다. 0.612가 4로 내려간 게 맞는 판단인지를 사람이 눈으로 확인하는 과정이 필요합니다.
자동 주입이 부족할 때를 대비해 에이전틱 도구 세 개도 붙였습니다. 도메인 내 유사 검색, 그래프 이웃 조회, 풀텍스트 검색을 LLM이 필요하다고 판단하면 스스로 추가로 호출합니다. 자동 주입이 기본이고, 에이전틱은 그다음 단계였습니다.
성능과 한계
속도는 갈렸습니다. 벡터 병렬 검색은 1.4초로 안정적이었지만, rerank는 1.9초에서 30초까지 흔들렸습니다. Gemini Flash의 thinking 지연 때문인데, 모든 질문에 30초짜리 rerank를 걸면 UX가 무너집니다. 더 좋은 rerank가 항상 더 좋은 UX는 아니었습니다.
그래프 탐색은 1-hop만 봤습니다. 2-hop 관계는 검토하지 못했고, 청킹과 대화 메모리도 아직 넣지 않았습니다. 7도메인 교차 검색은 중복을 만들기 때문에 중복 제거 품질이 검색 품질을 좌우합니다.
RAG는 한 번에 짓는 게 아니라 단계로 쌓는 것
이 작업을 일반화하면 몇 가지 패턴이 남습니다.
RAG는 세 정지점으로 나눠 짓습니다. 인프라 검증, 풀세트 확장, Hybrid와 rerank 결합
자동 주입이 도구 호출보다 강합니다. LLM이 검색을 결정하기 전에 컨텍스트에 이미 들어와 있게 합니다
드리프트는 숨기지 말고 운영 화면에 명시합니다. best-effort 임베딩은 실패해도 백필로 회복합니다
단순 벡터 top-K는 거짓 양성을 부르고, rerank가 그 갭을 메웁니다. rerank는 정성 사례로 검증합니다
공통 추상화는 도메인이 늘기 전에 잡습니다
반대편도 봐야 합니다. 별도 벡터 DB인 Qdrant는 역할 분리와 교체 자유를 주지만 운영 컴포넌트가 하나 더 늘어납니다. 1인 운영이라면 내장 벡터 인덱스가 더 단순할 수 있습니다. LLM rerank는 비용과 지연을 동반해 캐시나 간소화가 필요하고, 1-hop만 보는 그래프 탐색은 2-hop 관계를 놓칩니다. 모든 선택에는 반대 조건이 있습니다.
운영 RAG 도입을 검토하는 의사결정자라면 다음을 먼저 확인하는 편이 좋습니다.
RAG를 한 스프린트에 다 넣으려 하는가, 아니면 검증 정지점을 두고 나눴는가
검색 결과가 컨텍스트에 자동 주입되는가, 매번 LLM의 도구 호출 판단에 의존하는가
원본과 벡터 DB의 드리프트를 운영 화면에서 즉시 볼 수 있는가
rerank 품질을 벤치마크가 아닌 실제 정성 사례로 검증했는가
rerank 지연이 UX 한계를 넘지 않도록 캐시나 상한을 뒀는가
세 단계로 나눠 올린 덕에 각 정지점이 검증된 채로 다음 층을 받쳤습니다. RAG를 한 번에 다 짓는 대신, 무너져도 어디가 무너졌는지 아는 구조를 택한 결과였습니다.