RAG 정답률 42%에서 60%로 올린 커밋 16개, 프롬프트는 한 글자도 안 고쳤습니다
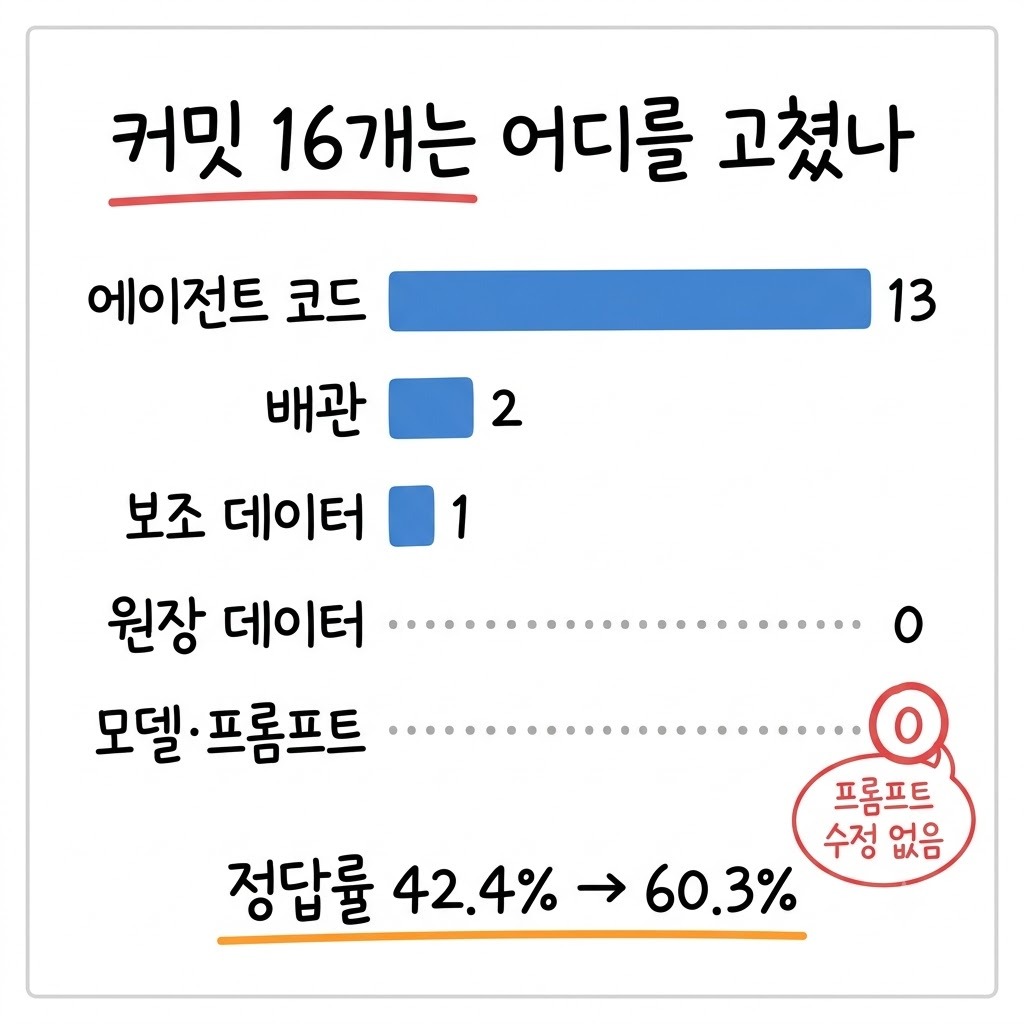
사내 문서 지식그래프 검색 도구의 답변 정답률을 42.4%에서 60.3%까지 올렸습니다. 그 사이에 들어간 커밋이 16개였습니다. 다 끝내고 나서 이 커밋들이 실제로 어디를 고쳤는지 세어 봤습니다. 모델을 바꾼 커밋 0개, 답변 프롬프트를 손댄 커밋 0개였습니다.
프롬프트가 무의미하다는 말을 하려는 것이 아닙니다. 이번 변경의 분포가 그랬다는 뜻입니다. 그리고 왜 그렇게 나왔는지는 측정 결과가 먼저 알려줬습니다.
먼저 확인한 것은 이게 모델 변덕인지였습니다
정답률은 148문항짜리 기준선으로 쟀습니다. 문항을 만들고, 답이 나오면 원장(DB)과 그래프의 실측값을 기준으로 사람이 O·부분·X 를 매기고, 판정 근거를 한 줄씩 적습니다. 그럴듯한지가 아니라 맞는지로 채점합니다.
고치기 전에 한 가지를 먼저 봤습니다. 1회차에 틀린 23건을 2회차에 똑같이 물었더니 22건이 같은 도구를 타고 같은 오답을 냈습니다. 모델의 비결정적 변화가 아니라 구조적으로 틀리는 것이고, 그렇다면 고치면 확실히 고쳐집니다. 이 확인이 없으면 실패 목록을 앞에 두고도 '오늘 모델이 좀 이상하네'로 넘어갑니다.
커밋 16개는 무엇을 고쳤나
측정 기간은 사흘이었습니다. 그 사이 2회차 42.4%, 3회차 53.2%, 4회차 60.3% 로 올랐습니다. 회차마다 모집단이 조금씩 달라서 이 글에서는 정리 문서 기준 하나로 통일해 적습니다. 그 사이 들어간 커밋 16개를 자리별로 세면 이렇습니다.
고친 자리 | 커밋 수 | 무엇을 고쳤나 |
|---|---|---|
에이전트 코드 | 13 | 라우팅 5 · 새 도구 4 · 매칭 규칙 2 · 물러서기 2 |
배관 | 2 | 관계를 잘못된 칸으로 이었다 · 빈 답이 성공처럼 저장됐다 |
보조 데이터 | 1 | 발주처 별칭표에 한글 표기 추가 |
원장 데이터 | 0 | 고칠 수 없는 자리 (아래 따로) |
모델·프롬프트 | 0 | 답변 프롬프트는 한 글자도 안 고쳤다 |
열세 개가 에이전트 코드입니다. 정답률을 올린 일의 대부분은 모델을 달래는 일이 아니라 '질문이 어느 도구로 가는가'를 고치는 일이었습니다.
틀린 66문항을 무엇을 바꾸면 맞나로 갈랐습니다
틀린 문항을 원인별로 묶을 때 '검색이 약해서'·'모델이 헷갈려서' 같은 이름을 붙이면 다음 행동이 안 나옵니다. 그래서 '무엇을 하면 이 문항이 맞게 되나'로만 갈랐습니다.
원인 | 건수 | 비중 |
|---|---|---|
있는 도구가 안 불려서 틀림 | 41 | 62% |
필요한 도구가 없어서 틀림 | 21 | 32% |
정책·자료 자체가 없음 | 4 | 6% |
가장 큰 덩어리가 '이미 있는 도구가 안 불려서'였습니다. 새로 만들 것이 없고 부르는 쪽만 고치면 되는 자리가 절반을 넘었습니다. 도구가 없어서 틀린 21건에만 새 도구 둘을 만들었습니다. 요구사항 조회 도구와 집계 도구인데, 둘 다 그래프와 원장을 직접 읽어서 답하므로 LLM 을 안 탑니다.
도구를 새로 만드는 쪽이 겉보기에는 더 생산적으로 보입니다. 다만 새 도구는 라우터 목록에 들어가는 순간 해당 도구가 답할 수 없는 질문까지 끌어당겨 새 오답을 만듭니다.
도구를 늘리는 것과 도구를 고르는 것은 다른 일입니다. 부르는 쪽을 어떻게 설계했는지는 따로 정리한 적이 있습니다.
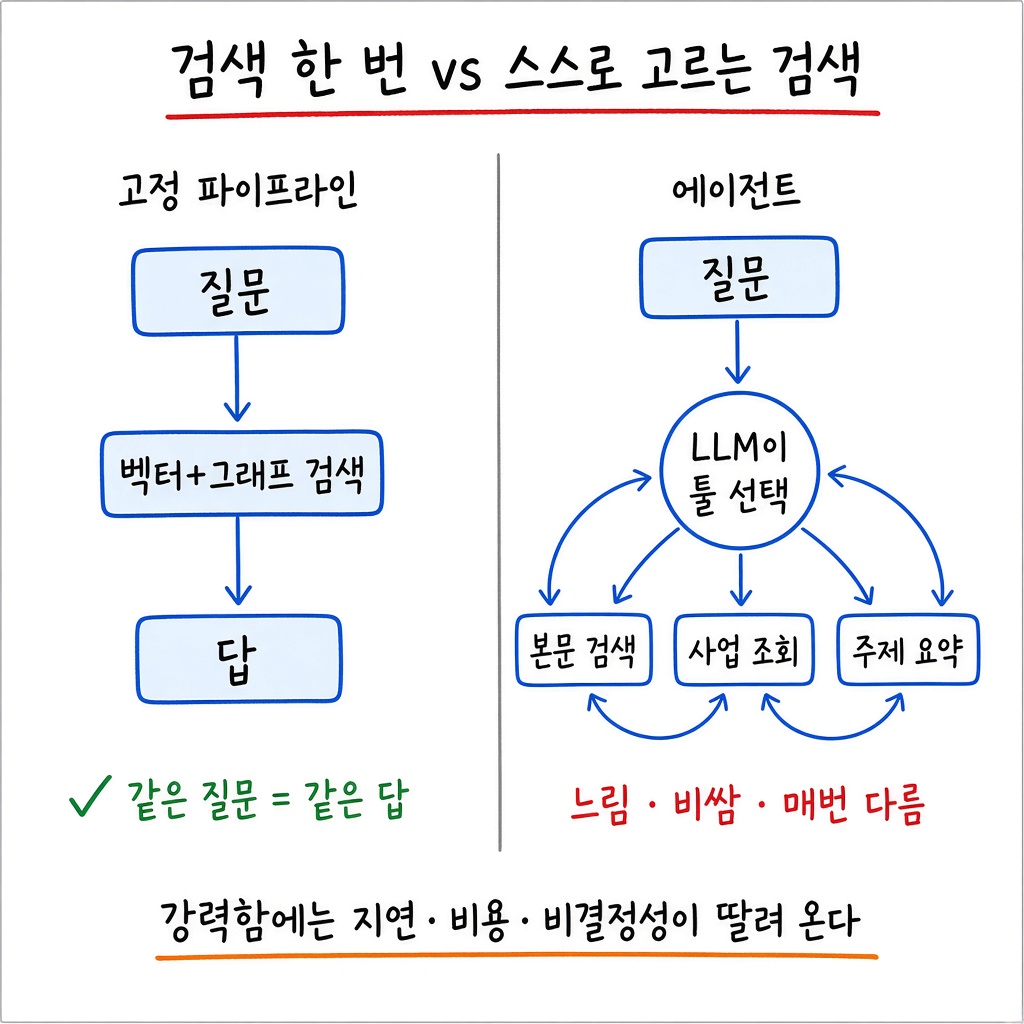
도구가 호출되지 않는 문제는 네 가지였고, 모두 모델 문제처럼 보였습니다
증상만 놓고 보면 전부 '모델이 이상하다'로 읽힙니다. 답이 그럴듯하게 틀리기 때문입니다. 원장에서 직접 세어 대조해야 갈립니다.
증상 | 진짜 원인 |
|---|---|
요구사항을 2건만 냄 | 폴더명은 발주처약칭과 사업약칭을 구분자로 붙여 쓰는데 사람은 띄어 씁니다. 구분자 하나가 달라 매칭이 안 됐습니다 |
참여 질문이 문서 검색으로 샘 | 엔진 프롬프트가 도구를 둘만 알고 있어서, 일주일 전에 추가한 참여자 조회 도구가 모델에게는 없는 도구였습니다 |
태그로 좁히는 질문이 다 샘 | 사업 목록 도구가 첫 줄 관문(목록형 질문인지 판정하는 단계)에 막혀 태그 층에 닿지도 못했습니다 |
문서를 11건으로 셈 | 문서에 붙은 사업 이름 칸과 사업 노드의 이름 칸이 187개 중 2개만 겹쳤습니다. 그 칸으로 이으니 4,372건이 11건이 됐습니다 |
마지막 줄이 가장 오래 걸렸습니다. 이름으로 이으면 맞을 것 같았는데 원장에서 이어져 있던 것은 이름이 아니라 관계였습니다. 이름 칸은 문서마다 적는 사람이 달라 표기가 흔들리고, 관계는 색인할 때 한 번 정해집니다.
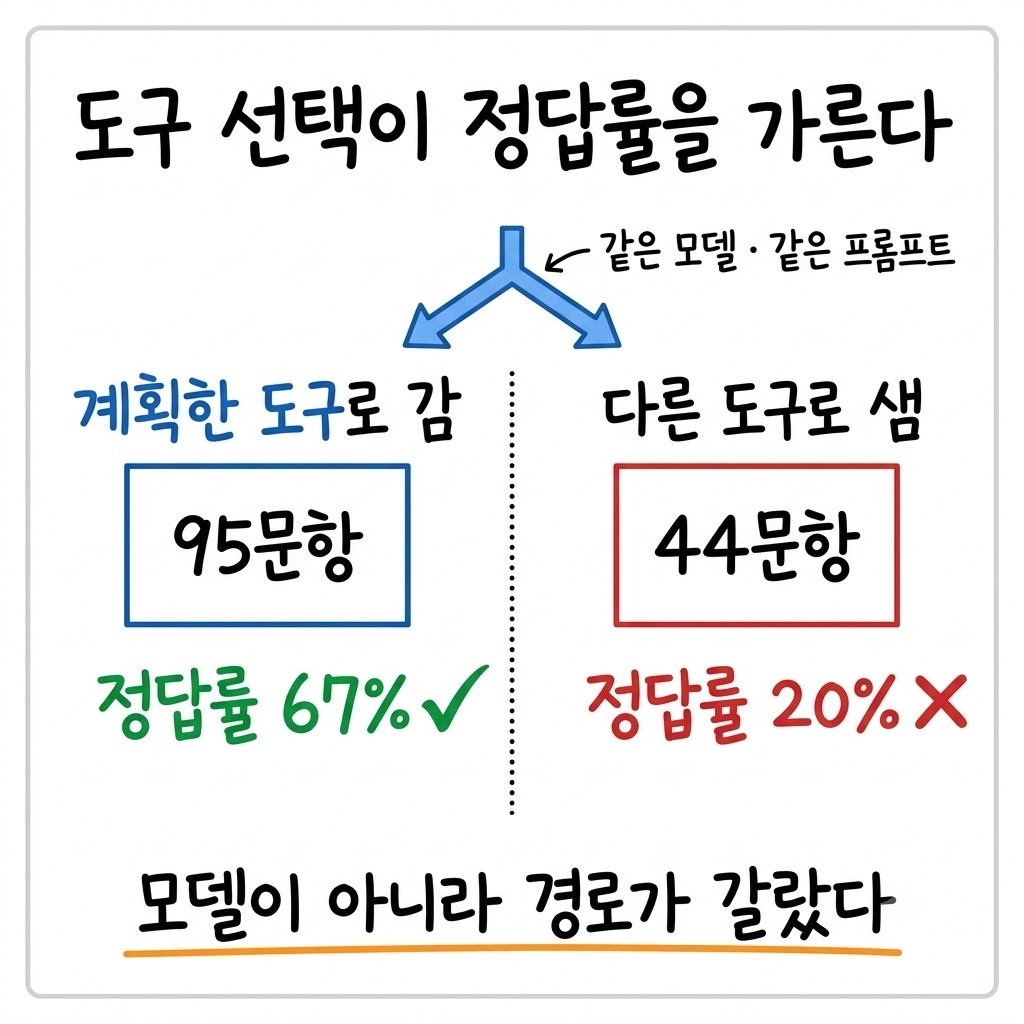
도구 선택이 정답률을 얼마나 가르는지는 숫자로도 나왔습니다. 계획한 도구로 간 95문항은 정답률 67%, 다른 도구로 샌 44문항은 20% 였습니다. 같은 모델, 같은 프롬프트, 같은 데이터인데 어디로 갔느냐만 다릅니다.
도구 하나를 더할 때 손대는 곳이 넷입니다
도구를 추가하면서 두 차례 문제를 겪었습니다. 등록만 하고 라우팅 규칙을 빠뜨려 일주일 동안 아무도 안 부르는 도구를 들고 있었고, 라우팅 쪽 관문이 두 군데인 줄 모르고 한쪽만 열었습니다.
엔진 엔드포인트 — 그래프와 원장을 실제로 읽는 쿼리
도구 등록표 — 이름·설명·예시. 화면과 사용량 집계, 라우터가 전부 여기서 파생됩니다
실행 그래프 노드 — 도구 이름을 실행 함수에 잇는 자리
라우팅 규칙 — 어떤 질문을 이 도구로 보낼지 정하는 자리
넷 중 하나를 빠뜨려도 오류가 안 나고, 그래서 조용히 안 불립니다. 테스트를 붙여도 잘 안 잡힙니다. 테스트는 대개 함수를 직접 부르므로 앞단 관문을 통째로 건너뛰기 때문입니다. 도구가 올바르게 작동하는 것과 그 도구가 불리는 것은 다른 문제입니다.
규칙을 바꾸기 전에 148문항에 먼저 돌려 봤습니다
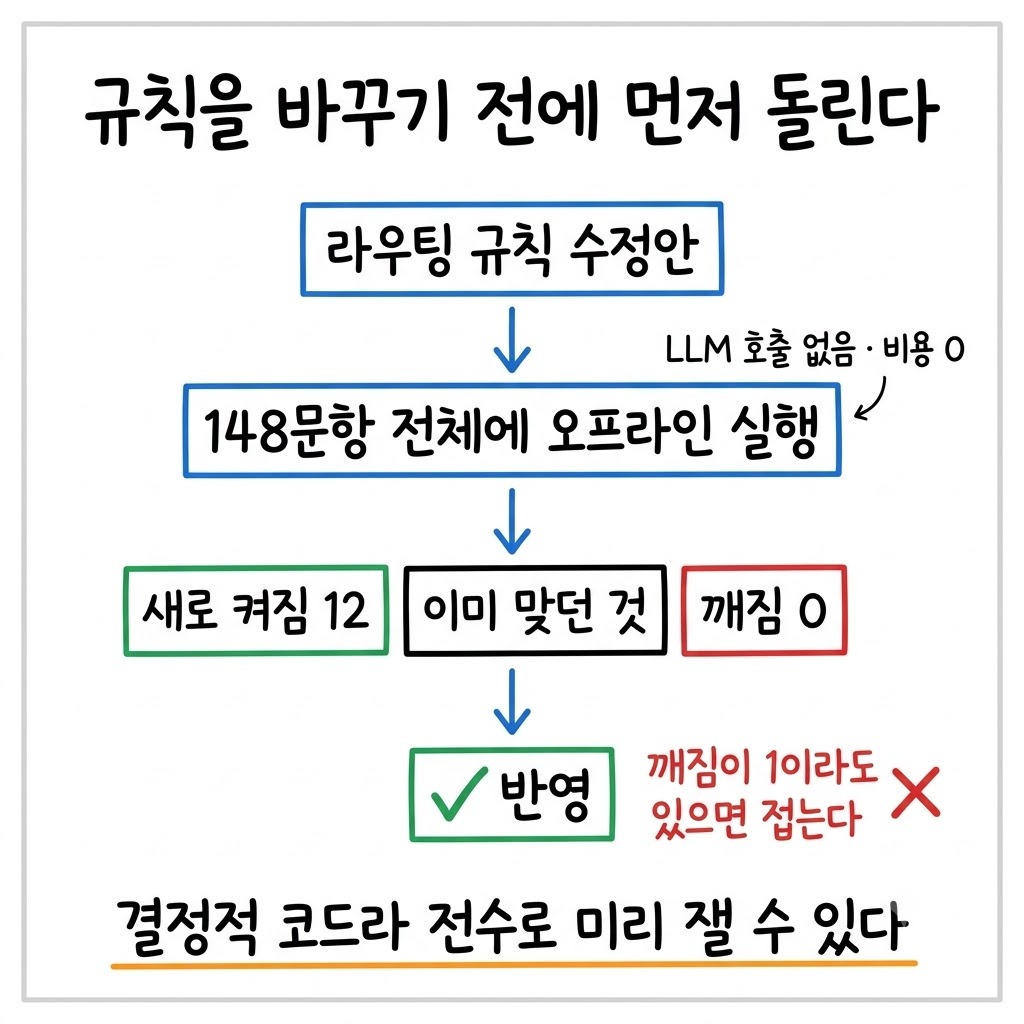
라우팅과 매칭은 결정적 코드입니다. 규칙 함수가 DB 와 그래프만 보고 판정하므로 LLM 호출 없이 오프라인으로 전체 문항에 돌려 볼 수 있습니다. 추가 모델 호출 비용이 사실상 0이고, 두 번 돌리면 같은 값이 나옵니다. 프롬프트 수정에는 없는 성질입니다.
그래서 규칙을 바꿀 때마다 바꾸기 전에 148문항 전체에 돌려서 세 숫자를 같이 냈습니다.
이 규칙에 새로 걸리게 되는 문항 수
그중 지금 이미 맞고 있는 문항 수
이 규칙 때문에 안 걸리게 되는 문항 수
앞서 나온 첫 줄 관문을 여는 작업은 이 표에서 새로 켜짐 12건, 깨짐 0건으로 나와서 그대로 넣었습니다. 맞고 있던 답이 하나라도 깨지면 그 안은 접는다는 규칙을 같이 뒀습니다. 이 장치가 없던 초반에는 고치다 깬 답이 열다섯 건 나왔고, 되돌린 판단이 여덟 번이었습니다.
못 고치는 것은 원장 데이터였습니다
커밋 분포에서 원장 데이터가 0 인 이유는 고칠 필요가 없어서가 아니라 우리가 못 고쳐서입니다. 세 가지가 나왔고 셋 다 수정하지 못한 채 남겼습니다.
발견 | 왜 못 고치나 | 그 사이에 한 것 |
|---|---|---|
발주처가 안 적힌 사업이 있음 | 사람이 원장에 채워야 합니다 | 집계 답변에 '이 수는 그 건을 뺀 값'임을 같이 적습니다 |
태그가 실제로 한 일이 아니라 말만 나온 것에 붙음 | 색인할 때 붙은 값이라 재색인 비용이 듭니다 | 전체의 40% 넘게 덮는 태그는 좁히는 데 안 씁니다 |
회사 이름이 사람으로 추출됨 | 같은 이유 | 조직 축을 따로 둡니다 |
고칠 수 없는 데이터는 피해만 막습니다. 없는 값을 지어내지 않고, 답 안에서 그 값이 무엇을 뺀 값인지 밝힙니다. 집계 도구에 순위를 넣을 때도 같은 자리를 뒀습니다. 발주처 수를 세어 답할 때 발주처 칸이 빈 사업을 스스로 밝히게 했습니다. 안 밝히면 그 수가 전부인 것으로 읽힙니다.
한 가지 더 나왔습니다. 기준값으로 한 달 가까이 인용하던 '2회차 45%' 가 원장 엑셀을 열어 보니 42.4% 였습니다. 메모에만 잘못 옮겨 적힌 값이었고, 대조하는 데 1분 걸렸습니다. 기준값은 기억에서 꺼내 쓰지 않습니다.
이 분포가 안 통하는 자리
프롬프트 0 은 이번 커밋 16개의 분포이지 프롬프트가 무의미하다는 뜻이 아닙니다. 답변 프롬프트가 이미 자리를 잡은 상태에서 그 위에 얹은 개선분입니다. 프롬프트가 아직 엉망인 초기 단계라면 분포가 다르게 나옵니다.
결정적 도구가 여럿인 구조에서 나온 분류이기도 합니다. 벡터 검색 하나에 LLM 답변만 얹은 단순 RAG 에는 라우팅 층도 도구 선택 층도 없어서 이 분류 자체가 성립하지 않습니다. 다만 그런 구조에서 정답률이 안 오른다면, 그런 계층을 추가하는 방안을 검토할 수는 있습니다.
이 방법이 무한히 통하지도 않습니다. '안 불림' 을 다 잡고 나면 다음 병목은 적재 데이터와 이어 묻기 구조로 넘어갑니다. 측정 자체도 비쌌습니다. 2주간 평가에 평소 사람이 사용하는 양의 35배에 이르는 입력이 쓰였고, 하루는 스무 문항이 사용 한도에 걸려 무효가 됐습니다. 전수 측정은 큰 마디에서만 돌립니다.
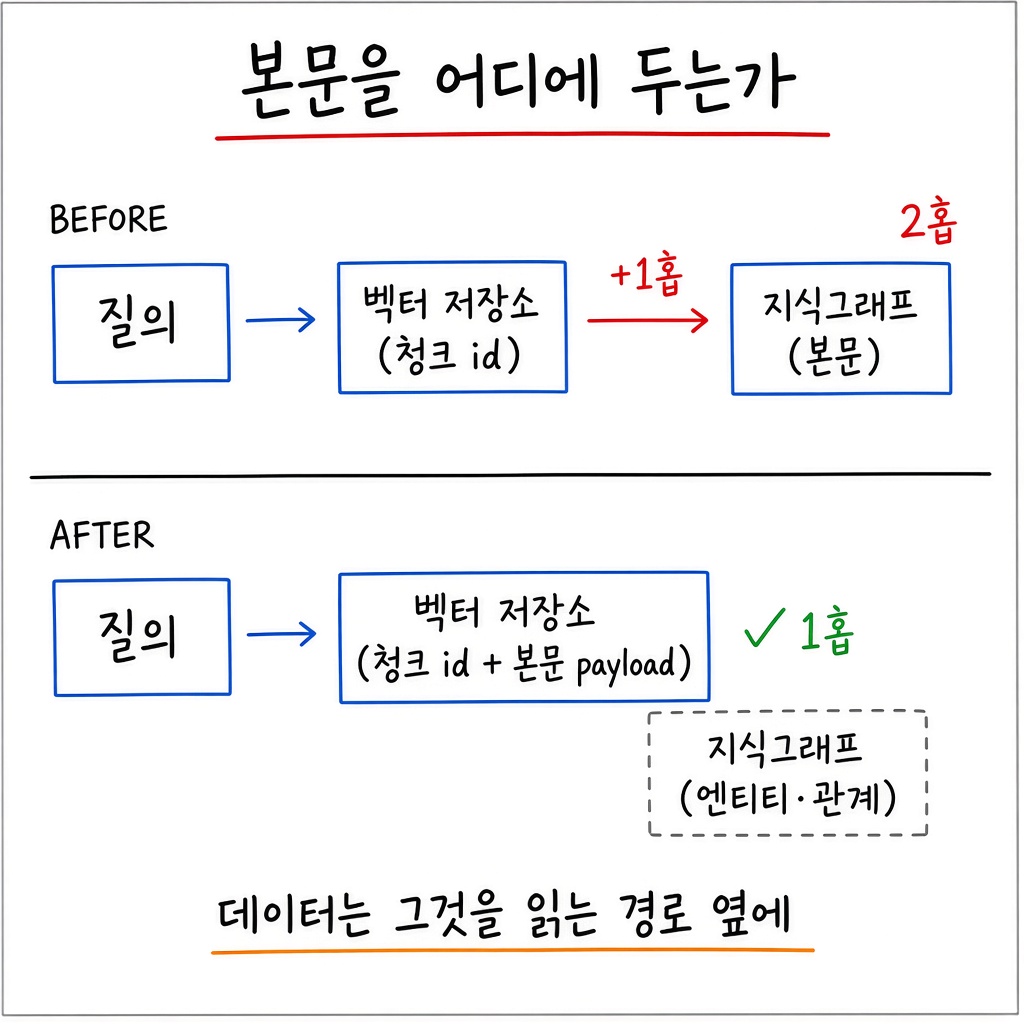
모델을 그대로 두고 구조를 고쳐 검색 품질을 올린 사례는 검색 쪽에서도 같은 모양이었습니다.
정답률이 안 오를 때 먼저 볼 것
같은 질문을 두 번 물어 같은 오답이 나오는지 본다 — 재현되면 구조 문제라 고치면 고쳐진다
틀린 문항을 '무엇을 바꾸면 맞나'로 가른다 — 원인 이름을 붙이면 다음 행동이 안 나온다
문항별로 '계획한 도구로 갔나'를 기록한다 — 경로를 안 재면 도구 문제와 모델 문제가 안 갈린다
도구를 하나 더할 때 네 자리를 같이 고쳤는지 확인한다 — 하나 빠져도 오류가 안 난다
규칙을 바꾸기 전에 전체 문항에 돌려 깨지는 건수를 같이 낸다
RAG 품질을 올리는 일은 모델을 잘 달래는 일보다 입력과 도구 사이의 경로를 고치는 작업에 가까웠습니다. 모델은 그대로 두고 그 앞뒤에서 무엇을 찾아 넣고 어느 도구로 보낼지를 고치는 것이 열여섯 중 열여섯이었습니다. 라우팅과 매칭은 결정적 코드라 전체 문항에 미리 돌려 보고 넣을 수 있습니다. 재고 고칠 수 있는 자리부터 손대는 편이 빨랐습니다.