RAG 가 자료가 없다고 답했는데, 근거 여덟 칸 중 여섯이 목차였습니다
사내 문서 지식그래프 검색 도구에서 한 공공 발주처의 사업을 열고 '이 사업의 주요 목표가 뭐야' 를 물었습니다. 돌아온 답은 '목차만 있어 확인할 수 없다' 였습니다. 사용자가 화면을 보고 바로 짚었습니다. 그 사업은 문서 340건이 색인돼 있어서, 목표가 어디에도 안 적혀 있을 리가 없었습니다.
여기서 방향이 둘로 갈립니다. '모델이 못 읽었다' 로 가면 프롬프트와 모델을 만지게 되고, '근거가 잘못 뽑혔다' 로 가면 검색과 선별을 보게 됩니다. 결과적으로 고칠 곳은 두 번째였고, 모델과 프롬프트는 한 글자도 안 건드렸습니다.
답은 지어낸 문장이 아니라 정직한 거절이었습니다
방향을 가른 단서는 답의 모양이었습니다. 환각이면 없는 목표를 그럴듯하게 적어 냈을 것입니다. 이 답은 그러지 않았습니다. 주어진 근거가 목차뿐이었고, 그 근거만으로는 목표를 알 수 없다고 성실하게 말했습니다.
모델이 제 할 일을 했다면 남은 의심은 재료입니다. 그래서 답을 다시 뜯어보는 대신 답의 재료를 열었습니다. 점수가 몇 점이었나가 아니라, 근거 칸에 **무엇이** 들어왔나를 봤습니다.
여덟 칸 중 여섯 칸이 목차였습니다
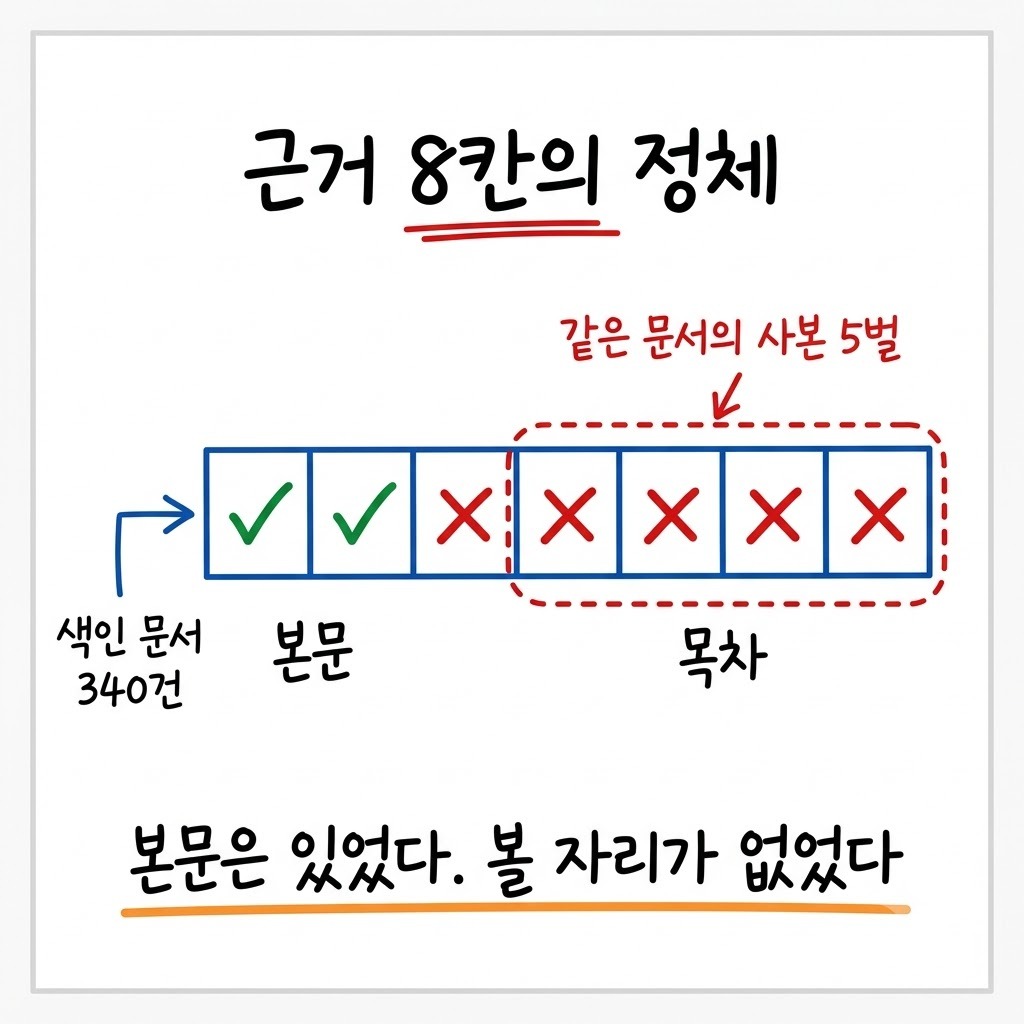
펼쳐 보니 답변에 실린 근거 8칸 중 6칸이 목차였습니다. 그리고 그 6칸 중 5칸은 같은 제안요청서의 사본이었습니다. 파일명 끝에 번호나 검토자 표시가 조금씩 다르게 붙은 편집본들이었습니다.
남은 2칸으로 사업의 주요 목표를 설명하라는 요구였던 셈입니다. 본문은 색인된 340건 안에 분명히 있었습니다. 모델이 그것을 볼 자리가 없었습니다.
목차는 질문과 표면만 닮습니다
검색 점수가 틀린 것도 아니었습니다. 목차는 그 문서의 모든 제목을 한 쪽에 담고 있습니다. 그래서 그 문서가 다루는 어떤 주제를 물어도 중간 이상으로 닮아 보입니다. 사업 목표를 물으면 목차 안의 '사업 개요', '추진 목표' 같은 줄이 그대로 걸립니다.
다만 닮은 것은 표면뿐입니다. 목차에는 그 목표가 무엇인지가 안 적혀 있습니다. 목차·색인·표지·양식이 임베딩 유사도에서 늘 상위권인 이유가 여기 있고, 이건 모델을 키워서 해결할 종류가 아닙니다. 점선 비율처럼 모양만 보고 가려내는 특징, 곧 형태적 지문으로 잡는 쪽이 맞습니다.
점수는 건드리지 않고 걸러내기만 위에 얹었습니다
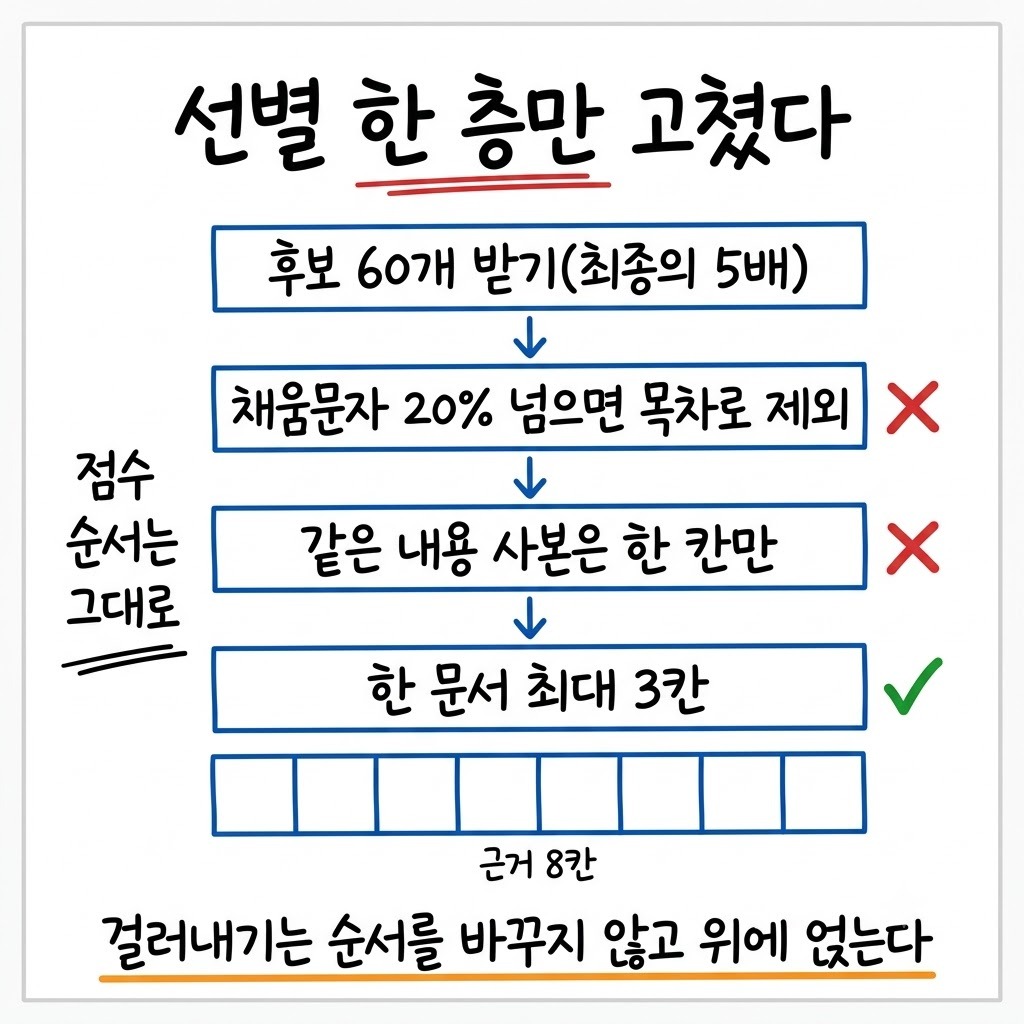
고친 곳은 선별 한 층입니다. 점수 순서는 그대로 두고, 그 위에 걸러내기 규칙 다섯을 올렸습니다. 점수 계산을 손대면 회귀 범위가 통째로 커지는데, 필터로만 두면 되돌리기도 한 줄입니다.
규칙 | 왜 필요했나 |
|---|---|
채움문자(점선·중점) 비율이 20% 를 넘으면 목차로 보고 제외 | 목차의 형태적 지문입니다. 의미 유사도로는 안 걸립니다 |
내용이 같은 사본은 한 칸만 | 파일명이 달라도 내용이 같으면 하나로 셉니다 |
한 문서가 차지하는 칸은 최대 3칸 | 8칸을 한 파일이 다 쓰면 다른 근거를 볼 기회가 없습니다 |
후보를 최종 개수의 5배(최대 60개)로 받는다 | 8개만 받으면 6개가 목차일 때 두 칸만 남습니다 |
다 걸러지면 걸러내기 전의 것을 준다 | 필터가 너무 많이 걸러냈을 때 빈손으로 돌아가지 않습니다 |
다섯 중 후보를 넉넉히 받는 규칙이 가장 늦게 눈에 들어왔습니다. 필터를 붙이려면 걸러낼 재료가 먼저 있어야 합니다. 최종 칸 수만큼만 받아 두고 거기서 걸러내면, 필터가 일을 할수록 답이 빈약해집니다.
같은 질문의 여덟 칸이 바뀌었습니다
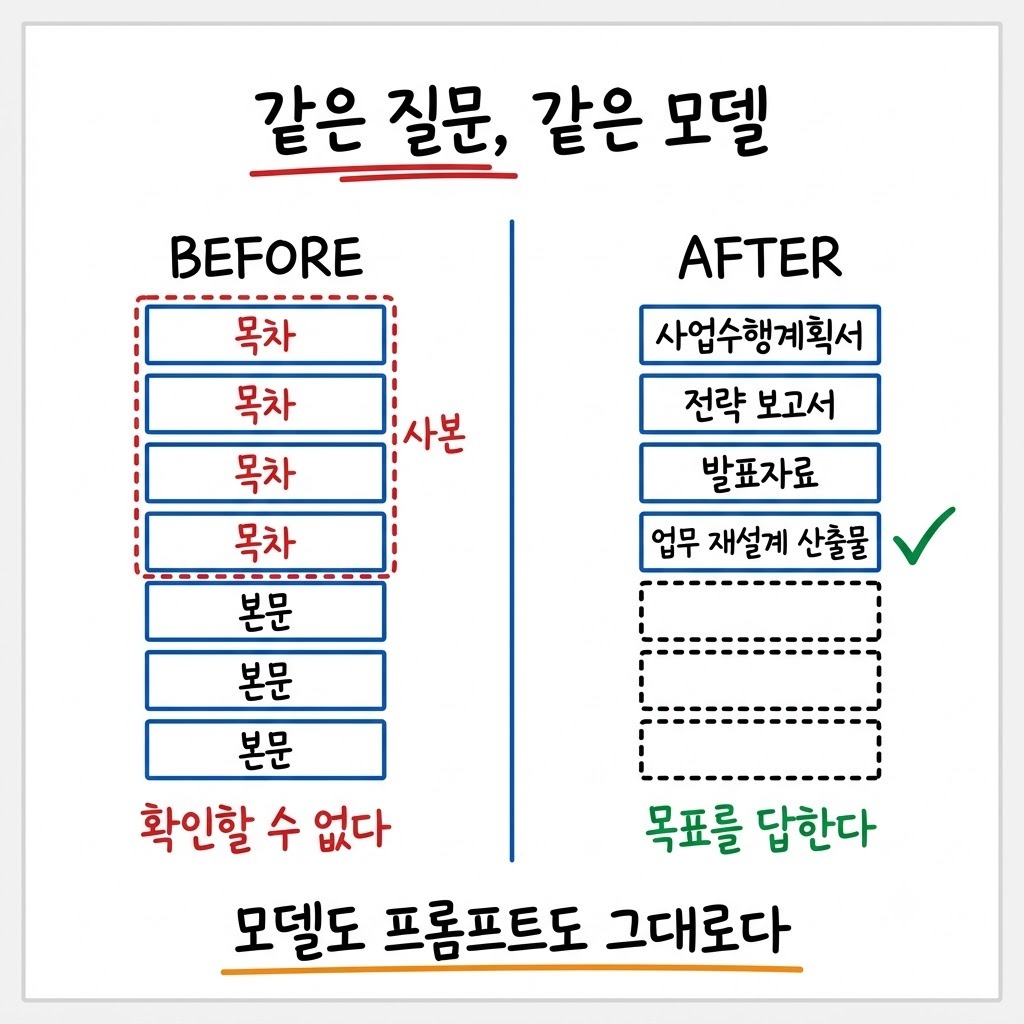
고친 뒤 같은 질문을 다시 넣었습니다. 8칸에 들어온 것은 사업수행계획서의 사업명·기간 부분, 중장기 전략 보고서의 과업수행목적, 발표자료, 업무 재설계 산출물이었습니다. 목차는 한 칸도 올라오지 않았습니다. 회귀 테스트는 237개 통과, 3개 건너뜀으로 끝났습니다.
한 가지 덤이 있었습니다. 검색 엔드포인트와 질의응답 엔드포인트가 같은 선별 함수를 씁니다. 질의응답이 내부에서 검색을 부르는 구조입니다. 그래서 함수 하나를 고쳤는데 검색 화면의 결과 목록도 같이 정리됐습니다.
고친 것은 증상이고 원인은 남아 있습니다
남은 문제를 같이 적어 뒀습니다. 같은 제안요청서의 사본이 다섯 벌 쌓여 있다는 사실 자체는 그대로입니다. 편집본이라 내용 해시가 조금씩 달라서, 색인 단계의 중복 검사에 안 걸립니다.
선별이 가려 주는 동안만 안 보입니다. 거의 같은 문서를 색인 단계에서 알아채는 일은 별개 작업으로 남겼습니다. 사본이 더 늘면 다시 새어 나올 수 있는 구조입니다.
색인 단계에서 재료가 망가지는 자리는 이것만이 아닙니다. 표 문서를 PDF 로 바꿔 색인했더니 조각의 상당수가 읽을 수 없는 상태였던 기록이 있습니다.
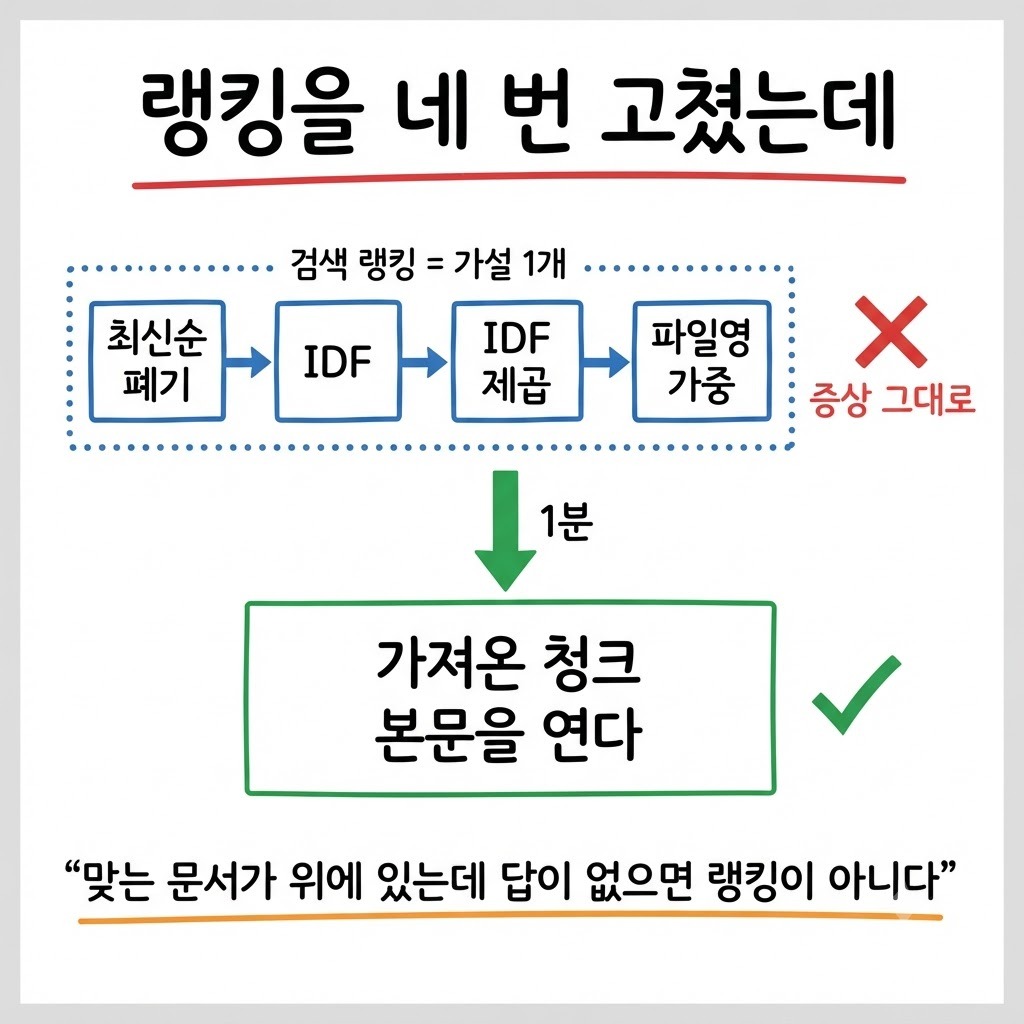
다른 한계도 적어 뒀습니다. 목차가 최선의 근거인 질문도 있습니다. '이 사업 문서가 어떻게 구성돼 있나' 가 그렇습니다. 채움문자 필터를 전역 상수로 두면 그 질문이 손해를 봅니다. 문서당 3칸 상한도, 계약서 한 건을 조목조목 묻는 질문에서는 불리합니다. 20% 라는 값도 점선으로 쪽수를 잇는 목차 관행을 전제한 숫자라, 다른 조직의 양식에서는 달라질 수 있습니다.
근거 칸은 예산입니다
이 건에서 남은 생각을 정리하면 이렇습니다. 근거 N칸은 N개의 슬롯이고, 한 문서가 다 쓰면 다른 근거는 평가받을 기회조차 없습니다. 점수의 정확도만큼 다양성 제약, 곧 문서당 상한과 사본 제거 같은 규칙이 답의 품질을 정합니다.
답이 부실할 때 모델·프롬프트를 먼저 만지기 전에, 근거 칸에 무엇이 들어왔는지 한 번 펼쳐 본다
'자료가 없어 확인할 수 없다' 는 답은 데이터가 없다는 신호가 아니라 선별이 실패했다는 신호일 수 있다
목차·표지·양식 같은 형식 노이즈는 의미가 아니라 표면으로 상위권에 든다. 형태적 지문으로 거른다
걸러내기는 점수 순서를 바꾸지 말고 위에 얹고, 다 걸러졌을 때 원래 것을 주는 폴백을 같이 둔다
필터를 붙이기 전에 후보를 최종 개수보다 넉넉히 받아 둔다
문서당 상한과 사본 제거의 임계값은 상수로 박지 말고 조직·양식마다 다시 재 본다
환각은 눈에 띄어서 잡힙니다. 정직한 거절은 그럴듯해서 '데이터가 없나 보다' 로 넘어갑니다. 이 건에서 진단에 들어간 일은 여덟 칸이 무엇이었나를 한 번 펼쳐 본 것뿐이었습니다.
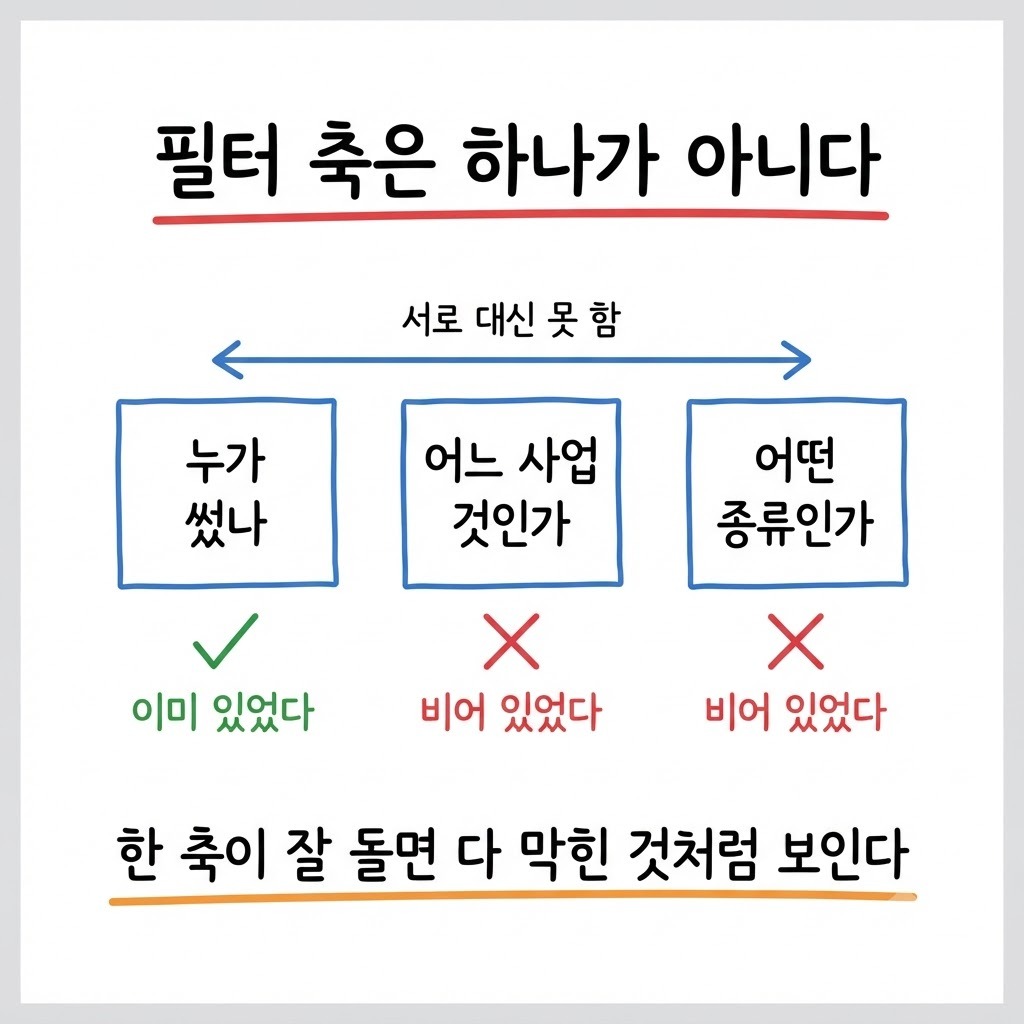
근거 칸이 오염되는 자리는 하나가 아닙니다. 검색 필터가 문서의 소속을 안 보면 남의 사업 참고자료가 자기 산출물보다 위에 서기도 합니다. 그쪽은 라벨 없는 문서가 그대로 통과한 건이고, 이번 건은 목차와 사본이 칸을 차지한 건입니다.