Kimi K3.1 Pro 가중치 공개 정리: 파일은 1.5TB, 공식 기준 구성은 GPU 8장입니다
Moonshot AI 가 Kimi K3.1 Pro 의 가중치(모델을 실행하는 데 필요한 학습 결과 파일)를 Hugging Face 에 공개했습니다. API 는 10월 23일 전후에 먼저 나왔고, 공식 블로그가 11월 4일까지 내놓겠다고 예고한 가중치가 이번에 올라온 것입니다.
공개 모델 소식이 나오면 따라오는 질문이 있습니다. '오픈 모델이니 사내 서버에 설치하면 되지 않나요?' 이 글은 그 질문에 답할 자료를 공식 문서에서 모은 정리입니다.
먼저 밝혀 둘 것이 있습니다. 저희는 이 모델을 **아직 직접 써 보지는 않았습니다.** 2026년 11월 5일 기준으로 모델 카드·라이선스·공식 기술 블로그·vLLM 설치 안내를 읽고 쓴 글입니다. 그래서 저희가 측정한 속도·정확도·비용 숫자는 이 글에 없습니다.
공식 자료에 적힌 사양
마지막 줄의 파일 합계만 모델 카드 값이 아니고, Hugging Face API 로 저장소 파일 크기를 더한 값입니다.
항목 | 공식 자료 내용 |
|---|---|
유형 | 공개 가중치 멀티모달 모델, 입력은 텍스트·이미지 |
구조 | Mixture-of-Experts(MoE, 입력마다 매개변수의 일부만 쓰는 구조) |
매개변수 | 전체 2.8T(2조 8천억 개), 한 번에 쓰는 것 104B(1,040억 개) |
문맥 길이 | 1,048,576 토큰(공식 표현은 1-million-token context window) |
양자화(숫자 표현을 줄여 크기를 낮추는 기법) | 가중치 MXFP4, 활성값 MXFP8 |
저장소 파일 합계 | 약 1,561GB(2026-11-05 합산) |
파일 합계는 저장소 전체를 더한 값이라, 실행에 필요한 메모리로 바로 환산할 수는 없습니다. 다만 내려받아 보관할 공간부터 1.5TB 를 넘는다는 것은 확인됩니다.
공식 설치 안내의 기준 구성은 GPU 8장입니다
모델 카드가 권장하는 추론 엔진(모델을 서버에서 실행해 주는 소프트웨어)은 vLLM·SGLang·TokenSpeed 셋입니다. 그중 vLLM 공식 안내가 구성을 구체적으로 적어 두었습니다.
one tensor-parallel group of 8 GPUs, either two GB300 trays or one B300 node
풀어 쓰면 GPU 8장을 한 묶음으로 쓰고, 모델을 그 8장에 나눠 올리는 구성입니다. 장비로는 GB300 트레이 2개 또는 B300 노드 1개이고, 둘 다 데이터센터용 GPU 장비입니다. 이 구성의 처리량은 조정하지 않았다는 설명도 함께 있습니다.
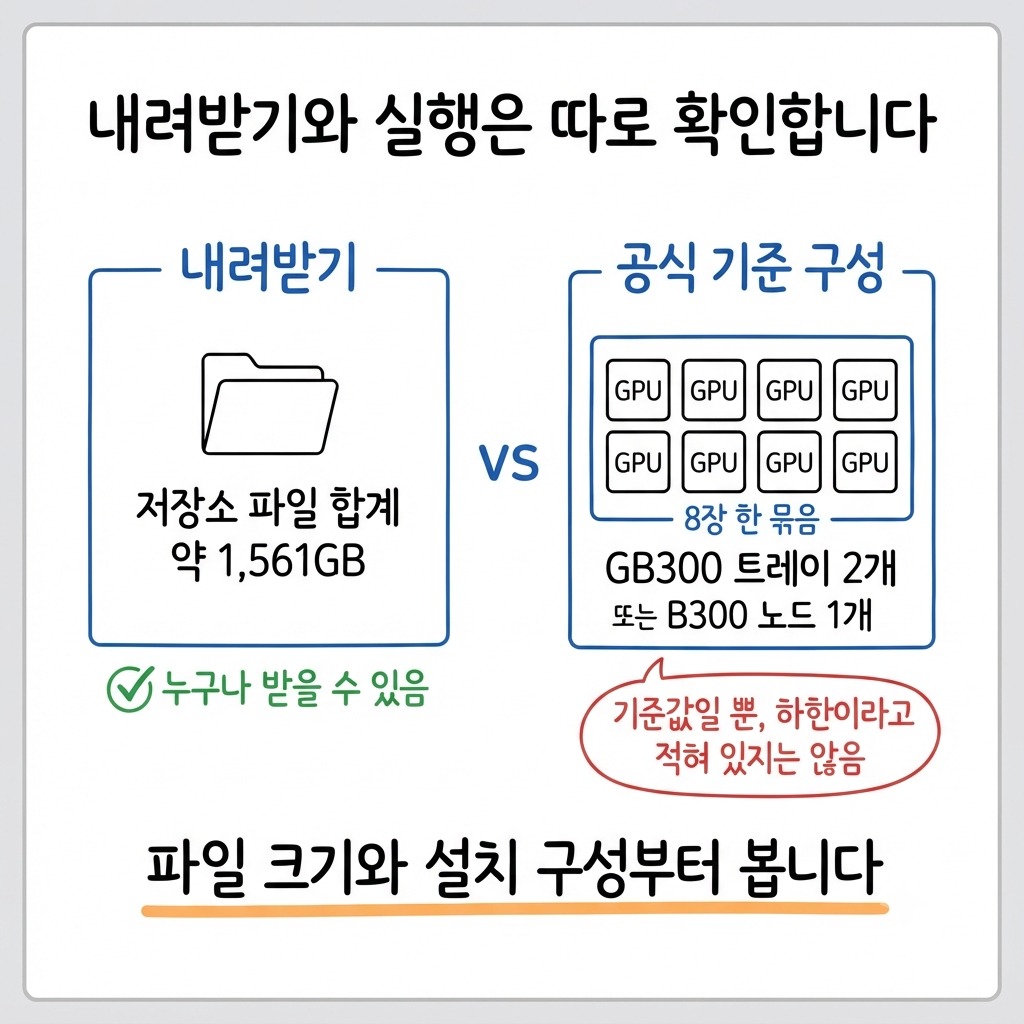
일반 사무용 서버나 GPU 한두 장 구성으로 실행한다는 공식 안내는 찾지 못했습니다. 다만 8장은 안내의 기준값이고, 하한이라고 적혀 있지는 않습니다. 더 작은 구성이 되는지 안 되는지는 공식 자료만으로 알 수 없습니다.
그래도 검토의 출발점은 달라집니다. 내려받을 수 있다는 것과 고객사 장비에서 실행된다는 것은 따로 확인할 일입니다. 사내 문서 AI 를 볼 때 GPU 서버부터 살 필요가 없었다고 판단한 기록도 같은 이야기를 다룹니다.
라이선스는 쓰는 방식에 따라 조건이 다릅니다
라이선스 이름은 Kimi K3.1-Pro License 입니다. MIT 라이선스 모양에 조건을 붙인 형태입니다. 사용·수정·재배포·상업 이용을 허용하고, 아래 경우에 조건을 둡니다.
조항 | 대상 | 내용 |
|---|---|---|
제2조 | 'Model as a Service' 사업을 하고 12개월 합산 매출이 2천만 달러를 넘는 경우 | 상업 이용 전에 Moonshot AI 와 별도 계약 필요 |
제3조 | 월간 활성 이용자 1억 명 초과 또는 월 매출 2천만 달러 초과 상업 제품 | 화면에 'Kimi K3.1-Pro' 를 잘 보이게 표시 |
제4조 | 내부 이용(소프트웨어·결과물·기능을 제3자에게 제공하지 않는 이용), 공식 제품·공인 추론 파트너 경유 이용 | 위 두 조건을 적용하지 않음 |
하나가 더 있습니다. 기능 안에 모델을 넣은 최종 사용자 제품은 Model as a Service 정의에서 제외됩니다.
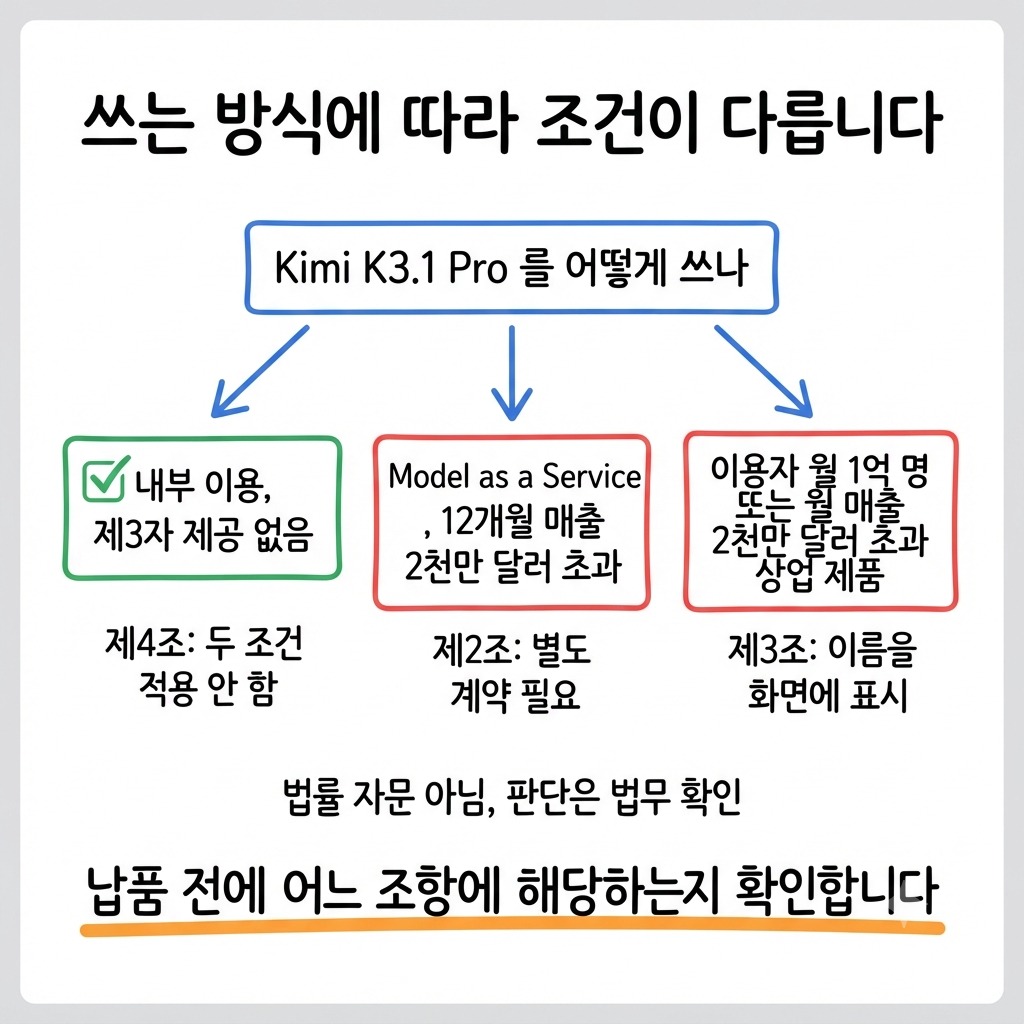
여기까지는 조항을 옮긴 것이고, 이 글은 법률 자문이 아닙니다. 어떤 납품 형태가 어느 조항에 해당하는지는 저희도 단정하지 않고 확인이 필요한 사항으로 둡니다.
벤치마크는 공식 표에 따르면 이렇습니다
공식 표에 따르면 코딩 벤치마크 Terminal-Bench 4.0 의 값은 아래와 같습니다.
모델 | 공식 표의 값 |
|---|---|
Kimi K3.1 Pro | 65.7 |
Claude Opus 5.5 | 66.4 |
GPT-6 Astra | 58.2 |
DeepSeek-V4.1-Flash-1017 | 42.3 |
이 표만으로 순위를 정하지는 않았습니다. 공식 블로그는 경쟁 모델 수치를 블로그와 리더보드의 최댓값에서 가져왔다고 밝힙니다. 일부 벤치마크는 Moonshot 내부 시험입니다.
환각 시험(Kimi Hallucination Benchmark)도 내부 시험입니다. 공식 블로그는 'The reported rates do not represent overall error rates in daily use.' 라고 직접 적었습니다. 여기 나온 비율이 일상 사용의 전체 오류율은 아니라는 뜻입니다. 한국어 성능은 공식 자료에서 찾지 못했습니다.
공식 블로그에는 사이버 역량에 관한 입장도 있습니다. 'we aim not to release open weights that would extend the absolute frontier of cyber capability.' 사이버 역량의 최전선을 넓히는 가중치는 내놓지 않는 것을 목표로 한다는 문장입니다. 학습 단계에서 사이버 관련 데이터를 제거했고, 공식 수치로 xdev-bench-hard 가 제거 전 90.5% 에서 제거 후 81.0% 였다고 밝혔습니다.
저희는 공식 표보다 자기 일의 자료로 직접 시험한 결과로 판단합니다. Gemma 4 에 사실 검수를 시켰다가 지어낸 사건이 통과한 기록이 있어서입니다.
코드를 옮길 때 확인할 두 가지
이 내용은 사내 설치 없이 API 만 써도 해당합니다. API 는 OpenAI·Anthropic 호환 형식을 제공합니다. 여기에 더해 모델 카드 사용법 절에 따로 적힌 조건이 둘 있습니다.
`reasoning_effort`(생각 깊이 설정): `low`·`high`·`max` 를 받고, 기본값이 `max` 입니다
여러 턴·도구 호출: 응답의 `reasoning_content`·`tool_calls` 까지 assistant 메시지 전체를 그대로 다시 넘깁니다. `content` 만 넘기면 안 된다고 적혀 있습니다
기본값 `max` 가 응답 시간과 비용에 어떤 영향을 주는지는 저희가 측정하지 않았습니다. API 호출 방법은 공식 안내를 따로 확인할 수 있습니다.
우리 일에 적용하면: 여기부터는 저희 판단입니다
이 절은 공식 문서의 주장이 아닙니다. 공식 자료를 읽고 **저희가 판단한 내용**입니다.
AI 도입 상담: '오픈 모델이니 사내에 설치하면 되죠'라는 질문에 파일 크기와 기준 구성을 먼저 보여 드립니다. 웬만한 회사에는 사내 서버에 올리는 모델보다 가격과 성능을 비교할 API 후보에 가깝다고 봅니다
SI 납품: 고객사가 쓰는 내부 시스템에 넣는 경우와 고객에게 모델 API 를 제공하는 경우는 라이선스 조건이 다릅니다. 납품 전에 제2조·제4조를 법무와 확인할 항목으로 적어 둡니다
시스템 개발: 도구 호출을 붙일 때 `reasoning_content` 를 함께 넘기는 조건은 기존 OpenAI 호환 코드를 그대로 옮기면 빠뜨리기 쉬운 부분입니다
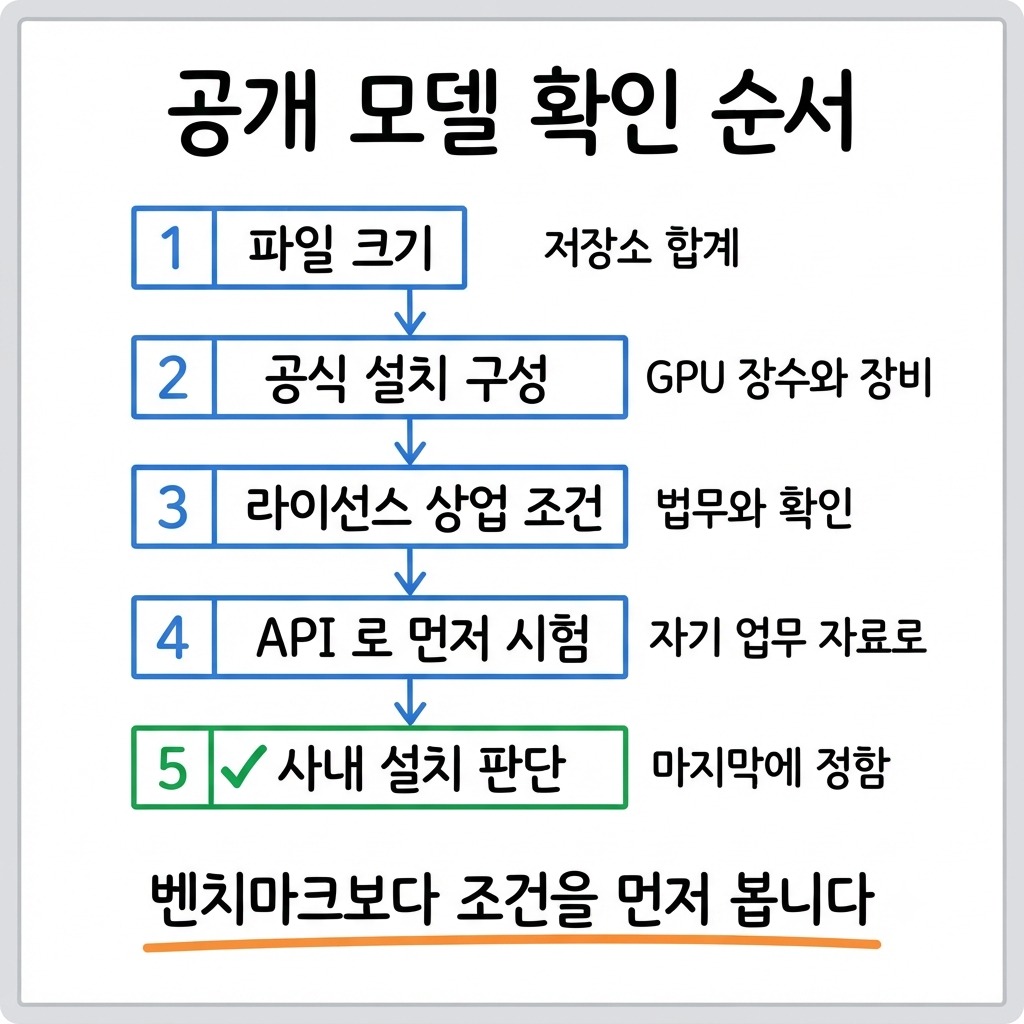
공개 가중치 모델을 볼 때 확인하는 순서도 정리했습니다. 벤치마크를 앞에 두지 않은 이유는, 뒤의 조건에서 막히면 성능이 좋아도 쓸 수 없기 때문입니다.
파일 크기: 저장소 합계를 확인합니다
공식 설치 구성: GPU 장수와 장비 종류를 확인합니다
라이선스의 상업 조건: 우리 쓰임새가 어느 조항에 해당하는지 법무와 확인합니다
API 로 먼저 시험: 자기 업무 자료로 직접 결과를 확인합니다
사내 설치 판단: 앞의 네 가지를 본 뒤에 정합니다
정리하면
Kimi K3.1 Pro 는 가중치를 내려받을 수 있습니다. 공식 설치 안내의 기준 구성은 GPU 8장이고, 저장소 파일 합계는 약 1,561GB 입니다.
아직 써 보지 않은 모델이라 성능과 비용은 이 글에서 결론을 내지 않았습니다. 사내 설치를 검토하신다면 파일 크기·설치 구성·라이선스부터 확인하고, API 로 자기 업무 자료를 시험해 보는 순서를 권합니다.