HWP·PDF 파서를 바꾸고 글자 2배라고 적었는데, 내용은 16%만 늘었습니다
자매 법인의 새 플랫폼에 문서 검색 엔진을 붙이고 있었습니다. hwp·pdf 를 미리보기 PDF 로 변환한 뒤 글자만 뽑아 색인하는 경로였습니다. 에러는 한 건도 안 났는데 표가 납작해졌습니다. 행과 열이 사라지고 숫자와 낱말이 좌표 순서로 흩어집니다.
제안서·설계서·현황표가 주류인 자료 더미에서는 표가 곧 내용입니다. '이 요건 번호의 전문 항목이 뭐냐' 같은 질문은 정확히 그 표를 봐야 답이 나옵니다. 공개된 문서 파서 라이브러리로 경로를 바꾸고 전후를 실측해 내부 기록으로 남겼습니다. 그 기록의 제목에까지 '글자 2배·표 줄 1,993' 을 박아 뒀습니다.
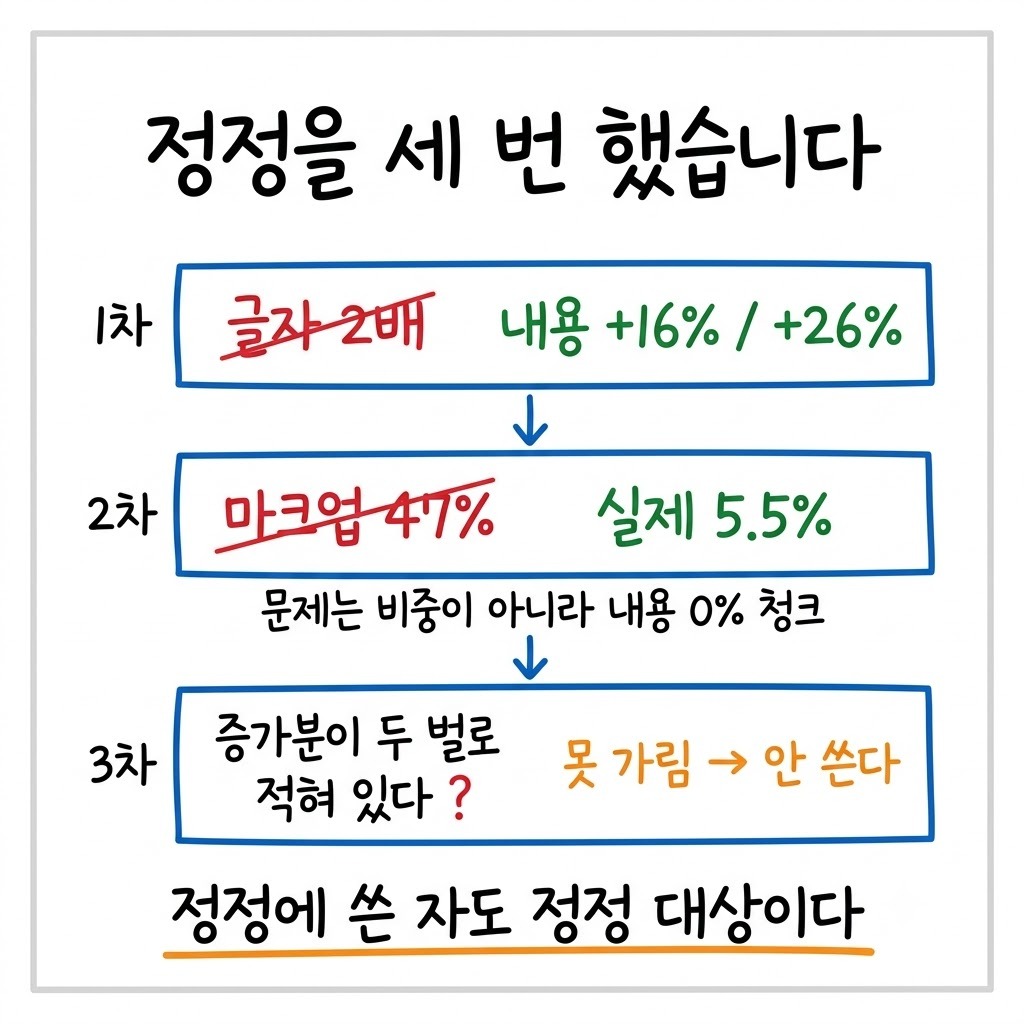
다음 날 다른 작업 세션에서 같은 표를 보던 중에 지적이 들어왔습니다. 그 늘어난 글자, 태그 아니냐는 것이었습니다. 다시 재니 셋 다 과했습니다. 그리고 그 뒤로 두 번 더 정정하게 됩니다.
첫 번째 정정 — 늘어난 글자의 대부분은 태그였습니다
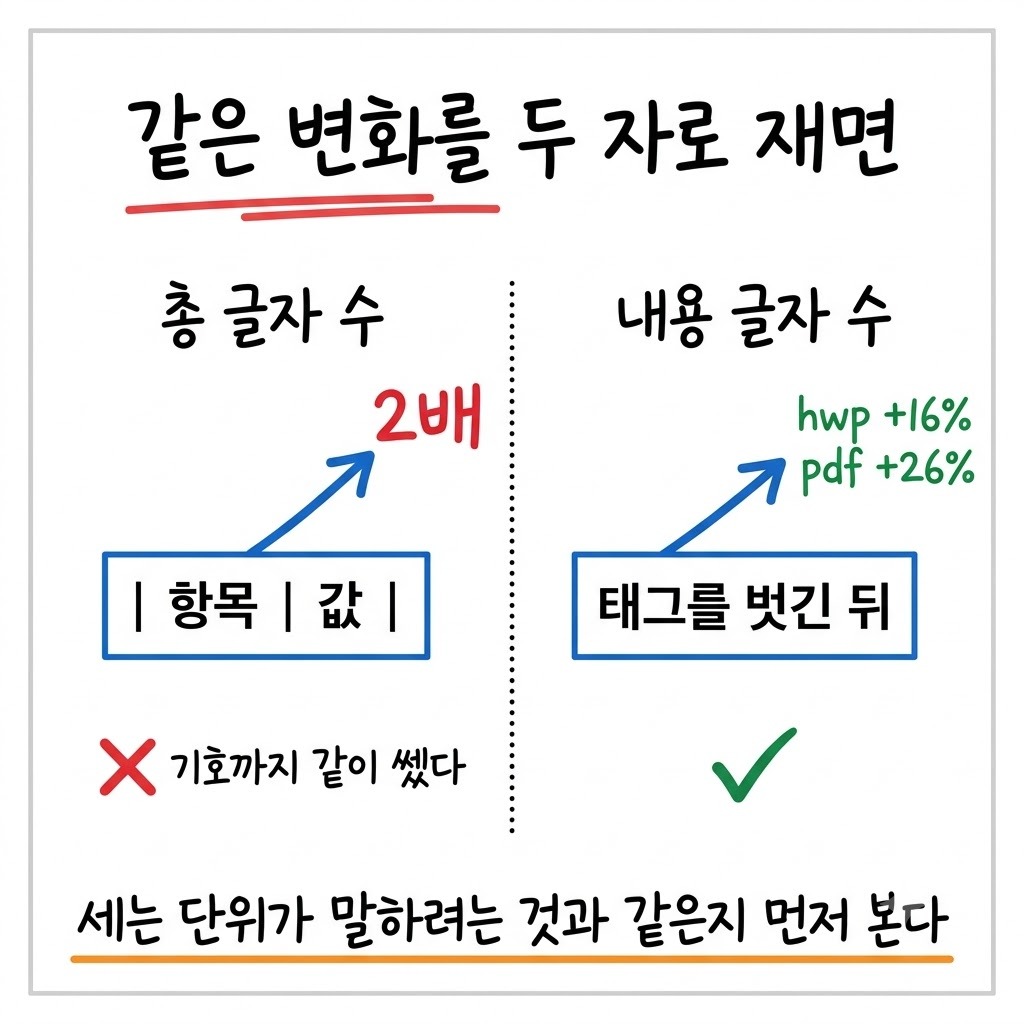
제가 처음 적용한 측정 기준은 총 글자 수였습니다. 구조를 넣는 파서로 바꾸면 무엇이 먼저 늘어나는지를 생각하지 않고 쓴 자입니다. 표를 마크다운으로 복원하는 파서는 파이프 기호와 구분선과 머리글 표시를 같이 냅니다. 글자 수는 내용이 아니라 바이트에 가깝습니다.
마크업을 벗기고 한글·영숫자만 세어 다시 쟀습니다. 내용 증가율은 hwp 가 +16%, pdf 가 +26% 였습니다. 2배와는 다른 이야기입니다. 그리고 공짜도 아닙니다. 구조를 넣으면 그 태그가 청크 예산을 쓰고 임베딩 신호를 묽게 만듭니다.
방향이 틀린 것은 아니었습니다. 회귀 15문항은 15/15 로 유지됐고 나빠진 문항은 없었으며 근거 자료가 더 맞는 쪽으로 바뀐 문항이 4개 나왔습니다. 틀린 것은 말이었습니다.
두 번째 정정 — 정정에 쓴 숫자도 틀렸습니다
구조를 넣은 대가를 같이 적어야 한다고 판단했습니다. 그래서 마크업이 본문에서 차지하는 비중을 세어 47% 라는 값을 얻었고, 그 값을 정정 기록에 실었습니다.
여기서 두 가지가 갈립니다. 47% 는 '늘어난 글자 중 기호의 비율' 이 아닙니다. '본문 전체에서 마크업이 차지하는 비중' 입니다. 앞 문단의 +16%·+26% 와는 분모가 아예 다른 값이라 한 문장 안에 섞으면 둘 다 틀린 말이 됩니다. 저도 이 둘을 한 번 섞어 적었습니다.
그리고 그 47% 자체가 틀렸습니다. 이틀 뒤에 다시 재 보니 hwp 하나만, 그것도 공백과 문장부호까지 마크업으로 센 값이었습니다. 전체로 제대로 세니 5.5% 였습니다. hwp·pdf 만 따로 봐도 20%대입니다. 걷어낼 규모가 아니었습니다.
비중을 재는 기준은 애초에 질문과 맞지 않았습니다. 실제로 손해를 내던 것은 평균 비중이 아니라 내용이 거의 없는 청크였습니다. 내용 글자가 12% 미만인 청크가 245개 있었고, 최악은 0% 였습니다. 빈 격자만 든 938자짜리 청크가 검색 대상에 그대로 들어가 있었습니다.
처방도 달라졌습니다. 태그를 걷어내는 대신 빈 행만 뗐습니다. 그것만으로 12% 미만 청크가 245개에서 185개로 줄었고, 내용 0% 청크는 없어졌습니다. 마크업 비중이 곧 손해라는 증거는 끝내 나오지 않았습니다.
세 번째 — 지금도 어긋나는 숫자가 하나 남아 있습니다
이 글을 쓰려고 기록을 다시 펼치다 또 하나를 발견했습니다. 늘어난 글자의 절대값이 기록 안에서 두 벌로 적혀 있습니다. 전후 총량 표에서 뒤 값에서 앞 값을 뺀 수와, 증가분이라고 따로 적어 둔 수가 서로 맞지 않습니다. hwp 쪽도 pdf 쪽도 그렇습니다.
어느 쪽이 맞는지 지금 가리지 못합니다. 서로 다른 회차에 잰 값이 섞여 들어간 것으로 보이는데, 그때 돌린 명령과 대상 목록을 남겨 두지 않아 재현이 안 됩니다. 그래서 이 글에서는 증가분의 절대값을 쓰지 않았습니다. 앞에서 쓴 것은 전부 증가율뿐입니다.
고를 수도 있었습니다. 둘 중 그럴듯한 쪽을 적고 넘어가면 아무도 모릅니다. 제 수치가 과했다는 글에서 또 안 맞는 수치를 골라 적는 것보다, 어긋난다고 적는 쪽이 정직합니다. 못 가리는 숫자는 안 쓰는 것이 이 자리에서는 정답입니다.
제가 낸 말을 재서 뒤집은 기록은 전에도 있었습니다. 원인을 먼저 단정하고 나서 잰 적이 있는데, 그때도 제 말이 과했습니다.
옛 방식이 0건인 지표로는 개선 폭을 판단할 수 없습니다
두 번째 자는 표 줄 수였습니다. 정확히는 마크다운 표의 구분 기호 개수입니다. hwp 10건에서 4줄이 127줄이 됐고 pdf 40건에서는 0줄이 1,866줄이 됐습니다. 숫자만 보면 화려합니다.
옛 경로는 마크다운을 애초에 내지 않습니다. 그 자로 재면 옛 경로는 항상 0에 가깝고 새 경로는 무엇을 하든 그보다 큽니다. 이게 아니라면 무엇이 보일까를 물었어야 했는데 묻지 않았습니다. 0 과 비교해 나온 배수는 성능이 아니라 형식이 바뀌었다는 사실의 다른 표현입니다.
더 나쁜 것은 이 자가 틀린 결과도 통과시킨다는 점입니다. 병합된 셀이 엉뚱한 칸에 들어가도 구분 기호는 똑같이 세어집니다. 이 자로 증명된 것은 표가 표로 남아 있다까지입니다. 표가 맞게 남아 있다는 아닙니다.
그래서 자를 하나 더 만들었습니다. 정답을 아는 문서에서 라벨과 값이 같은 행에 붙어 있는지를 보는 자입니다. 신청서 원본 hwp 로 10개 쌍 중 10개가 제자리였습니다. 한 행에 두 쌍이 들어간 줄도 어긋나지 않았습니다. 표본이 10건이니 10건만큼만 말할 수 있고, 여기서도 딱 그만큼만 말했습니다.
자 | 무엇을 재나 | 개선 근거로 쓸 수 있나 |
|---|---|---|
총 글자 수 | 마크업을 포함한 분량 | 못 쓴다. 구조 기호가 먼저 늘어난다 |
표 줄 수 | 구분 기호가 나오나 | 못 쓴다. 옛 경로가 0이라 항상 이긴다 |
마크업 비중 | 태그가 차지하는 몫 | 못 쓴다. 손해와 이어진다는 증거가 없었다 |
내용 0% 청크 수 | 쓸모없는 청크가 몇 개인가 | 쓴다. 줄면 검색이 실제로 덜 헤맨다 |
라벨·값 동행률 | 표가 맞게 복원됐나 | 쓴다. 표본 수만큼만 |
표 줄 수는 버리지 않고 남겼습니다. 회귀 감지용으로는 값이 싸고 충분합니다. 다만 개선의 근거로는 쓰지 않기로 했습니다. 모든 지표에 양과 질을 함께 둘 필요는 없습니다. 다만 그 수치를 개선의 근거로 쓸 때는 추출량과 내용의 정확성을 따로 확인해야 합니다.
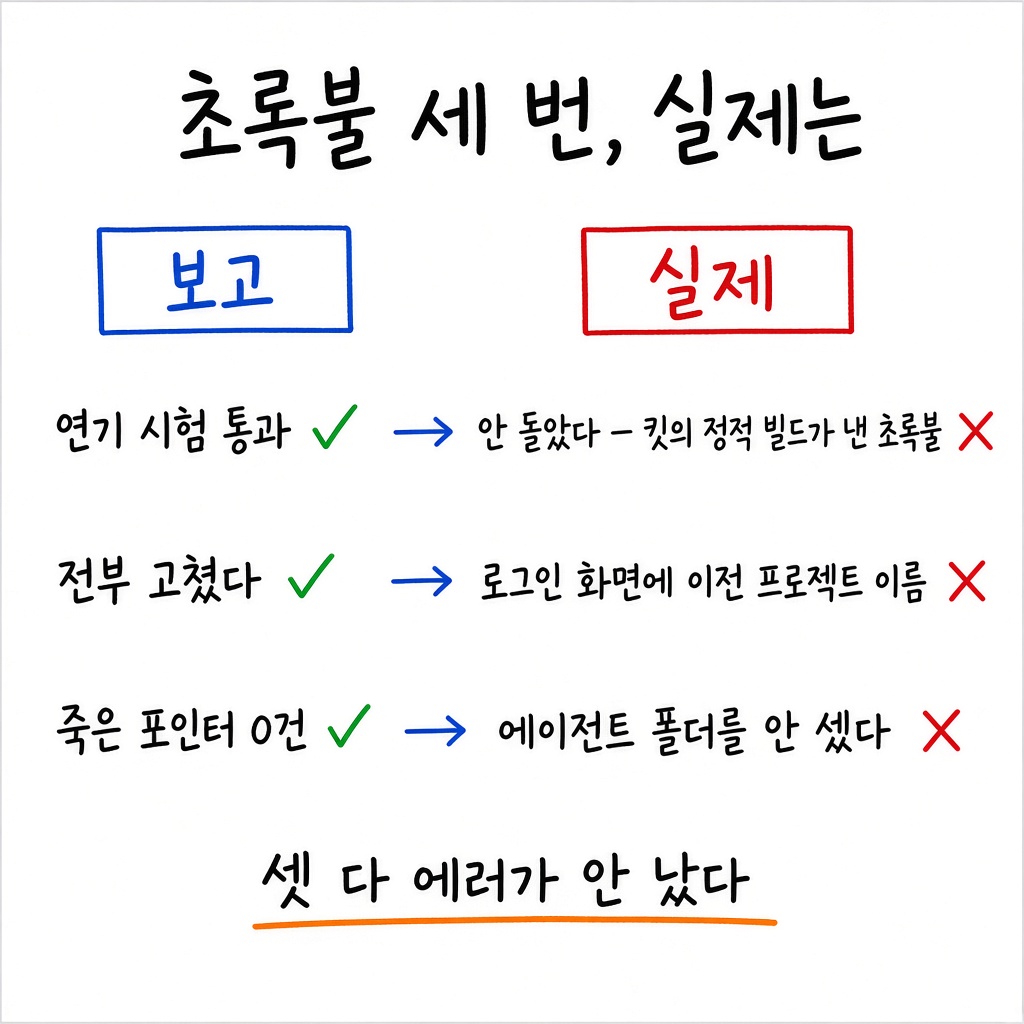
실패할 수 없는 자로 쟀던 일은 테스트 쪽에서도 한 번 겪었습니다. 검증 코드를 통째로 지워도 테스트가 그대로 통과한 적이 있습니다.
비용은 바꾼 부품이 아니라 파이프라인 전체로 잽니다
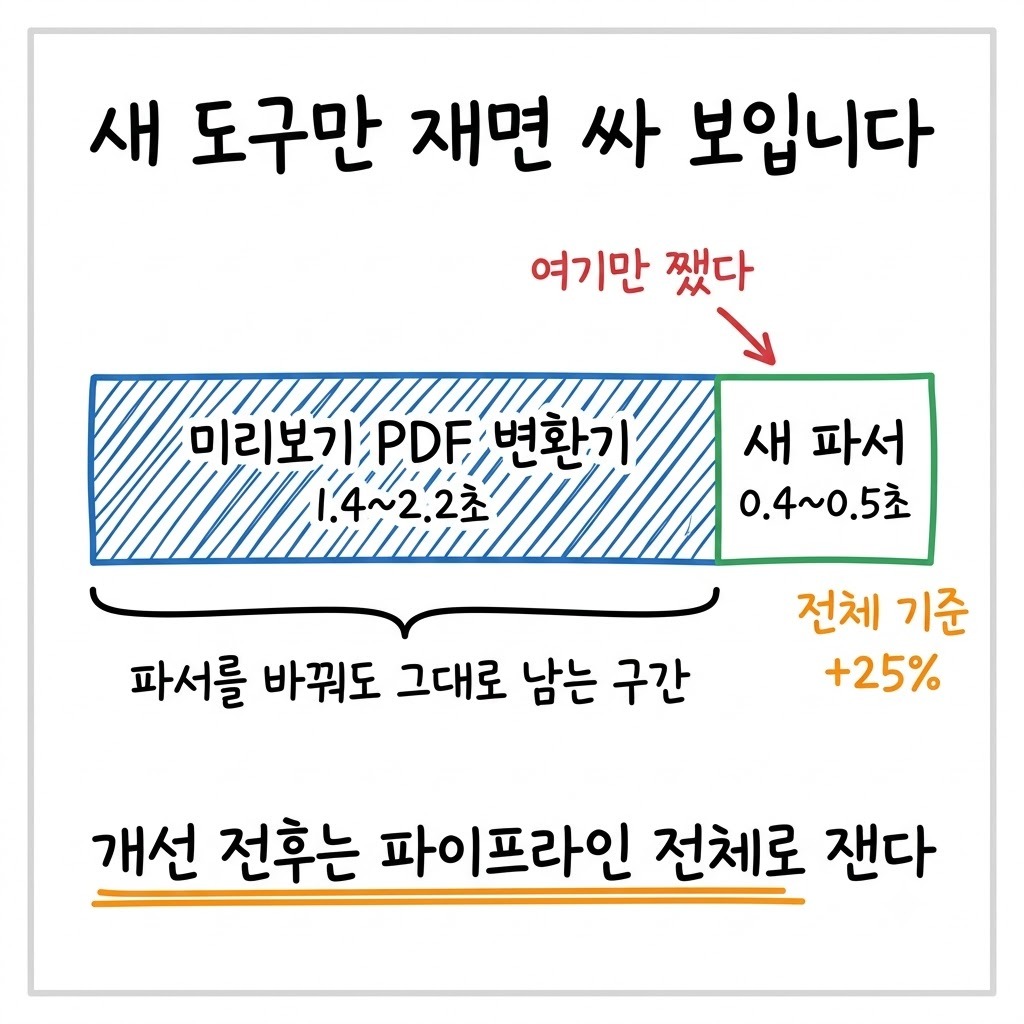
세 번째로 과했던 것은 시간입니다. 새 파서만 재면 싸 보입니다. 그런데 hwp 는 화면에 미리보기 PDF 를 띄워야 해서 변환기를 여전히 부릅니다. 파서를 바꿨어도 그 단계는 그대로 남아 있습니다.
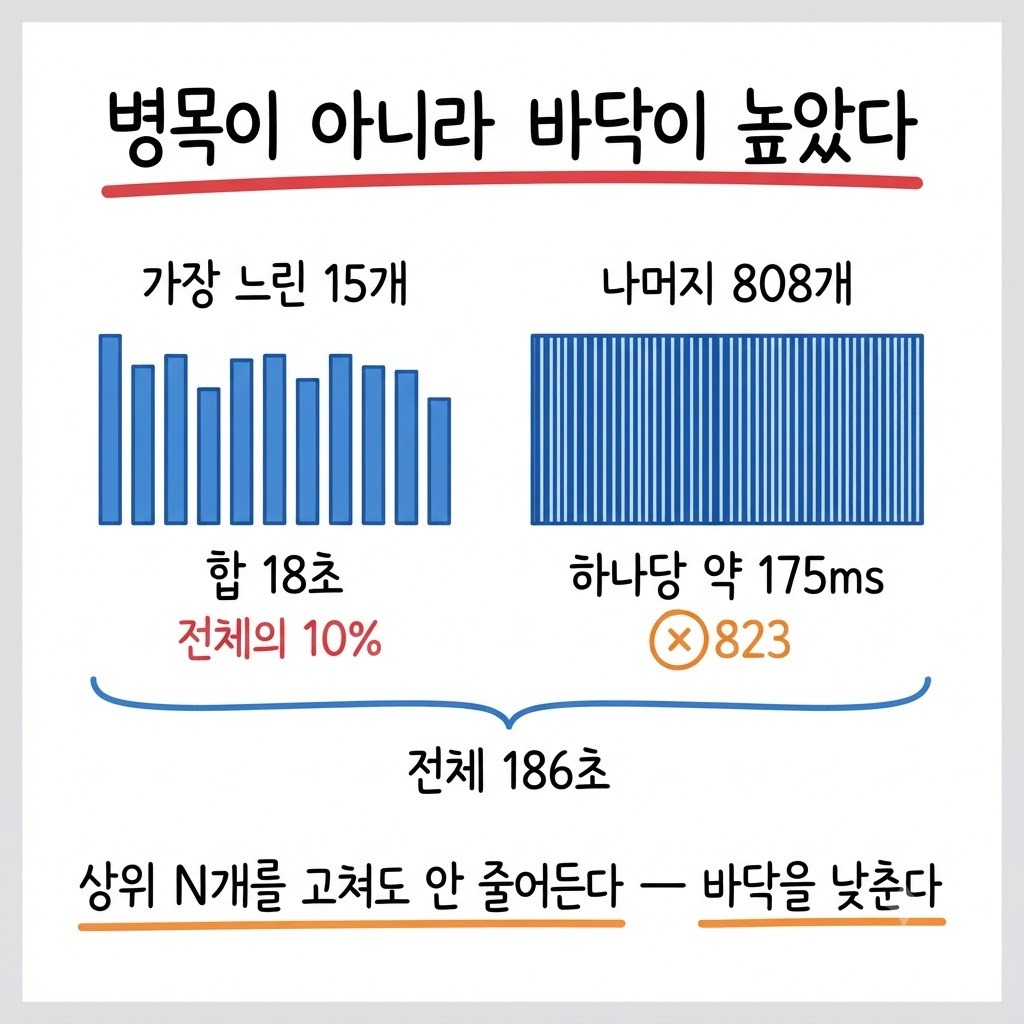
나눠 재니 한 건당 비용의 80% 가 변환기 쪽이었고 1.4~2.2초를 씁니다. 새 파서가 더한 시간은 0.4~0.5초, 전체의 +25% 입니다. 부품만 재면 새 도구가 25% 를 더한다와 전체가 25% 느려진다가 구분되지 않습니다. 그리고 남은 80% 의 병목을 계속 못 보게 됩니다.
개선 수치를 보고하기 전에 보는 것
이게 아니라면 무엇이 보일까. 옛 방식과 새 방식이 같은 값을 낼 수 없는 자는 아무것도 검증하지 않습니다
세는 단위가 말하려는 것과 같은가. 글자 수는 내용이 아니라 분량이고, 구조를 넣으면 구조 기호가 먼저 늘어납니다
결과가 틀려도 이 자를 통과하는가. 통과한다면 그 자는 형식만 보는 자입니다
이득만 쟀나 대가도 쟀나. 다만 대가를 재는 자도 틀릴 수 있으니 그 자에도 같은 질문을 겁니다
바꾼 부품만 쟀나 전체를 쟀나. 남은 구간이 더 클 수 있습니다
하루 뒤에 다시 쟀나. 특히 제목에 들어간 숫자를 다시 잽니다
마지막 항목이 제일 비쌌습니다. 기록에 한 번 박힌 숫자는 그 뒤로 인용만 되고 다시 검증되지 않습니다. 제목에 들어간 숫자는 그중에서도 제일 오래 삽니다. 이번에 그 숫자를 세 번 깎았는데, 세 번 다 남이 아니라 제가 만든 자가 원인이었습니다.
틀린 기록을 지우지 않았습니다
과했던 표를 지우고 새 숫자로 덮어쓰는 편이 깔끔합니다. 그렇게 하지 않고 그 아래에 정정 절을 붙였습니다. 이렇게 적었는데 과했다가 같은 자리에 남아 있으면, 다음 사람이 같은 자를 다시 집어들 때 왜 그 자를 못 믿는지가 같이 읽힙니다. 결론만 남은 문서는 왜 그 자를 버렸는지를 전하지 못합니다.
교체 결정 자체는 그대로 뒀습니다. 과했다는 것과 의미 없었다는 것은 다릅니다. 정정하면서 성과까지 같이 깎아 버리면 다음에 개선을 보고하기가 어려워집니다.
개선 효과는 추출량과 내용의 정확성으로 나눠 확인했고, 처리 비용은 파이프라인 단계별로 적기로 했습니다. 못 가리는 숫자 하나는 못 가린다고 적은 채로 뒀습니다. 다음에 같은 대상을 다시 잴 일이 생기면 그때 돌린 명령과 대상 목록부터 같이 남길 생각입니다.