옆 프로젝트에 파서 문제를 알렸더니, 3년 전 견적서가 올해 문서로 색인돼 있었습니다
사내 문서를 긁어 파싱하고 청크로 잘라 검색에 태우는 도구를 두 곳에서 각자 만들고 있었습니다. 한쪽은 이미 운영 중인 사내 문서 지식그래프 검색 도구였고, 다른 한쪽은 같은 구조를 뒤늦게 다시 푸는 새 플랫폼이었습니다. 포맷별 파서, OCR, 청크 가드라는 똑같은 판을 서로 모르게 두 번 깔고 있었던 셈입니다.
하루 동안 뒤에 선 쪽이 파서 넷을 갈아엎었습니다. 그 과정에서 나온 발견을 먼저 선 쪽에 그때그때 알렸고, **그 알림이 오간 자리에서만 나온 결과가 따로 있었습니다.** 한쪽 혼자서는 못 찾았을 결함이 양쪽에서 각각 나왔습니다.
변환이 값을 바꾸는데 파서는 성공으로 끝납니다
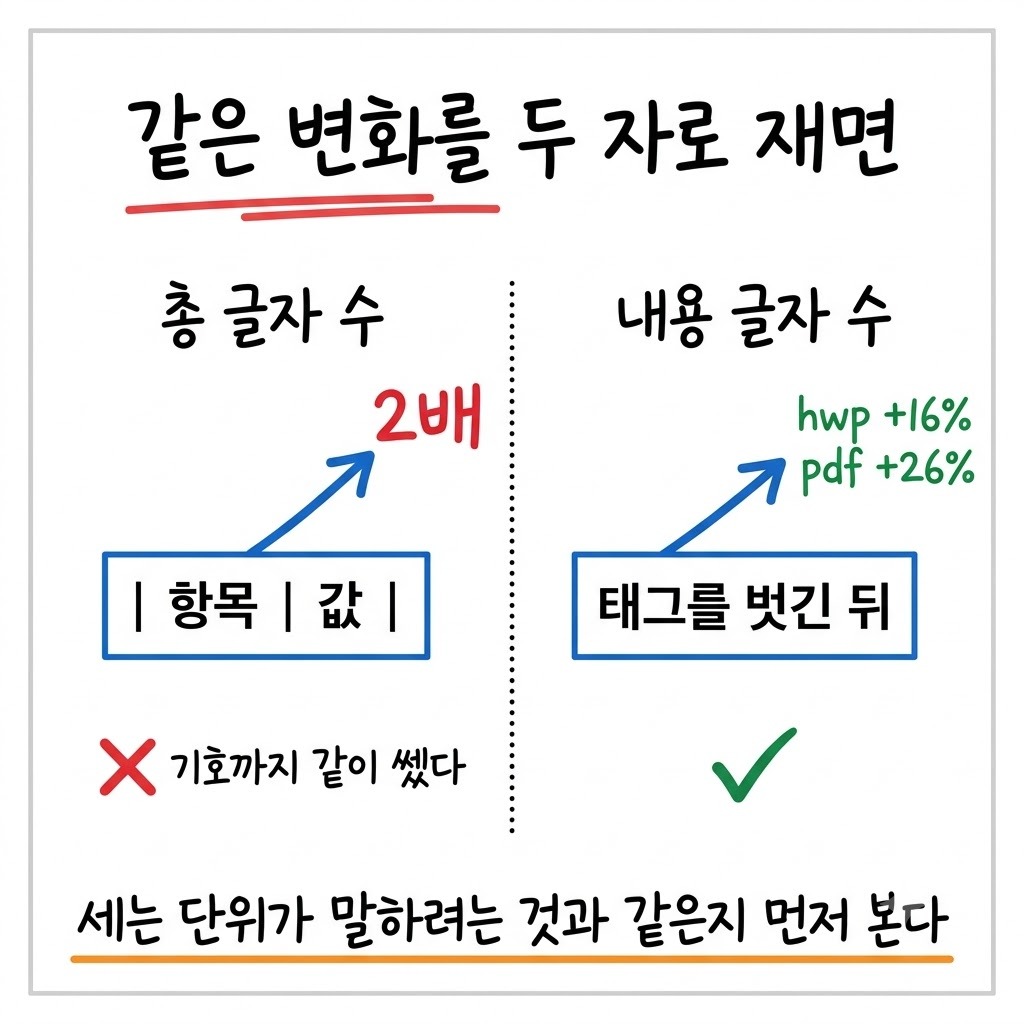
바꾼 것 자체는 단순합니다. 포맷마다 오피스 변환기로 PDF 를 한 번 거쳐 읽던 경로를 걷어내고, 전용 리더로 원본을 직접 읽게 했습니다. 중간 포맷 하나를 뺀 것뿐인데 추출량이 포맷마다 수 배에서 수십 배로 달라졌습니다.
포맷 | 전 (변환 경유) | 후 (전용 리더) |
|---|---|---|
표계산 옛 포맷 | 표 줄 0 | 표 줄 243 · 값 오류 셀 0 |
프레젠테이션 | 표 줄 1,077 · 표가 잡힌 문서 55건 | 표 줄 37,823 · 표가 잡힌 문서 104건 |
워드 문서 | 표 줄 173 | 표 줄 1,051 |
프레젠테이션 쪽이 약 35배입니다. 표가 납작하게 뭉개져 들어가고 있었다는 뜻이고, 검색이 표 안의 수치를 못 집던 이유가 거기 있었습니다.
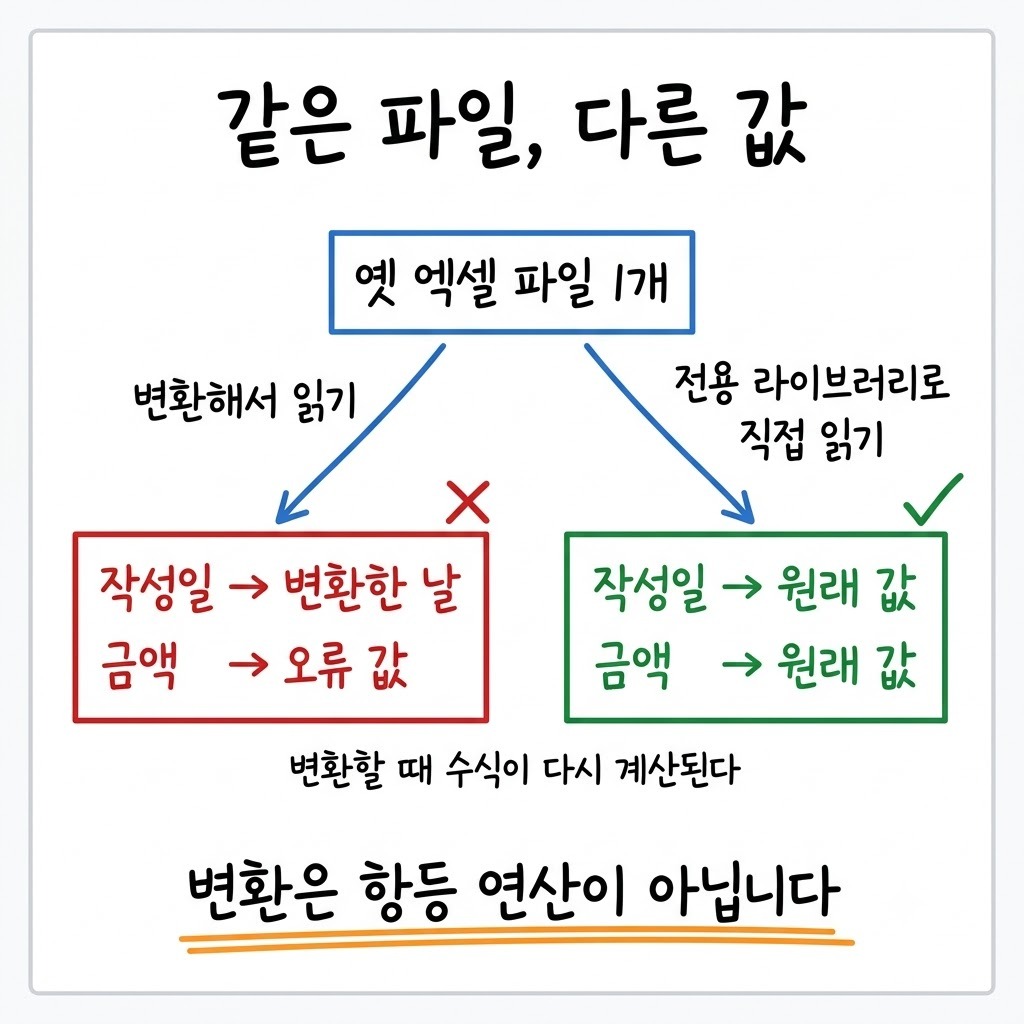
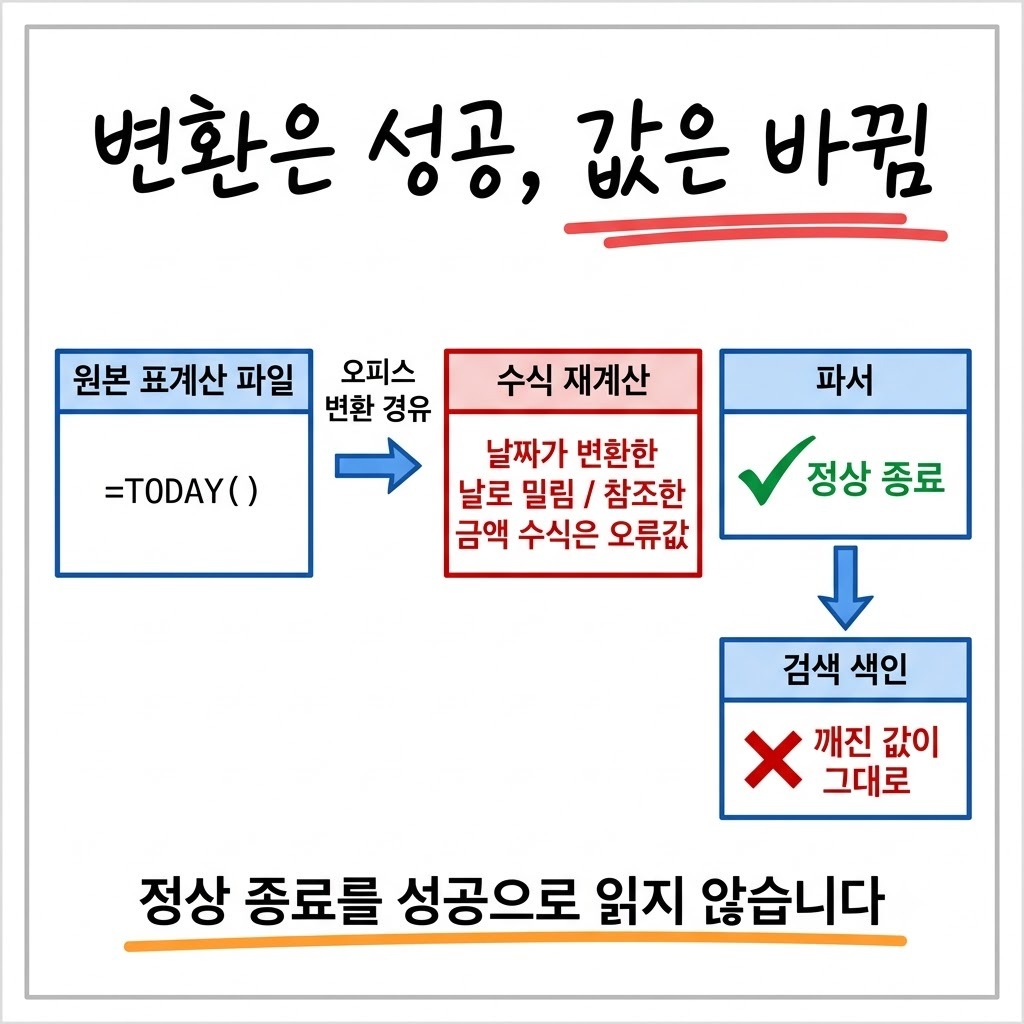
그런데 가장 값진 발견은 양이 아니었습니다. 오피스 변환기로 표계산 파일을 다른 포맷으로 옮기면 **수식이 다시 계산됩니다.** 오늘 날짜를 반환하는 함수가 변환한 날로 밀리고, 그 값을 참조하던 금액 수식은 오류값으로 깨집니다. 그리고 **파서에는 에러가 안 납니다** — 정상 종료하고, 깨진 값이 그대로 색인됩니다.
이것은 앞의 표와 등급이 다른 문제입니다. 표 줄이 덜 잡히는 것은 검색 품질 문제고, 값이 바뀌는 것은 오답 문제입니다. 같은 파서 이슈 목록에 섞어 두면 우선순위가 갈립니다.
변환기가 수식을 다시 계산하는 대목은 따로 한 번 더 파 봤습니다.
알림 한 줄이 옆 코퍼스의 전수 조사 질의가 됐습니다
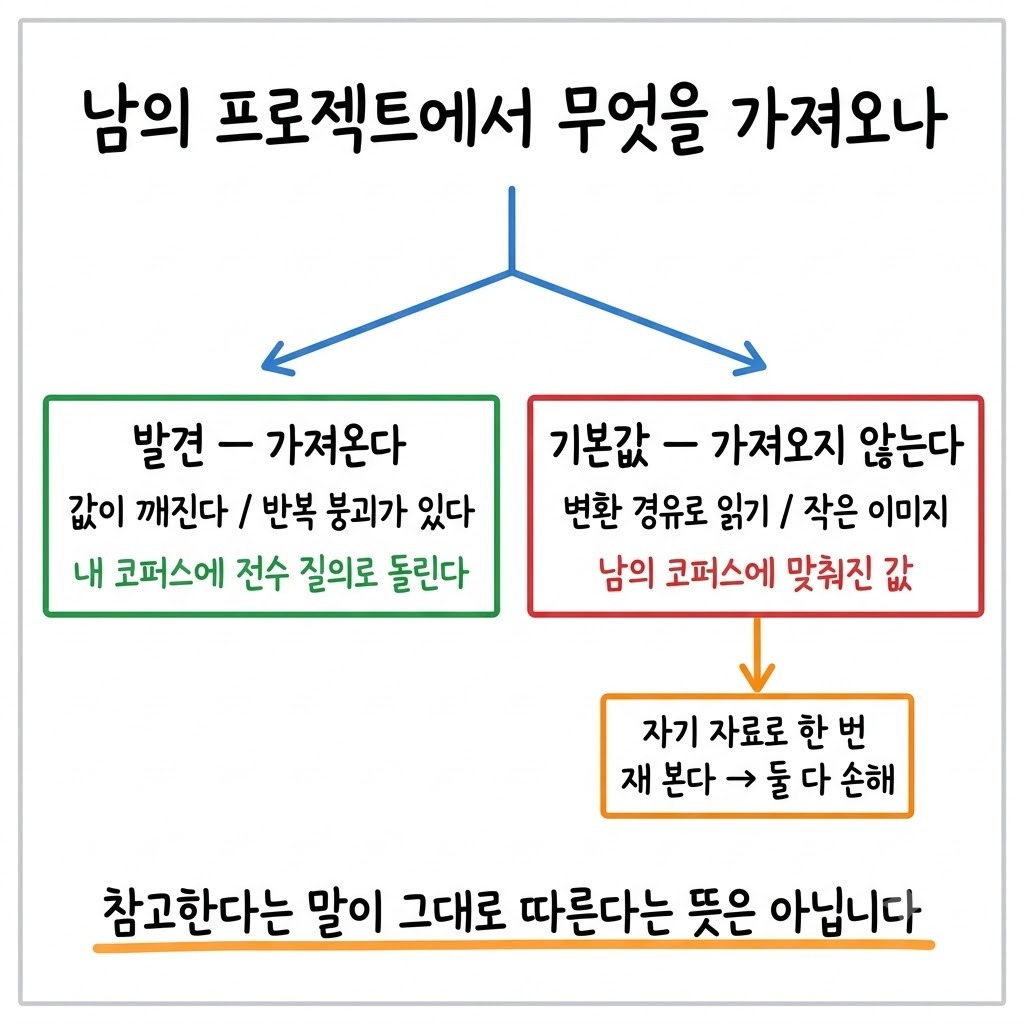
값이 깨진다는 사실을 먼저 선 쪽에 알렸습니다. 그쪽은 그 말을 고치라는 요구로 받지 않고 **자기 코퍼스 전체에 같은 질의를 돌렸습니다.** 오류값 셀이 들어간 표를 전부 찾아낸 결과, 3년 전 견적서가 올해 문서로 색인돼 있었습니다. 오류값 셀 32개, 값이 바뀐 문서 20건이 재색인 대상으로 잡혔습니다.
남이 자기 버그를 찾아 준 것이 아닙니다. **남의 발견이 자기 질의가 된 것입니다.** 혼자였으면 그 질의를 던질 이유가 없었습니다. 색인은 돌고 있었고 검색도 결과를 냈고, 연도가 밀린 문서는 밀렸다는 표시를 어디에도 남기지 않았습니다.
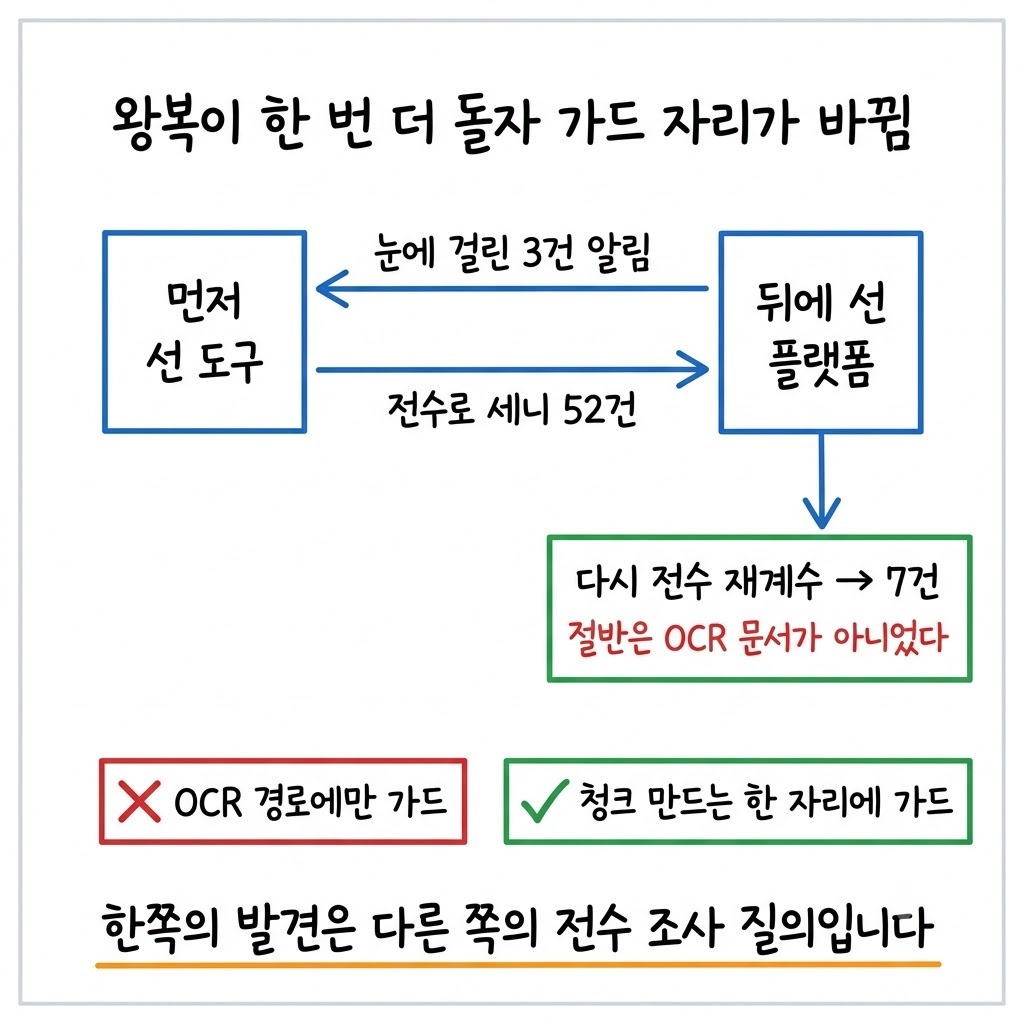
반대 방향 왕복도 같은 모양이었습니다. 뒤에 선 쪽이 같은 문구가 반복되며 붕괴하는 청크를 3건 발견해 알렸습니다. 앞에 선 쪽이 전수로 세니 52건이 나왔고, 그 숫자를 보고 뒤쪽이 다시 전수로 셌습니다.
뒤쪽이 눈에 걸린 3건을 알립니다
앞쪽이 자기 코퍼스를 전수로 세어 52건을 찾습니다
그 숫자를 보고 뒤쪽이 다시 전수로 세니 7건, 합쳐 82,608자였습니다
7건 중 절반이 OCR 을 거친 문서가 아니라 원래 글자층이 있는 문서였습니다
마지막 줄이 중요합니다. 처음 발견한 3건은 전부 OCR 결과물이었습니다. 거기서 멈췄으면 가드를 OCR 경로에만 붙였을 것이고, 그러면 절반을 못 잡았을 겁니다. 전수로 다시 센 덕에 가드가 붙을 자리가 **OCR 경로가 아니라 청크를 만드는 한 자리**로 옮겨졌습니다. 적용 뒤 '반복 붕괴'는 0건입니다.
발견은 가져오고 기본값은 가져오지 않았습니다
참고한다는 말이 그대로 따른다는 뜻은 아닙니다. 이미 운영 중인 쪽의 설정은 검증된 값처럼 보이지만, **그쪽 코퍼스에 맞춰진 값**입니다. 가져오기 전에 자기 자료로 한 번 재 봤고, 두 건이 다 손해였습니다.
프레젠테이션을 오피스 변환 경유로 읽는 기본 설정 — 그대로 따랐으면 표 줄 35배를 놓쳤을 겁니다
아이콘을 걸러내려고 둔 최소 픽셀 기준 — 가져왔으면 뒤쪽 문서 8건을 통째로 버렸을 겁니다. 그 8건은 전부 글자가 든 가로 띠 캡처라 작은 이미지로 분류됩니다
두 번째가 특히 아슬아슬했습니다. 아이콘이 실제로 많은 자료라면 그 기준은 맞는 선택입니다. 설정이 틀린 것이 아니라 **코퍼스가 다른 것**이고, 그 차이는 자기 자료에 대 보기 전에는 안 보입니다.
OCR 은 기준을 하나로 모았습니다. 사내 GPU 에 올린 오픈 모델과 외부 상용 멀티모달 API 가 섞여 있으면 어느 모델이 낸 글자인지에 따라 품질이 갈립니다. 353건 1,503쪽을 전량 다시 전사해 한쪽으로 통일했습니다. 종량제 창구라 회차마다 비용이 드는데, 두 모델의 결과가 섞인 상태를 남기는 쪽이 더 비쌀 것으로 봤습니다.
파서를 바꾸면 추출량이 늘어나는 것 자체가 품질 개선인지는 따로 재 봐야 합니다.
공유는 메시지가 아니라 파일로 남겼습니다
오간 내용이 대화 메시지로만 남으면 다음 세션에 사라집니다. 그래서 공용 참고문서를 저장소로 만들어 커밋했습니다. 안에 든 것은 네 가지입니다.
포맷별 결정표 — 어느 포맷을 어느 리더로 읽는지, 왜 그렇게 정했는지
검색 적재 규칙 — 청크를 만드는 자리와 거기 붙은 가드
두 프로젝트 대조표 — 같은 항목에서 양쪽 설정이 어떻게 다른지
주고받기 — 질문과 답을 파일로 남깁니다. 세션 메시지는 만료되기 때문입니다
그리고 양쪽 에이전트 메모리에 이 저장소를 등록했습니다. **다음 세션이 파서를 건드리기 전에 읽게** 하는 것이 목적입니다. 읽는 시점을 강제하지 않으면 결정표는 있어도 안 읽히고, 다음 사람이 같은 함정을 다시 밟습니다.
회귀 15문항으로 확인했습니다. 14/15 유지, 나빠진 문항 0, 그리고 **근거 파일이 더 맞는 자료로 바뀐 것이 11문항**입니다. 점수는 그대로인데 답의 출처가 달라진 것이 이번 작업의 실제 결과입니다.
같은 일을 두 곳에서 할 때 점검할 것
중간 포맷을 거치는 구간이 있는지 — 변환은 양만 줄이는 것이 아니라 값을 바꿉니다
정상 종료를 성공으로 읽고 있는지 — 조용히 틀리는 변환은 에러를 안 냅니다
상대가 알려 온 발견을 전수 조사 질의로 바꿔 봤는지 — 눈에 걸린 건수가 전체 건수는 아닙니다
상대의 기본 설정을 자기 자료로 재 봤는지 — 운영 중이라는 사실이 내 코퍼스에 맞다는 근거는 아닙니다
결정이 만료되는 채널에 남아 있는지 — 세션 메시지에 남긴 결정은 다음 세션에 사라집니다
이 왕복에는 비용이 듭니다. 서로 알리고 다시 세는 데 시간이 들고, 발견의 등급이 표가 조금 덜 잡히는 수준이면 과합니다. 발견이 '값이 틀린다' 등급일 때만 값을 합니다.
그리고 코퍼스가 닮아야 대 보는 값이 나옵니다. 도메인과 포맷 분포가 완전히 다르면 상대의 수치는 소음입니다. 이번에는 둘 다 사내 문서 검색이라 성립했습니다. 공용 문서도 유지 비용이 들어서, 참여가 늘거나 한쪽이 멀어지면 결정표가 낡습니다. 낡은 결정표는 없는 것보다 나쁩니다.