엑셀을 PDF 로 바꿔 색인했더니, RAG 청크의 35%가 읽을 수 없는 상태였습니다
자매 법인용 새 플랫폼의 문서 엔진을 새로 만들면서, 같은 팀이 먼저 만든 옆 저장소의 문서 엔진을 참고했습니다. 설계서에 참고 경로와 참고한 파일까지 적어 뒀으니 저는 이걸 '베꼈다'에 가깝다고 생각했습니다. 그 상태로 색인을 돌렸고, 한 공공 발주처 대상 사전검증(POC) 자료에서 표에 대한 질문이 이틀 내내 '근거 없음'으로 돌아왔습니다.
결론부터 적으면 원인은 검색이 아니라 색인에 있었습니다. 표 파일을 PDF 로 바꿔 글자를 뽑고 있었고, 그 과정에서 어느 행의 어느 칸인지가 사라져 있었습니다. 참고한 옆 저장소는 표를 그 길로 보내지 않고 있었습니다.
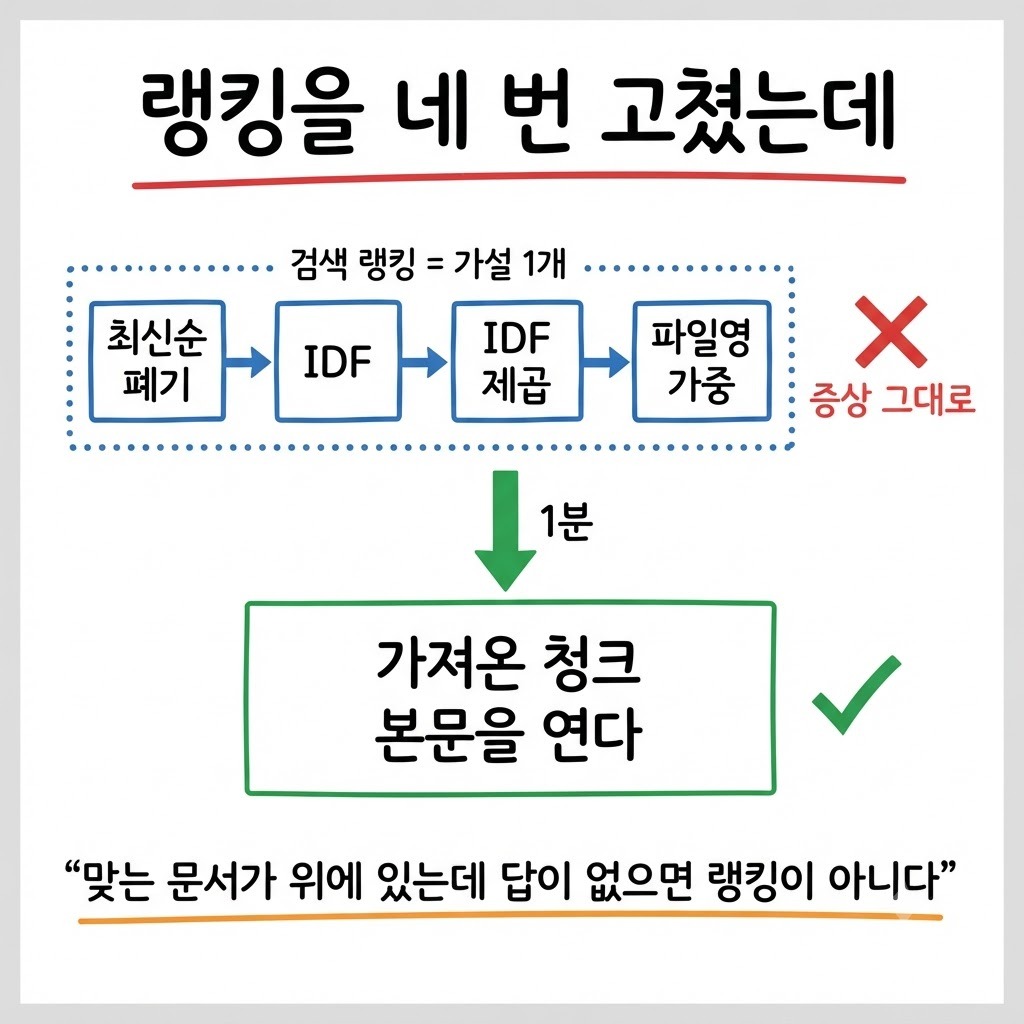
랭킹을 네 번 고치는 동안 가설은 한 번도 안 바뀌었습니다
증상은 단순했습니다. 특정 요건 번호가 무엇인지 묻는 질문에 계속 근거를 못 찾는다는 답이 나왔습니다. 저는 검색이 엉뚱한 문서를 위에 세운다고 봤고, 스코어링을 네 번 손봤습니다.
최신순 가중을 폐기 — 오래된 문서가 무조건 아래로 밀리는 것을 막았습니다
IDF 도입 — 흔한 낱말의 기여도를 낮췄습니다
IDF 제곱 — 희귀 낱말을 더 세게 밀어 올렸습니다
파일명 포함 가중 — 질문의 낱말이 파일명에 있으면 점수를 더했습니다
네 번 다 개선 자체는 맞았습니다. 지금도 그 변경은 코드에 남아 있습니다. 다만 이 문제와는 아무 상관이 없었습니다. 같은 가설을 네 가지 방식으로 변주하는 동안 가설 자체를 의심하는 자리가 한 번도 없었습니다.
방향이 바뀐 건 한 문장 때문이었습니다. 검색 결과 목록을 보니 맞는 문서가 상위에 올라와 있는데도 답이 안 나오고 있었습니다. 그렇다면 순서 문제가 아닙니다. 그래서 랭킹 대신 모델에게 실제로 전달되는 청크 본문을 직접 열었습니다.
표가 표가 아니었습니다
청크 본문 한 줄을 눈으로 본 순간 원인이 보였습니다. 걸린 시간은 1분이 안 됐습니다. 본문은 이런 모양이었습니다.
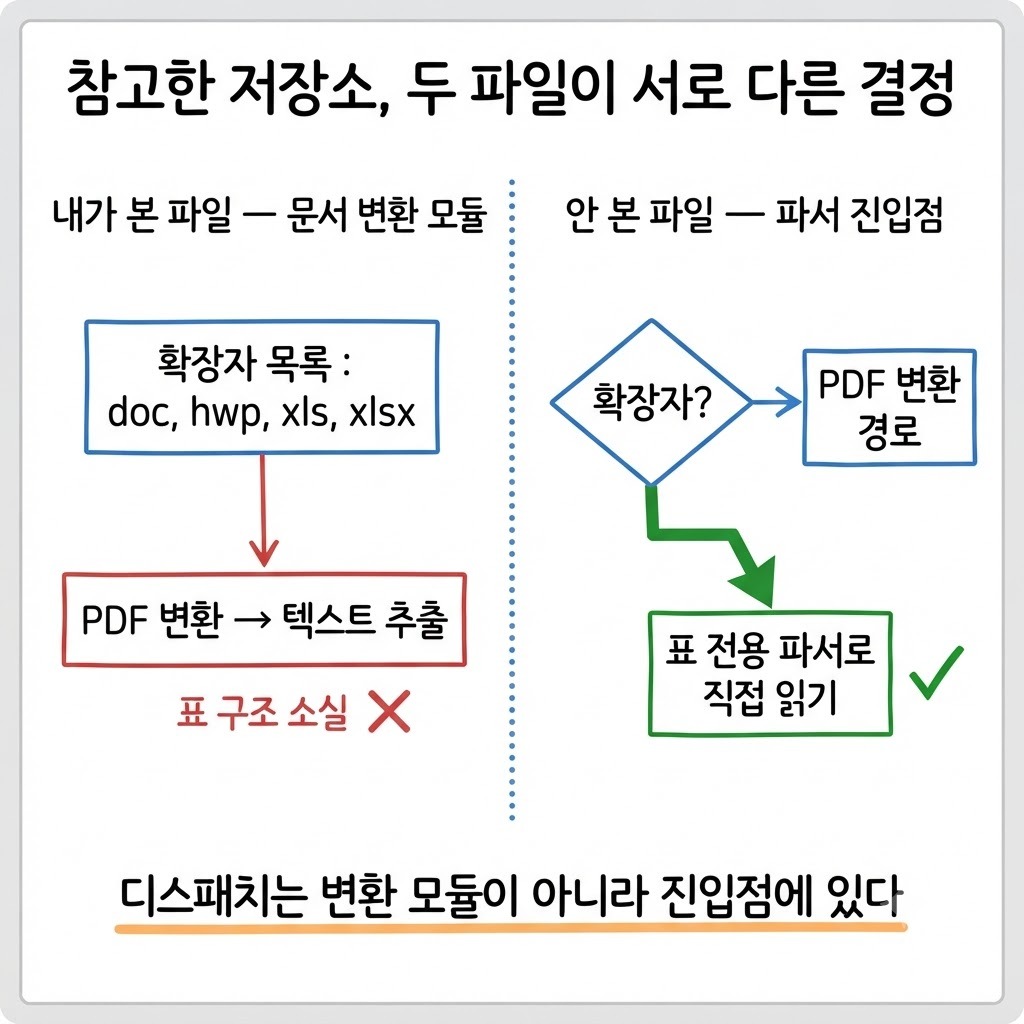
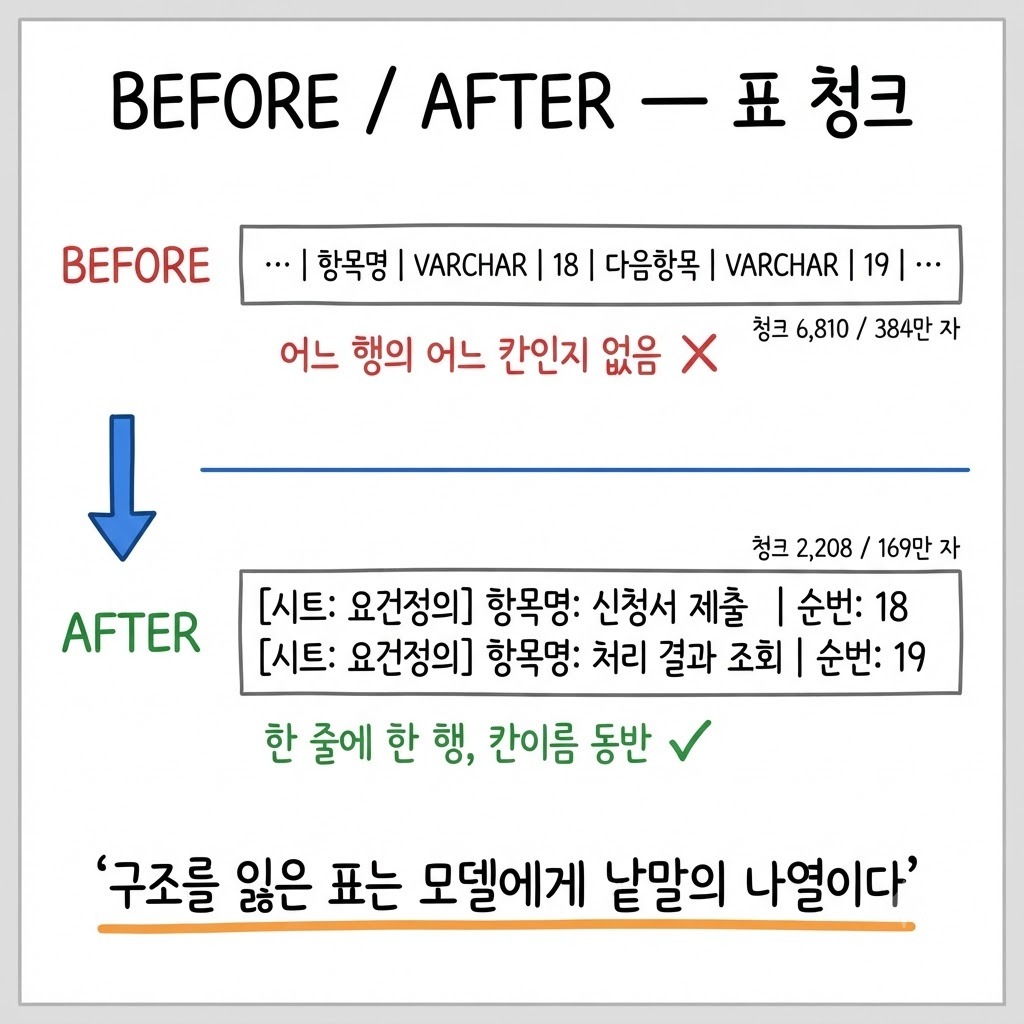
… | 항목명 | VARCHAR | 18 | 다음항목 | 설명 | VARCHAR | 19 | …표 파일(xlsx·xls)을 LibreOffice 로 PDF 로 변환한 뒤 텍스트를 뽑고 있었습니다. 변환은 사람이 눈으로 보기 위한 배치를 만드는 작업입니다. 셀이 시각 순서대로 한 줄에 늘어서면서, 어느 행의 어느 칸인지를 말해 주던 구조가 통째로 사라졌습니다.
사람이 저 줄을 읽고 '18번 요건의 항목명은 무엇인가'에 답할 수 없다면 모델도 못 합니다. 검색은 제 일을 하고 있었습니다. 맞는 문서를 가져왔는데 그 문서의 내용이 읽을 수 없는 상태였을 뿐입니다. 이 상태의 문서가 84건, 청크로는 6,873개였고 전체 청크의 35% 였습니다.
파이프라인이 만든 중간 산출물도 원본입니다. 원본을 직접 확인했느냐를 물을 때, RAG 에서 원본은 원천 문서만이 아니라 색인에 들어간 청크이기도 합니다. 저는 그걸 한 번도 안 열어 본 채로 나흘을 썼습니다.
수집 단계가 검색 품질을 먼저 정한다는 이야기는 전에도 한 번 쓴 적이 있습니다. 그때는 한글 문서를 넣는 쪽이 문제였고, 이번에는 표였습니다.
참고했다는 말이 그 결정을 봤다는 뜻은 아니었습니다
왜 이렇게 만들었는지를 거슬러 올라가니 설계서의 한 줄이 나왔습니다. '표 형식은 문서 변환 모듈을 베낀다'였습니다. 그리고 그 변환 모듈은 실제로 열어 봤습니다. 다만 한글 문서 변환 필터를 보려고 연 것이었고, 거기 오피스 확장자 목록에 표 형식이 들어 있길래 표도 이 길로 간다고 옮겨 적었습니다.
참고한 쪽은 표를 그 길로 보내지 않았습니다. 같은 저장소의 파서 진입점이 표 전용 라이브러리(openpyxl)로 직접 읽고 있었습니다. 한 저장소 안에서 서로 다른 파일이 서로 다른 결정을 하고 있었고, 저는 한쪽만 보고 전부 그렇다고 일반화했습니다.
디스패치(어떤 형식이 어느 파서로 가는지를 정하는 분기)는 대개 변환 모듈이 아니라 파서 진입점에 있습니다. 변환 모듈의 확장자 목록은 '이 모듈이 처리할 수 있는 것'이지 '이 모듈로 오는 것'이 아닙니다. 목록에 이름이 있다고 그 길로 간다는 보장이 없습니다.
덤으로 빠뜨린 것이 하나 더 있었습니다. 참고한 쪽에는 이름 없는 사용자 속성이 파일에 남아 있으면 표 라이브러리가 그 파일을 통째로 거절하는 문제에 대한 방어가 있었습니다. 주석에는 그 방어를 붙이기 전에 문서 4건이 색인에서 누락됐던 기록이 같이 남아 있었습니다. 이번에 뒤늦게 옮겨 왔습니다. 예외 처리와 복구 경로는 상대가 사고를 겪고 붙인 것이라, 참고한 쪽에서 우리가 안 가져온 것을 한 번 훑는 일이 가장 값싼 학습입니다.
표를 표로 넣는 직렬화
고친 방향은 간단합니다. 표 형식은 PDF 변환 경로에서 빼고 표 전용 파서로 직접 읽습니다. 그리고 텍스트가 스스로 '어느 행의 어느 칸인지'를 말하게 만들었습니다.
시트마다 시트 이름과 머리행을 청크 앞에 붙입니다
한 줄에 한 행을 담고, 각 칸은 '칸이름: 값' 형태로 적습니다
표본 데이터 시트는 앞 20행만 남기고 나머지는 생략 표시를 답니다
[시트: 요건정의] 항목명: 신청서 제출 | 자료형: VARCHAR | 순번: 18
[시트: 요건정의] 항목명: 처리 결과 조회 | 자료형: VARCHAR | 순번: 19
표본 데이터 시트를 판단하는 기준은 두 가지를 같이 봅니다. 값처럼 생긴 칸이 60% 를 넘고, 동시에 행이 60행을 넘으면 데이터 덤프로 간주합니다. 이런 시트는 300행을 다 넣어도 검색에 기여하는 정보가 앞 몇 줄과 다르지 않고, 청크만 부풀립니다.
기존 문서 78건을 다시 파싱한 결과입니다.
항목 | 재파싱 전 | 재파싱 후 |
|---|---|---|
청크 수 | 6,810개 | 2,208개 |
글자 수 | 384만 자 | 169만 자 |
표 질문 응답 | 근거 없음 | 정상 답변 |
청크가 3분의 1 수준으로 줄고 글자 수는 절반 아래로 떨어졌습니다. 같은 문서인데 들어가는 양이 줄었다는 건 그만큼이 읽을 수 없는 노이즈였다는 뜻입니다. 검색 품질과 임베딩 비용이 같이 좋아졌습니다.
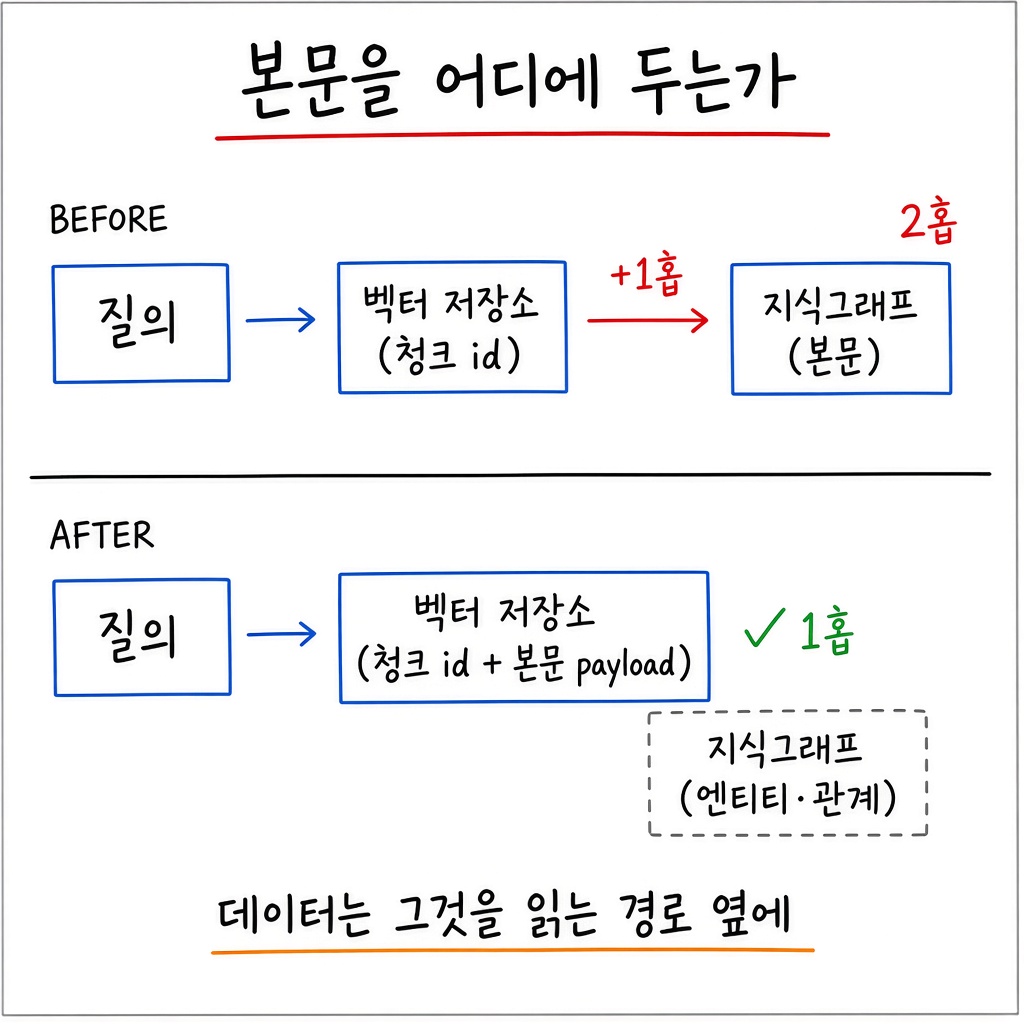
청크에 무엇이 담기느냐가 검색 결과를 가른다는 점은 벡터 payload 를 손봤을 때도 같았습니다. 검색기를 바꾸지 않고 넣는 내용만 바꿔 한 홉이 줄었습니다.
이 처방이 안 맞는 자리
표를 PDF 로 바꾸는 경로가 늘 틀린 것은 아닙니다. 원본이 이미 PDF 이거나, 표가 서술형 문서에 끼어 있는 부속물이면 평면화 비용이 크지 않습니다. 문제는 데이터 시트가 주인공인 문서에 그 경로를 그대로 적용한 것이었습니다.
행 단위 직렬화도 만능은 아닙니다. 병합 셀·다층 머리행·피벗 표는 한 줄 한 행으로 펴지지 않습니다. 이번 처방은 머리행 하나에 아래로 데이터가 쌓이는 형태에 맞춘 것입니다.
표본 시트 생략은 명백한 손실입니다. '그 표의 300번째 행에 뭐가 있나' 같은 질문은 이제 답할 수 없습니다. 검색용 코퍼스와 원본 조회를 분리해 두고, 원본이 필요한 질문은 문서 자체를 열어 보게 한다는 전제가 있어야 성립합니다.
같은 실수를 안 하려고 바꾼 것
설계서 작성 규칙을 하나 바꿨습니다. 참고 출처를 적을 때 어느 파일의 무엇을 참고했는지까지 적습니다. '변환 모듈을 베낀다'는 나중에 검증할 수가 없습니다. 무엇을 베꼈는지가 문장에 없어서입니다.
설계서·PR 본문의 참고 문구에 파일명과 함수명이 들어 있는가
옮겨 온 형식이 상대 저장소에서 어느 파서로 가는지 진입점에서 확인했는가
상대 저장소에 있는데 우리가 안 가져온 예외 처리가 무엇인지 한 번 훑었는가
검색이 맞는 문서를 가져오는데 답이 안 나올 때, 청크 본문을 눈으로 읽어 봤는가
RAG 를 디버깅하는 순서로 정리하면 이렇습니다. 랭킹은 덜 맞는 문서가 위에 설 때의 처방입니다. 맞는 문서가 위에 있는데도 답이 안 나오면 그때부터는 랭킹이 아니라 가져온 청크의 본문을 읽습니다. 이 구분 하나가 이틀을 가릅니다.
코드베이스가 작고 전부 내가 쓴 코드라면 옆 저장소를 열어 보라는 조언이 과할 수 있습니다. 이 확인에 값이 붙는 순간은, 남이나 과거의 내가 겪은 사고가 그 코드에 이미 박혀 있을 때입니다.