알람에선 '경고'였는데 인시던트에선 '치명'이라고?
AI 운영·관제 플랫폼을 만들고 있습니다. 서버의 CPU·메모리·디스크 같은 자원 지표를 감시하다가 임계치를 넘으면 알람을 올리고, 상황이 심각하면 알람을 인시던트로 격상해 대응 흐름을 태우는 구조입니다.
알람의 심각도는 임계치 규칙이 산정합니다. CPU와 메모리는 90% 초과면 high, 95% 초과면 critical. 디스크는 80%와 90%가 기준입니다. 조건이 명확하니 값도 결정적입니다. 같은 지표가 들어오면 언제나 같은 심각도가 나옵니다.
인시던트로 격상되는 순간부터는 LLM이 등장합니다. 영향 분석이나 원인 추정 같은 초안을 LLM이 써 주면 운영자가 검토하는 흐름입니다. 여기까지는 설계 의도대로 굴러가는 줄 알았습니다.
같은 건인데 알람에선 '경고', 인시던트에선 '치명'
어느 날 이상한 화면을 봤습니다. 알람 목록에는 '경고'로 떠 있는 건이, 격상된 인시던트 상세에서는 '치명'으로 표시돼 있었습니다. 같은 사건의 심각도가 화면마다 달랐습니다.
운영자 입장에서 이건 표기 오류 수준의 문제가 아닙니다. '치명'이면 즉시 대응 대상이고 '경고'면 관찰 대상입니다. 두 값이 다르면 어느 쪽을 믿을지부터 정해야 하고, 그 사이 대응은 멈춥니다. 어느 값이 맞느냐 이전에, 같은 값이 두 화면에서 다르게 존재한다는 것 자체가 사고였습니다.
원인을 추적해 보니 인시던트 초안을 쓰는 LLM 프롬프트였습니다. 초안 출력 스키마에 severity 필드가 들어 있었고, LLM은 시키는 대로 상황을 읽고 심각도를 다시 판단해 내놓았습니다. 그 값이 저장 단계에서 규칙이 산정한 원래 값을 덮어쓰고 있었습니다.
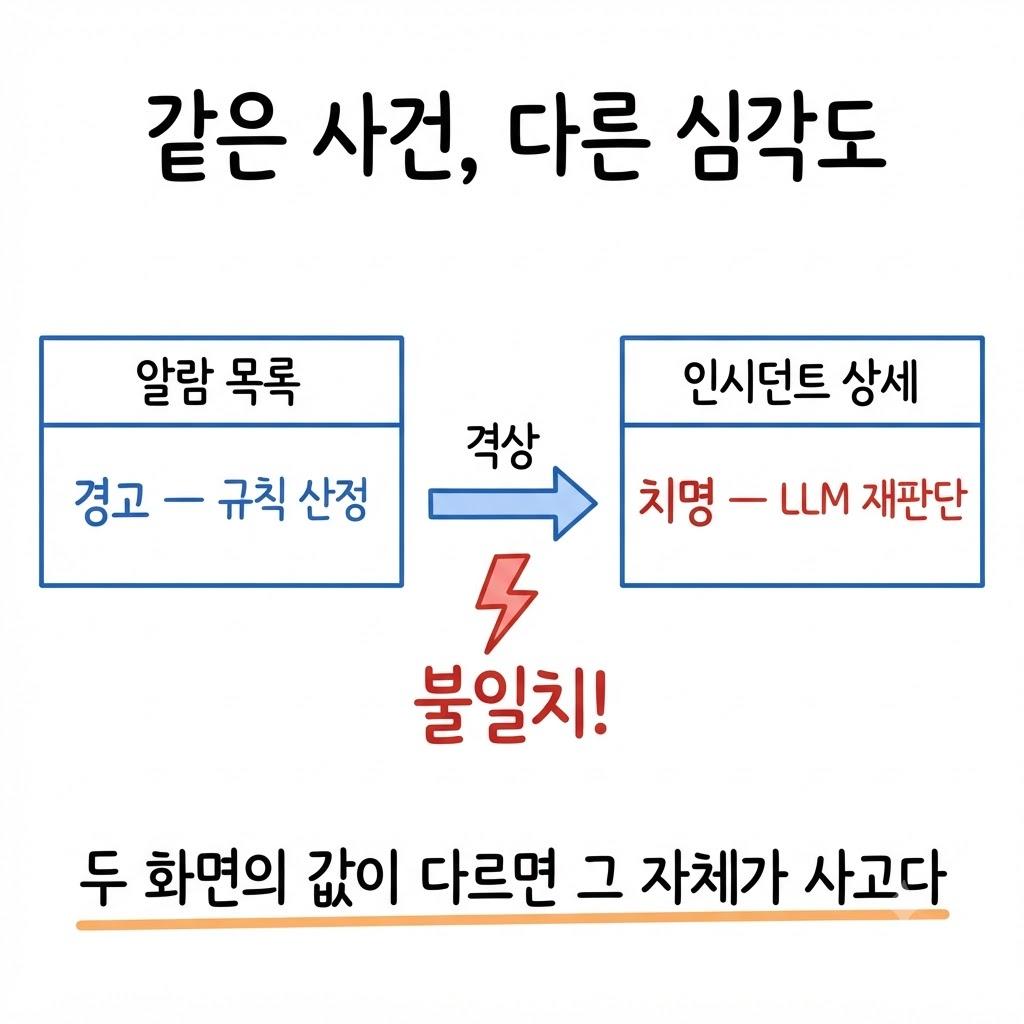
재판단은 정확도를 높이지 않고 불일치를 만든다
처음엔 프롬프트를 고쳐 LLM이 심각도를 더 잘 판단하게 만들 생각도 했습니다. 알람 맥락을 더 넣어주면 규칙과 비슷한 값을 내지 않을까. 파보니 방향 자체가 틀린 접근이었습니다.
임계치 규칙이 산정한 값은 결정적이고 설명 가능합니다. 'CPU 96%라서 critical'은 누구에게든 한 줄로 설명됩니다. 반면 LLM의 재판단은 같은 입력에도 흔들릴 수 있고, 왜 그 값인지 설명하려면 프롬프트와 모델을 통째로 꺼내야 합니다. 더 권위 있는 원천이 이미 값을 정했는데, 덜 권위 있는 쪽에 같은 질문을 다시 던진 셈입니다.
그래서 결정을 못박았습니다. 심각도는 알람 값을 그대로 승계한다. AI는 심각도를 판단하지 않는다. LLM은 자기가 잘하는 서술과 분석만 하고, 결정적 값은 규칙이 소유합니다.
결정적 값은 코드가 쥐고 판단만 LLM에 맡기는 원칙은 이번이 처음이 아닙니다. 일일 정리 파이프라인에서 LLM이 생성하던 본문을 코드 생성으로 되돌렸던 결정과 같은 선 위에 있습니다.
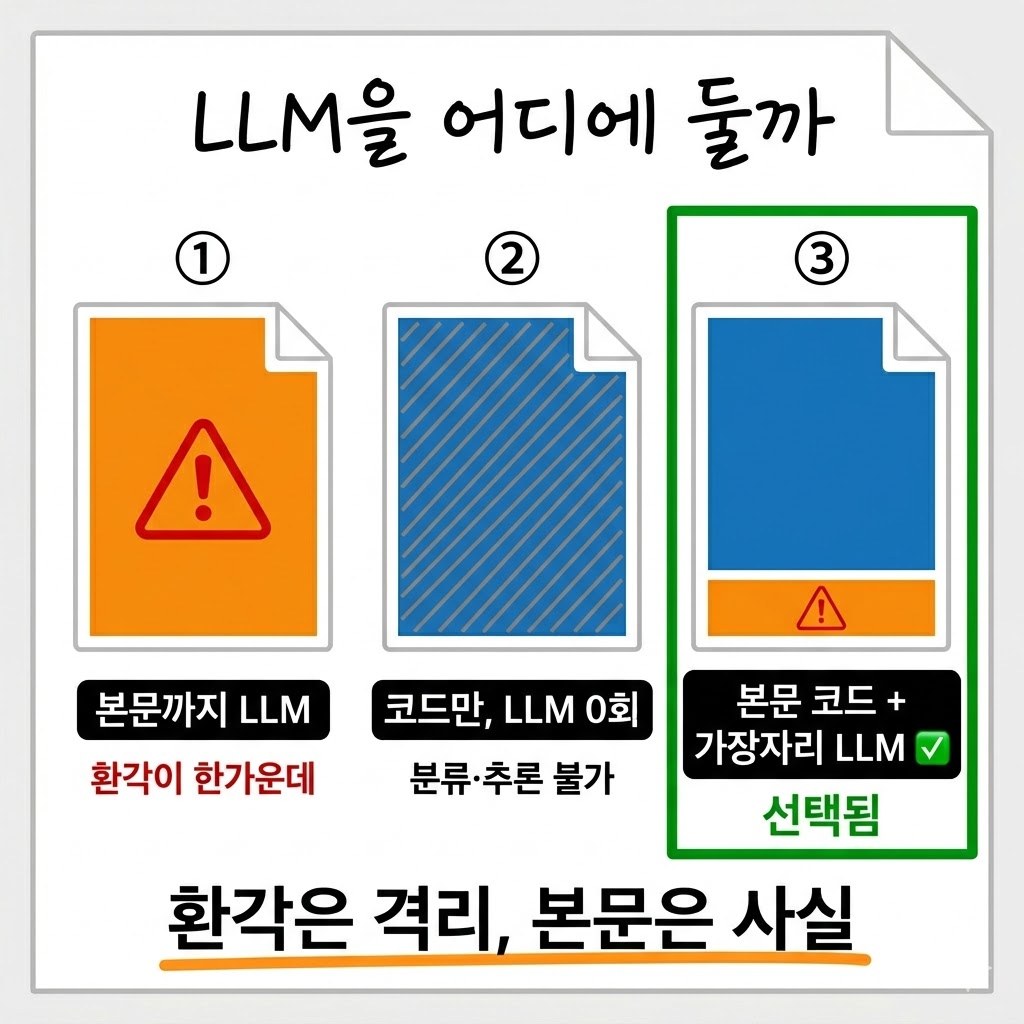
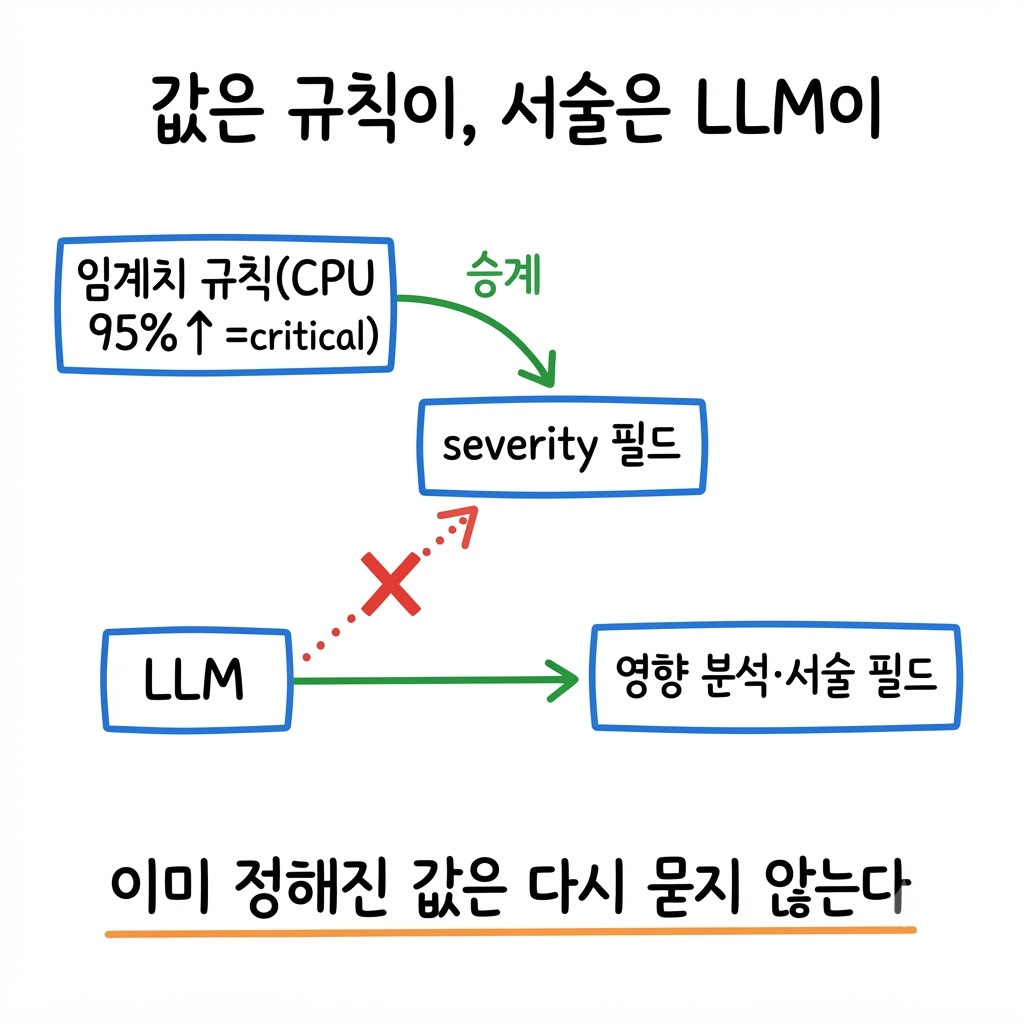
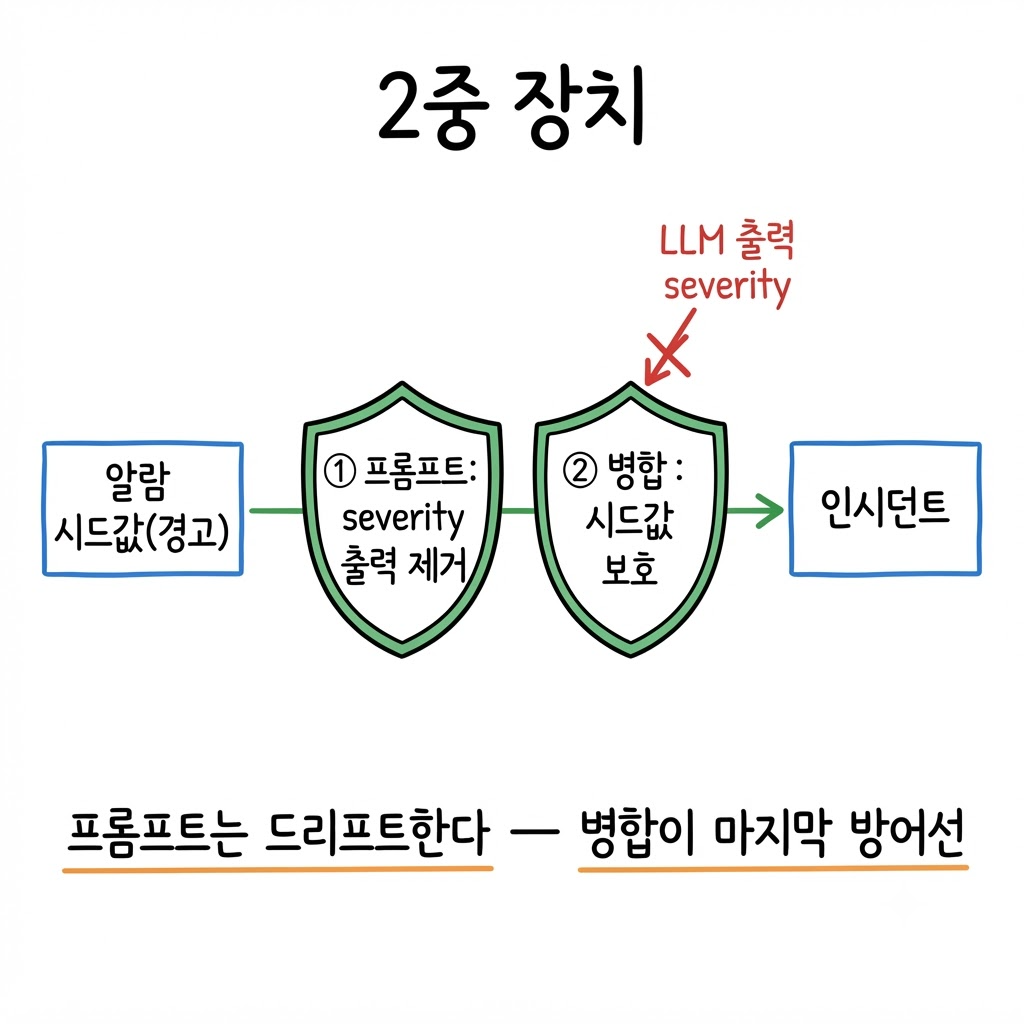
프롬프트 수정만으론 부족했다 — 2중 장치
적용은 두 겹으로 했습니다. 첫째, 프롬프트에서 severity 출력을 제거했습니다. 초안 출력 스키마에서 필드를 빼면 LLM이 그 값을 낼 통로 자체가 사라집니다.
둘째가 더 중요합니다. 초안을 기존 데이터와 합치는 병합 로직이 알람에서 넘어온 시드값을 보호하게 했습니다. LLM 출력에 severity가 섞여 들어와도 병합 단계에서 버려지고, 규칙 산정값이 유지됩니다.
프롬프트만 고치고 끝냈다면 반쪽짜리였을 겁니다. 프롬프트는 계속 수정되는 파일이라, 몇 달 뒤 누군가 스키마에 필드를 다시 넣는 순간 같은 사고가 재발합니다. 병합 로직의 보호는 프롬프트가 어떻게 드리프트해도 값이 안 덮이는 마지막 방어선입니다. 이미 어긋나 있던 케이스 2건도 규칙값 기준으로 교정했습니다.
같은 작업에서 나온 덤 — 조용한 실패 두 건
심각도 문제를 파는 김에 격상 파이프라인을 같이 훑었는데, 조용한 실패가 두 건 더 나왔습니다. 하나는 그래프 승격이 System 노드만 매칭해서, 자원 알람의 대상인 Host 노드는 매칭에 실패하고 있었습니다. 그 결과 인시던트의 영향 관계 그래프가 비어 있었는데, 어디에도 로그가 없어 아무도 몰랐습니다.
System과 Host를 둘 다 매칭하게 고치고, 매칭 실패 시 경고 로그를 남기게 했습니다. 다른 하나는 그래프 레코드의 키를 직접 접근하던 코드가 예외를 내면 승격 전체가 조용히 실패하던 것으로, 방어적 접근으로 교체했습니다. 부분 매칭과 무방비 키 접근은 빈 결과를 만들고, 빈 결과는 에러보다 늦게 발견됩니다.
LLM의 담당 범위를 좁게 긋는 설계는 분석 파이프라인에서도 같은 결론이 났습니다. 분석을 하나의 거대 프롬프트로 합치지 않고 Case별로 갈라, LLM에는 판단만 맡겼던 결정입니다.
체크리스트 — LLM 파이프라인에 결정적 값이 섞여 있다면
이 필드는 이미 다른 원천(규칙·코드·DB)이 권위 있게 정한 값인가 — 그렇다면 LLM 출력 스키마에서 뺀다
프롬프트에서 뺐더라도 병합·저장 단계가 시드값을 보호하는가 — 프롬프트 드리프트는 반드시 온다
같은 값이 두 화면에서 다르게 보일 수 있는 경로가 있는가 — 불일치 자체가 사고다
매칭·승격 실패가 조용히 빈 결과를 만들지 않는가 — 실패는 경고 로그로 소리 나게 한다
무엇을 다시 묻지 않을 것인가
LLM 도입 초기에는 '무엇을 시킬까'만 고민했습니다. 이번 건 이후로는 프롬프트의 출력 스키마를 열 때마다 반대 질문을 먼저 합니다. 이 중에 이미 답이 정해져 있는 필드는 무엇인가. LLM의 권한 경계는 무엇을 시킬까만큼, 무엇을 다시 묻지 않을까로 정해집니다.
물론 규칙이 없는 값이라면 LLM 판단이 유일한 선택일 수 있습니다. 이 원칙은 어디까지나 권위 있는 원천이 이미 있을 때의 이야기입니다. 그리고 그런 원천이 있는데도 LLM에게 같은 질문을 다시 하고 있다면, 지금 두 값이 어디선가 조용히 어긋나 있을 가능성이 큽니다.