사내 문서 AI(RAG)가 엉뚱한 답을 할 때, 먼저 볼 곳은 답이 아니라 찾는 단계입니다
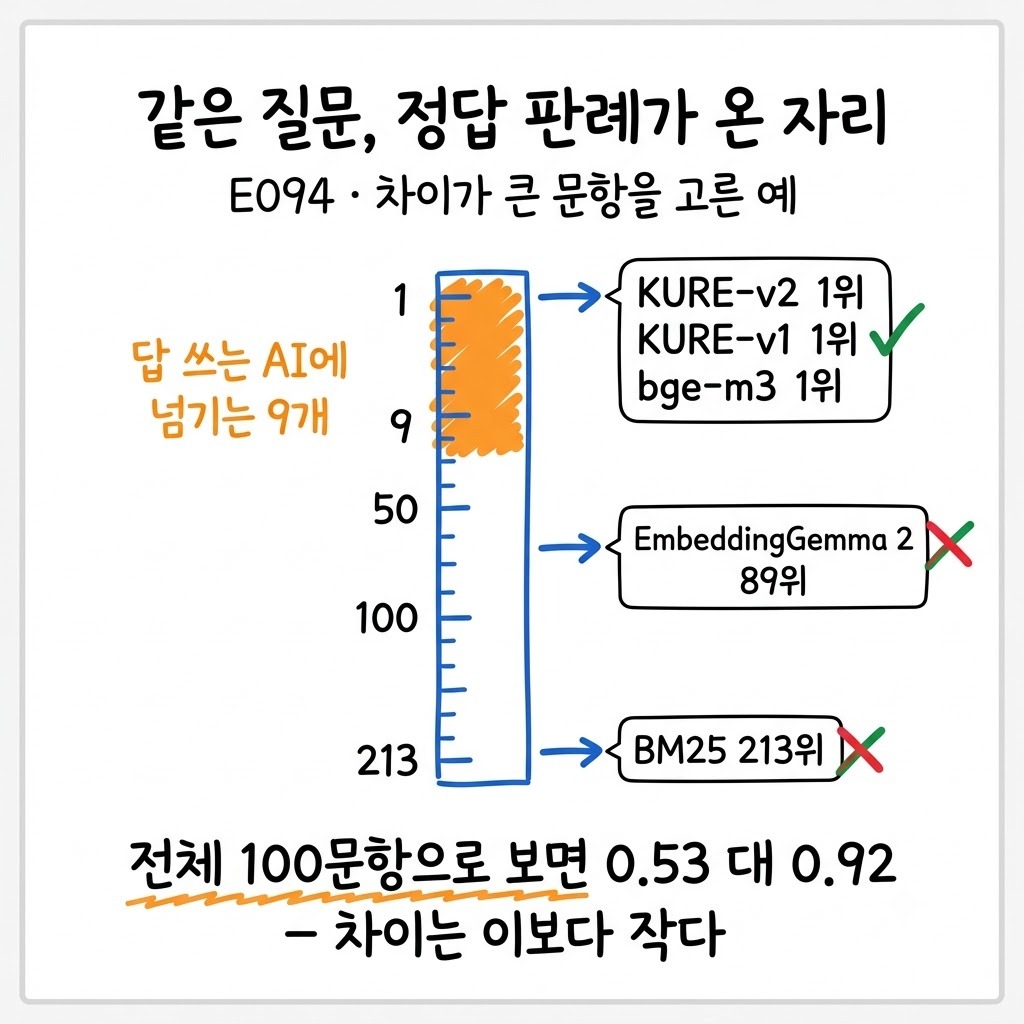
'회사 규정에 보너스는 퇴직금 계산에서 뺀다고 되어 있는데 이거 불법 아닌가요?' 노동법 조문·판례 5,714건 안에서 이 질문의 정답 판례를 찾게 했습니다. 문서도 질문도 그대로 두고 문서를 찾는 모델만 바꿨습니다. 어떤 모델은 정답 판례를 1위로 가져왔고, 다른 모델은 89위로 가져왔습니다.
사내 문서 AI가 엉뚱한 답을 하면 보통 답을 쓰는 AI부터 바꾸려 합니다. GPT로 갈지 클로드로 갈지를 따지는 식입니다. 이 글은 그 앞 단계, **질문에 맞는 문서를 찾아 오는 단계**를 먼저 보자는 이야기입니다. 덕랩이 고정 시험지로 검색 모델 다섯 개를 잰 결과를 근거로 씁니다.
사내 문서 AI는 두 단계로 움직입니다
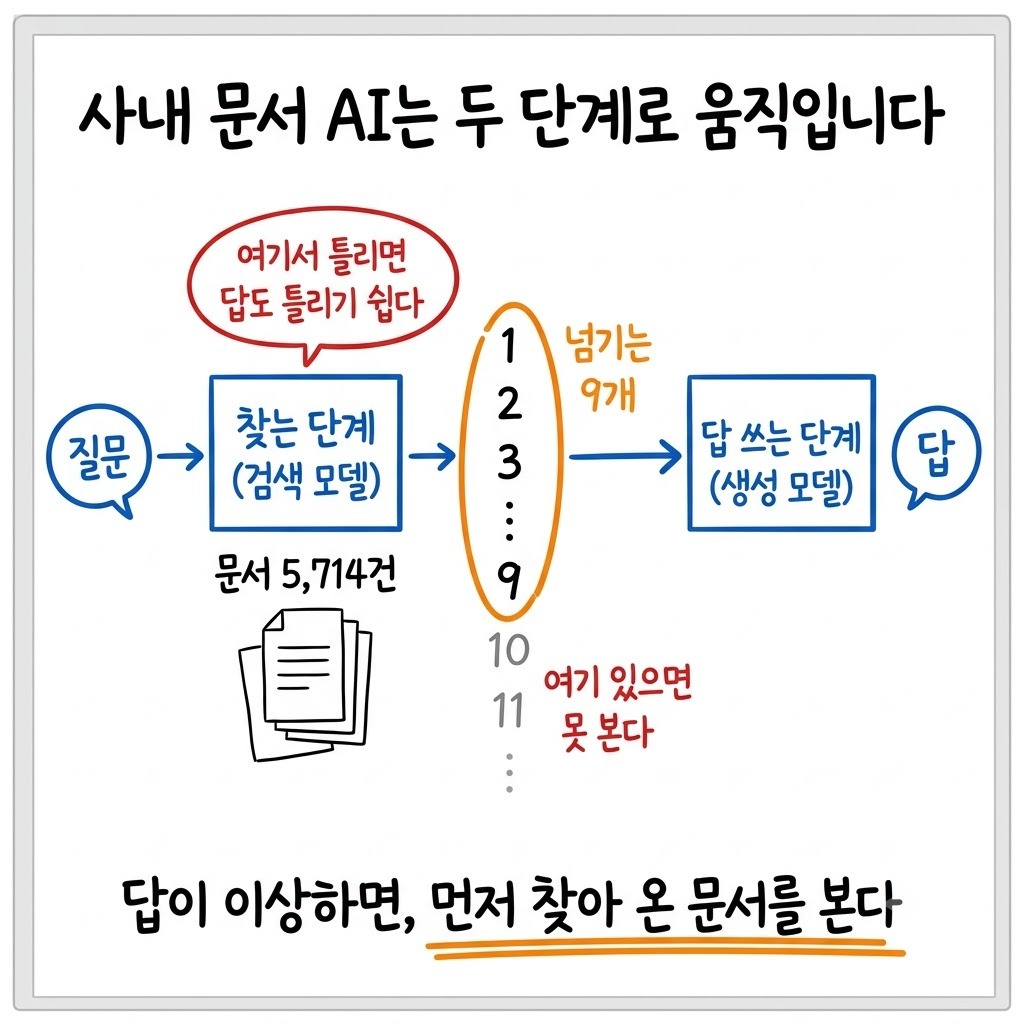
사내 문서 AI, 흔히 'RAG'(문서를 찾아 근거로 붙인 뒤 답을 쓰게 하는 방식)라고 부르는 구조는 두 단계입니다. 먼저 검색 모델이 문서 더미에서 질문과 가까운 문서를 순서대로 골라 옵니다. 다음으로 답을 쓰는 AI(생성 모델)가 그 문서를 읽고 답을 씁니다.
이 글에서 비교하는 검색 모델은 대부분 '임베딩' 모델입니다. 문장을 숫자 묶음으로 바꿔 뜻이 가까운 문서를 찾는 방식입니다. 비교 대상에는 낱말이 겹치는 정도로 찾는 전통 방식인 'BM25'(낱말 검색)도 하나 넣었습니다.
벡터 검색이 무엇을 기준으로 문서를 찾는지는 예전 글에서 비유로 풀어 둔 적이 있습니다.
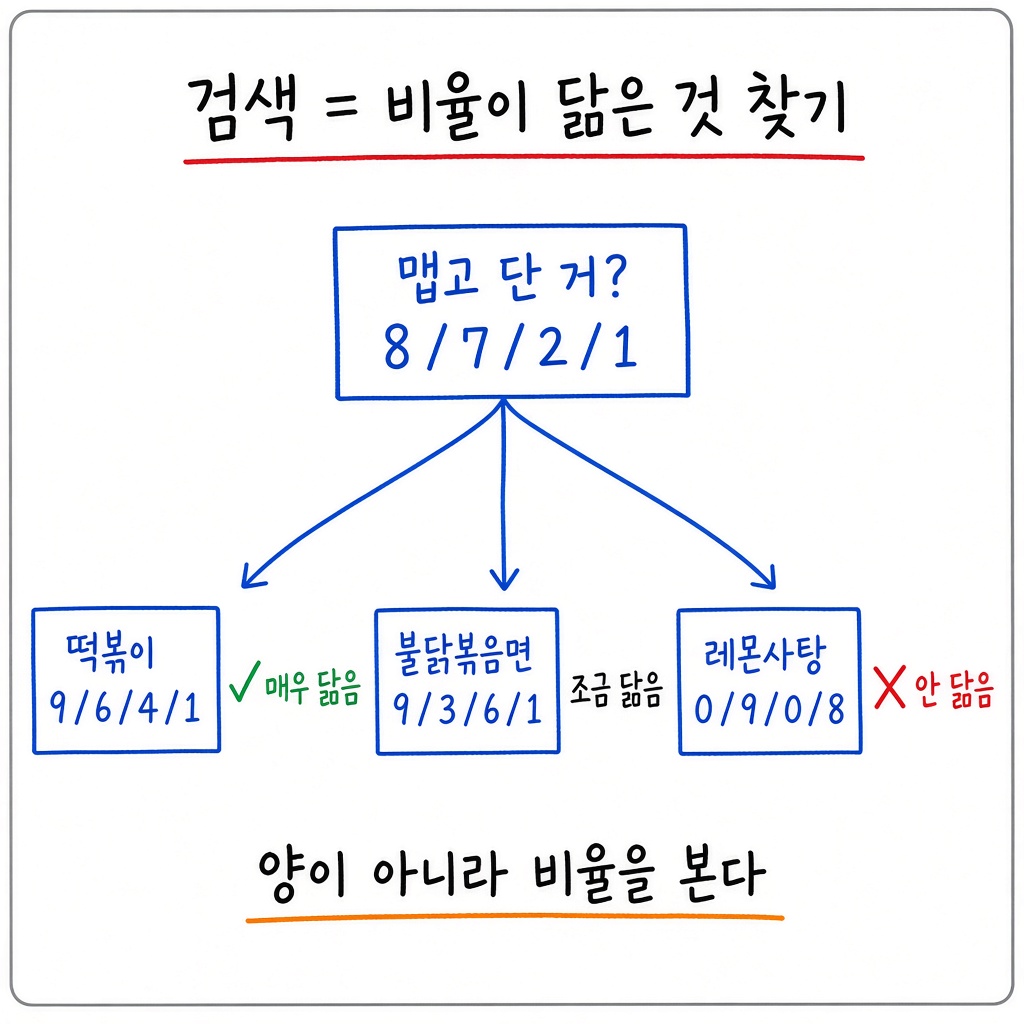
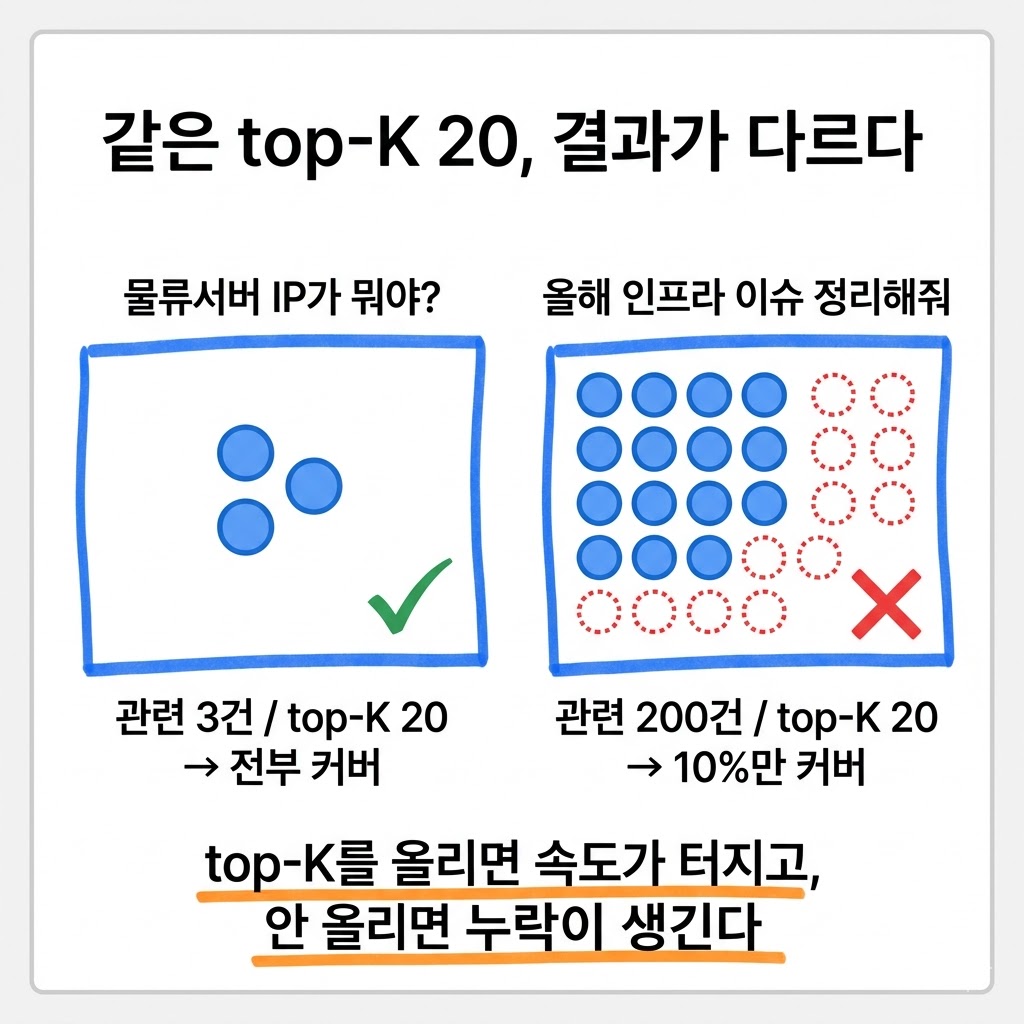
여기서 중요한 조건이 하나 있습니다. 답을 쓰는 AI에게는 찾은 문서를 전부 넘기지 않고 앞의 몇 개만 넘깁니다. 덕랩이 만들고 있는 노동법 상담 AI는 조문 6개와 판례 3개, 모두 9개를 넘깁니다. 정답 문서가 이 9개 밖에 있으면 답을 쓰는 AI는 그 문서를 보지 못합니다.
다만 넘기는 개수는 서비스마다 다릅니다. '재정렬 모델'(찾아 온 후보를 한 번 더 읽고 순서를 다시 매기는 모델)을 쓰는 곳은 상위 50~100개에서 다시 고르기도 합니다. 그래서 89위라고 해서 늘 못 보는 것은 아닙니다. 넘기는 개수 밖에 있을 때 못 봅니다.
같은 질문, 정답 문서는 몇 위로 왔나
덕랩은 검색 모델을 바꿀 때마다 시험을 새로 짰습니다. 그러다 보니 결과를 나란히 놓고 비교할 수 없었습니다. 그래서 시험지를 하나로 고정했습니다. 그중 법령검색 시험지는 노동 관련 조문과 판례 5,714건에 공개 문항 100개로 이루어져 있습니다.
아래 세 문항은 100문항 가운데 **모델 사이 차이가 큰 것을 골라 온 예**입니다. 대표 사례가 아니라는 점을 먼저 밝혀 둡니다.
E094 '회사 규정에 보너스는 퇴직금 계산에서 뺀다고 되어 있는데 이거 불법 아닌가요?' — 정답은 대법원 1987. 2. 10. 선고 85다카187 판결
E058 '하청 업체 직원이 우리 현장에서 안전수칙을 어기는데 원청이 직접 고치라고 지시해도 되나요?' — 정답은 산업안전보건법 제66조
E072 노조와 만든 합의서에 사장 도장이 빠졌는데 효력이 있느냐는 질문 — 문항 원문은 평가판 페이지에 그대로 있습니다
문항 | KURE-v2 | KURE-v1 | bge-m3 | EmbeddingGemma 2 | BM25 |
|---|---|---|---|---|---|
E094 | 1위 | 1위 | 1위 | 89위 | 213위 |
E058 | 1위 | 10위 | 16위 | 103위 | 1,125위 |
E072 | 1위 | 1위 | 1위 | 166위 | 38위 |
표를 보면 '1위 대 89위'는 KURE라서 생긴 일이 아닙니다. 한국어 전용이 아닌 다국어 모델 bge-m3도 E094와 E072의 정답을 1위로 찾았고, E058은 16위로 찾았습니다. 이 세 문항에서 갈린 것은 사실상 EmbeddingGemma 2와 나머지 모델 사이였습니다. 고른 예 대신 전체를 보면 차이는 이보다 작습니다. 공개 100문항에서 정답이 10위 안에 든 비율은 아래와 같습니다.
모델 | 정답이 10위 안에 든 비율 (공개 100문항) | 숨긴 50문항 |
|---|---|---|
BM25 (낱말 검색) | 0.47 | 0.42 |
EmbeddingGemma 2 | 0.53 | 0.58 |
bge-m3 | 0.74 | 0.78 |
KURE-v1 | 0.81 | 0.86 |
KURE-v2 | 0.92 | 0.94 |
KURE-v2는 100문항 중 92문항에서 정답을 10위 안에 가져왔고, EmbeddingGemma 2는 53문항이었습니다. 문항을 공개하지 않은 50문항에서도 다섯 모델의 순서는 같았습니다. KURE-v2 모델 카드에 발표된 한국어 검색 점수(MTEB, LawIRKo)도 KURE-v2, KURE-v1, bge-m3 순서로 우리 결과와 같습니다. EmbeddingGemma 2는 발표된 한국어 점수가 없어 대조하지 못했습니다.
이 숫자에서 읽을 것은 두 가지입니다. 같은 다국어 모델끼리도 차이가 큽니다(EmbeddingGemma 2 0.53, bge-m3 0.74). 큰 차이는 한국어 전용이 아닌 bge-m3 단계에서 이미 납니다. 한국어로 더 학습시킨 몫은 그보다 작지만 실제로 있습니다(bge-m3 0.74에서 KURE-v1 0.81).
답을 쓰는 AI는 받은 문서 안에서만 답을 씁니다. 엉뚱한 판례를 받으면 그 판례를 근거로 답을 쓰게 되고, 그래서 찾는 단계가 틀리면 답도 틀리기 쉽습니다. 넓은 질문에서 검색이 문서를 놓쳐 답이 빠졌던 사례도 같은 흐름이었습니다.
시험지는 이렇게 만들었습니다
질문은 법조문을 베끼지 않고 새로 썼습니다. 상담 말투, 사연, 검색어, 일상어를 섞었습니다. 질문과 정답 문서가 같은 낱말을 많이 쓰면(겹침 0.45 이상) 다시 써서 낱말 맞추기로는 풀 수 없게 했습니다. 예전에 낱말 검색이 이긴 시험에서는 질문이 정답 문서의 낱말을 그대로 쓰고 있었습니다. 그래서 위 BM25 숫자는 낱말이 잘 겹치지 않는 질문에서 잰 값으로 읽어야 합니다.
한 번 고정한 뒤에는 문항·정답·채점을 바꾸지 않습니다. 정답이 틀린 것이 나오면 정오표로만 고칩니다. 문항별 순위와 측정한 기계 조건은 아래 벤치 페이지에 공개해 두었으니 위 숫자를 직접 대조할 수 있습니다.
벤치 첫 페이지: https://deoklab.com/lab/ko-doc-retrieval
법령검색 평가판(문항별 순위·기계 조건): https://deoklab.com/lab/ko-doc-retrieval/법령검색-v1
이 숫자가 말하지 않는 것
**찾는 단계만 쟀습니다.** 정답 문서를 1위로 찾아도 답을 쓰는 AI가 결론을 틀릴 수 있습니다. 찾는 단계를 고친다고 답이 맞는다는 근거는 이 시험에 없습니다
**89위가 늘 안 보이는 것은 아닙니다.** 답을 쓰는 AI에 넘기는 개수 밖에 있을 때 못 봅니다
**예시 세 문항은 차이가 큰 것을 고른 것입니다.** 전체 비율로는 다섯 모델이 0.47에서 0.92 사이입니다
**법 분야 시험지입니다.** 다른 분야 문서에서도 순서가 같을지는 모릅니다
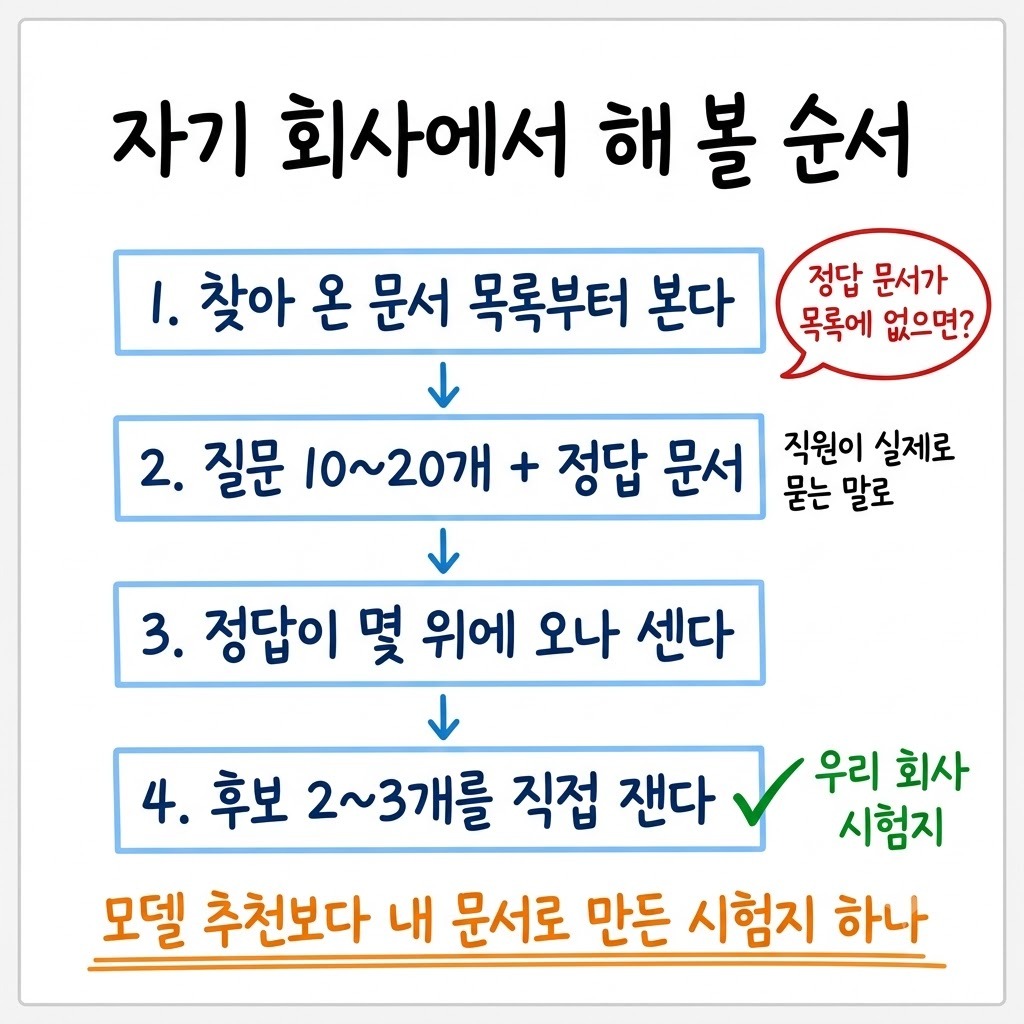
자기 회사에서 해 볼 순서
AI가 틀린 답을 했을 때, 답을 쓰기 전에 **찾아 온 문서 목록**을 봅니다. 대부분의 RAG 도구가 '출처'로 보여 줍니다. 정답이 될 문서가 그 목록에 없으면 답을 쓰는 AI를 바꿔도 나아지기 어렵습니다
회사 문서로 질문 10~20개를 만들고, 질문마다 정답 문서를 정해 둡니다. 질문은 문서에 쓰인 말 말고 직원이 실제로 묻는 말로 씁니다
검색 모델 두세 개로 '정답 문서가 몇 위에 오나'를 셉니다. 이것이 우리 회사 시험지입니다
후보를 두세 개 놓고 직접 재 봅니다. 같은 다국어 모델끼리도 0.53과 0.74로 갈렸습니다
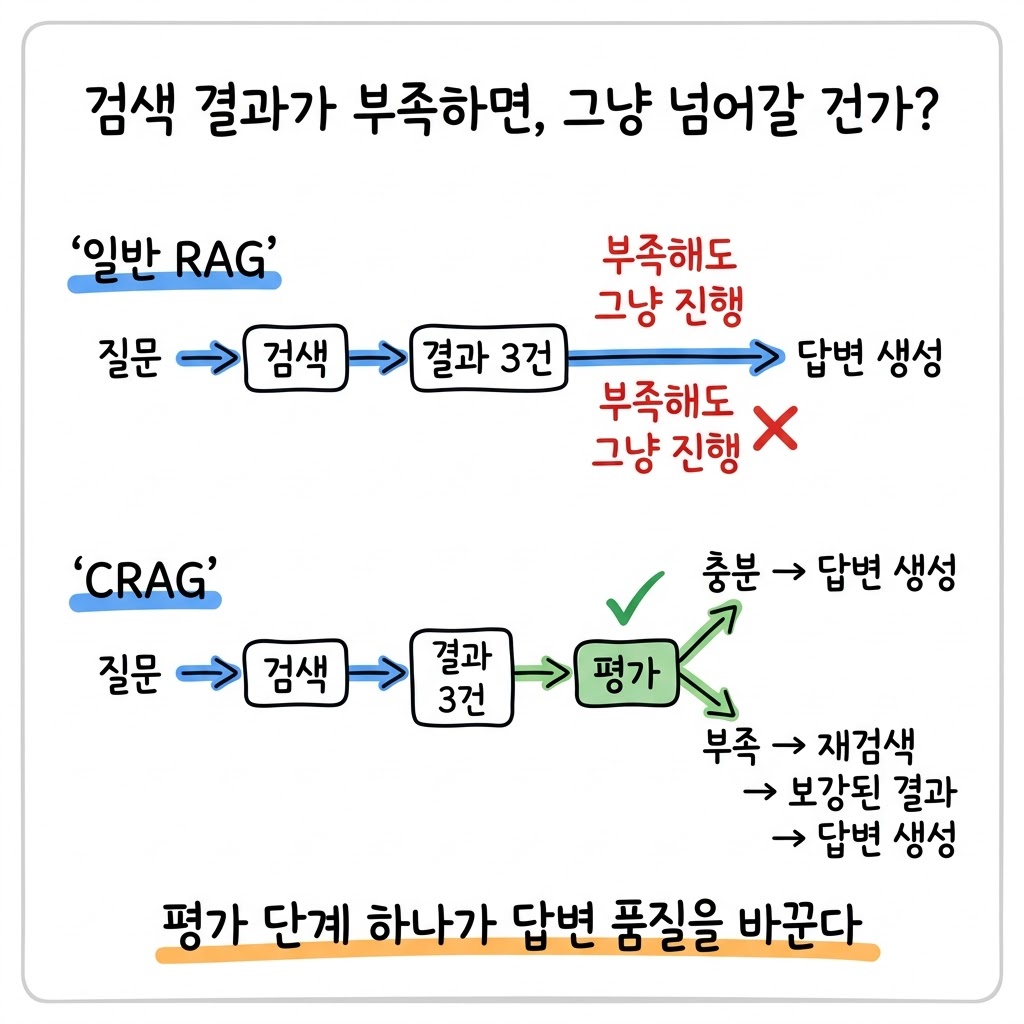
찾아 온 문서가 부족할 때 AI가 검색 품질을 스스로 판단하고 다시 찾게 한 방법은 따로 정리해 두었습니다.
모델 추천이 아니라 어디부터 볼지입니다
덕랩 시험에서 정확도는 KURE-v2가 가장 높았고, 운영 후보로는 질문 하나를 약 4배 빠르게 처리하는 KURE-v1(16ms 대 64ms)을 보고 있습니다. 다만 이 글이 권하는 것은 특정 모델이 아닙니다.
남이 낸 순위표는 남의 문서와 남의 말투로 잰 결과입니다. 사내 문서 AI의 답이 이상하면 답을 쓰는 AI를 바꾸기 전에 찾아 온 문서 목록부터 열어 봅니다. 정답 문서가 거기 없다면 고칠 곳은 찾는 단계입니다.