문서 파서가 낱말을 갈랐고, RAG 검색만 조용히 빗나갔습니다
사내 문서 지식그래프 검색 도구의 색인을 들여다보다가, 본문 한가운데에 'Monitorin' 과 'g' 가 따로 앉아 있는 청크를 봤습니다. 한글 문서의 표 칸이 좁아서 파서가 줄바꿈을 넣은 자리였습니다. 파서는 그 줄바꿈을 줄바꿈 태그로 그대로 옮겼고, 그 태그가 영문 한 단어의 한가운데를 갈라 놓았습니다.
수집도 성공, 파싱도 성공, 색인도 성공입니다. 에러 로그는 한 줄도 없습니다. 다만 검색만 빗나갑니다.
에러가 안 나는 결함이 가장 오래 삽니다
찾는 사람 입장에서는 아무 이상이 없습니다. 검색어를 넣으면 결과가 나오기는 나옵니다. 나와야 할 문서가 안 나올 뿐입니다. 사용자는 '요구사항 고유번호' 로 찾는데 본문에는 '요구사항' 과 '고유번호' 가 태그를 사이에 두고 두 조각으로 앉아 있습니다. 임베딩을 하든 키워드로 걸든 이 두 조각은 원래 낱말과 다른 것입니다.
낱말이 갈리는 원인은 한 가지가 아니었습니다.
표 칸이 좁아 줄바꿈된 자리 — 영문 한 단어가 'Monitorin' 과 'g' 로 갈림
밑줄 같은 서식 태그 — 괄호 안 낱말이 '(Reg' 와 'ulation)' 으로 갈림
표 머리의 필드명 — 한 칸 안에서 두 낱말로 쪼개져 들어가 있음
파서만의 문제도 아니었습니다. 이미지로 된 문서를 상용 멀티모달 모델로 전사한 결과에도 같은 줄바꿈 태그가 들어 있었습니다(10건). 한 계층에서 원인을 찾았다면 같은 모양의 출력을 내는 다른 입구를 전부 세어 봐야 합니다.
파이프라인 지표로는 이 결함이 안 보입니다. 성공률도 처리 건수도 정상입니다. 보이는 곳은 코퍼스 자체뿐입니다.
태그를 지운 자리를 붙일지 띄울지가 남았습니다
태그를 지운다는 것까지는 이견이 없었습니다. 문제는 지운 자리를 어떻게 이을지였습니다. 세 가지 안이 나왔습니다.
안 | 처리 | 맞는 경우 | 깨지는 경우 |
|---|---|---|---|
A | 빈 문자열로 지운다 | 'Monitorin' + 'g' → Monitoring | 'API' + 'Exchange' → APIExchange |
B | 공백으로 바꾼다 | 'API Exchange' | 'timestam p' 로 두 조각 잔존 |
C | 자리마다 코퍼스에 물어 정한다 | 근거가 있는 자리 | 근거가 갈리는 자리 |
세 번째 안이 가장 그럴듯해 보였습니다. 갈린 자리마다 '붙인 형태가 이 코퍼스의 다른 데 실제로 있나' 를 세서 자리별로 고르는 방식입니다. 갈린 자리 4,421곳을 그렇게 판정해 봤습니다. 띄워 쓴다 1,654곳(37%), 붙여 쓴다 377곳(9%), 그리고 둘 다 있다 1,113곳(25%)이 나왔습니다.
넷 중 하나꼴로 근거가 갈립니다. 자리별 자동 판정은 그 25%는 자동으로 판정할 근거가 부족합니다. 그래서 전역 규칙 하나로 가되, 그 하나를 코퍼스가 정하게 했습니다.
다수결이 아니라 손해의 비대칭으로 골랐습니다
규칙 하나를 고를 때 기준을 비율에 두지 않았습니다. 틀렸을 때 무엇을 잃는지가 양쪽이 달랐기 때문입니다.
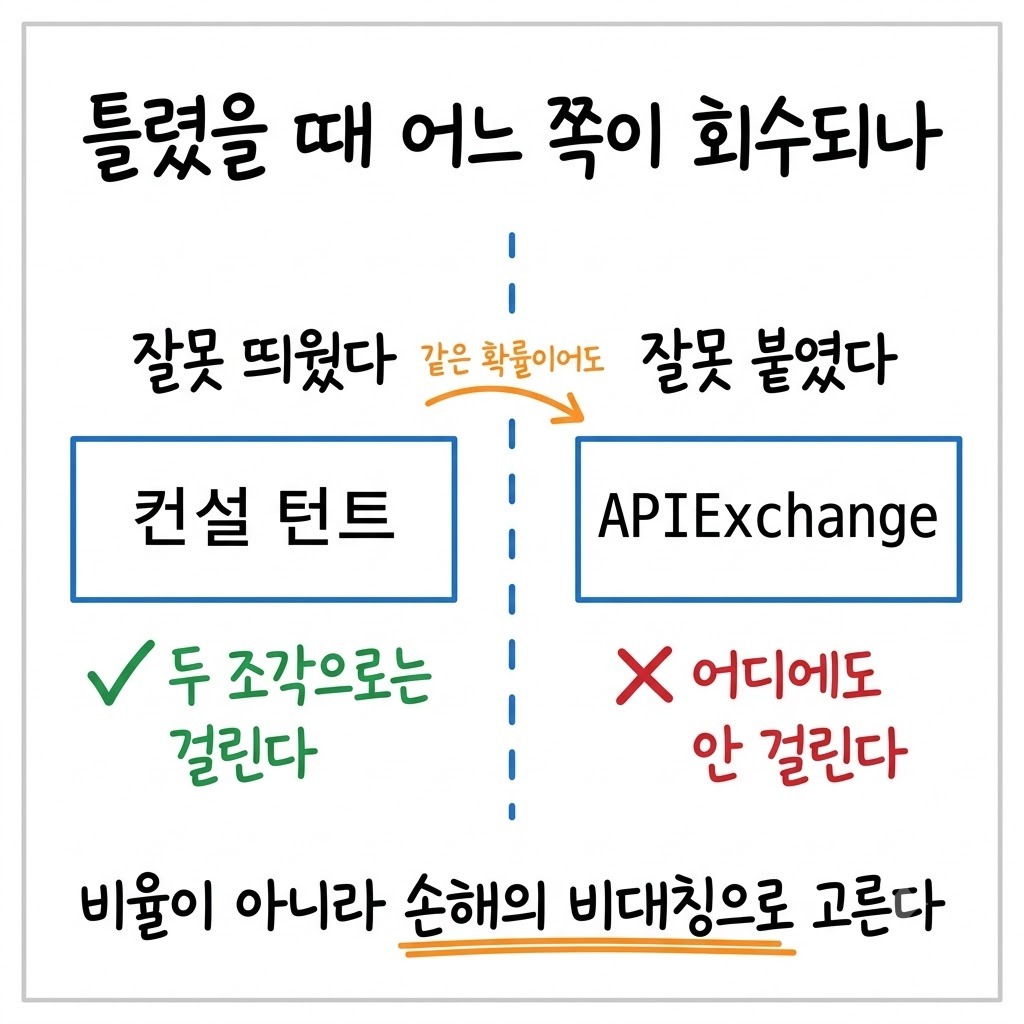
잘못 띄우면 '컨설 턴트' 가 됩니다. 보기에는 이상하지만 두 조각 각각은 실제로 쓰는 말이라 검색에 부분적으로 걸립니다. 잘못 붙이면 'APIExchange' 가 됩니다. 이건 세상에 없는 말이라 어느 질의로도 안 걸립니다. 검색으로 일부라도 찾을 수 있는 쪽과 전혀 찾을 수 없는 쪽이 있다면 비율이 비슷해도 전자가 이깁니다.
공백으로 갔습니다. '둘 다 있다' 로 나온 자리도 실제 출현 비율은 띄어쓰기 쪽이 높았고, 틀렸을 때 회수가 되는 쪽도 공백이었습니다.
첫 번째 측정은 자기 순환 구조였습니다
부끄러운 대목이 하나 있습니다. 코퍼스에 물어보려면 비교할 말뭉치가 있어야 하는데, 그 말뭉치를 '태그를 공백으로 바꾼 본문' 으로 만들었습니다. 갈린 자리 자신이 정답 쪽에 섞여 들어간 것입니다.
처음 나온 결과는 공백 70%, 붙이기 0% 였습니다. 숫자만 보면 결론이 명확합니다. 다만 그 결론은 제가 이미 넣어 둔 처리를 되읽은 것이었습니다. 비교 대상을 내가 고친 결과물로 만들면 답은 늘 내 편으로 나옵니다.
측정을 하기 전에 '이게 아니라면 무엇이 보일까' 를 한 번 물었어야 했습니다. 공백 70%가 나올 수밖에 없는 측정 도구를 사용했으니, 그 검사는 아무것도 확인하지 않은 셈입니다. 말뭉치를 손대지 않은 원본 쪽에서 다시 만들고 나서야 위의 37·9·25 라는 분포가 나왔습니다.
같은 증상인데 다른 프로젝트에서는 정반대 결과가 나왔습니다
이 도구와 자매 법인 쪽에서 새로 세우는 같은 계열 플랫폼이 같은 문서 파서와 같은 청킹 코드를 씁니다. 코퍼스가 훨씬 큰 쪽이 자기 색인에서 먼저 이 자리를 발견해 알려 왔고, 작은 쪽에서 같은 기준으로 다시 측정했습니다.
큰 쪽 | 작은 쪽 | |
|---|---|---|
규모 | 26,134청크 · 1,567문서 | 809청크 · 52문서 |
주력 형식 | 한글 문서 | |
가장 많이 갈린 낱말 | 붙여 쓴 형태가 88배 | 띄워 쓴 형태가 440배 |
같은 문서 계열, 같은 파서, 같은 증상인데 가장 많이 갈린 낱말의 판정이 정반대로 나왔습니다. 형식 분포가 반대였기 때문입니다. 규칙은 같이 쓸 수 있지만 문턱은 각자 코퍼스에 대 봐야 합니다.
받은 규칙 중 하나는 실제로 뺐습니다. '표 칸 경계에서 갈리면 칸이 붙는다' 는 규칙이었는데, 우리 코퍼스에서는 해당하는 자리가 0건이었습니다. 옆에서 잘 듣는 값을 그대로 받았으면 쓰지도 않을 분기를 하나 더 들고 다녔을 겁니다.
반대로 큰 쪽이 먼저 밟은 것도 있습니다. 서식 태그를 낱말 한가운데만 지우다가 짝이 안 맞는 태그가 남는 문제입니다. 결론은 '서식 태그는 어디에 있든 지운다' 였습니다. 우리 쪽은 처음부터 전역이라 안 밟았는데, 그건 판단이 아니라 운이었습니다. 자기 순환이었던 측정 실수도 그대로 알렸습니다. 그쪽이 같은 자를 쓸 참이었기 때문입니다.
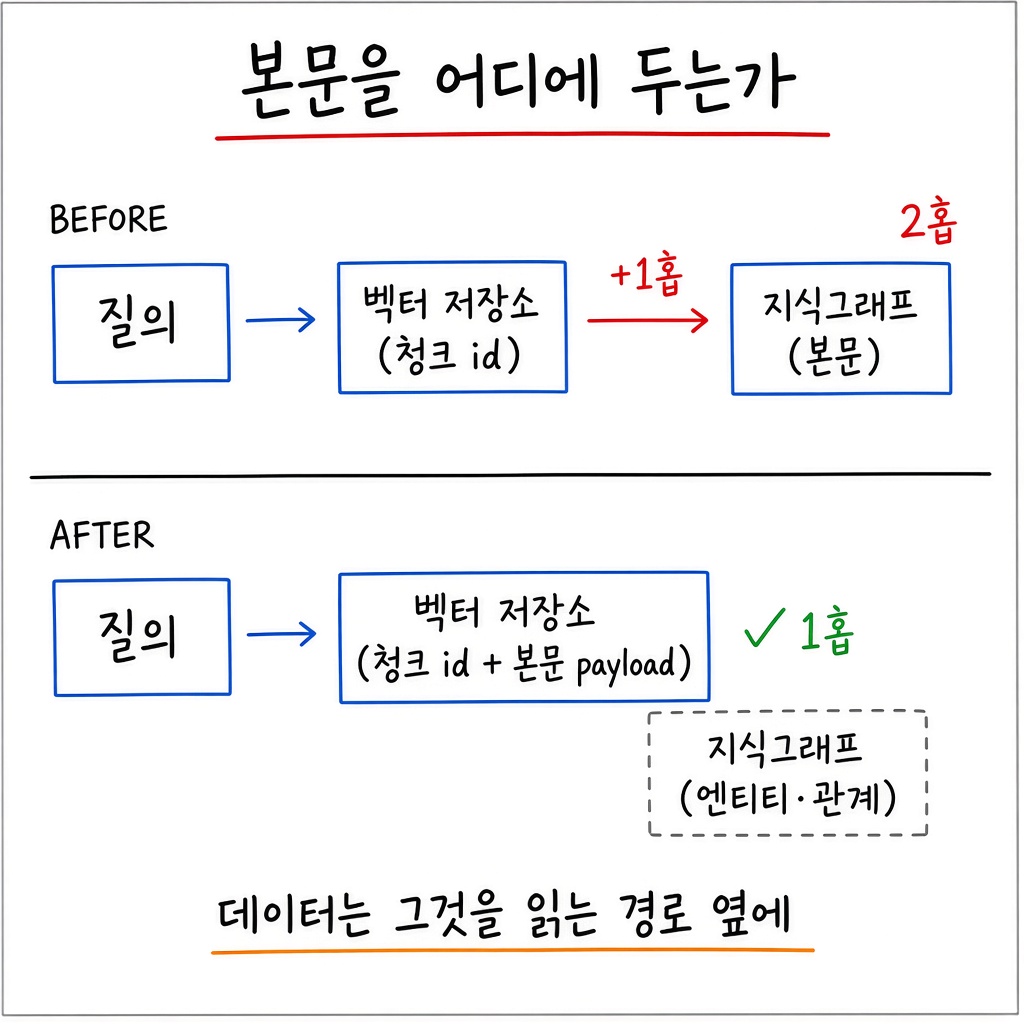
청크 안에 무엇이 담기느냐가 검색 결과를 가른다는 점은 다른 글에서 한 번 더 확인했습니다. 본문을 어디에 두느냐만 바꿨는데 검색 경로 자체가 짧아졌던 기록입니다.
고치는 자리를 비싼 단계 뒤에 뒀습니다
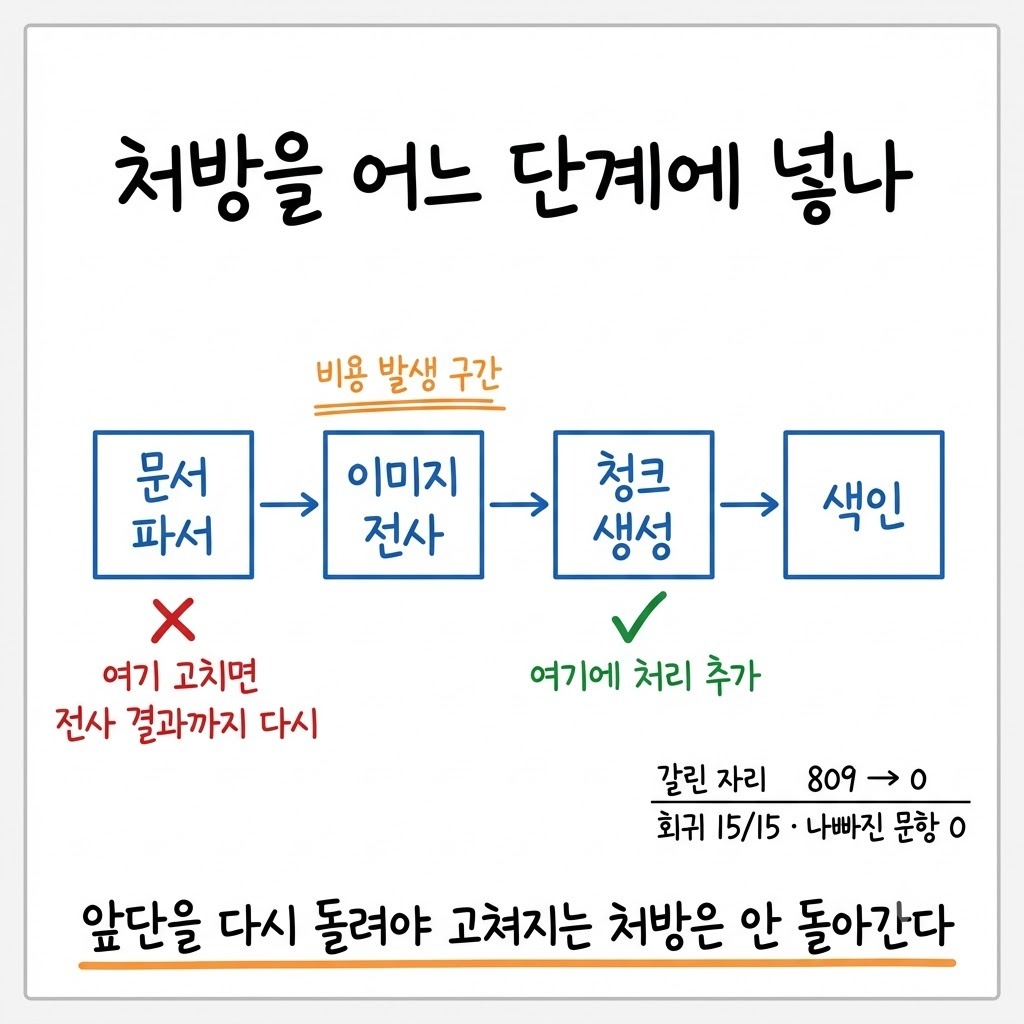
처방을 어디에 넣을지도 선택이었습니다. 파서 쪽을 고치는 것이 근본이지만, 그렇게 하면 전체를 다시 파싱해야 합니다. 재파싱하면 돈을 주고 얻은 이미지 전사 결과가 같이 지워집니다. 큰 쪽은 재전사 비용이 더 크므로 같은 방식의 스크립트를 넘기기로 했습니다.
그래서 파서를 다시 안 돌리고 색인 본문만 고쳤습니다. 이어붙이는 처리는 청크를 만드는 자리에 뒀습니다. 반복 가드와 빈 행 제거, 줄바꿈 정규화가 이미 서 있는 자리입니다. 앞단을 다시 돌려야만 고쳐지는 처방은 앞단이 비쌀수록 안 돌아갑니다.
결과는 이렇습니다. 갈린 자리 809청크에서 0으로, 회귀 검사 15문항 중 15개 유지, 나빠진 문항 0, 근거 파일이 바뀐 문항 6개입니다. 마지막 항목이 이 작업의 실제 성과입니다. 같은 질문에 같은 답이 나오면서 근거로 집힌 문서가 여섯 군데에서 달라졌습니다.
두 프로젝트의 검사가 같이 놓치는 자리도 찾았습니다. 양쪽 다 태그 앞뒤가 글자나 숫자일 때만 갈린 것으로 잡는 검사였습니다. 문장부호 뒤에서 갈린 자리는 안 걸립니다. 30건에 46개가 그렇게 남아 있었습니다. 검사를 두 벌 가지고 있어도 같은 가정 위에 서 있으면 같은 곳을 놓칩니다.
같은 자리를 의심할 때 볼 것
검색이 이상한데 로그가 깨끗하다면, 아래 순서로 봅니다.
파이프라인 지표 말고 코퍼스 자체를 재는 지표가 있는지 — 성공률과 처리 건수로는 이 결함이 안 보입니다
비교 말뭉치를 내가 고친 결과물로 만들지 않았는지 — 측정 전에 '이게 아니라면 무엇이 보일까' 를 한 번 묻습니다
같은 모양의 출력을 내는 다른 입구가 있는지 — 파서를 잡았으면 전사·크롤링·업로드 경로를 전부 셉니다
옆 프로젝트에서 받은 문턱을 그대로 넣지 않았는지 — 규칙은 같이 쓰고 값은 각자 코퍼스에 대 봅니다
검사 두 벌이 같은 가정 위에 있지 않은지 — 글자와 숫자만 보는 검사는 문장부호 뒤를 같이 놓칩니다
한계도 적어 둡니다. 이 방법은 코퍼스가 작으면 안 섭니다. '붙인 형태가 다른 데 있나' 를 세려면 같은 낱말이 여러 번 나와야 하는데, 문서 수십 건 규모에서는 판정 근거가 안 모입니다. 공백이 기본이라는 결론도 한국어와 영어가 섞인 코퍼스의 결론이지 보편 규칙이 아닙니다. 그리고 색인 본문만 고친 것은 반쪽이라, 파서 쪽 처방을 따로 넣기 전까지는 한 번 쓴 스크립트를 계속 들고 다녀야 합니다.
검색 품질을 파고들 때 고생이 검색 쪽이 아니라 수집·파싱 쪽에서 나온다는 것은 이번이 처음이 아니었습니다. 한글 문서를 다루는 RAG 라면 같은 지점을 먼저 확인하는 편이 빠릅니다.
검색이 정확히 이 이유로 빗나갔는지는 바뀐 문항 수로만 확인했습니다. 고치기 전후로 사용자 질의를 직접 비교한 것은 아닙니다. 그래도 에러가 안 나는 결함을 하나 세어서 0으로 만든 기록은 남았습니다. 이런 결함은 누가 세기 전까지 계속 살아 있습니다.