파일 변환이 엑셀 수식을 다시 계산했고, 파서는 끝까지 성공이라고 답했습니다
사내 문서를 검색 가능한 상태로 쌓는 일을 하고 있었습니다. 들어오는 포맷이 여러 가지라, 옛 엑셀 형식처럼 직접 읽기에 적합한 라이브러리가 없는 형식은 사무용 오픈소스 소프트웨어로 최신 형식이나 PDF 로 바꾼 뒤 읽었습니다. 변환 경로는 포맷이 늘어도 코드가 안 늘어서 편합니다.
이 경로의 품질은 그동안 '표가 얼마나 살아남았나'로 쟀습니다. 변환을 거치면 표가 좌표 순서대로 흩어져 나와서, 표 줄 수가 0에 가까워지는 문서가 있었기 때문입니다. 그래서 그 포맷은 오래 '표 복원 품질이 다소 낮은 형식'으로 분류돼 있었습니다.
그런데 나쁜 것은 표가 아니었습니다. 값이었습니다.
읽기가 나쁜 것과 사실이 어긋난 것은 등급이 다릅니다
우연히 같은 파일을 옛 형식 전용 라이브러리로도 읽어 두 결과를 나란히 놓고 봤습니다. 표의 모양만 다를 줄 알았습니다. 달랐던 것은 날짜 칸과 금액 칸의 **값 자체**였습니다.
원인은 변환기였습니다. 옛 엑셀을 최신 형식으로 바꿀 때 **문서 안의 수식이 다시 계산됩니다.** 오늘 날짜를 돌려주는 함수가 원래 작성일이 아니라 변환을 실행한 날로 밀렸고, 그 칸을 참조하던 금액 수식은 참조가 깨져 오류 값이 됐습니다. 같은 파일을 전용 라이브러리로 직접 읽으면 작성일도 금액도 원래 값 그대로였습니다.
제가 보고 있던 표 줄 수라는 지표는 이걸 잡을 수 없습니다. 그 지표가 보여 주는 것은 표를 얼마나 복원했는지뿐입니다. 표를 잘 살려내는 변환기로 바꿔도 날짜는 여전히 밀려 있었을 겁니다. 두 가지는 등급이 다른 문제입니다.
구분 | 표가 납작해진다 | 값이 틀린다 |
|---|---|---|
성질 | 읽기 품질 | 사실 정합성 |
증상 | 검색이 덜 걸린다 | 답이 그럴듯하게 틀린다 |
보이나 | 표 줄 수 지표로 보인다 | 어떤 지표로도 안 보인다 |
고치는 곳 | 파서·변환기 품질 | 읽는 경로 자체 |
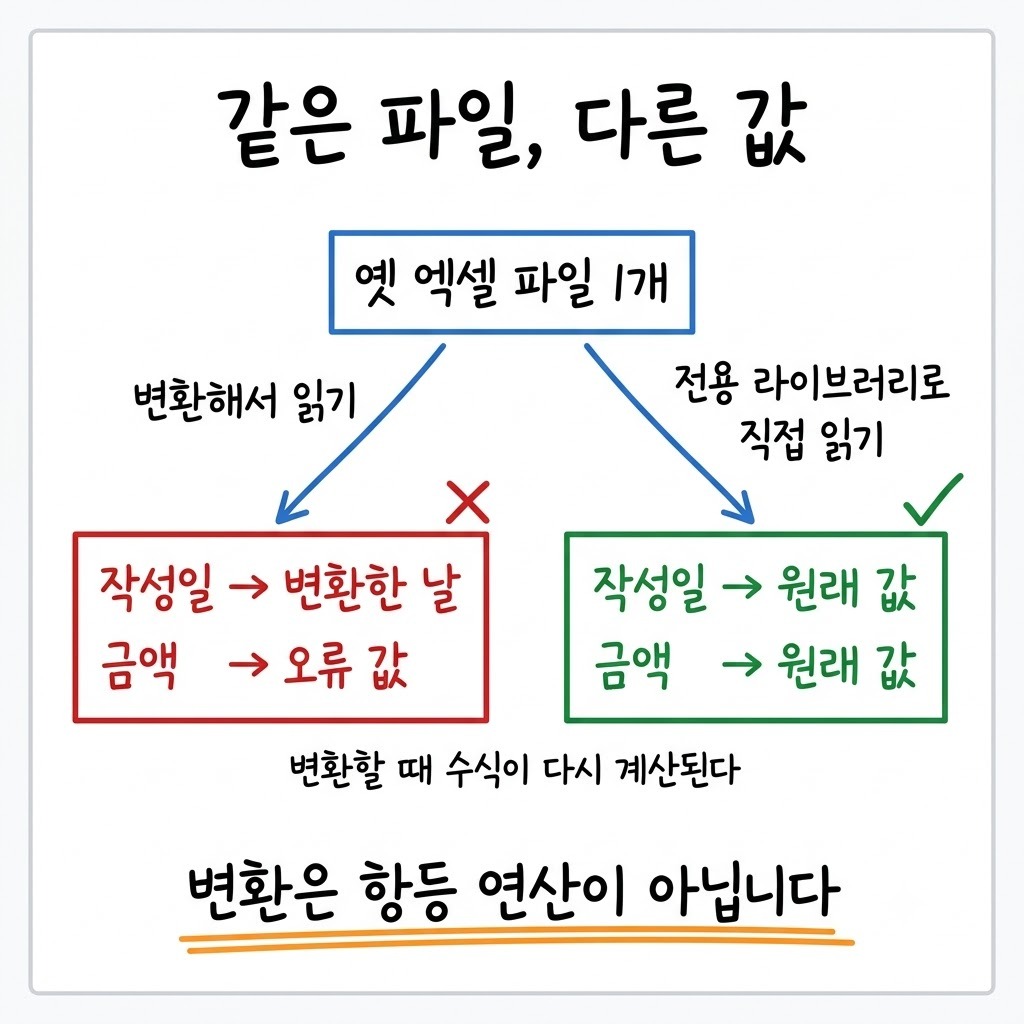
성공 신호만 정상이라면 값의 정합성은 검사하지 않은 것입니다
가장 곤란했던 점은 값이 바뀌어도 성공으로 처리된다는 사실입니다. 변환 경로에서도 **파싱은 끝까지 성공으로 끝났습니다.** 반환 코드도 정상, 쪽수도 정상, 글자 수도 정상이었습니다. 로그만 보면 잘 읽힌 문서와 구별할 방법이 없었습니다.
조용한 실패는 성공과 겉모습이 같습니다. 그래서 검사를 고를 때 먼저 물어야 하는 것은 '이게 틀렸다면 무엇이 달라 보일까' 입니다. 반환 코드는 값이 틀려도 달라지지 않습니다. 글자 수도 달라지지 않습니다. 결함이 있어도 달라지지 않는 신호만 여러 개 확인해서는 해당 결함을 검증할 수 없습니다.
파이프라인이 에러 없이 끝났다는 사실 자체가 안심의 근거가 못 되는 경우를 전에도 한 번 만났습니다.
성공 신호만 보고 있다가 놓친 다른 사례도 같은 자리에서 걸렸습니다.
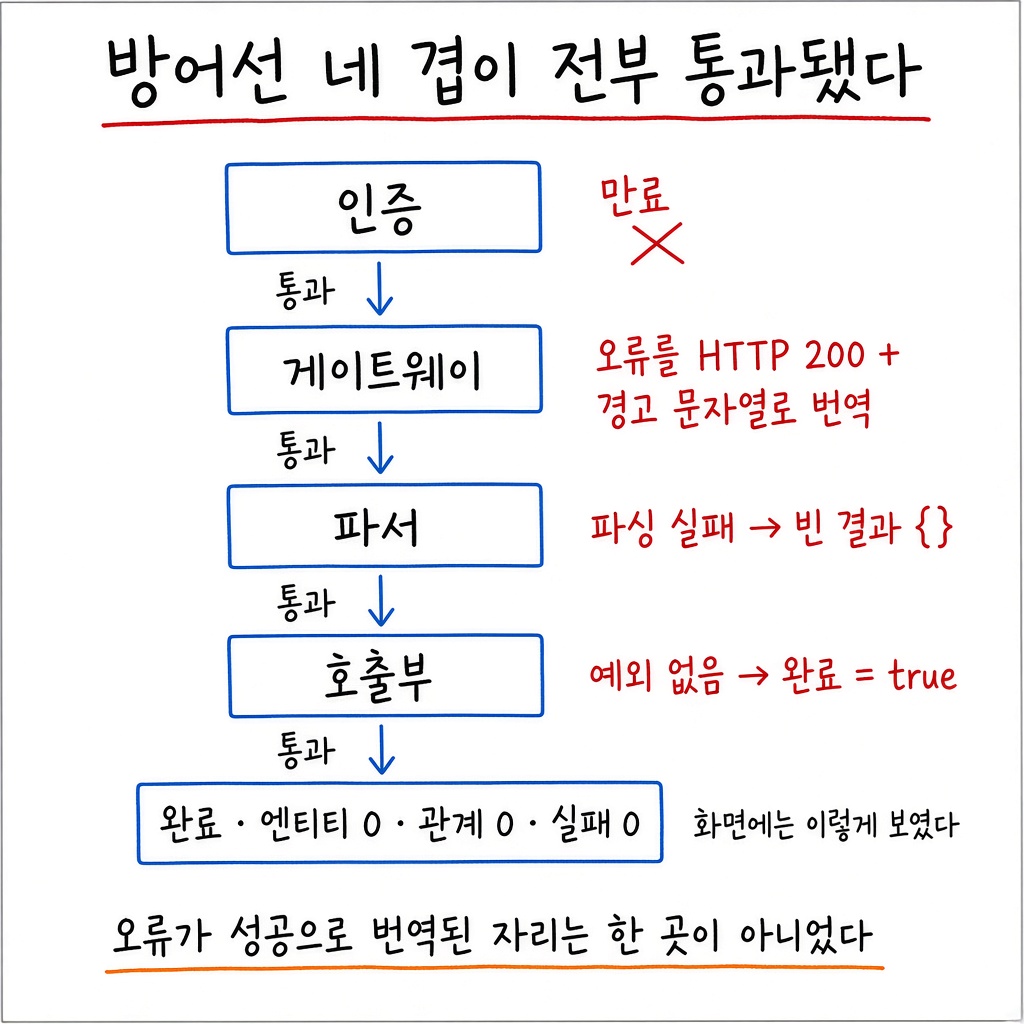
정답 기준은 문서 바깥에서 찾습니다
두 결과가 다르다는 것까지는 알았는데, 기존 지표만으로는 어느 쪽이 맞는지 판단할 수 없었습니다. 둘 다 그럴듯한 날짜와 그럴듯한 숫자였습니다.
그래서 문서 바깥에서 정답을 찾았습니다. 그 양식은 문서번호에 작성 연월이 박혀 있었습니다. 문서번호의 연월과 본문에 찍힌 날짜를 대 보니 반년 넘게 어긋나 있었습니다. 변환본은 어긋났고, 직접 읽은 쪽은 맞았습니다. 대조하는 데 걸린 시간은 1분입니다.
이 방식이 값싼 이유는 **본문과 독립적으로 같은 사실을 가리키는 값**을 쓰기 때문입니다. 문서번호·파일명·발신일이 그런 자리입니다. 본문 안에서만 검사를 만들면 변환기가 본문을 통째로 바꿨을 때 같이 틀립니다.
문서번호에 든 연월 — 본문 날짜와 대 본다
파일명에 든 날짜·차수 — 본문 제목·작성일과 대 본다
메일 발신일·시스템 등록일 — 문서가 주장하는 날짜와 대 본다
합계 칸 — 항목 칸의 합과 대 본다
다만 이 대조가 만능은 아닙니다. 문서번호에 날짜가 든 양식이라서 성립했습니다. 그런 값이 없는 문서에서는 '정답을 이미 아는 칸'을 포맷별로 미리 하나 골라 둬야 합니다.
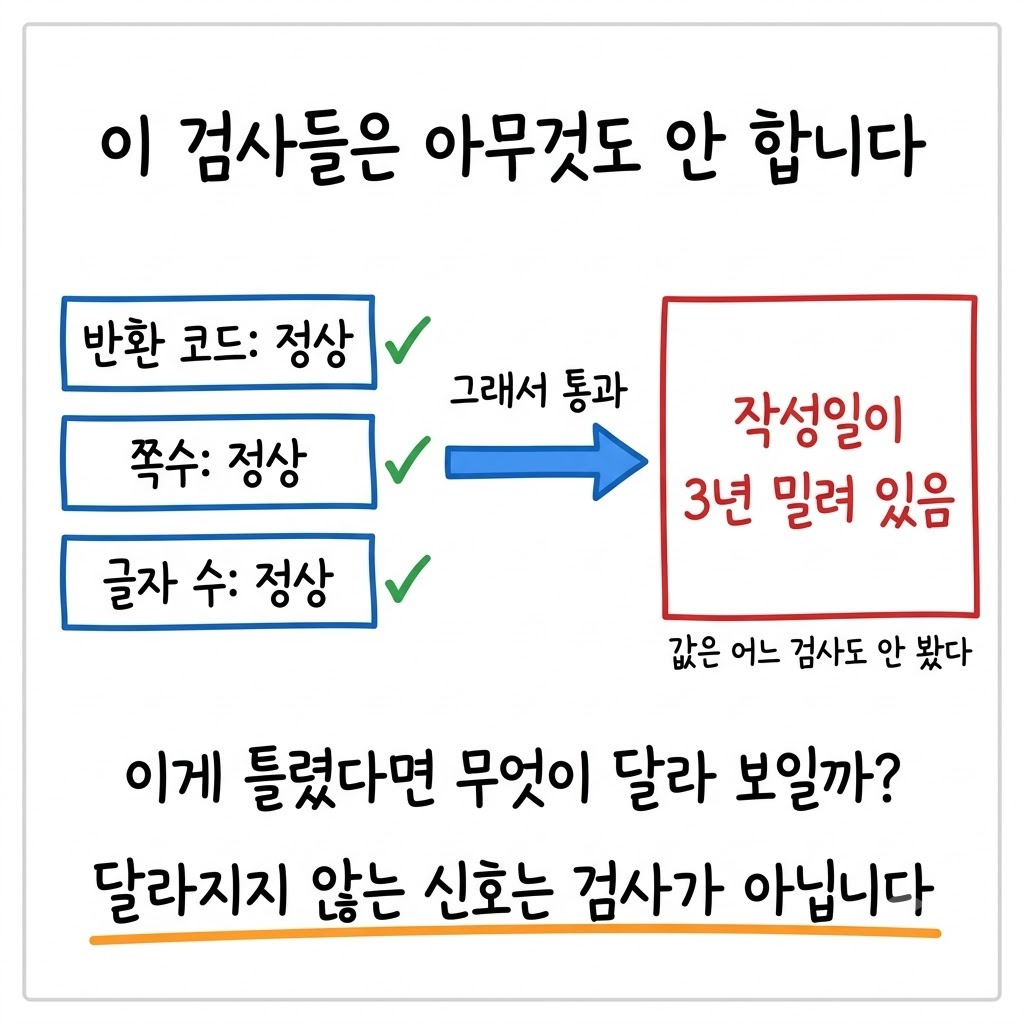
읽기 라이브러리는 나눴지만 확장자로 판별하지 않았습니다
결정은 단순합니다. **직접 읽는 라이브러리가 있으면 그걸 쓰고, 없을 때만 변환을 거칩니다.** 변환은 기본 경로에서 마지막 수단으로 내렸습니다.
구현에서 한 가지를 조심했습니다. 포맷을 확장자로 가르지 않았습니다. 적재 경로에서 파일은 임시 파일로 떨어지는데 거기엔 확장자가 없습니다. 대신 **파일 앞머리 몇 바이트**를 읽어 옛 형식과 압축 기반 최신 형식을 갈랐습니다. 파일이 스스로 밝히는 값으로 판단하는 편이, 경로 어디에서 오든 같은 답을 냅니다.
그리고 갈라지는 것은 첫 단계 리더 하나뿐입니다. 그 뒤에 이어지는 함수 인터페이스와 결과 형식은 하나로 뒀습니다. 그전에는 같은 엑셀이 형식에 따라 두 가지 모양으로 색인되고 있었습니다. 뒷단이 갈리면 검색 품질을 잴 때 포맷마다 다른 해석을 해야 합니다.
바꾼 뒤 그 포맷의 표 줄 수는 0에서 243으로 올라갔고, 오류 값은 0이 됐습니다. 읽기 품질과 값 정합성이 같이 올라간 셈인데, 애초에 잡으려던 것은 뒤쪽이었습니다.
한 가지는 그대로 남겼습니다. 화면에서 여는 미리보기 PDF 는 여전히 변환 도구가 만듭니다. **글자를 읽는 경로를 바꾼 것이지 변환을 없앤 것이 아닙니다.** 사람이 눈으로 보는 미리보기는 수식이 다시 계산돼도 검색 색인에 들어가지 않습니다.
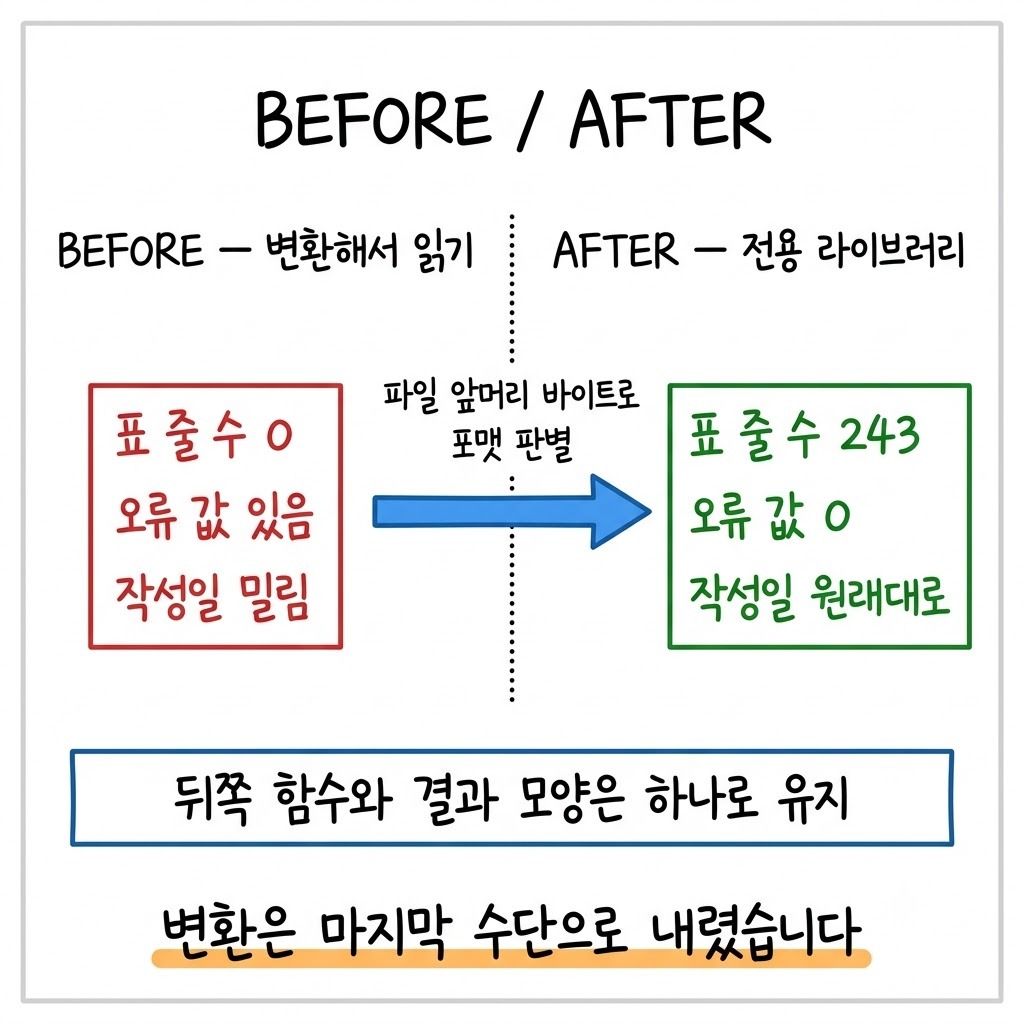
수정을 마치기 전에 관련 프로젝트에 먼저 알렸습니다
우리 쪽 코드를 다 고치고 알리는 대신, 발견한 날 바로 옆 프로젝트에 알렸습니다. 같은 계열의 적재 경로를 쓰고 있었기 때문입니다.
해당 프로젝트는 자체 문서 전체를 대조했습니다. **2023년에 작성된 문서가 2026년 것으로 색인돼 있었습니다.** 오류 값 32개, 값이 바뀐 문서 20건이 나왔습니다. 우리 쪽에서 발견한 것은 문서 몇 건이었는데 그쪽 더미에서는 수십 건이었습니다. 검색 결과에 최신순 정렬이 걸려 있었다면 3년 전 문서가 맨 위에 서 있었을 겁니다.
반대 방향도 있었습니다. 그쪽이 쓰던 기본 설정을 그대로 가져왔으면 다른 포맷에서 표 보존을 크게 놓칠 뻔했습니다. 그래서 같이 남은 규칙이 하나 더 있습니다. **문제 유형은 공유하되 설정값은 각 데이터에 맞게 정합니다.** 알리는 것은 함정이고, 설정은 각자의 문서 더미에 맞춰 잽니다.
문서를 넣는 단계가 검색보다 더 자주 발목을 잡는다는 이야기는 전에도 한 번 정리한 적이 있습니다.
변환을 거치는 경로에 붙이는 점검 항목
의사결정 자리에서 쓸 수 있게 정리하면 이렇습니다. 도입 검토든 운영 점검이든 순서는 같습니다.
적재 경로에 형식 변환이 들어 있는지부터 센다 — 변환기는 대개 편의를 위해 조용히 들어와 있다
변환을 거치는 포맷에 '읽는 시점에 계산되는 칸'이 있는지 본다 — 수식·상대 참조·오늘 날짜·상대 경로
그 포맷마다 '정답을 이미 아는 칸'을 하나씩 정해 둔다 — 문서번호·파일명·발신일
같은 파일을 두 경로로 읽어 값이 같은지 한 번 대 본다 — 포맷당 표본 몇 건이면 충분하다
품질 지표에 읽기 품질 말고 값 정합성 항목을 하나 추가한다 — 표 줄 수만 보면 값은 영영 안 보인다
처리량이 아주 큰 경로에서는 문서마다 대조를 돌리는 비용이 붙습니다. 그럴 때는 전수 대신 포맷별 표본으로 시작하는 선택이 있습니다. 중요한 것은 검사를 붙이는 것이지 전수인지 표본인지가 아닙니다.
마무리
이 글의 규칙은 '변환을 쓰지 마라'가 아닙니다. 직접 읽는 라이브러리가 없는 포맷도 있고, 그때는 변환이 유일한 길입니다. 규칙은 **변환을 쓰면 값 검사를 같이 붙인다** 쪽입니다.
그리고 값만 들어 있고 계산식이 없는 문서는 변환해도 같은 값이 나옵니다. 위험한 것은 읽는 시점에 계산되는 칸을 가진 문서입니다. 같은 성질이 문서 바깥에도 있습니다. 타임존이 붙은 시각, 통화가 붙은 금액, 상대 경로가 전부 옮기는 도구를 지날 때 값이 바뀔 수 있는 자리입니다.
마지막으로, 이번에 잡힌 것은 오류 값 덕분입니다. 오류 값은 눈에 띕니다. 정말 위험한 것은 날짜처럼 **그럴듯한 값으로 조용히 바뀌는 칸**이고, 그건 사람이 한 번 대 보기 전까지 아무도 모릅니다. 대 보는 데 1분이면 됩니다.