코드 리뷰 에이전트가 3가지를 고치라고 했는데, 1가지만 고쳤습니다
코드 리뷰 에이전트를 붙여두면 편합니다. 사람이 놓친 패턴을 잡아주고, 일반적으로 권장되는 모범 사례를 친절하게 짚어줍니다. 문제는 그 권고가 "일반적으로 맞는 말"일 뿐, 내 코드베이스의 컨텍스트까지 검증한 결과는 아니라는 점입니다.
그래프 DB 기반의 프로젝트 관리 도구를 운영하던 중, 코드 리뷰 에이전트가 세 가지를 한꺼번에 지적했습니다. 결론부터 말하면 셋 중 하나만 채택했고, 나머지 둘은 거부 사유까지 기록해 남겼습니다. 그 판단 과정을 정리합니다.
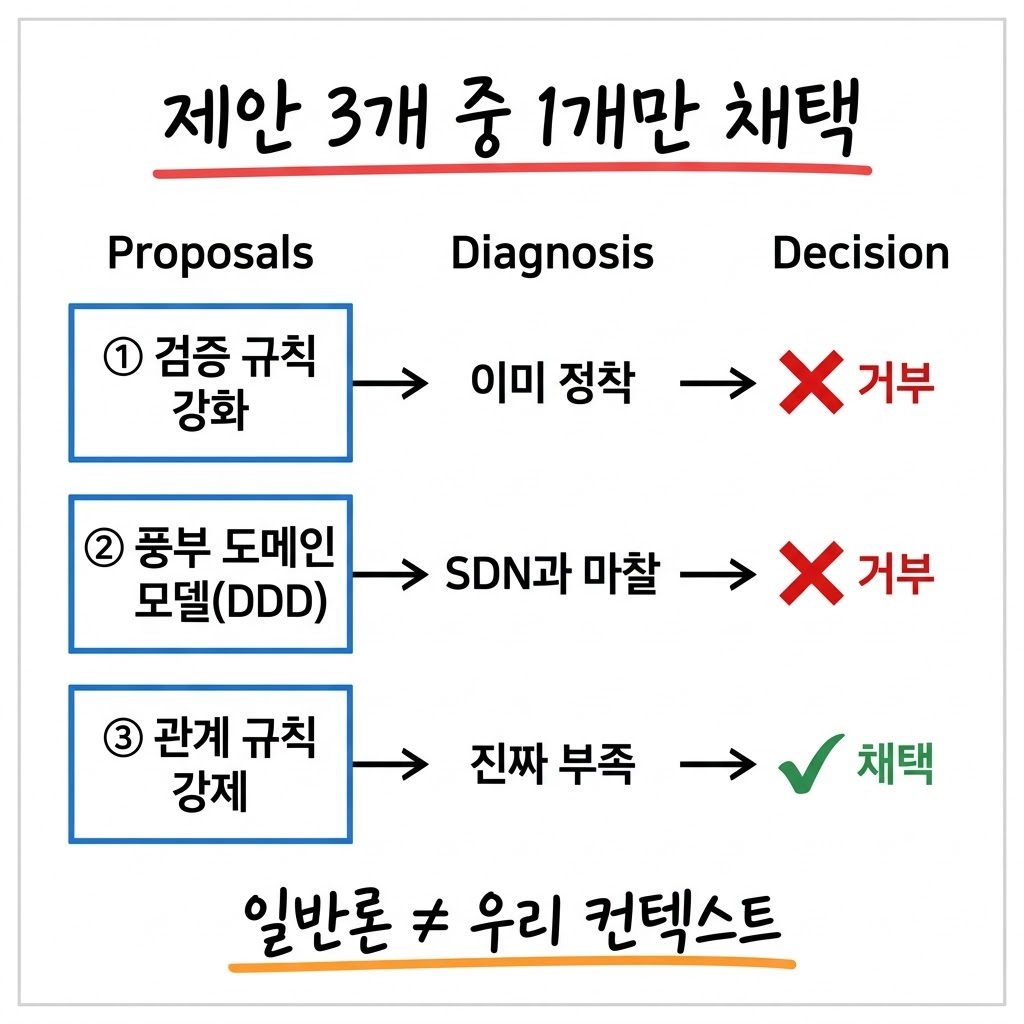
제안은 세 가지였고, 다 맞는 말처럼 보였습니다
에이전트가 올린 제안은 다음과 같았습니다. 첫째, 비즈니스 검증 규칙을 강화하라. 둘째, 도메인 로직을 엔티티로 끌어올려 풍부한 도메인 모델(DDD)을 만들어라. 셋째, 그래프 관계 규칙에 합의가 필요하다.
세 개 모두 교과서적으로는 옳은 권고입니다. 그래서 더 위험합니다. 다 채택하면 일반론을 그대로 따라가는 것이고, 다 거부하면 검증 없는 거부가 됩니다. 둘 다 좋은 선택지가 아닙니다.
그래서 제안을 받자마자 코드를 고치지 않고, 현황부터 숫자로 쟀습니다.
검증 로직은 이미 정착해 있었습니다
첫 번째 제안을 확인하려고 코드베이스를 훑었습니다. 검증 애너테이션이 21곳, 필수값 체크류가 33곳, 예외를 명시적으로 던지는 파일이 80개였습니다. 비즈니스 검증은 이미 코드 전반에 정착해 있었습니다.
여기에 새 정책을 더 얹는 건 중복입니다. 첫 번째 제안은 "맞는 말이지만 우리에겐 이미 있는 것"으로 분류하고 채택하지 않았습니다.
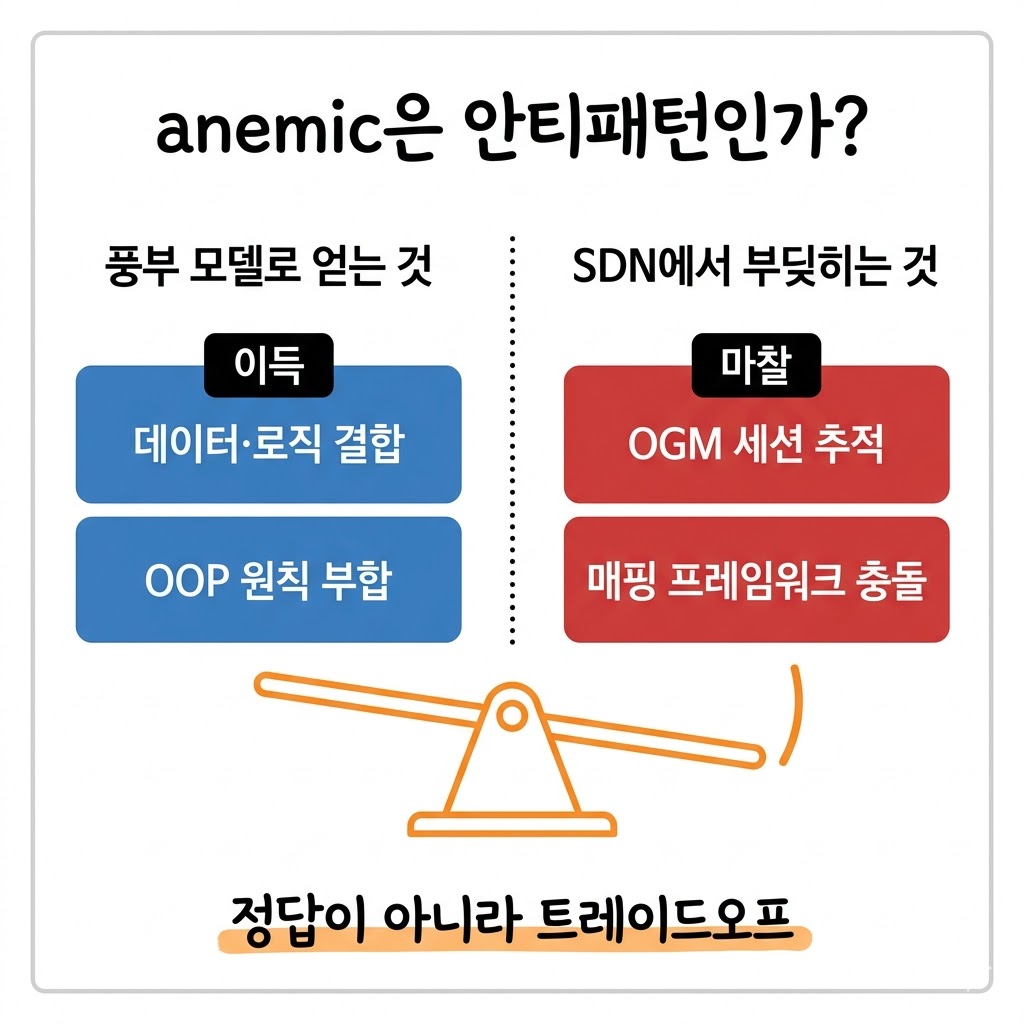
anemic 모델은 안티패턴이라는데, 컨텍스트가 답을 바꿉니다
두 번째 제안이 가장 까다로웠습니다. 우리 노드 클래스는 전부 데이터만 들고 행위는 서비스에 있는 구조, 흔히 anemic(빈혈성) 도메인 모델이라 부르는 형태였습니다. 에이전트는 이걸 풍부한 도메인 모델로 바꾸라고 권했습니다.
용어부터 짚으면, 일반론에서 안티패턴으로 명명된 쪽은 오히려 anemic 모델입니다. Martin Fowler가 2003년에 이 이름을 붙였고, 데이터와 행위를 한 객체에 결합하는 객체지향 설계의 기본 발상에 어긋난다는 게 그 근거입니다.
그렇다고 anemic이 무조건 나쁜 것도 아닙니다. 정당한 옹호 근거가 있습니다. 로직과 데이터를 명확히 분리할 수 있고, 단순한 애플리케이션에 적합하며, 무엇보다 dumb property를 기대하는 매핑·주입 프레임워크와 궁합이 좋고 복잡한 객체-DB 매핑 레이어를 피할 수 있습니다.
이 지점이 핵심입니다. 우리가 쓰는 Spring Data Neo4j는 객체-그래프 매핑(OGM) 위에서 세션 생명주기를 추적하고, 낙관적 락과 불변 엔티티를 다루는 구조입니다. 이 환경에서 엔티티에 행위를 잔뜩 넣으면, 풍부 모델로 얻는 이득보다 매핑·세션·트랜잭션과 부딪히는 마찰이 더 큽니다.
그래서 "anemic은 우주적 정답"이라는 결론이 아닙니다. "우리 SDN 컨텍스트에서는 풍부 모델의 이득보다 마찰이 커서, anemic이 실용적 선택이었다"는 트레이드오프 판단입니다. 일반 원칙(풍부 모델 선호)을 그대로 따르지 않고, 현재 스택의 특성에 맞춰 조정한 사례입니다. 두 번째 제안은 거부했고, 거부 사유를 문서에 남겼습니다.
같은 패턴으로 일반 보안 원칙을 현 조건에 맞게 조정한 기록도 있습니다.
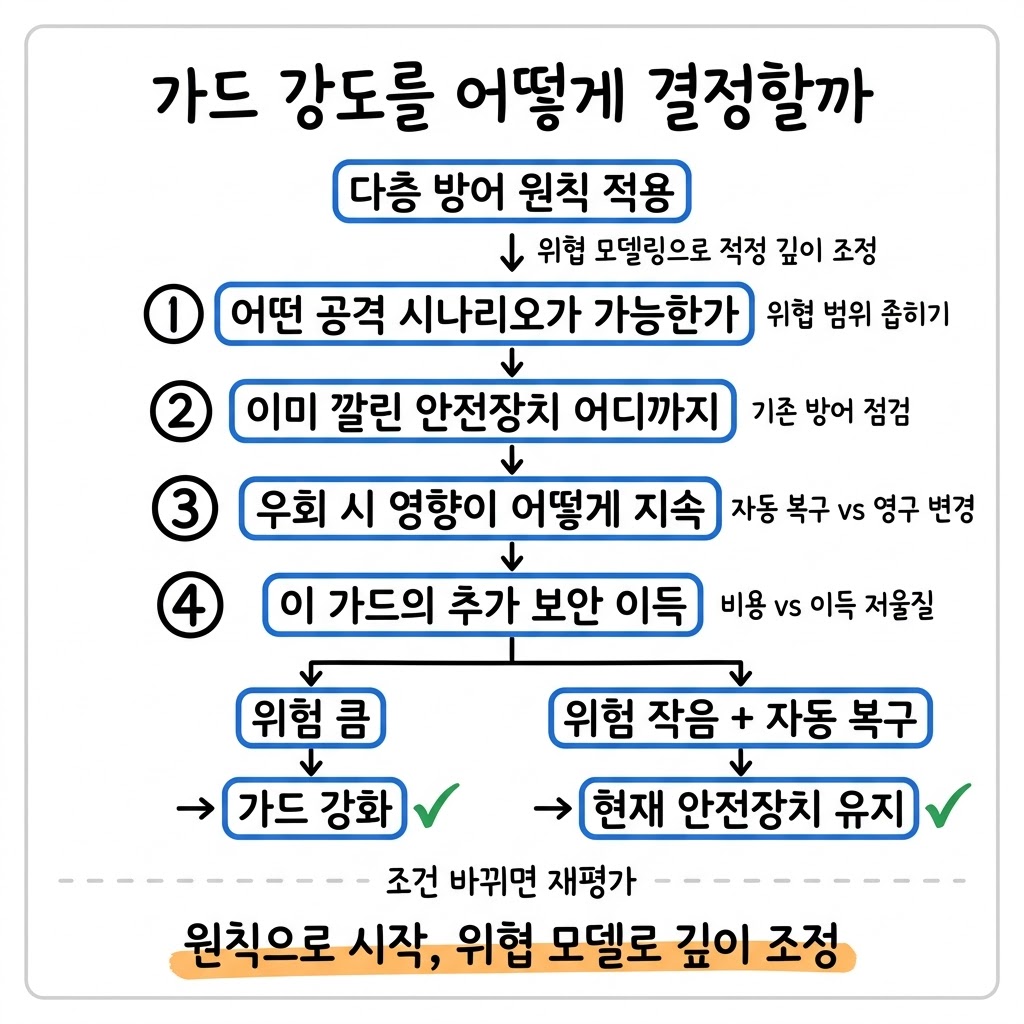
진짜 부족했던 건 세 번째, 관계 강제였습니다
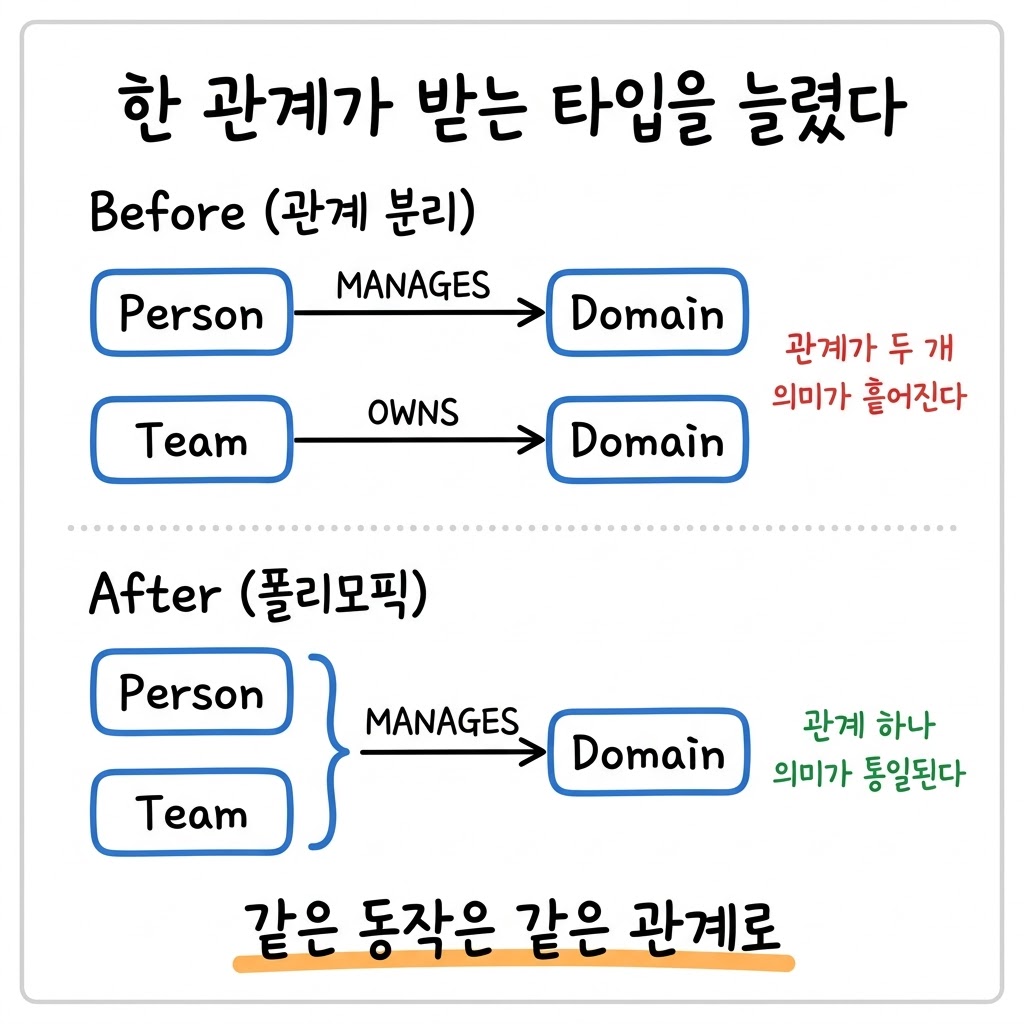
세 가지 중 실제로 부족한 건 세 번째뿐이었습니다. 그래프 관계를 다루는 Cypher 구문이 코드 전반에 흩어져 있는데, "이 노드는 반드시 저 노드에 연결돼야 한다"는 의무 관계를 강제하는 장치가 약했습니다.
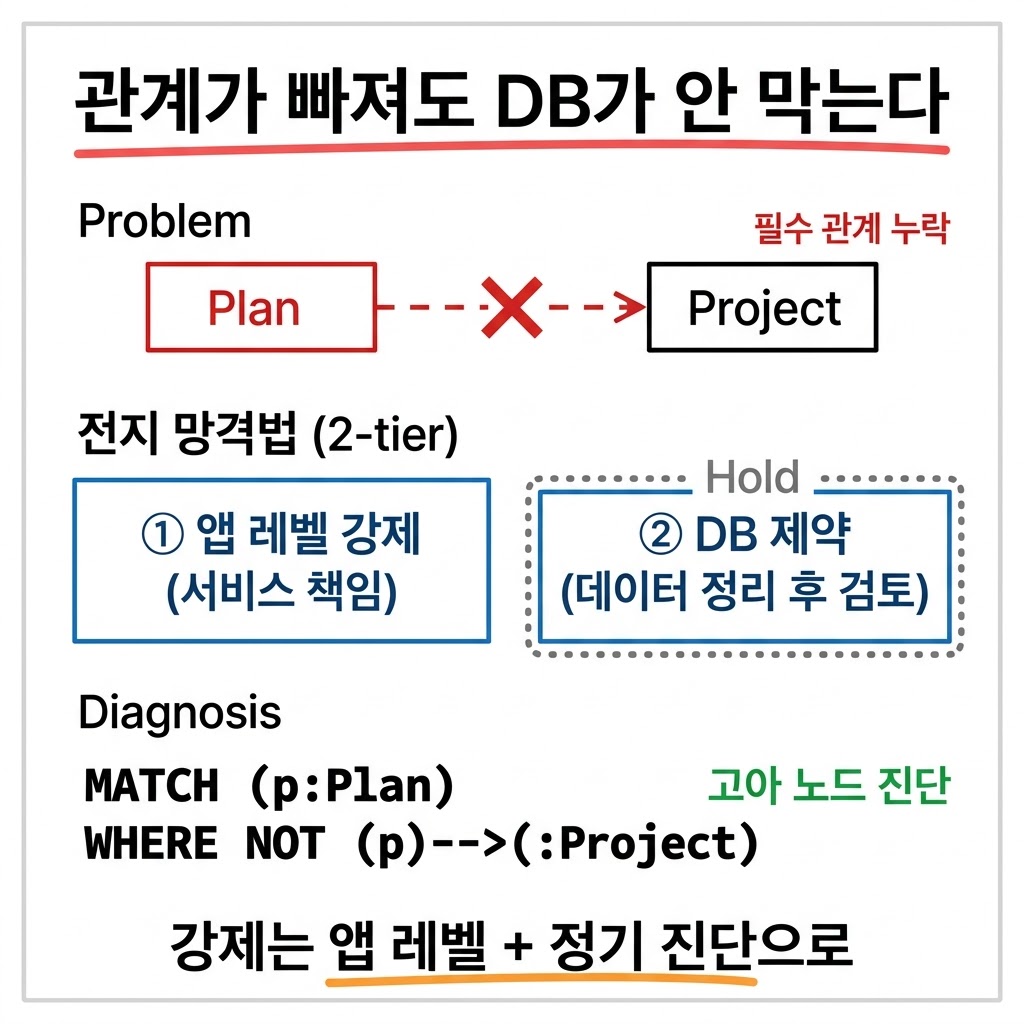
이건 그래프 DB의 구조적 약점이기도 합니다. 관계형 DB라면 NOT NULL 외래 키로 강제할 수 있는 제약이, 그래프 DB에서는 기본적으로 느슨합니다. 노드를 일단 만들 수 있고, 필수 관계가 빠져도 DB가 막아주지 않습니다.
그래서 의무 관계를 문서에 명문화했습니다. 예를 들어 프로젝트 산하 항목은 반드시 프로젝트에 연결되고, 일부 노드는 두 부모 중 하나에만 붙어야 하며, 특정 노드는 출처가 최소 하나 있어야 합니다. 이런 규칙을 노드 16종에 걸쳐 정리했습니다.
강제는 일단 애플리케이션 레벨(서비스 책임)에 두기로 했습니다. DB 레벨의 존재 제약은 기존 고아 데이터를 정리한 뒤 검토하는 게 안전합니다. 대신 필수 관계가 빠진 노드를 찾는 진단 쿼리를 함께 추가해, 정기적으로 깨진 곳을 잡아내도록 했습니다.
관계의 주체에 여러 타입을 허용하는 폴리모픽 설계도 같이 고민했던 부분입니다.
일반론적 권고는 컨텍스트 검증 후에 채택합니다
세 제안을 처리하고 나서 남은 원칙은 단순합니다. AI 에이전트가 주는 권고는 "일반적으로 옳은 말"의 모음이지, 내 코드베이스의 컨텍스트를 검증한 결론이 아닙니다.
다 따르면 일반론에 끌려다니고, 다 거부하면 배울 기회를 놓칩니다. 사이에서 길을 내는 방법은 코드 매트릭스로 현황을 측정한 뒤, 이미 정착한 것과 진짜 부족한 것을 구분하는 일입니다. 검증 21곳·필수값 33곳 같은 숫자가 그 판단의 근거가 됩니다.
거부한 제안의 사유를 기록해 두는 것도 같은 맥락입니다. 다음에 같은 권고가 또 올라오면, 그때 다시 처음부터 따지지 않고 기록을 꺼내면 됩니다.
점검 체크리스트
AI 코드 리뷰 제안을 받았을 때 다음을 점검하면 일반론 추종과 무검증 거부 사이를 피할 수 있습니다.
제안이 "일반적으로 옳은 말"인지, "우리 컨텍스트에 맞는 말"인지 구분했는가
현황을 숫자(코드 매트릭스)로 측정하고 판단했는가
이미 정착한 규칙과 진짜 부족한 영역을 분리했는가
우리가 쓰는 프레임워크·DB의 특성(예: ORM/OGM 매핑, 트랜잭션)을 권고에 반영했는가
거부한 제안의 사유를 다음 검토를 위해 기록했는가
AI 도구를 코드 리뷰에 붙이는 건 분명 이득입니다. 다만 그 제안을 그대로 머지 버튼까지 연결하는 순간, 일반론과 우리 컨텍스트의 차이가 코드에 쌓입니다. 제안과 채택 사이에 진단 한 단계를 두는 것만으로 그 차이를 거를 수 있습니다.