지금 값만 주는 API 의 지표는 그 시각에 찍어야 남습니다
한 SNS 플랫폼에 제휴 링크가 들어간 글을 올리는 운영을 하고 있습니다. 계정은 두 개입니다. 글을 몇 가지 유형으로 나눠 올리고, 날을 정해 어느 유형이 잘 읽히는지 판정하기로 했습니다. 판정 기준은 '게시 24시간 뒤 조회 수'로 적어 뒀습니다.
기준은 정해 뒀는데 그 값을 어떻게 손에 넣을지는 정하지 않았습니다. 판정일에 측정 도구를 한 번 돌리면 된다고 생각했습니다. 이 글은 그 전제가 틀렸다는 데서 시작합니다.
그 API 는 지금 값만 줍니다
측정 도구를 다시 들여다보니 그 플랫폼의 API 는 **과거 시점 조회를 주지 않았습니다.** 요청한 순간의 조회 수만 돌려줍니다. 사흘 전 글의 '게시 24시간 뒤 조회 수'를 오늘 물어볼 방법이 없습니다.
그러면 판정일에 손에 쥐는 값은 '판정일 현재 조회 수'입니다. 글마다 게시 후 지난 시간이 다르니 같은 기준으로 비교할 수도 없습니다. 게시 후 24시간이 되는 시각에 누군가 값을 찍어 두지 않았다면, 그 글의 24시간 값은 어디에도 남지 않습니다.
보통 자동화는 편의를 위해 합니다. 손으로도 할 수 있지만 번거로우니 기계에 넘깁니다. 이 값은 사정이 다릅니다. 손으로 재다가 하루를 놓치면 그날 값은 **다시 구할 방법이 없습니다.** 여기서 자동화는 편의가 아니라 값을 남기는 유일한 방법이었습니다.
세 가지 방법을 놓고 비교했습니다
값을 손에 넣는 방법은 세 가지였습니다.
방법 | 장점 | 약점 |
|---|---|---|
판정일에 손으로 한 번 잰다 | 만들 것이 없다 | 그날 잊으면 데이터가 없다. 24시간 값은 처음부터 못 얻는다 |
판정일에만 자동으로 한 번 잰다 | 잊을 일이 없다 | 그 한 번이 실패하면 손으로 잴 때와 결과가 같다. 실패했다는 것도 판정일에야 안다 |
주기적으로 계속 재서 쌓는다 | 한 회차가 실패해도 다음 회차가 메운다 | 쌓는 비용이 든다. 시점이 주기만큼 어긋난다 |
셋째 줄(주기적으로 계속 쌓는다)로 갔습니다. 다시 구할 수 없는 값이라면 재시도가 처음부터 설계에 들어가 있어야 한다고 봤습니다. 판정일에만 한 번 재는 방식은 실패를 알아챌 시점이 너무 늦습니다. 알았을 때는 이미 그 값을 다시 얻을 수 없습니다.
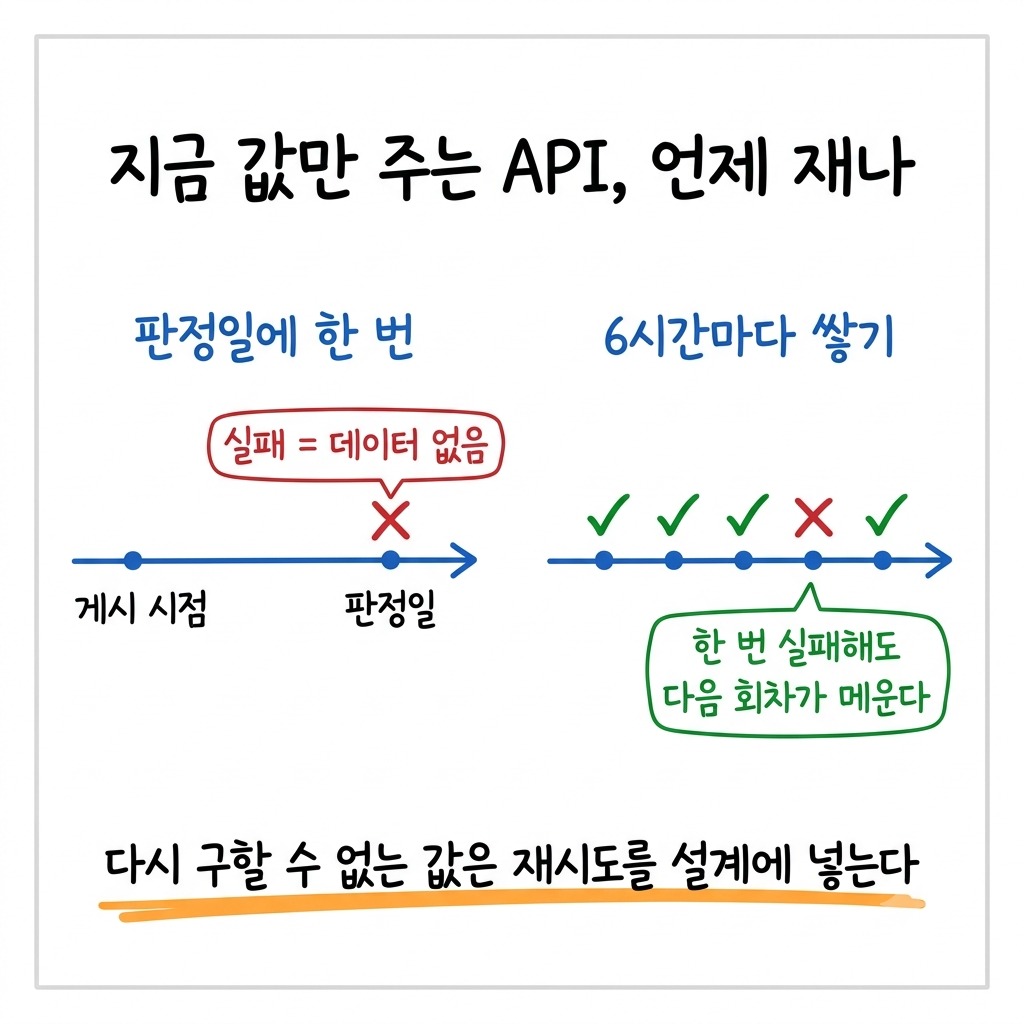
여섯 시간마다 쌓는 예약 작업을 만들었습니다
만든 것은 아래와 같습니다.
**여섯 시간마다** 두 계정의 값을 재서 스냅샷 한 줄을 기록 파일에 쌓는 예약 작업을 걸었습니다
기록 파일은 **상시 가동하는 기계 한 대만** 쓰게 했습니다. 두 곳에서 같이 쓰면 충돌합니다
측정 도구가 계정을 인자로 받게 고쳐, 같은 코드로 두 계정을 잽니다. 기간 필터로 '언제부터'를 자를 수 있게 했습니다
글 유형은 **파일 이름의 둘째 칸**으로 분류합니다. 이름 규칙이 곧 분류라서 유형을 늘릴 때 코드를 고치지 않습니다. 뜻이 같은 유형 둘은 하나로 묶었습니다
기록 열람 도구에 성과 메뉴를 붙이고 **이미 있던 토큰으로 보호**했습니다. 새 인증 장치는 만들지 않았고, 토큰 없이 들어가면 거부되는 것을 직접 확인했습니다
돌아보면 '24시간 뒤 조회 수로 판단한다'는 문장은 그 자체로 측정 요구사항이었습니다. 기준을 적는 날 재는 장치도 같이 만들었어야 했습니다. 기준만 적고 장치를 미뤘다면 판정일에 아무것도 없었을 겁니다.
배치가 매달 성공해도 판정 기준 밖의 누락은 아무도 안 볼 수 있습니다. 기준과 재는 장치가 따로 놀았던 다른 사례입니다.
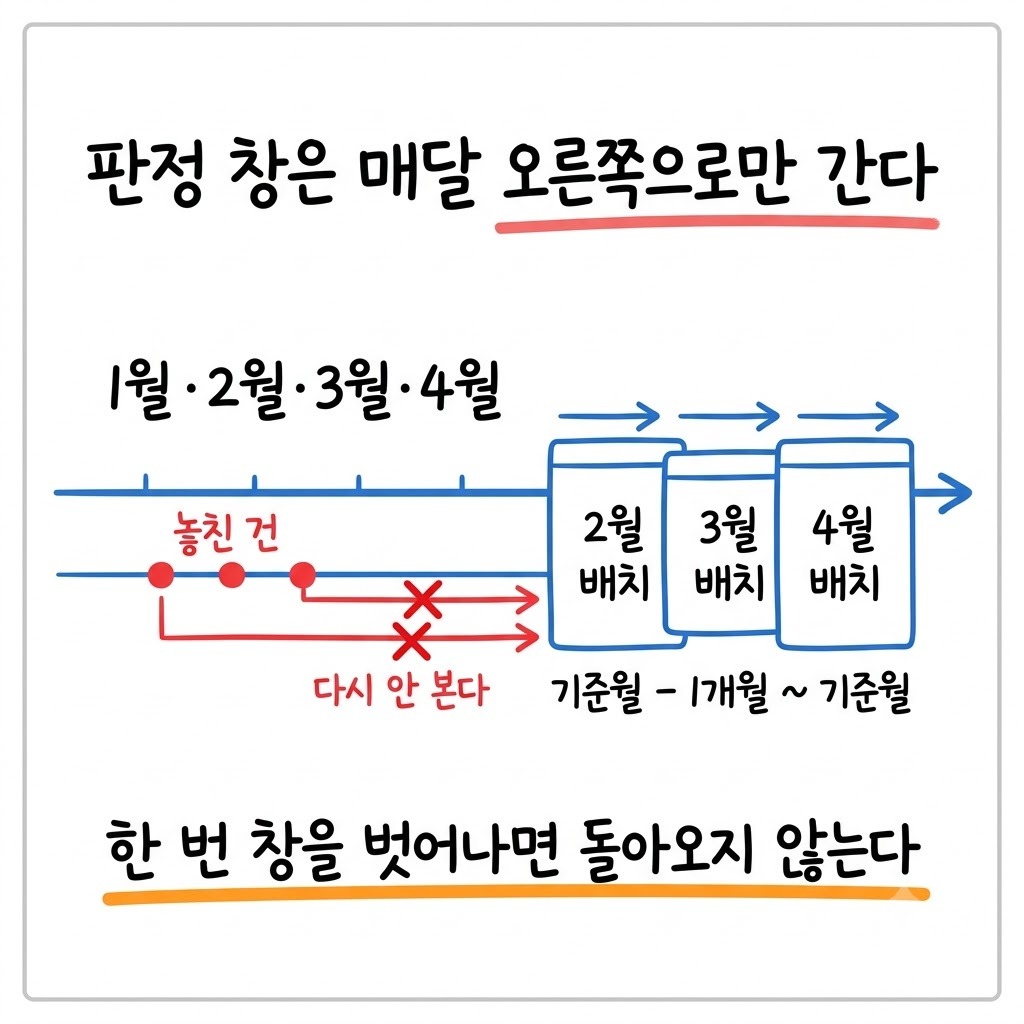
분류를 늘렸더니 그래프에 검정이 나왔습니다
작은 결함 하나가 같이 나왔습니다. 유형 분류를 늘렸는데 그래프의 색 표는 늘리지 않았습니다. 그래서 색 표에 없는 유형이 그래프에서 **검정으로 나왔습니다.** 오류가 나지 않고 그냥 검정으로 그려지니 눈치채기가 늦습니다.
분류 목록만 고치고 그 분류를 쓰는 자리는 고치지 않은 것이 원인이었습니다. 색이 붙게 고쳤습니다. 분류를 늘릴 때는 그 분류를 받아 쓰는 표와 화면을 같이 세어 봐야 합니다.
다섯 배 차이를 결론으로 적지 않았습니다
쌓이기 시작한 데이터에서 눈에 띄는 숫자가 하나 나왔습니다. 링크를 댓글에 붙인 글에서, 본문을 본 사람 중 댓글까지 내려간 비율(도달률)이 두 계정에서 크게 달랐습니다.
본문 조회 | 댓글 조회 | 도달률 | |
|---|---|---|---|
계정 A | 341 | 106 | 31.1% |
계정 B | 1,663 | 97 | 5.8% |
다섯 배 넘게 갈렸습니다. 그런데 높게 나온 계정 A 의 **조회 중앙값은 16**이었습니다. 글 하나당 열몇 명이 보는 규모에서는 몇 명만 움직여도 비율이 크게 흔들립니다. 정작 수익으로 이어지는 클릭은 양쪽 다 0~1 이었습니다. 둘을 가를 근거가 되지 못했습니다.
그래서 결론을 내지 않았습니다. 이 숫자는 '관찰(결론 아님)'이라고 적었습니다. 운영 전략 문서의 최종 판정일 줄에는 '이 도달률을 그때 다시 본다'를 적어 뒀습니다. 판정일까지 쌓이는 표본이 답하게 두는 것이 데이터가 모자랄 때 할 수 있는 처리였습니다.
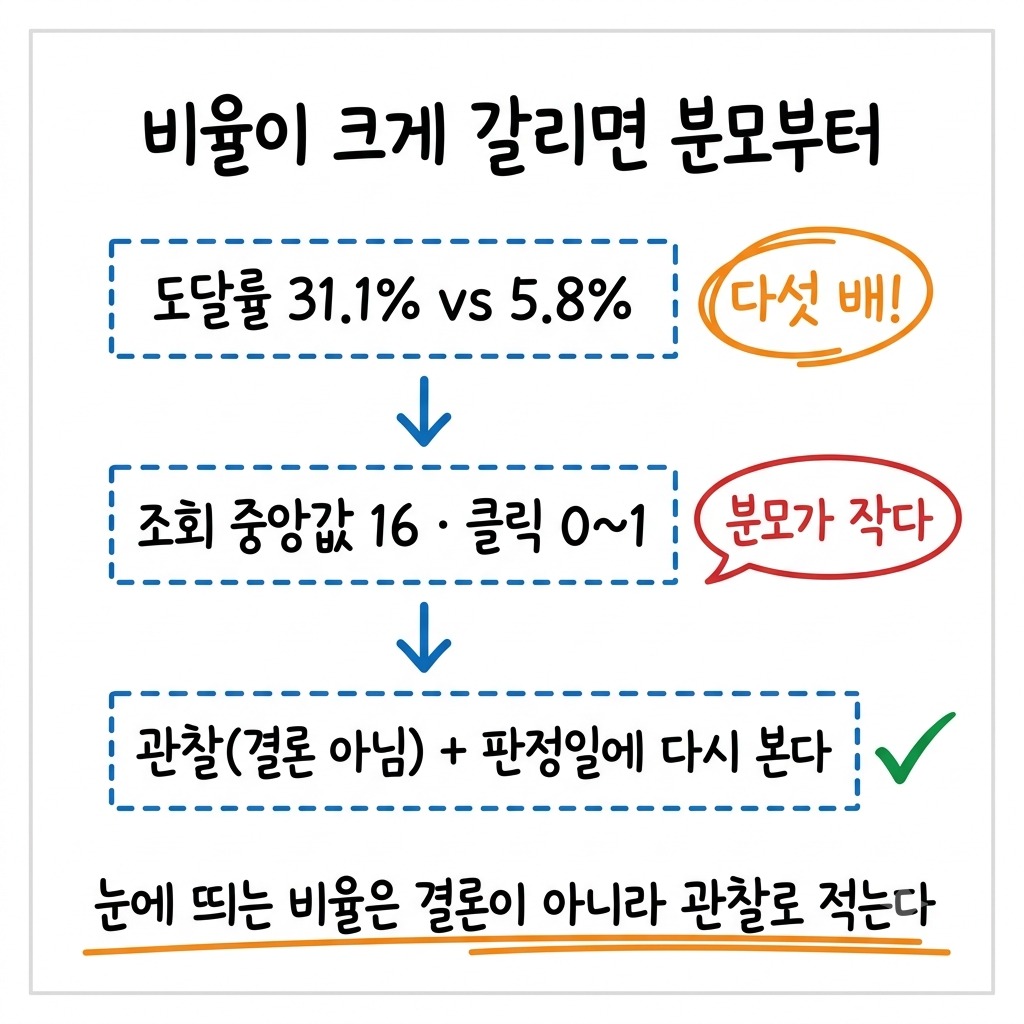
같은 설정으로 두 번 돌려도 결과가 크게 흔들린 실측이 있습니다. 작은 표본에서 나온 차이를 어떻게 다뤘는지 같이 보면 좋습니다.
이 설계가 감수한 것
**시점이 최대 여섯 시간 어긋납니다.** 여섯 시간 간격으로 찍으니 '게시 24시간 뒤'는 정확히 24시간이 아닙니다. 유형끼리 비교하기엔 충분하지만, 정확한 시점 값이 필요하면 주기를 줄이거나 글마다 따로 걸어야 합니다
**기계 한 대가 멈추면 기록도 멈춥니다.** 충돌을 피한 대가로 단일 실패 지점을 받았습니다. 지금은 멈춘 것을 사람이 알아채면 되는 수준이라 감수했습니다
**과거 조회를 주는 API 라면 이 설계가 필요 없습니다.** 지난 값을 언제든 다시 물을 수 있으면 판정일에 한 번 가져오면 됩니다
**재는 데 비용이 큰 값이면 주기를 이렇게 짧게 못 가져갑니다.** 호출 제한이 있거나 한 번에 돈이 드는 값이면 주기를 늘리고 판정 범위를 넓히는 쪽이 현실적입니다
측정 기준을 정할 때 같이 보는 것
이 값은 나중에 다시 물어볼 수 있는가. 못 묻는다면 자동화가 편의가 아니라 유일한 방법입니다
기준에 시각이 들어가 있는가. 들어가 있다면 그 시각에 값을 찍는 장치가 기준과 같은 날 있어야 합니다
한 번 재다 실패하면 다음 기회가 있는가. 없다면 주기적으로 쌓아 재시도를 설계에 넣습니다
눈에 띄는 비율이 나왔을 때 분모는 얼마인가. 작으면 결론 대신 관찰로 적고 다시 볼 날짜를 정합니다
분류를 늘렸을 때 그 분류를 받아 쓰는 표·화면은 몇 군데인가
마무리
판정 기준을 적는 일과 그 값을 재는 장치를 만드는 일을 따로 생각했습니다. 기준에 '24시간 뒤'라는 시각이 들어가는 순간 둘은 같은 일이었습니다. API 가 지금 값만 준다면 그 시각을 놓친 값은 다시 구할 수 없습니다. 측정 기준을 정할 때는 그 값을 나중에 다시 물어볼 수 있는지부터 확인합니다.