스키마 바꿀 때마다 데이터 재처리, 빅테크는 어떻게 할까
새 타입 승격할 때마다 재임포트가 필요했습니다
지식그래프 운영하면서 거버넌스를 통해 새 타입을 승격하는 흐름이 자리잡았습니다. LLM이 발견한 미매핑 타입 중 도메인에 적합한 것을 정규 타입으로 올리는 프로세스인데, 한 번 승격할 때마다 마음에 걸리는 게 하나 있었습니다.
기존 문서들은 이전 스키마로 이미 처리된 상태라는 점입니다.
새로 승격한 타입은 새로 들어오는 문서에는 적용되지만, 이전에 임포트한 문서에는 자동 적용되지 않습니다. 새 타입까지 반영하려면 기존 문서들을 다시 임포트해야 합니다. 문서 3개일 때는 5분이면 끝나는 작업이지만, 30개가 되고 300개가 되면 얘기가 달라집니다.
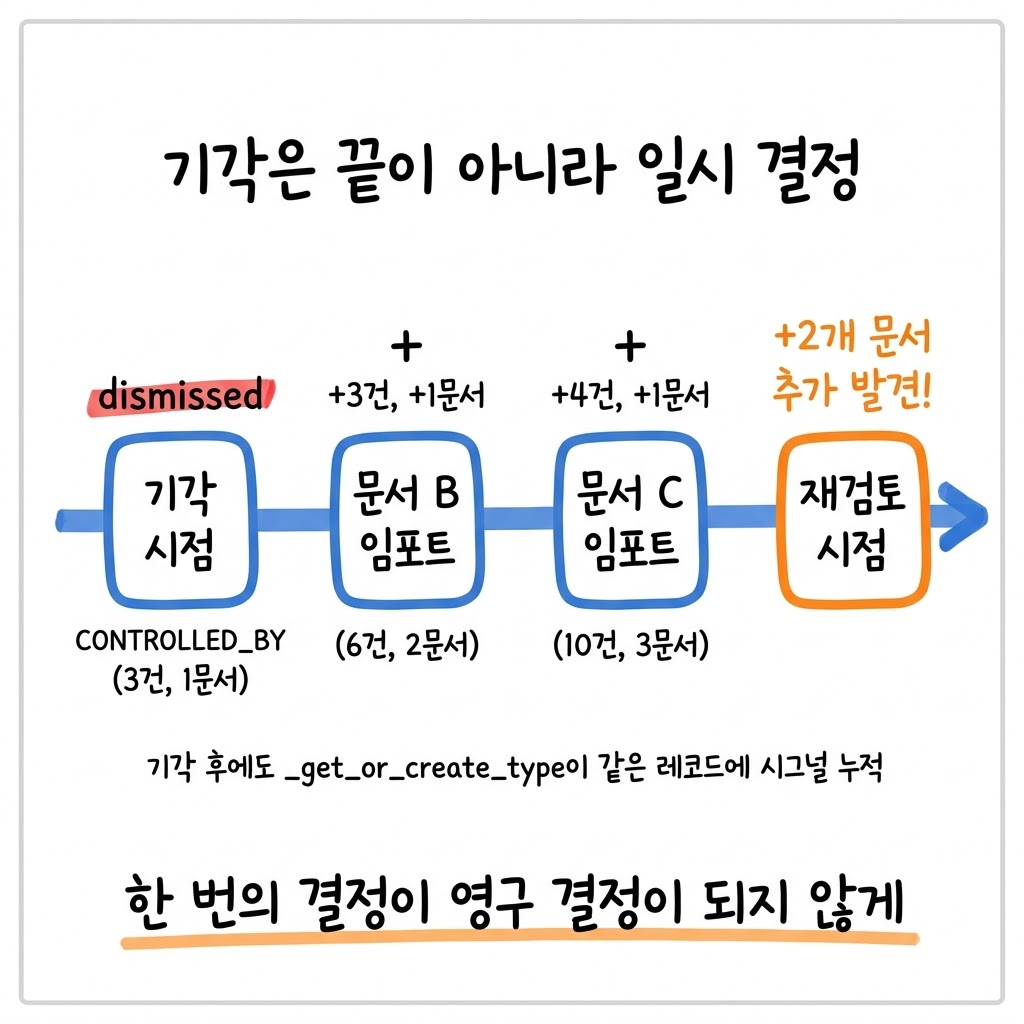
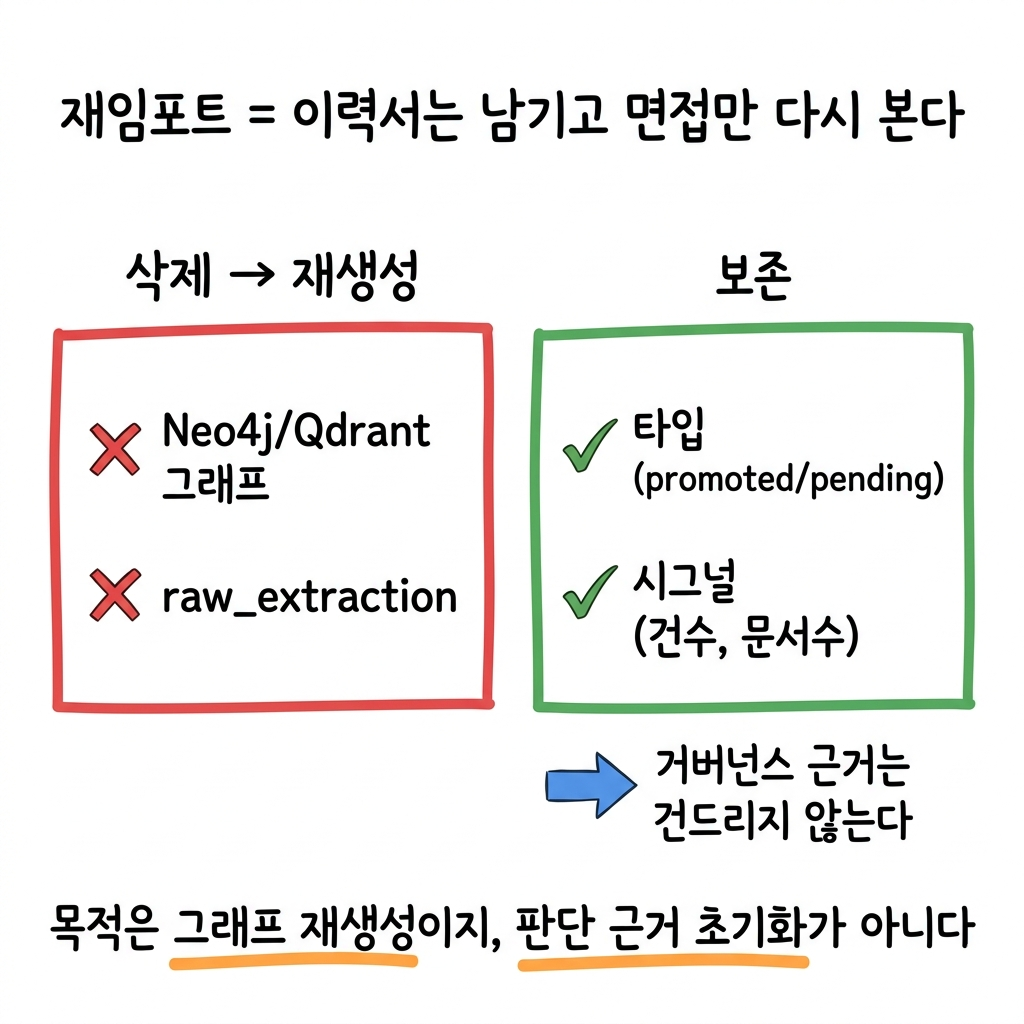
이 시점에서 의문이 하나 들었습니다. "우리만 이렇게 비효율적인가?" 빅테크들은 스키마를 자주 바꿀 텐데, 그때마다 매번 데이터를 전부 다시 처리하지는 않을 것 같았습니다. 무언가 더 영리한 방법이 있을 거라 생각했습니다.
결론은 "재처리는 피할 수 없다"였습니다
여러 자료를 찾아본 결과는 의외였습니다. 빅테크도 스키마 변경 시 데이터 재처리를 피하지 못합니다. 차이는 "재처리 자체"가 아니라 "자동화 수준" 이었습니다.
dbt는 incremental 모델을 쓰다가 스키마가 크게 바뀌면 --full-refresh 플래그로 전체 재빌드를 합니다. dbt 공식 문서에서도 "significant schema changes, backfills, or when incremental state needs to be reset" 시 사용하라고 안내하고 있어요. 이름만 다를 뿐 우리의 재임포트와 같은 개념입니다.
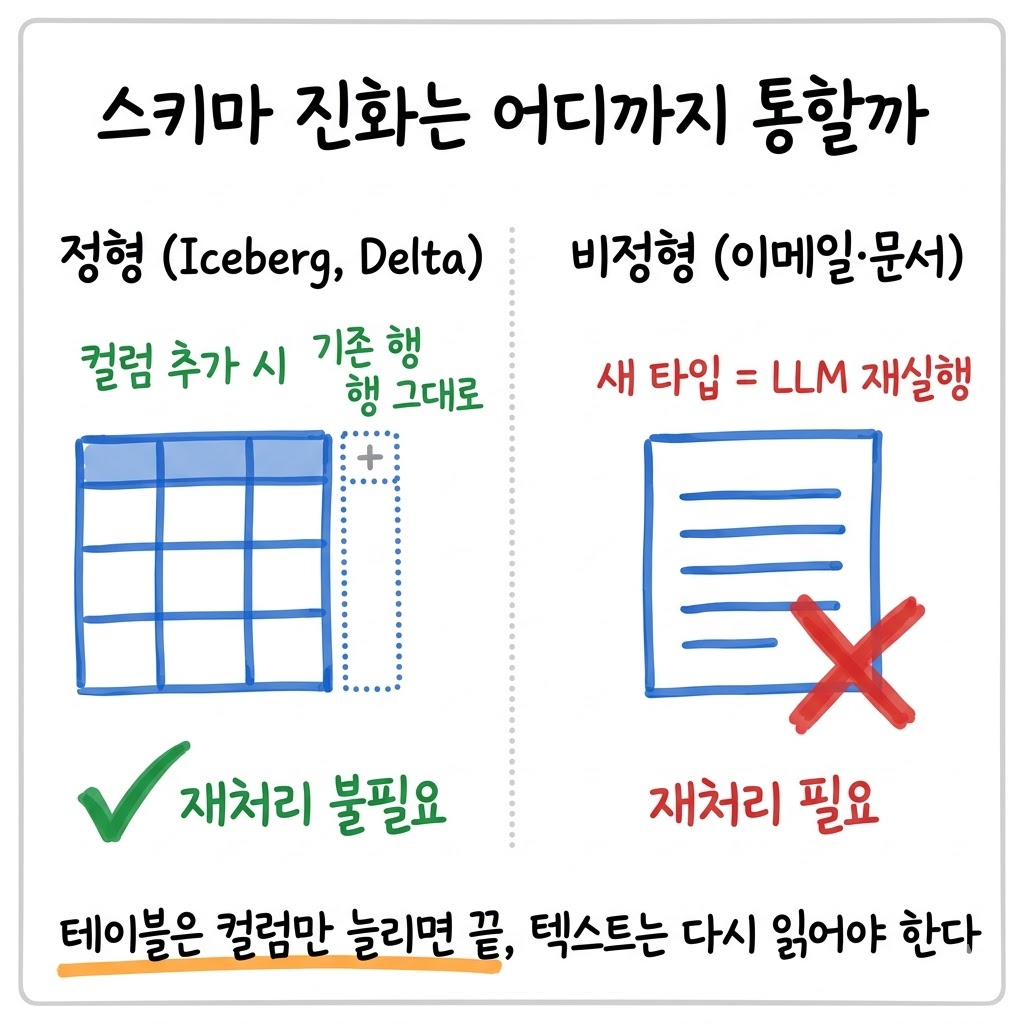
Apache Iceberg나 Delta Lake 같은 데이터 레이크 포맷은 "스키마 진화(schema evolution)"라는 기능으로 컬럼 추가/삭제/이름 변경 시 기존 데이터를 다시 쓰지 않습니다. 이게 가능한 이유는 정형 데이터(테이블) 이기 때문입니다. 컬럼만 늘어났을 뿐 기존 행의 의미는 그대로니까요.
하지만 우리 같은 LLM 추출 파이프라인에는 이 방식이 적용되지 않습니다. 새 타입(예: Database)을 추가하면 LLM이 기존 이메일 본문에서 그 타입의 엔티티를 다시 발견해야 합니다. 컬럼이 늘어난 게 아니라, 같은 텍스트에서 새로운 의미를 뽑아내야 하는 상황이에요.
자동화 수준은 데이터 규모에 따라 다릅니다
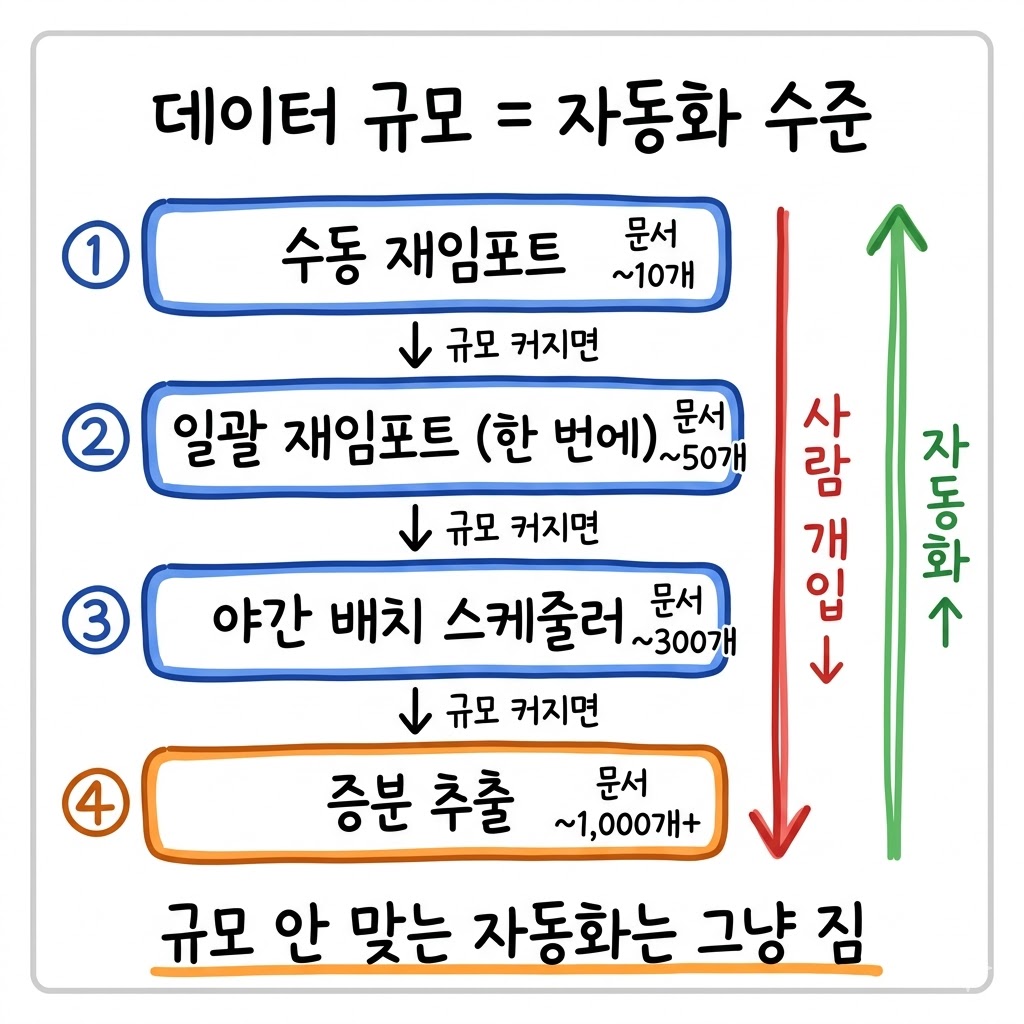
재처리 자체는 피할 수 없지만, "어떻게 처리하느냐"는 규모에 따라 선택지가 달라집니다. 자료들을 정리하면 네 단계로 나뉘었습니다.
전략 | 설명 | 적합 규모 |
|---|---|---|
수동 재임포트 | 사용자가 문서별로 재임포트 클릭 | 문서 ~10개 |
일괄 재임포트 | "전체 재임포트" 버튼으로 큐에 넣고 순차 처리 | 문서 ~50개 |
야간 배치 | stale 문서를 스케줄러가 야간에 자동 재처리 | 문서 ~300개 |
증분 추출 | 기존 데이터 유지, 새 타입만 추가 추출 | 문서 ~1,000개+ |
각 단계의 핵심은 "사람이 얼마나 개입하는가" 입니다. 수동에서는 사람이 매번 클릭하고, 일괄에서는 한 번만 클릭하고, 야간 배치에서는 클릭조차 필요 없고, 증분 추출에서는 기존 결과를 보존하면서 부분만 처리합니다.
데이터가 적을 때 위 단계의 자동화를 미리 만들어두는 건 오버엔지니어링이에요. 문서 3개에 야간 배치 스케줄러를 붙이면 코드 복잡도만 올라가고 얻는 게 거의 없습니다. 반대로 문서가 1,000개를 넘는데 수동 클릭만 쓰고 있으면 운영자가 못 버팁니다.
증분 추출은 생각만큼 효율적이지 않았습니다
처음에는 "증분 추출이 가장 좋은 거 아닌가?" 생각했습니다. 기존 데이터를 그대로 두고 새 타입만 추가로 뽑으면 토큰을 절약할 수 있을 것 같았어요. 그런데 실제 동작을 따라가 보니 이득이 크지 않았습니다.
이유는 LLM 호출 구조에 있습니다. 새 타입(Database) 하나만 추출하더라도, LLM에는 여전히 문서 본문 전체를 컨텍스트로 줘야 합니다. "이 문서에서 Database 엔티티만 뽑아줘"라고 요청해도 LLM이 본문을 읽어야 하니, 토큰 비용은 거의 비슷해집니다.
거기에 추가 부담이 붙습니다.
기존 추출 결과와 새 추출 결과를 병합하는 로직이 필요합니다
어떤 엔티티가 "이미 있던 것"인지 "새로 발견된 것"인지 식별해야 합니다
같은 엔티티가 두 번 추출되면 중복 제거 처리도 필요합니다
파이프라인 구조 자체를 크게 바꿔야 합니다
토큰 비용은 거의 안 줄고 코드 복잡도는 커지는 거예요. 문서 수백 개까지는 차라리 전체 재임포트 + 배치 자동화가 더 단순하고 안정적입니다.
증분 추출이 의미 있어지는 시점은 문서가 1,000개를 넘기 시작할 때입니다. 그 규모가 되면 전체 재임포트에 시간이 너무 오래 걸려서 야간 배치로도 안 끝나거든요. 그때부터 병합 로직 복잡도를 감수할 만한 가치가 생깁니다.
우리 선택은 수동 재임포트였습니다
지금 우리 프로젝트는 임포트 대상 문서가 3개 수준입니다. 이 규모에서 가장 적합한 전략은 수동 재임포트 였습니다. 운영자가 거버넌스 패널에서 새 타입을 승격한 뒤, 재임포트 패널에서 영향받는 문서를 골라서 클릭합니다. 5분이면 끝나요.
처음에는 이 방식이 왠지 "수준이 낮은" 것 같아서 더 자동화된 구조를 만들어야 하나 고민했습니다. 그런데 알아보니 dbt도 사람이 --full-refresh 플래그를 의도적으로 붙여서 실행합니다. 자동으로 백그라운드에서 도는 게 아니에요. 이유는 재처리가 비용이 큰 작업이라 사람이 명시적으로 결정하는 게 안전하기 때문입니다.
규모가 커지면 다음 단계로 넘어갈 준비를 해두면 됩니다.
문서 3개   → 재임포트 5분    → 수동 클릭으로 충분 ← 지금
문서 30개  → 재임포트 1시간   → 일괄/야간 배치 검토
문서 300개 → 재임포트 10시간  → 야간 배치 필수, 증분 검토
각 단계에서 필요한 코드 변경은 점진적입니다. 수동에서 일괄로 가려면 큐 처리만 추가하면 되고, 일괄에서 야간 배치로 가려면 스케줄러만 붙이면 됩니다. 미리 다 만들어둘 필요는 없어요.
마무리
스키마 변경 시 데이터 재처리는 빅테크들도 피하지 못하는 공통 과제입니다. dbt의 --full-refresh, Foundry의 빌드 재실행, AWS Glue의 backfill 모두 같은 결의 작업이에요. 차이는 재처리를 피했느냐가 아니라 어느 수준까지 자동화했느냐였습니다.
자동화 수준은 데이터 규모를 따라가야 합니다. 문서 3개에 야간 배치 스케줄러를 붙이는 것도, 문서 1,000개에 수동 클릭만 쓰는 것도 잘못된 매칭입니다. 규모가 어디쯤 있는지 먼저 확인하고, 거기에 맞는 단계를 선택하는 게 맞아요.
LLM 추출 파이프라인을 운영하면서 "재임포트가 매번 발생하는데 이게 정상인가?" 의심하는 분이 있다면, 정상입니다. 빅테크도 같은 방식으로 처리하고 있어요. 다만 규모가 커질수록 자동화 단계를 한 칸씩 올려야 한다는 점만 챙기면 됩니다.