수량만 4~5% 많았습니다 — 데이터가 아니라 POS 조회 기준의 기본값이 달랐습니다
프랜차이즈 ERP 의 매장 상세 매출 화면 맨 아래에 '메뉴별 판매' 표를 새로 붙였습니다. 원천은 상용 POS 가 매일 내려주는 상품별 일매출 집계입니다. 이런 화면은 붙이는 순간 사용자가 무엇을 할지 정해져 있습니다. POS 의 같은 화면을 옆에 띄워 놓고 두 숫자를 나란히 보는 것입니다.
같은 브랜드, 같은 달로 대 봤습니다. 금액은 사실상 일치했습니다. 차이가 0.01% 수준이었습니다. 그런데 수량만 우리 쪽이 4~5% 많았습니다.
화면을 붙인 날에는 '조회 기준 차이로 추정(미확인)'이라고만 적어 두고 다음 과제로 넘어갔습니다. 다음 날 40분을 들여 원인을 확인했고, 결과적으로 숫자는 한 자리도 고치지 않았습니다.
어긋남의 모양이 첫 단서였습니다
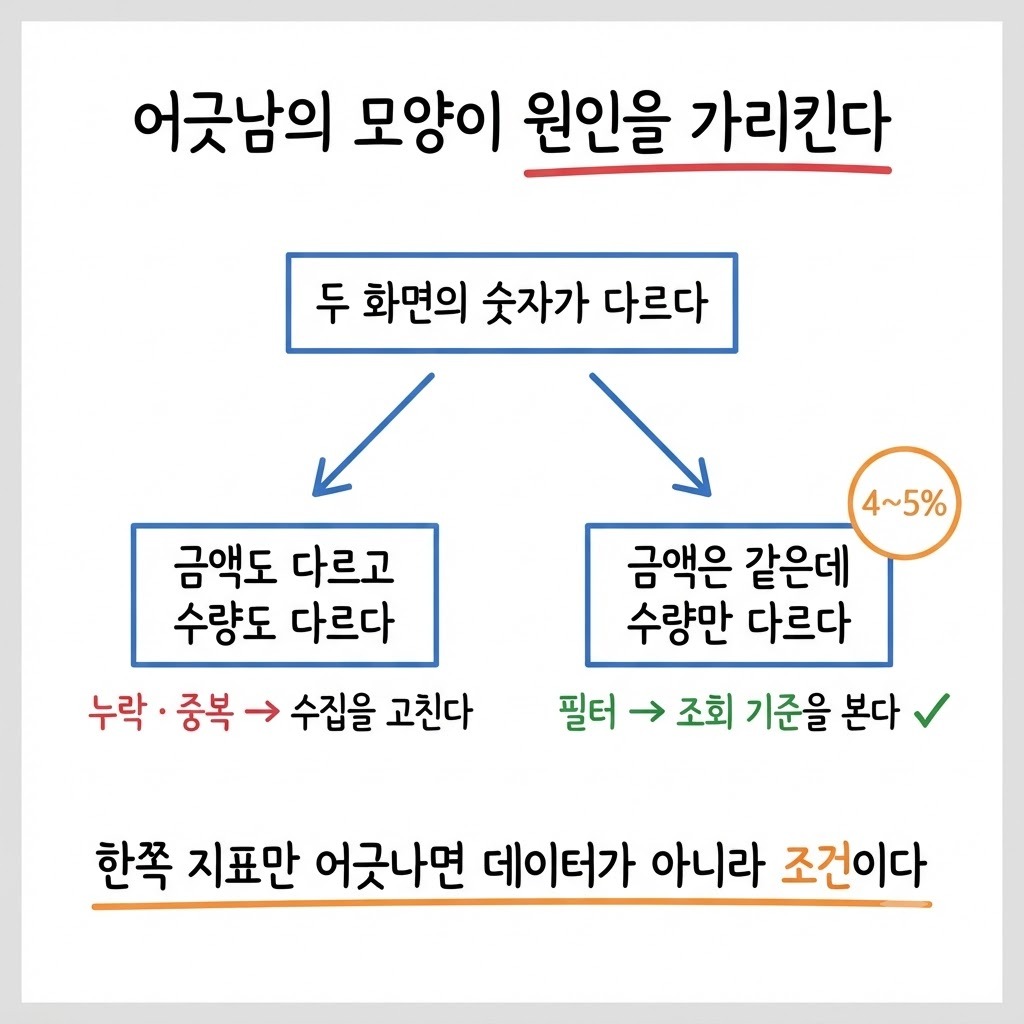
이런 상황에서 가장 먼저 떠오르는 가설은 우리 수집이 틀렸다는 것입니다. 저도 처음엔 그쪽을 봤습니다. 그런데 어긋남이 **비대칭**이었습니다. 금액은 맞고 수량만 많았습니다. 할인 금액까지 원 단위로 일치했습니다.
수집이 통째로 빠졌거나 같은 줄을 두 번 넣었다면 금액과 수량이 같이 어긋납니다. 한쪽 지표만 어긋나는 모양은 누락이나 중복이 아니라 **어느 한쪽이 무언가를 빼고 세고 있다**는 뜻입니다. 그러면 볼 곳은 데이터가 아니라 조회 조건입니다.
그래서 원천 POS 의 상품별 월매출 조회 화면부터 열어 봤습니다. 그 화면의 조회 파라미터에는 세 값이 있었습니다. 전체 · 부가 제외 · 부가만. 그리고 기본값이 '부가 제외'였습니다. 우리는 받은 것을 전량 그대로 집계하고 있었습니다.
추정을 사실로 바꾸는 가장 값싼 방법은 분해해서 더해 보는 것입니다
기본값이 다르다는 것을 봤다고 해서 원인을 확인한 것은 아닙니다. 그 시점까지는 여전히 그럴듯한 가설일 뿐입니다. 필요한 것은 이 설명 하나로 차이가 전부 덮이는지를 보는 일이었습니다.
세 번 조회했습니다.
전체 기준으로 한 번 뽑습니다
부가 제외 기준으로 한 번 뽑습니다
부가만 기준으로 한 번 뽑습니다
전체 = 부가 제외 + 부가만 이 성립하는지 봅니다
상품 개수와 수량 양쪽에서 덧셈이 맞아떨어졌습니다. 우리 화면의 숫자는 '전체'와 일치했고, 남은 차이는 조회하던 당일에 아직 안 들어온 몇 건뿐이었습니다. 덧셈이 맞은 순간 다른 설명이 필요 없어집니다. 그 분류로 차이가 전부 설명되기 때문입니다.
반대로 덧셈이 안 맞았다면 이 글은 다른 이야기가 됐을 겁니다. 전체가 부분의 합보다 크거나 작으면 그건 기준 차이가 아니라 실제 누락이나 중복이고, 그때는 도움말이 아니라 수집을 고쳐야 합니다. 40분이면 둘 중 어느 쪽인지가 갈립니다.
차이 줄의 정체도 같이 봤습니다. 0원짜리 주문 옵션이었습니다. 덜 맵게, 소스 따로 같은 것들입니다. 부가로 잡힌 줄의 대부분이 0원이라 수량에는 4~5%, 금액에는 0.01% 수준으로만 영향이 갔습니다. 비대칭의 이유가 여기서 닫혔습니다.
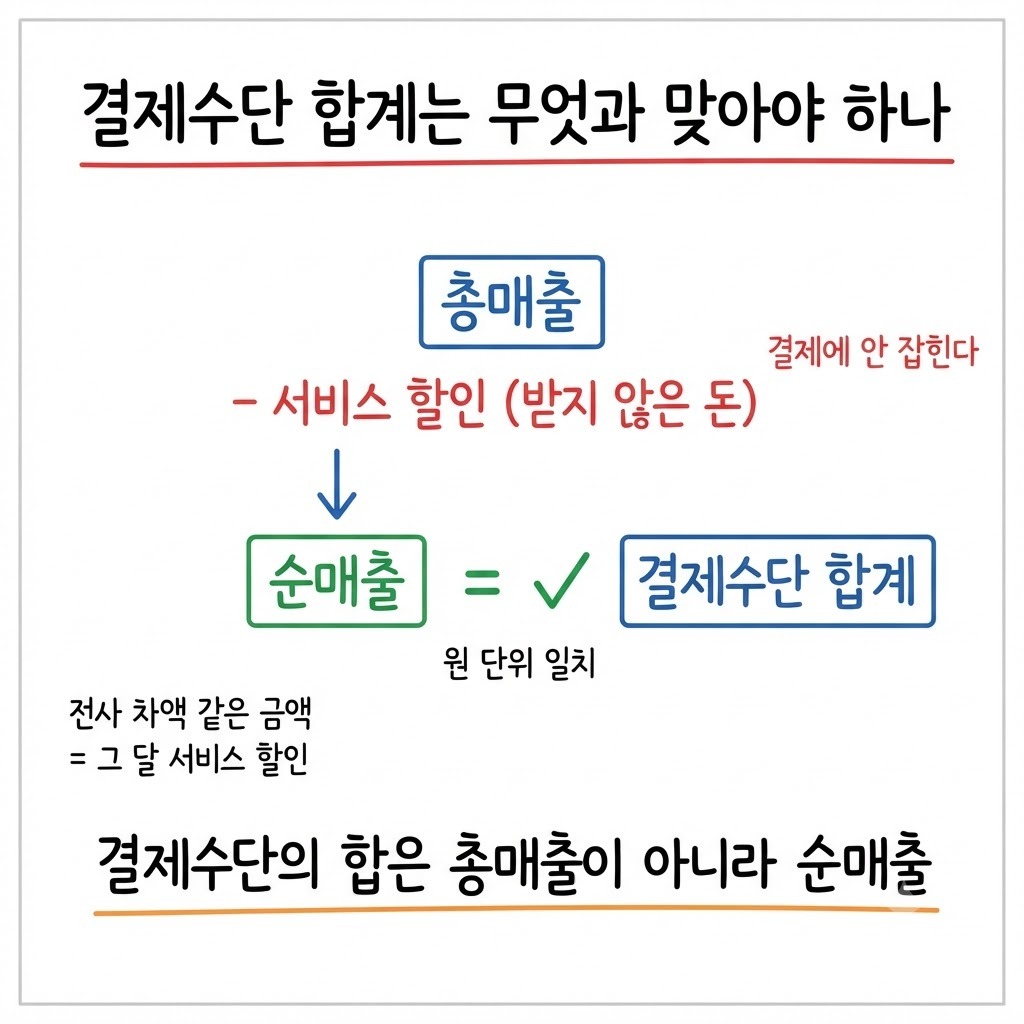
두 원천을 끝까지 맞춰 보는 대사 작업은 결과가 맞든 안 맞든 남는 것이 있습니다. 결제수단 합계를 전 매장에서 원 단위까지 맞춰 봤던 기록도 같은 축입니다.
거를 수 있나 — 속성이 어느 층에 붙어 있는지를 봤습니다
원인을 알았으니 다음 질문은 하나입니다. 그러면 우리도 부가를 빼고 보여줄 수 있나.
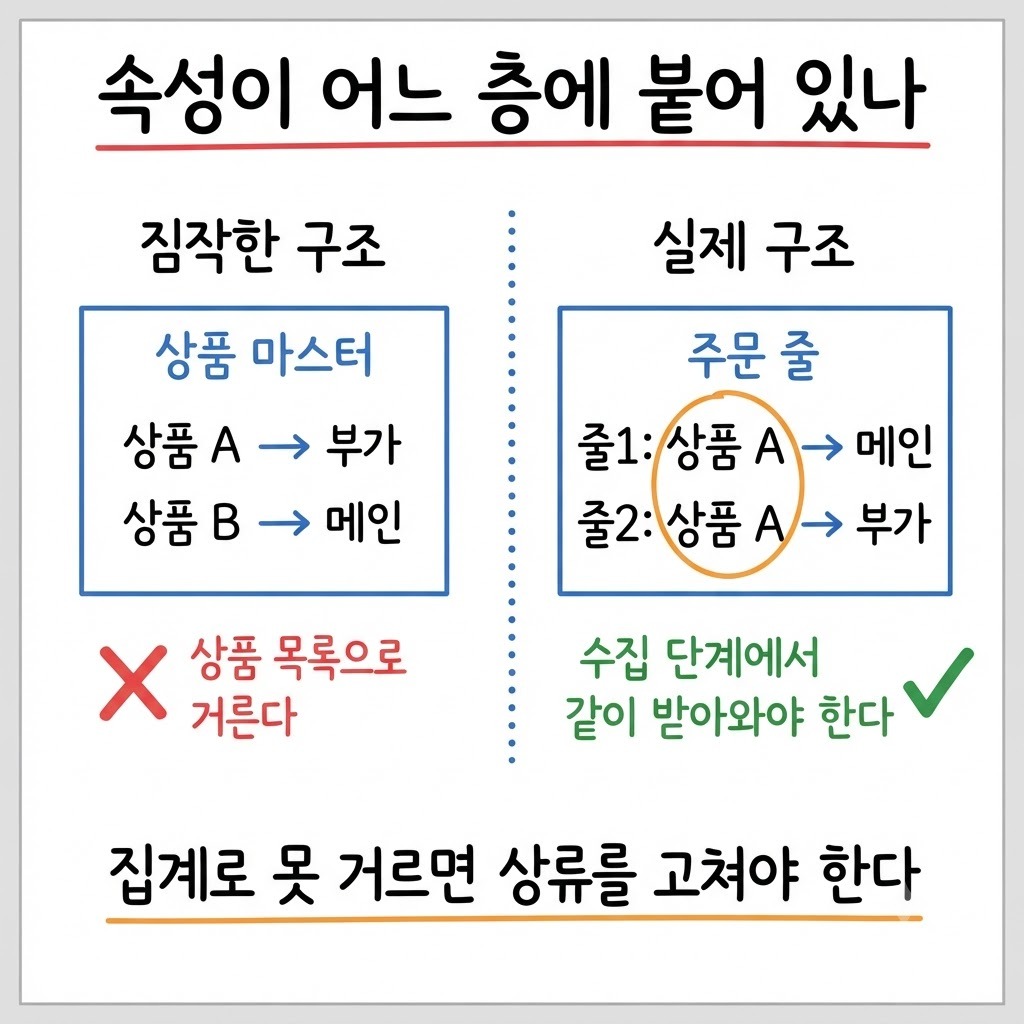
처음엔 상품 속성일 것이라고 짐작했습니다. 부가로 팔리는 상품 목록이 따로 있고, 그 목록에 든 상품 코드를 집계에서 빼면 될 것이라고 봤습니다. 아니었습니다. **부가 여부는 상품이 아니라 주문 줄마다 붙어 있었습니다.** 같은 상품 코드가 어떤 줄에서는 메인으로 팔리고 어떤 줄에서는 부가로 팔립니다.
이 차이가 결론을 바꿉니다. 속성이 상품에 붙어 있으면 우리가 이미 가진 집계에서 거를 수 있습니다. 주문 줄에 붙어 있으면 우리가 받은 집계에는 그 구분이 아예 실려 있지 않습니다. 거르려면 집계가 아니라 **수집 단계**를 고쳐서 그 구분을 같이 받아와야 합니다.
'이건 상품 속성이겠지'라고 넘기고 거르는 코드를 먼저 썼다면 반쯤 짜고 나서 막혔을 겁니다. 속성이 어느 층에 붙어 있는지는 구현을 시작하기 전에 확인할 것입니다.
숫자를 맞추는 것과 숫자를 설명하는 것은 다른 선택지입니다
선택지는 둘이었습니다.
선택지 | 내용 | 치르는 비용 |
|---|---|---|
숫자를 맞춘다 | 수집 단계부터 부가 구분을 받아와 우리 기본값도 '부가 제외'로 만든다 | 수집 파이프라인 수정. 과거 데이터 재수집 여부도 같이 판단해야 한다 |
숫자를 설명한다 | 집계는 그대로 두고, 이 수량이 어느 기준과 같은 수량인지를 화면에 적는다 | 도움말 문구 한 줄. 사용자가 그 문구를 읽어야 작동한다 |
설명하는 쪽을 골랐습니다. 이유는 두 가지입니다.
첫째, 우리 화면이 틀린 것이 아닙니다. 오히려 실제로 팔린 줄을 전량 보여주는 쪽이 매출 화면으로는 더 맞습니다. 상대 화면의 기본값을 따라가면 맞춘 것이 아니라 **근거 없이 줄인 것**이 됩니다. 나중에 '왜 옵션 줄이 빠져 있나'라는 질문이 반대 방향에서 올라옵니다.
둘째, 맞추려면 손대야 하는 곳이 집계가 아니라 수집입니다. 남의 화면 기본값과 같아 보이려고 치르기에는 큰 비용입니다.
그래서 총수량 머리칸에 도움말을 달았습니다. 이 수량이 전체 기준과 같은 수량이고, 부가 제외 기준으로 보면 4~5% 적게 나온다는 것을 적었습니다. 다음에 같은 질문이 오면 그 도움말이 대신 답합니다.
다만 이 선택이 항상 맞는 것은 아닙니다. 사용자가 두 화면을 **매일 나란히 놓고 대조하는 운영**이라면 설명보다 기준을 맞추는 쪽이 낫습니다. 매번 같은 질문이 다시 올라오기 때문입니다. 차이가 금액까지 닿았어도 도움말로 끝내지 않았을 겁니다. 0원 옵션이라 넘어간 것이지, 영향이 매출에 닿으면 수집을 고치는 쪽으로 갔어야 합니다.
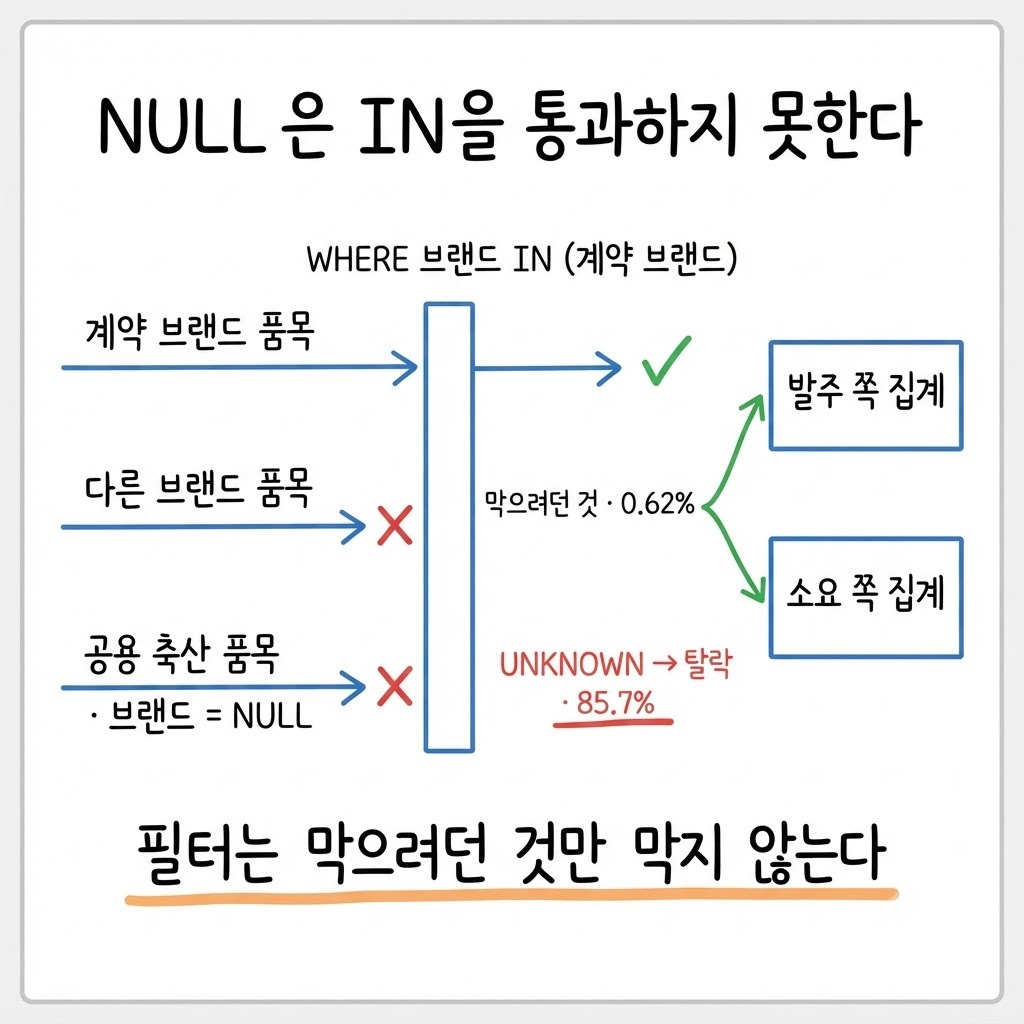
집계 조건 하나가 숫자를 바꾸는 자리는 여기만이 아닙니다. 막으려던 대상보다 같이 걸러진 쪽이 훨씬 컸던 필터 사례도 같은 축입니다.
추정으로 적어 둔 문장을 확인된 사실로 고쳤습니다
덤으로 나온 것이 하나 더 있습니다. 화면을 붙이던 전날, 아직 확인하지 않은 상태에서 '조회 기준 차이로 추정'이라고 적어 둔 문장이 두 자리에 남아 있었습니다. 화면 도움말과 코드 주석입니다.
확인이 끝난 김에 두 자리 다 확인된 사실로 고쳤습니다. 추정을 적어 두는 것 자체는 괜찮습니다. 아무것도 안 적어 두는 것보다 낫습니다. 다만 확인한 뒤에도 추정인 채로 두면 다음 사람이 같은 40분을 다시 씁니다. 그 사람은 그 문장이 이미 검증됐는지 알 방법이 없습니다.
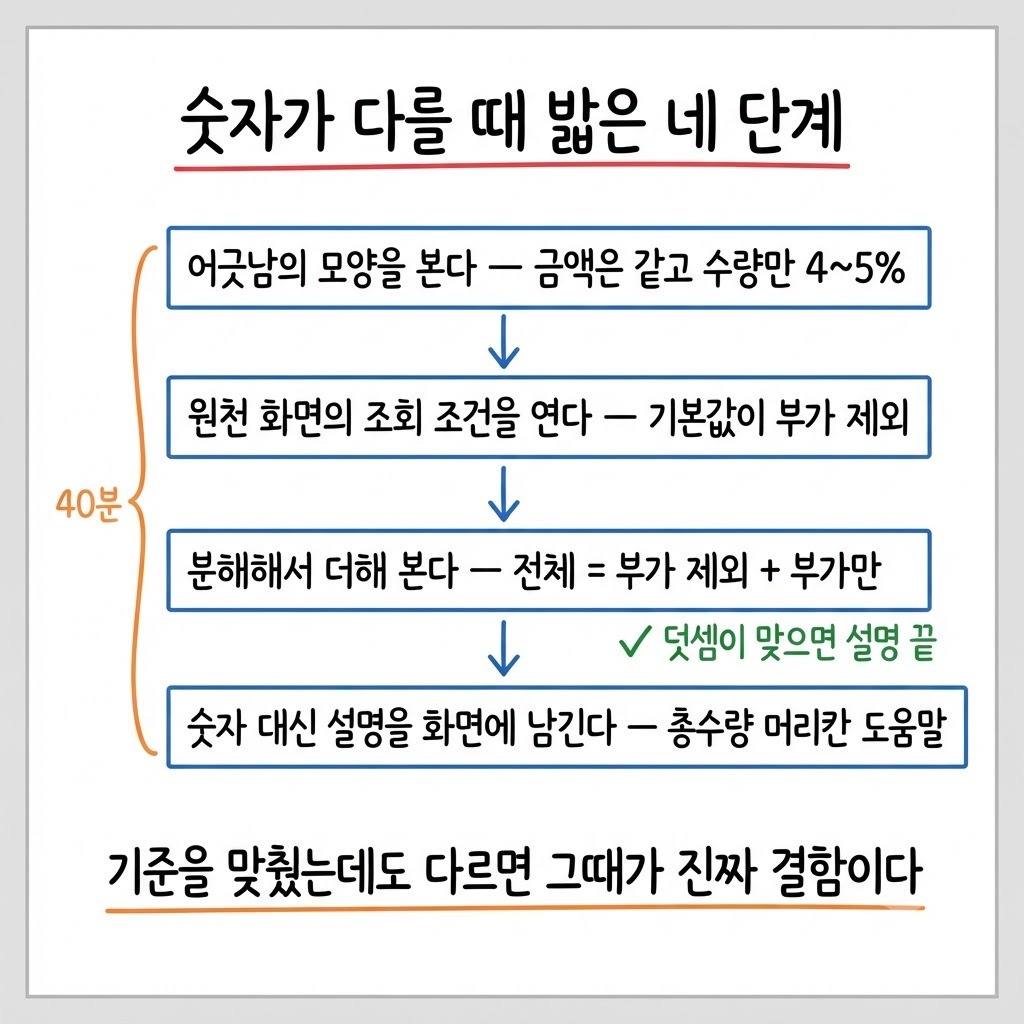
같은 상황을 만났을 때 보는 순서
두 시스템의 숫자가 다르다는 말을 들으면 아래 순서로 봅니다. 데이터를 뒤지는 것은 뒤쪽입니다.
어긋난 지표가 전부인지 일부인지 먼저 봅니다. 한쪽만 어긋나면 누락·중복이 아니라 필터입니다
양쪽 화면의 조회 조건 기본값을 각각 확인합니다. 기본값은 화면마다 다르고, 대개 아무도 안 건드린 채로 비교가 시작됩니다
가설이 섰으면 분해해서 더해 봅니다. 전체 = 부분 + 부분 이 맞으면 그 분류로 설명이 끝납니다
차이 줄의 성격을 봅니다. 금액은 맞고 수량만 다르면 0원 줄을 의심합니다
거를 수 있는지는 속성이 어느 층에 붙어 있는지로 갈립니다. 상품이 아니라 주문 줄에 붙어 있으면 상류를 고쳐야 합니다
맞출지 설명할지를 정합니다. 우리가 틀리지 않았다면 설명도 답입니다
확인이 끝나면 추정으로 적어 둔 문장을 찾아 고칩니다
마무리
두 화면의 숫자가 다를 때 가장 먼저 의심하게 되는 것은 자기 데이터입니다. 그 반사가 나쁜 것은 아닙니다. 다만 값을 대기 전에 기준을 먼저 대면 이번처럼 40분에 끝나는 경우가 있습니다.
그리고 기준을 맞췄는데도 숫자가 다르면, 그때가 진짜 결함입니다. 순서를 지키면 그 판단이 훨씬 빨라집니다.
이번 건에서 남은 것은 화면의 도움말 한 줄과 정정된 주석 두 자리입니다. 숫자는 하나도 안 바꿨습니다. 그래도 같은 질문이 다시 올라오지는 않았습니다.