서버 이전 중 받은 알림은 멀쩡한 기계에서 왔고, 멈춘 기계는 알림을 보낼 수 없었습니다
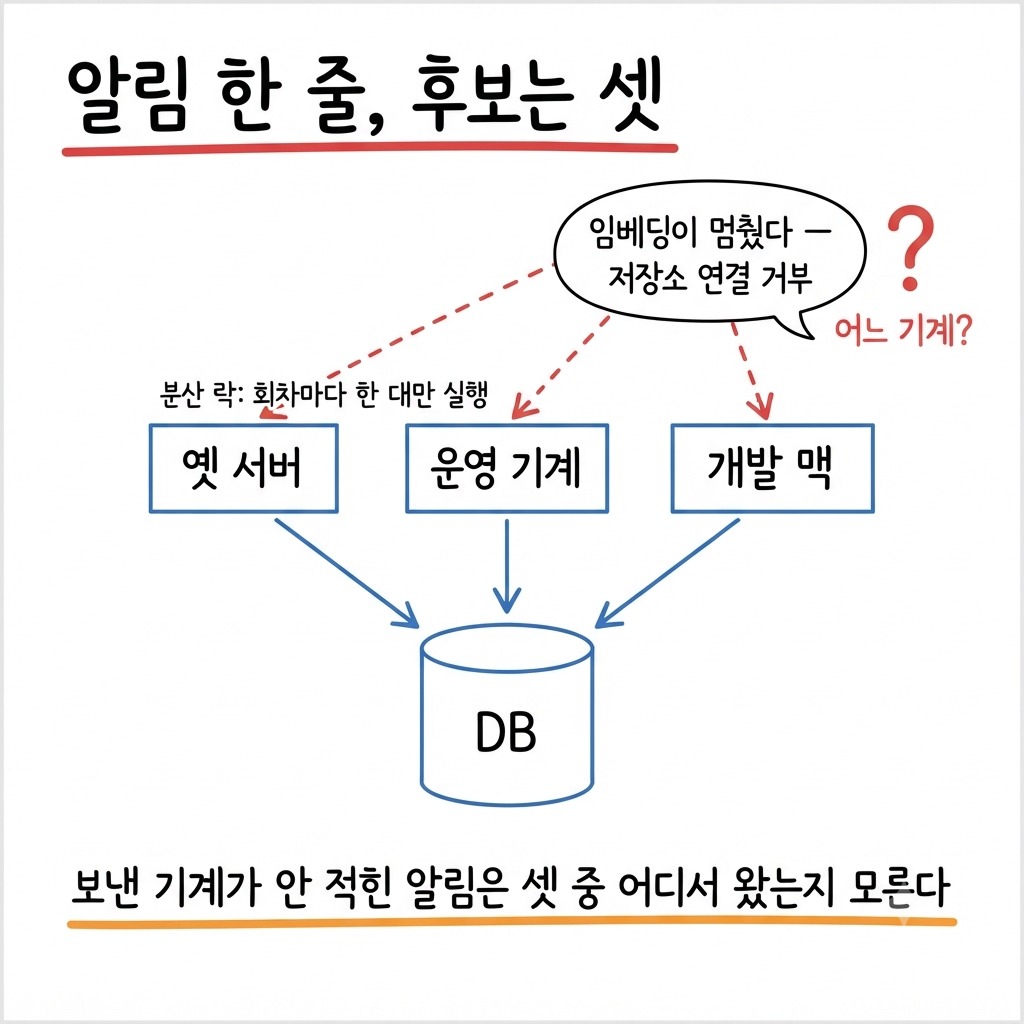
토요일 오후 4시 5분, 메신저로 알림 한 줄이 왔습니다. '임베딩이 멈췄다 — 저장소 연결 거부'. 내부 프로젝트 관리 도구가 매시간 실행하는 임베딩 배치가 실패했다는 내용이었습니다. 알림에는 어느 기계에서 실패했는지가 적혀 있지 않았습니다.
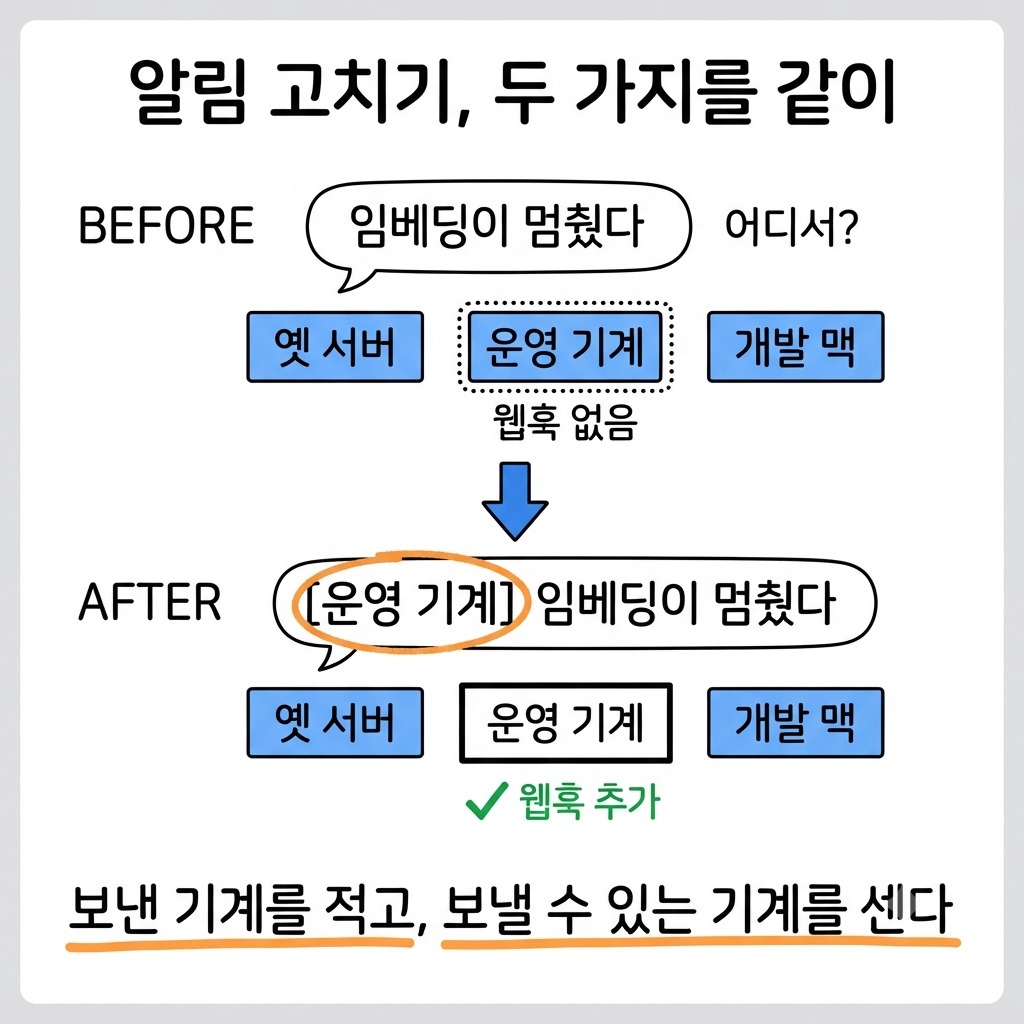
그 주에는 이 도구의 서버를 옛 클라우드 서버에서 새 운영 기계로 옮기는 중이었습니다. DB 는 옮기지 않고 그대로 쓰기로 해서, 옛 서버·운영 기계·개발 맥 세 대가 같은 DB 를 보는 상태가 며칠 이어졌습니다. 알림 한 줄로는 셋 중 어디서 온 것인지 구분할 수 없었습니다.
결론부터 적습니다. 알림을 보낸 기계는 원인이 가벼운 쪽이었습니다. 정말 멈춰 있던 기계는 알림을 보낼 설정이 없어서 아무 신호도 내지 않았습니다.
세 기계가 같은 DB 를 보던 며칠
이전 기간에 배치가 두 번 실행될 걱정은 하지 않았습니다. '분산 락'(여러 기계 중 한 대만 작업을 맡도록 남기는 잠금 기록)이 회차마다 한 기계만 배치를 실행하게 막아 주기 때문입니다. 실제로도 중복 실행은 한 번도 없었습니다.
문제는 중복이 아니라 출처였습니다. 세 기계 모두 같은 코드로 같은 문구의 알림을 만들었고, 알림 본문에는 보낸 기계를 구분할 칸이 없었습니다. 기계가 한 대일 때는 필요 없던 칸이 이전 기간에만 필요해졌습니다.
보낸 기계는 락 기록에 남아 있었다
보낸 기계를 찾은 단서는 분산 락 표였습니다. 이 표에는 회차마다 락을 잡은 기계의 이름이 적힙니다. 알림이 난 회차의 그 칸에는 개발 맥이 적혀 있었습니다.
옛 서버는 그날 재부팅한 뒤로 해당 프로세스가 떠 있지 않았고, CI 배포 작업도 꺼져 있었습니다. 그래서 후보에서 바로 빠졌습니다. 락은 중복 실행을 막으려고 둔 장치였는데, 그 회차를 어느 기계가 실행했는지 남기는 기록 역할도 하고 있었습니다.
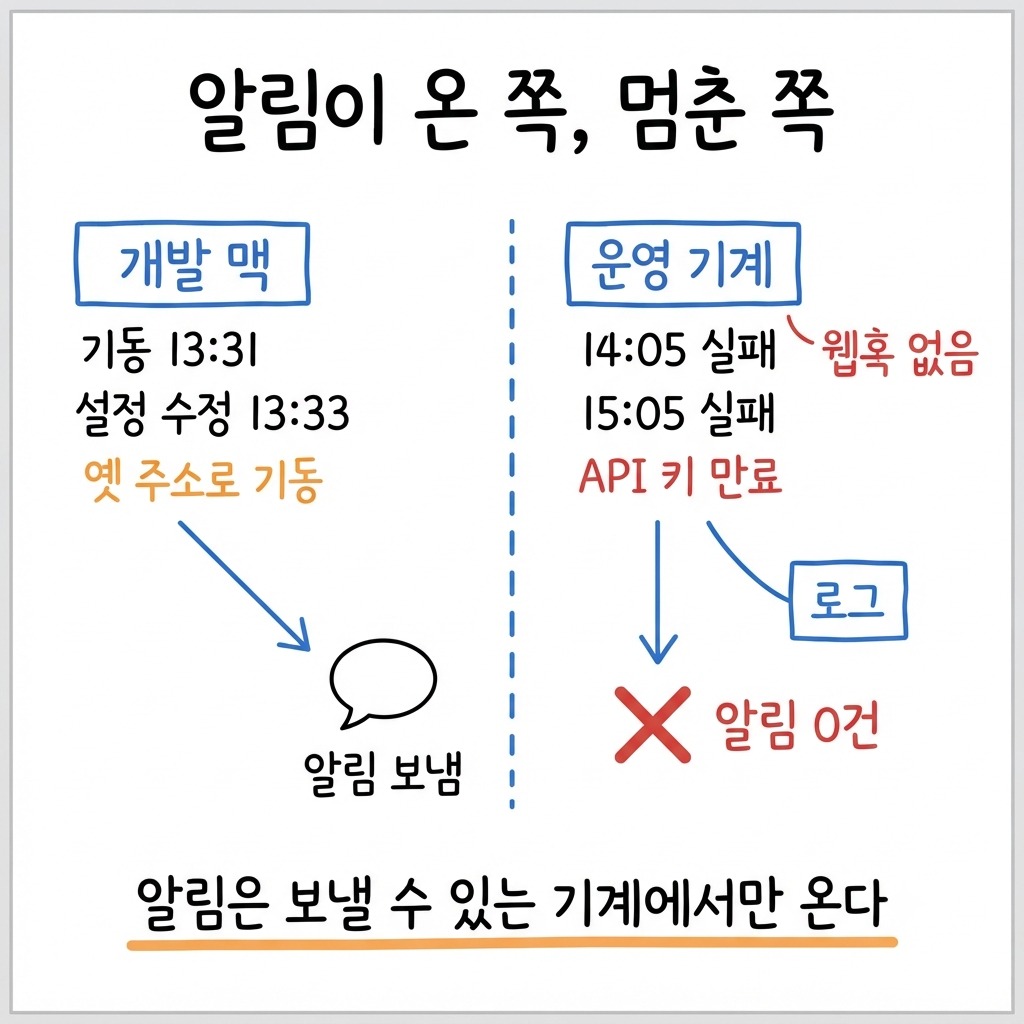
개발 맥의 원인은 2분 차이였습니다.
13:31 — 개발 맥에서 AI 서버 기동
13:33 — 설정 파일의 저장소 주소 수정
결과 — 서버는 고치기 전의 옛 주소로 떠 있었음
벡터 저장소 자체는 정상이었습니다. 저장소에 직접 요청을 보내 보니 200 으로 응답했습니다. 알림은 사실을 말하고 있었고, 그 대상이 개발 기계였을 뿐입니다.
알림이 오지 않은 기계를 따로 열어 봤다
여기서 개발 맥만 재시작하고 끝냈다면 장애 하나가 그대로 남았을 겁니다. 알림이 개발 맥에서 왔다는 사실이 다른 기계가 정상이라는 뜻은 아니었습니다. 그래서 운영 기계의 로그를 따로 열었습니다.
운영 기계는 별개로 멈춰 있었습니다. 14시 5분과 15시 5분, 두 회차의 임베딩이 모델 API 키 만료로 실패해 있었습니다. 그 기계에는 메신저 웹훅 설정이 빠져 있었습니다. 그래서 실패가 로그에만 남고 알림은 한 줄도 나가지 않았습니다.
정리하면 이렇습니다. 알림이 온 기계는 설정을 2분 늦게 반영한 개발 기계였습니다. 알림이 오지 않은 기계가 실제 서비스를 맡은 운영 기계였고, 두 회차째 임베딩을 만들지 못하고 있었습니다.
화면이나 로그에는 문제가 남아 있는데 그 사실을 사람에게 전하는 경로가 없으면, 아무도 모르는 채로 시간이 지납니다. 비슷한 일을 다른 자리에서도 겪었습니다.
세 가지를 한 번에 고쳤다
고친 것 | 무엇을 | 이유 |
|---|---|---|
API 키 교체 | 새 키로 직접 요청해 200 응답을 확인한 뒤 교체, 바꾼 설정 파일은 백업 | 운영 기계가 멈춘 직접 원인 |
웹훅 설정 추가 | 운영 기계 설정에 메신저 웹훅 추가 | 알림을 못 보내는 기계의 장애는 로그에만 남는다 |
알림에 보낸 기계 이름 | 사고·공지·복구 알림 세 종류 전부 | 한 종류에만 넣으면 다음에 같은 질문이 또 나온다 |
양쪽을 재시작하자 '웹훅 미설정' 로그가 사라졌고, 검색과 임베딩 상태가 정상으로 표시됐습니다. 임베딩이 빠진 기록 10건이 남았습니다. 매시 5분에 실행되는 배치가 빠진 것만 한 번에 50건씩 자동으로 채우므로 따로 손대지 않았습니다.
고친 것과 적용된 것은 따로 적어 둡니다. 알림에 기계 이름을 붙이는 코드는 그날 고쳤습니다. 하지만 운영 기계의 빌드 반영은 수동이라 그날 바로 적용하지 못했습니다.
알림이 없는 것은 정상의 증거가 아니다
알림은 보낼 수 있는 기계에서만 옵니다. 웹훅이 없는 기계는 가장 심하게 멈췄을 때도 아무 신호를 내지 않습니다. '오늘 알림이 없었으니 괜찮다'는 판단은 모든 기계에 웹훅이 설정돼 있을 때만 맞습니다.
알림이 오지 않는 시간이 길어질수록 그 침묵을 정상으로 읽기 쉬워집니다. 실패 알림이 한 통도 없었는데 실제로는 오래 실패하고 있던 사례가 있습니다.
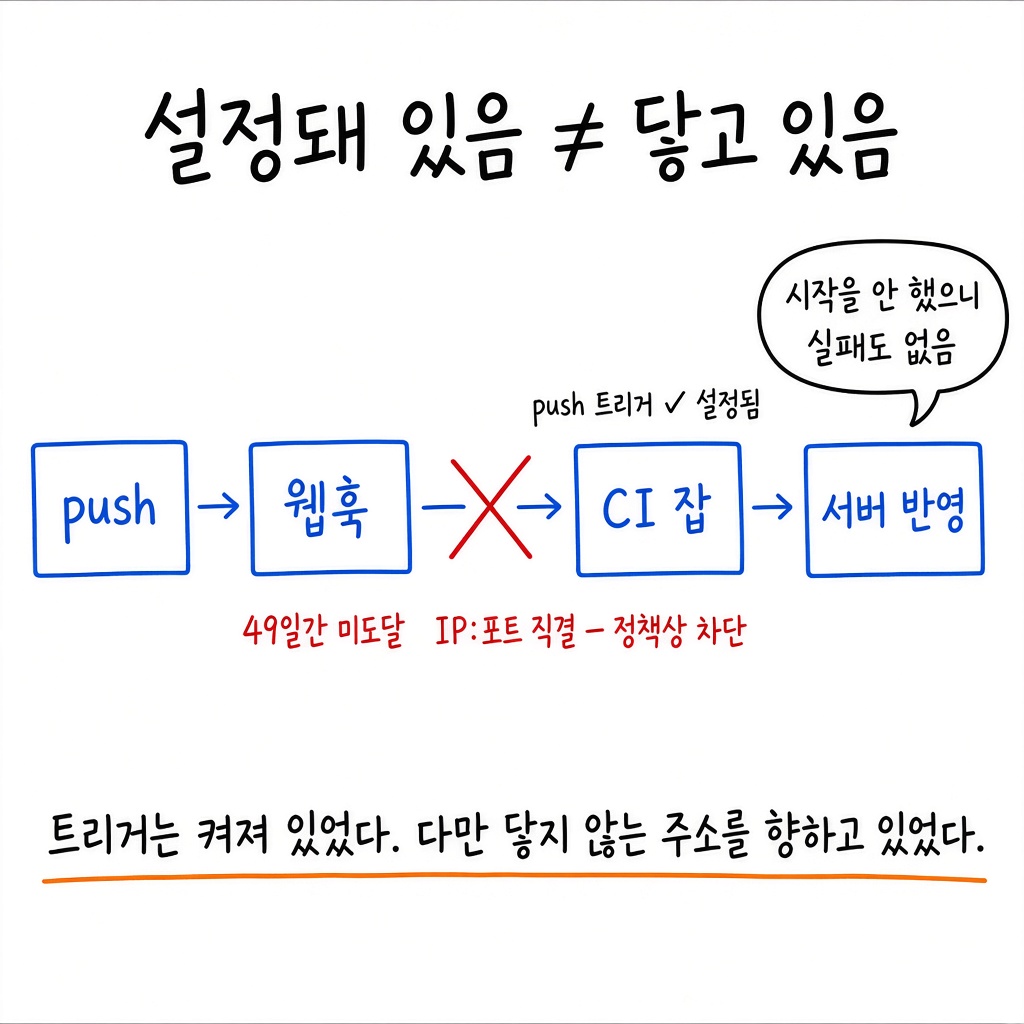
알림에 기계 이름을 넣는 것만으로는 이 구멍이 메워지지 않습니다. 이번 일의 더 큰 원인은 이름이 없던 것이 아니라 웹훅이 없던 기계였습니다. 알림 본문만 고치고 알림을 보낼 수 있는 기계가 몇 대인지 세지 않으면 같은 일이 다시 납니다.
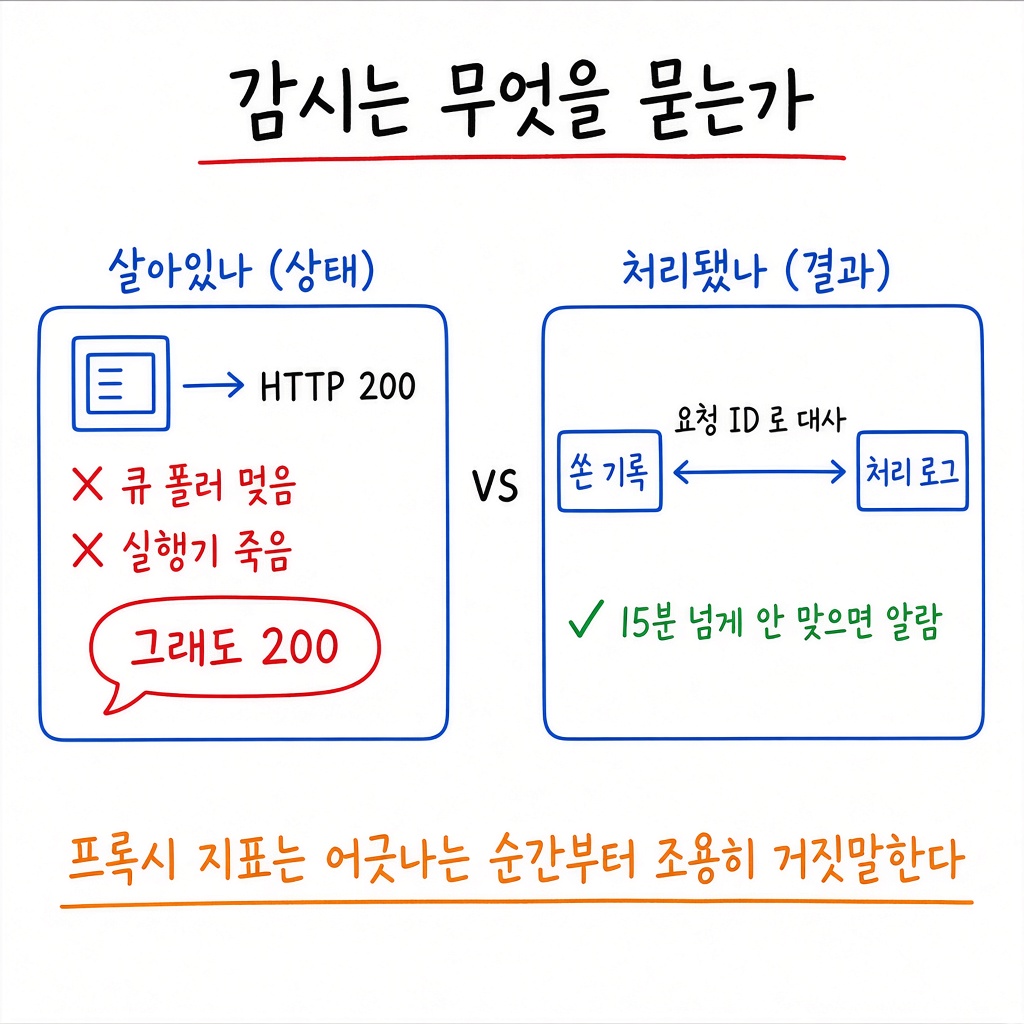
안이 멈추면 안에서 나오는 알림도 같이 멈춥니다. 그래서 알림을 못 보내는 기계를 잡으려면 밖에서 주기적으로 상태를 확인하는 감시(외부 헬스체크·주기 신호)가 따로 있어야 합니다. 다만 그 감시도 '살아 있느냐'만 물으면 프로세스는 떠 있는데 배치가 멈춘 상태는 보지 못합니다.
외부 헬스체크가 무엇을 묻고 무엇을 묻지 않는지는 따로 정리한 적이 있습니다.
서버를 옮기는 기간에 점검할 것
기계가 한 대뿐이라면 알림에 기계 이름을 붙이는 것은 잡음에 가깝습니다. 하지만 서버 이전·증설·개발 기계 연결처럼 둘 이상이 같은 DB 를 보는 기간은 생각보다 자주 옵니다. 그 기간에는 아래를 확인합니다.
같은 DB·큐·저장소를 보는 기계가 지금 몇 대인지 센다
그중 알림을 보낼 수 있는 기계가 몇 대인지 따로 센다. 두 숫자가 다르면 모자란 기계부터 설정한다
알림 본문에 보낸 기계를 적는다. 호스트명이 민감한 환경이면 운영·예비·개발 같은 역할 이름으로 적는다
회차마다 어느 기계가 실행했는지 남는 기록(분산 락 표 등)이 있는지 확인한다
임시 구성은 끝나는 날짜가 아니라 끝나는 조건(옛 기계 프로세스 종료·개발 기계 연결 해제)으로 관리한다
이번 일에서 알림은 틀린 말을 하지 않았습니다. 어디서 왔는지 적혀 있지 않았고, 알림이 오지 않은 기계를 의심할 계기가 없었을 뿐입니다. 저는 이제 여러 기계가 같은 DB 를 보는 기간에는 알림이 온 기계보다 알림을 보낼 수 없는 기계를 먼저 확인합니다.