'사용 한도에 걸렸습니다'가 LLM 답변으로 저장되고 있었습니다 — 148건 중 20건, 응답은 전부 200
사내 제안서 지식검색 도구의 채팅 답변을 148문항 전수로 채점하던 중이었습니다. 한 회차 결과를 훑다가 답변 칸에 같은 문장이 반복되는 것을 봤습니다. '지금은 사용 한도에 걸려 잠시 뒤 다시 시도해 주세요'였습니다.
148건 중 20건이 그 안내문이었습니다. 채점표에는 이미 '답변 있음'으로 들어가 있었습니다. HTTP 응답은 20건 전부 200 이었고, 채점 스크립트는 상태 코드로 성공을 갈랐습니다. 답변을 읽는 사람에게도 목록에서 그 20건을 골라낼 표식이 없었습니다.
실패가 답의 모습을 하고 DB 에 저장돼 있었습니다. 이 글은 그 안내문이 어느 채널로 나갔는지, 그리고 왜 아무도 못 골라냈는지에 대한 기록입니다.
한도가 왜 찼는지를 글자 수로 추정하고 있었습니다
답변 생성은 ChatGPT 구독으로 쓰는 코덱스의 REST 창구를 씁니다. 그 구독은 5시간 창과 7일 창, 두 한도가 따로 돌고 한쪽만 차도 막힙니다. 148문항을 여러 회차 돌리면 한도에 걸리는 일이 잦았습니다.
'왜 찼나'를 알 방법이 없다고 생각했습니다. 질문당 글자 수를 세어 토큰을 추정하고, 회차 사이에 시간을 띄우는 식으로 대응했습니다. 창구가 토큰 수를 안 준다는 결론을 확인 없이 들고 있었습니다.
한도에 걸리면 서버는 사용자에게 안내문을 내보냈습니다. 화면에서는 자연스럽게 보였습니다. 그 안내문이 어느 채널로 나가는지는 아무도 보고 있지 않았습니다.
헤더를 전부 출력하는 데 2분이 걸렸습니다
창구를 한 번 직접 치고 응답 헤더를 전량 출력했습니다. 두 창의 사용 비율과 리셋 시각이 매 호출 헤더에 실려 오고 있었습니다. 추정할 필요가 없는 값이었습니다. '토큰 수를 알 방법이 없다'는 결론은 헤더를 안 열어본 상태에서 나온 것이었고, 뒤집는 데 2분이 걸렸습니다.
뿌리는 스트리밍 처리 코드에 있었습니다. SSE 로 오는 이벤트 중 본문 델타 이벤트 하나만 읽고, 나머지 이벤트와 응답 헤더를 통째로 버리고 있었습니다. 필요한 값이 매 호출 오고 있었는데, 안 보니 없는 것과 같았습니다.
그 계측을 붙이면서 스트리밍 경로를 다시 읽다 20건의 원인을 찾았습니다. 한도 안내문이 본문 토큰과 같은 이벤트 종류로 나가고 있었습니다. 본문은 토큰 조각 이벤트로 흘러가고, 조각이 모여 답변이 되고, 그 답변이 대화 기록에 저장됩니다. 안내문도 같은 파이프를 타니 조각이 모여 '답변'이 되고 그대로 저장됐습니다.
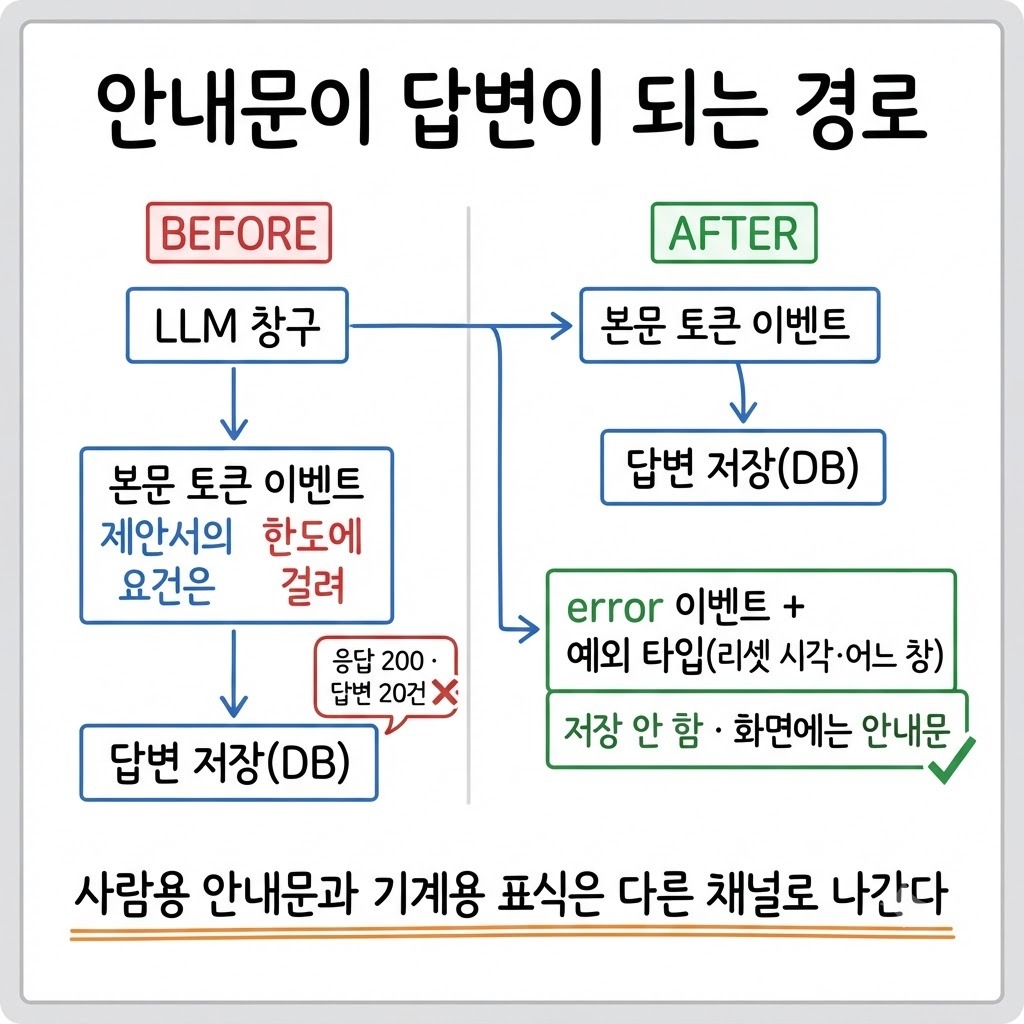
200 은 첫 바이트가 나갈 때 이미 확정됩니다
스트리밍 응답에서 상태 코드는 첫 바이트가 나갈 때 정해집니다. 그 뒤 스트림 안에서 한도에 걸리든 모델이 빈 답을 내든 코드는 바뀌지 않습니다. 응답 코드 200 은 '연결이 열렸다'까지만 말하고, 답의 품질은 말하지 않습니다.
같은 형태의 버그가 같은 경로에서 셋 연달아 나왔습니다.
버그 | 실제로 일어난 일 | 밖에서 보인 모양 |
|---|---|---|
빈 답이 성공으로 저장 | 모델이 아무것도 안 냈다 | 정상 저장 · 200 |
안내문이 답으로 저장 | 사용 한도에 걸렸다 | 답변 20건 · 200 |
한도 판정이 문자열 매칭 | 창구가 에러 문구를 바꿨다 | 원인 없는 500 |
셋 다 '실패인데 실패의 모양이 아니다'입니다. 빈 답 건은 앞선 회차에서 한 건이 성공으로 남아 있는 것을 찾아 먼저 고쳤습니다. 저장하지 않고 error 이벤트를 보내도록 바꿨습니다.
한도 판정은 429 를 '예외 문자열에 특정 낱말이 들어 있나'로 골라내고 있었습니다. 창구가 문구를 바꾸는 순간 조용히 안 걸리고, 그때 밖으로 나오는 것은 500 입니다. 500 만 보고는 한도 때문인지 알 길이 없습니다.
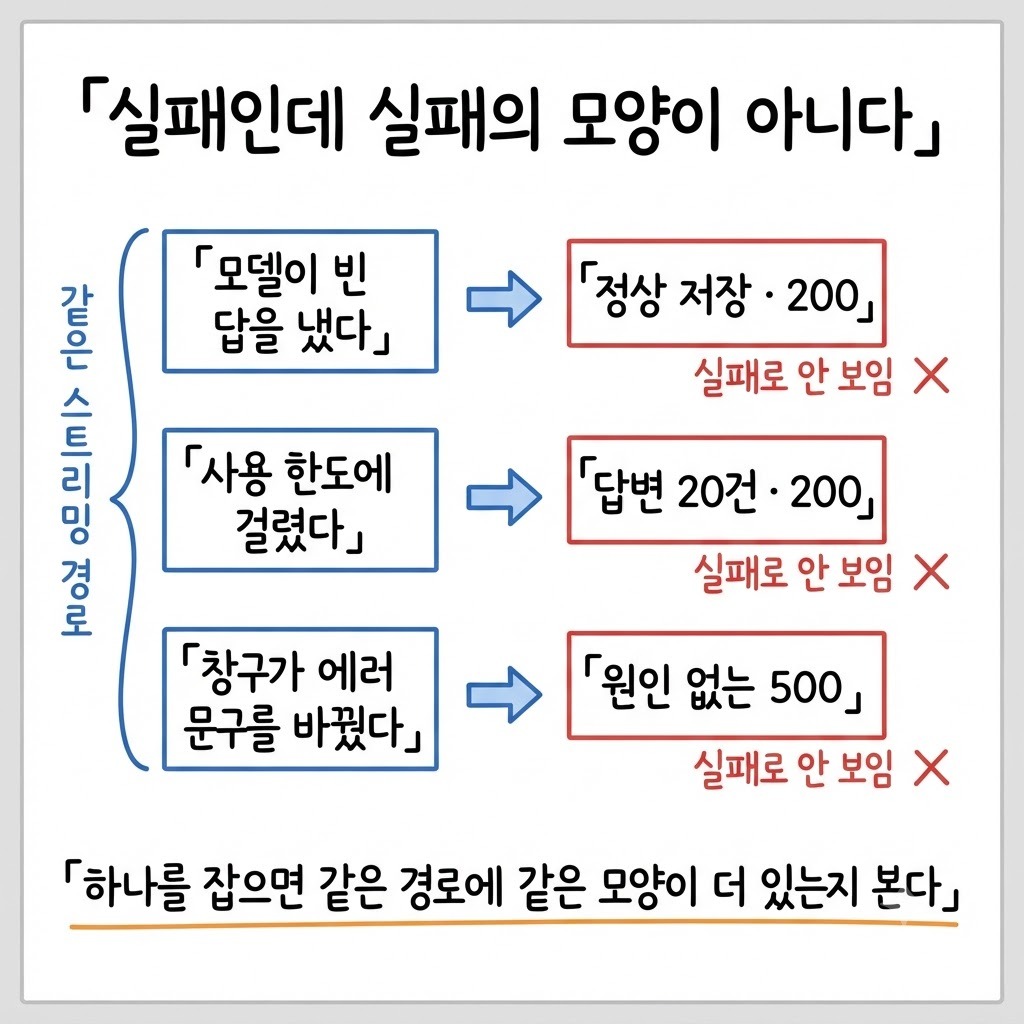
고친 것 셋 — 안내문과 표식을 갈랐습니다
원칙은 하나였습니다. 사람에게 보일 안내문과 기계가 읽을 표식은 다른 채널로 나가야 합니다. 안내문만 보내면 실패가 답의 모습을 갖습니다. 그 원칙으로 셋을 고쳤습니다.
429 를 타입 있는 예외로 올립니다. 문자열 매칭 대신 예외 타입에 리셋 시각과 어느 창이 찼는지를 싣습니다. 부르는 쪽은 문구가 아니라 타입으로 판정합니다.
한도가 차면 별도 API 키로 쓰는 다른 제공자의 모델로 한 번 더 시도합니다. 같은 구독 안에서 모델만 바꾸면 한도를 같은 통에서 쓰는 셈이라 의미가 없습니다.
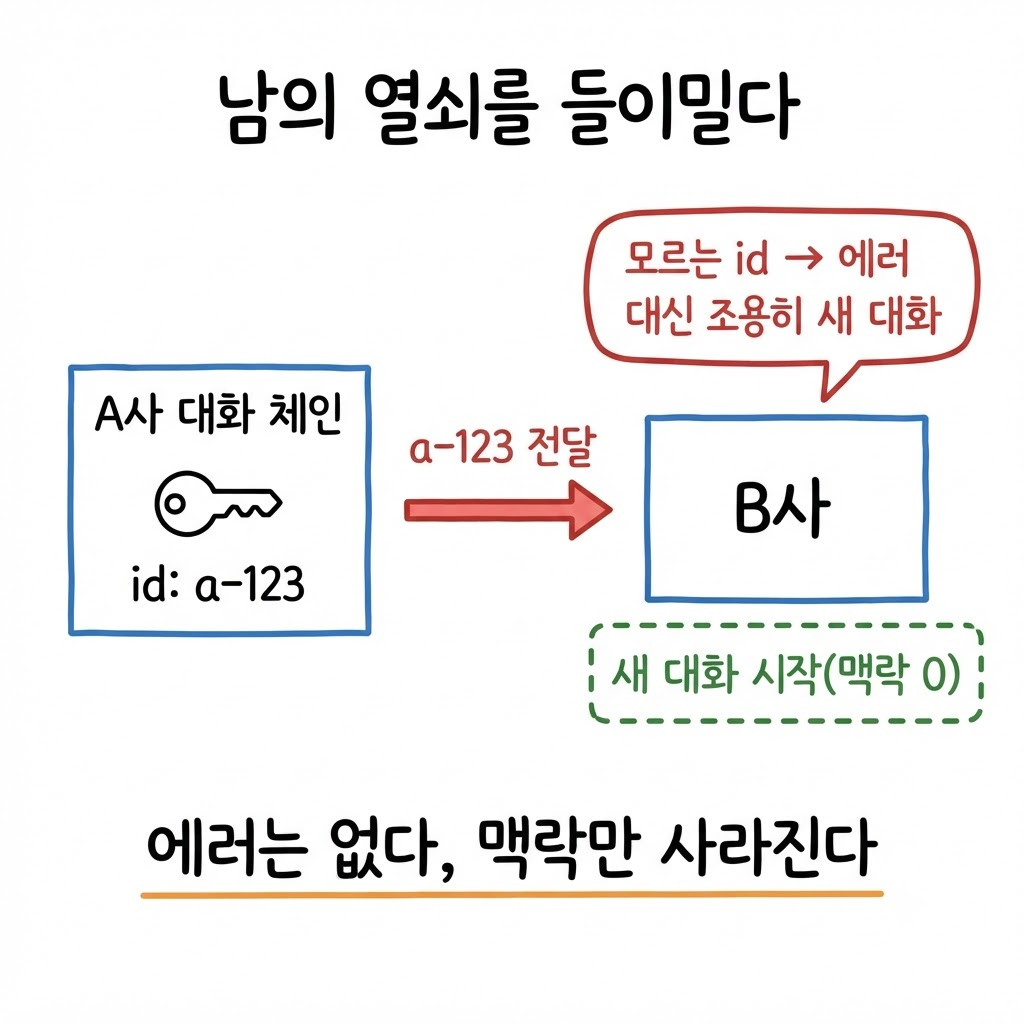
폴백으로 약한 판이 답하면 응답에 '품질이 내려간 답'이라는 표식을 붙입니다. 조용히 바꾸면 품질이 내려간 것을 아무도 모릅니다.
세 번째가 가장 쉽게 빠지는 자리입니다. 폴백은 대개 '어떻게든 답을 내자'로 붙이는데, 그 답이 왜 나빴는지를 나중에 추적하려면 어느 모델이 답했는지가 응답에 남아 있어야 합니다. 에러 로그는 0건인데 답이 나빠졌다는 신고가 오면 대개 이 자리입니다.
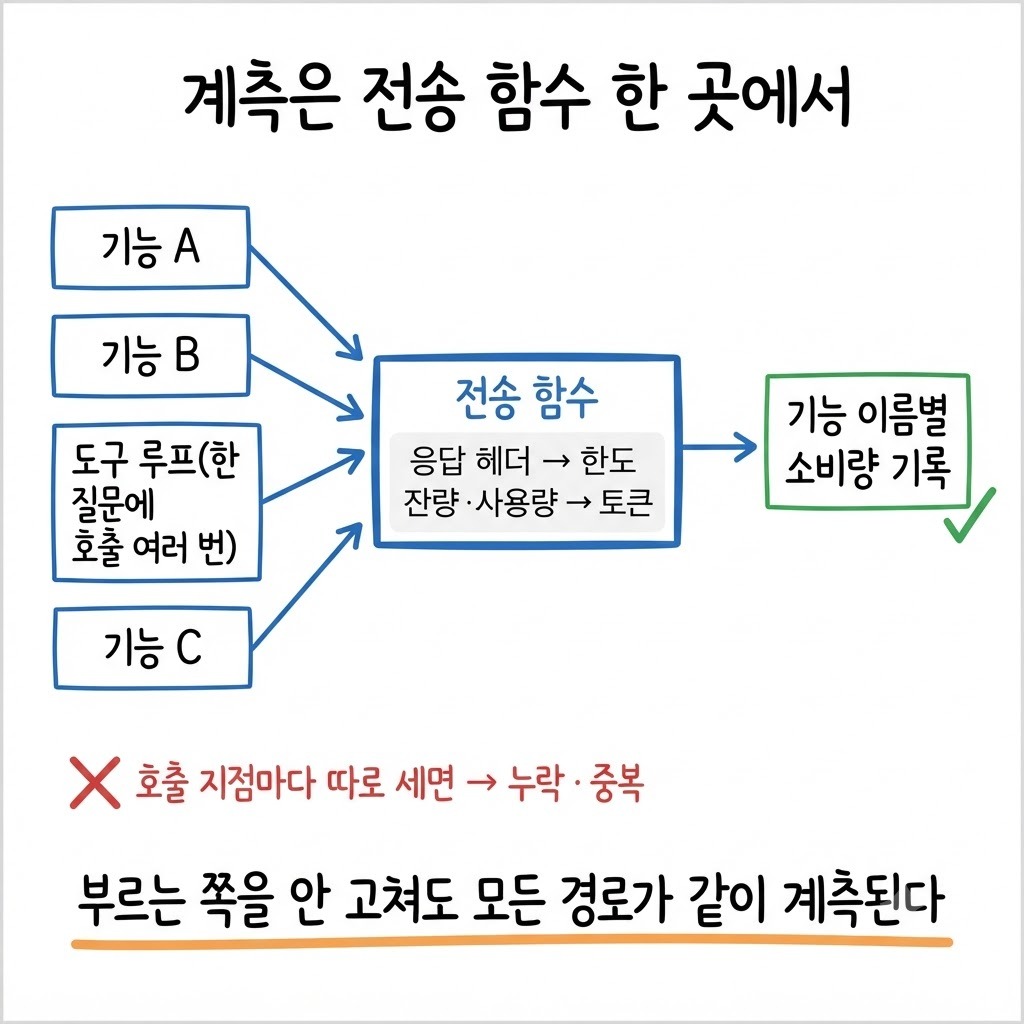
계측도 같이 붙였습니다. 한도 잔량과 토큰 사용량을 전송 함수 한 곳에서 줍습니다. 부르는 쪽을 안 고쳐도 모든 경로가 같이 계측됩니다. 도구 루프처럼 한 질문에 호출이 여러 번 생기는 경로에서 빠뜨리거나 두 번 세는 것을 막는 배치입니다.
소비량은 '어느 기능이 불렀나' 단위로 쌓습니다. 호출 지점이 그 이름으로 LLM 인스턴스를 만들므로 이미 알고 있는 값입니다. 5시간 창이 찼을 때 어느 기능이 얼마를 썼는지가 이제 추정이 아니라 기록으로 남습니다.
채점표도 고쳤습니다. '답변 있음' 20건은 사실 '못 쟀음'이었습니다. 측정 결과를 해석할 때 그 20건을 분모에서 뺐습니다. 안 빼면 정답률이 실제보다 낮게 나오고, 낮은 이유를 엉뚱하게 검색 품질에서 찾게 됩니다.
표식을 읽는 곳이 없으면 표식이 아닙니다
채널을 갈랐다고 끝나지 않습니다. '그럴듯한 오답'은 여전히 200 으로 옵니다. 서버 쪽 처방은 실패를 실패로 보이게 하는 것까지이고, 재는 쪽은 서버를 믿지 말고 본문을 봐야 합니다.
안내문을 본문에 보이는 것 자체가 틀린 것은 아닙니다. 사용자 화면에 안내를 자연스럽게 띄우려면 본문 자리에 문장이 들어가야 합니다. 틀린 것은 '그것만 있고 표식이 없는 것'입니다.
표식을 붙여도 채점 스크립트·화면·저장 로직 중 어느 하나가 그 값을 실제로 보지 않으면 없는 것과 같습니다. 본문 검사도 완벽하지 않습니다. 안내문 문구가 바뀌면 다시 못 잡습니다. 서버가 표식을 주는 쪽이 원천이고, 본문 검사는 이중 방어입니다.
성공률은 표식이 붙은 답의 비율로 잽니다
스트리밍 답변에서 실패가 본문 토큰과 다른 이벤트로 나가는가
에러 판정을 문자열이 아니라 상태 코드·예외 타입으로 하는가
폴백으로 답한 응답에 그 사실이 표식으로 남는가
채점·측정 스크립트가 상태 코드가 아니라 본문을 검사하는가
새 창구를 붙일 때 첫 호출에서 응답 헤더 전량과 이벤트 종류를 한 번 덤프했는가
이번 일에서 가져간 계측 기준은 한 줄입니다. 성공률은 응답 코드 200 의 비율이 아니라, 기계가 읽을 표식이 붙은 답의 비율로 잽니다. 표식이 없는 200 은 성공으로 세지 않습니다. 그 기준으로 다시 세니 148문항 중 실제로 답한 것은 128건이었습니다.
새 창구를 붙일 때 첫 호출의 헤더 전량과 이벤트 종류를 한 번 덤프해 두는 것이 그 기준을 지키는 가장 싼 방법입니다. 이번에는 필요한 값이 이미 거기에 와 있었고, 안 보고 있었을 뿐입니다.
연작 '토큰은 어디로 갔나'
이 글은 다섯 편 중 5편입니다. 구독 LLM 을 운영하며 한도·토큰·인증이 어디서 새고 어디서 안 보였는지를 이어서 다룹니다.