분류 모델 Jev 가 못하는 것— 답이 컬럼에 있으면 규칙이 이깁니다
운영하는 두 시스템에 요즘 핫한 Jev 분류 모델을 대봤습니다. 하나는 사내 문서 지식그래프 검색 도구이고, 다른 하나는 채권 분석 시스템입니다. 앞쪽에서는 모델이 관문으로 값을 냈습니다. 뒤쪽에서는 모델이 들어갈 자리 자체가 없었습니다.
왜 한쪽은 되고 한쪽은 안 됐는지를 정리하다가 「텍스트냐 정형 데이터냐」라는 익숙한 구분선이 틀렸다는 결론에 닿았습니다. 갈림선은 형식이 아니라 「입력만 보면 답이 이미 정해지는가」였습니다.
앞선 실험 — 판단이 갈리는 텍스트에서는 관문이 됐습니다
배경이 되는 실험부터 한 문단으로 요약합니다. 사내 문서 지식그래프 검색 도구에서 문서 종류와 저자 편(우리 문서인지, 발주처나 다른 수행사의 문서인지)을 분류하는 자리에 분류 전용 모델 Jev(TypeSafe 의 분류 전용 모델로, 판정과 함께 확신도를 돌려줍니다)를 붙여 실측했습니다.
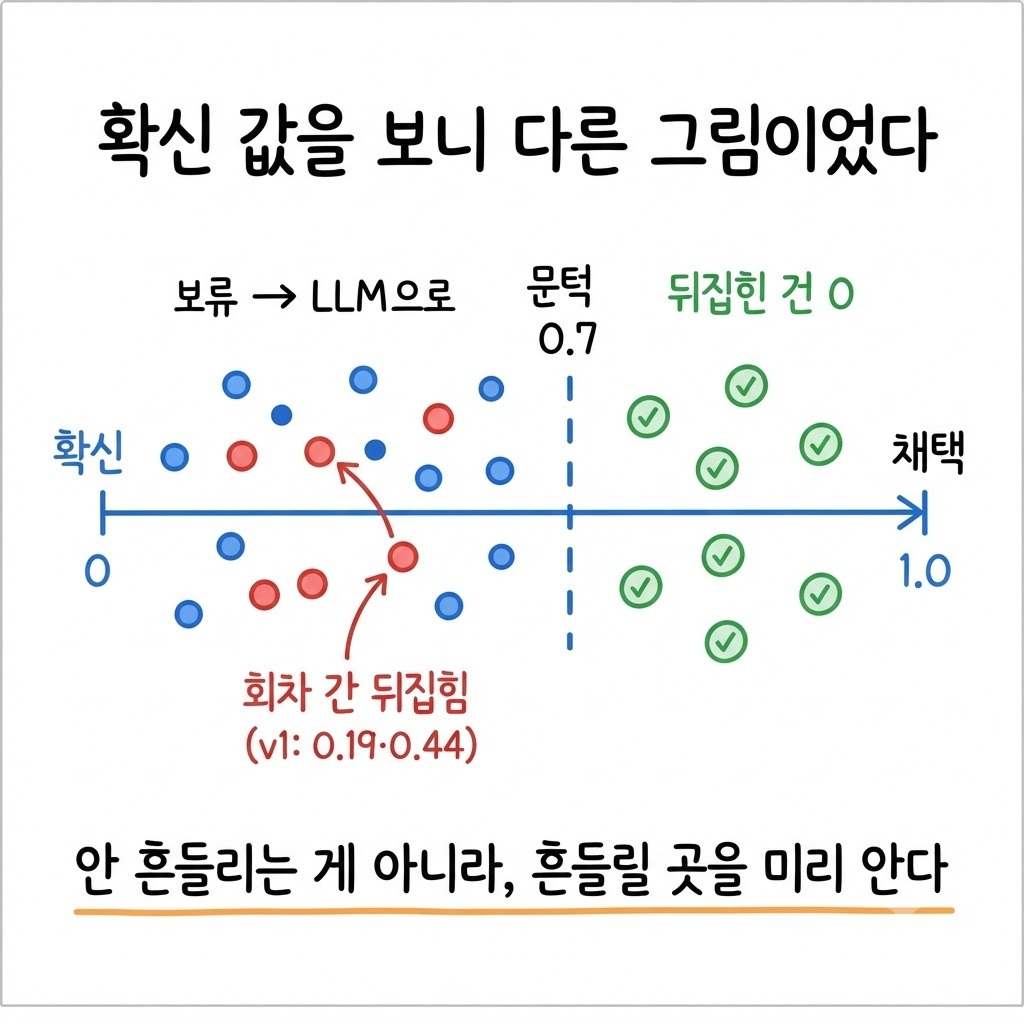
이 분류는 원래 흔들리던 판단이었습니다. 같은 모델을 두 번 돌려도 88%만 일치했습니다. Jev 는 확신도가 낮은 건에서만 실제로 회차가 흔들렸습니다. 그래서 확신 0.7 이상만 채택하는 관문으로 걸었더니, 채택된 건에서 오답이 0건이었습니다. 수치 표와 세부는 아래 글에 있습니다.
이 결과에 고무되어 Jev 를 어디까지 넓혀 쓸지 검토했습니다. 첫 후보가 같은 팀이 운영하는 B2B 채권 분석 시스템의 상각 원장 판정이었습니다. 문서 분류에서 오답 0건을 냈으니, 판정 로직이 많은 쪽에도 자리가 있을 것으로 봤습니다.
옆 시스템에 대보니 들어갈 자리가 없었습니다
상각 원장(상각 스케줄을 행 단위로 기록한 장부)의 판정은 각 행이 정상인지, 조치가 필요한지를 가르는 일입니다. 조치가 필요한 쪽은 다시 네 방향으로 갈립니다.
실효 — 약정이 효력을 잃은 행
재조정 — 조건이 다시 잡힌 행
수익률 상하한 — 수익률이 허용 범위를 벗어난 행
어긋난 원장 — 스케줄과 기록이 맞지 않는 행
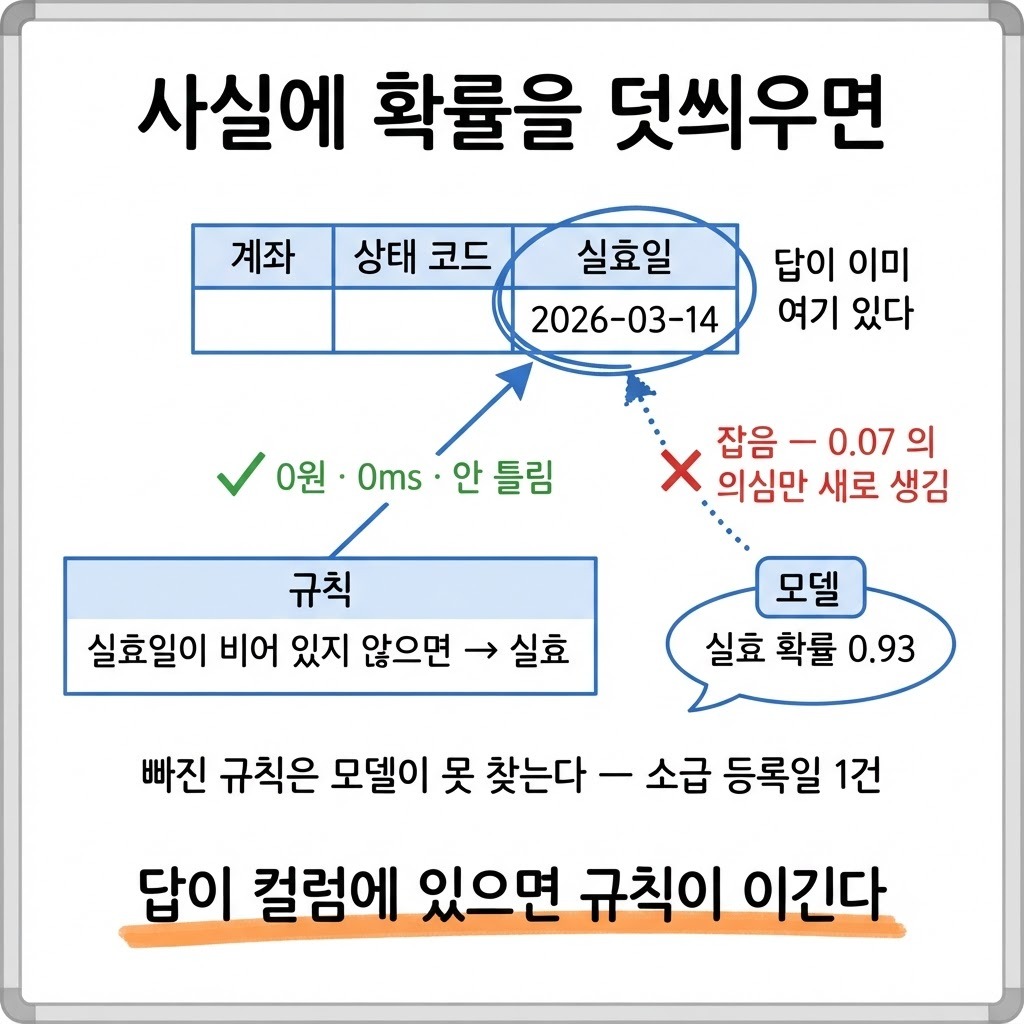
네 방향 모두 답이 날짜 컬럼과 상태 코드 컬럼에 이미 있습니다. 실효는 실효일 컬럼에 값이 있느냐로 갈립니다. 나머지도 날짜끼리 대조하거나, 상태 코드를 읽거나, 계산값을 범위와 비교하면 끝납니다. 입력 행만 보면 답이 결정돼 있고 저울질이 남지 않습니다.
정답지 30건으로 채점한 결과가 그걸 보여줍니다. 정상 19건에서 오탐은 0건이었습니다. 조치필요 11건 중 미검출은 1건이었습니다. 그 1건은 등록일이 소급해서 입력된 행이었습니다. 판단이 흔들려서 놓친 것이 아니라, 그 경우를 다루는 규칙이 하나 빠져 있었습니다.
여기에 확률 모델을 얹으면 이런 출력이 나옵니다. 실효일 컬럼에 값이 있는 행에 「실효 확률 0.93」이 붙습니다. 사실에 확률을 덧씌운 잡음입니다. 0.93 은 아무것도 더해주지 않고, 0.07 만큼의 의심을 새로 만듭니다. 규칙은 같은 행을 0원·0ms 에 틀리지 않고 가릅니다.
실제로 문제였던 미검출 1건도 모델이 풀어줄 문제가 아니었습니다. 확률 모델은 빠진 규칙을 찾아주지 않습니다. 이미 있는 선택지 중 그럴듯한 쪽을 잴 뿐입니다. 소급 등록일을 잡는 규칙 하나를 추가하는 것이 답이었습니다.
갈림선은 텍스트냐 정형이냐가 아니었습니다
두 시스템을 나란히 놓고 처음 떠올린 축은 「텍스트는 모델, 정형 데이터는 규칙」이었습니다. 직관적이고 두 사례에도 맞아 보입니다. 문서는 텍스트라 모델이 맞았고, 원장은 정형이라 규칙이 맞았다는 설명입니다. 그런데 반례가 바로 나옵니다.
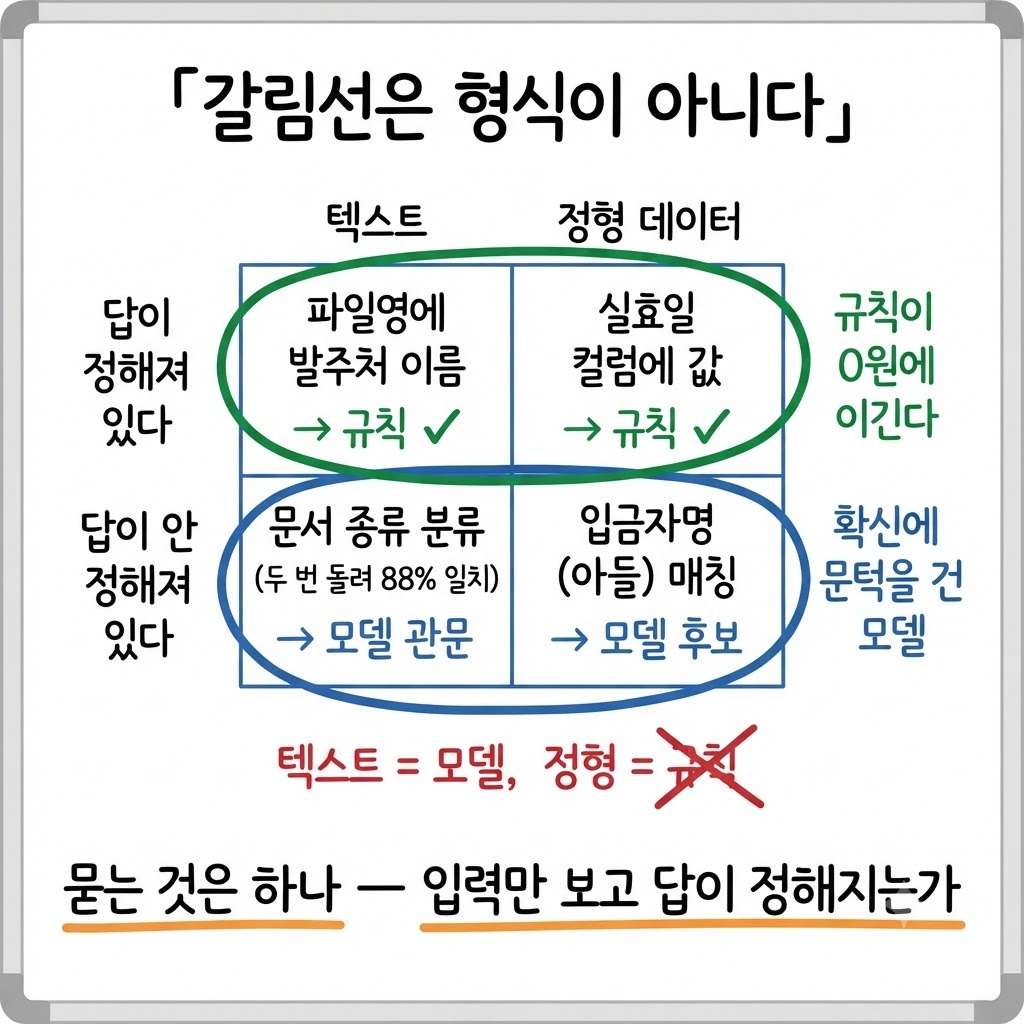
파일명에 발주처 이름이 그대로 들어 있으면 텍스트인데도 규칙이 그 자리에서 확정합니다. 모델을 부를 이유가 없습니다.
입금자명이 채무자 이름 뒤에 「(아들)」이 붙은 형태로 들어오면, 이 입금이 그 채무자의 변제인지는 정형 데이터 옆에 있어도 저울질이 남습니다. 모델 후보입니다.
문서 종류 분류가 모델 자리였던 이유는 텍스트여서가 아닙니다. 같은 문서를 두고 판단이 88%밖에 안 겹칠 만큼 답이 정해져 있지 않아서였습니다.
형식이 아니라 「입력만 보고 답이 이미 정해지는가」가 축이었습니다. 정해져 있으면 규칙입니다. 텍스트여도 그렇습니다. 정해져 있지 않으면 모델 후보입니다. 정형 데이터처럼 생겨도 그렇습니다.
이 축으로 두 시스템을 다시 놓으면 아래처럼 갈립니다.
구분 | 사내 문서 지식그래프 검색 도구 | B2B 채권 분석 시스템 |
|---|---|---|
판정 대상 | 문서 종류·저자 편 | 상각 원장의 정상/조치필요와 네 방향 |
입력 형식 | 텍스트(문서 본문·파일명) | 정형(날짜·상태 코드 컬럼) |
답이 어디 있나 | 입력 안에 없음 — 읽고 저울질해야 나옴 | 컬럼에 이미 있음 |
같은 판단의 흔들림 | 같은 모델 두 번에 88% 일치 | 없음 — 같은 행이면 같은 답 |
실제로 문제였던 지점 | 확신 낮은 건이 회차마다 뒤집힘 | 규칙 하나가 빠져 미검출 1건 |
결정 | Jev 를 확신 0.7 관문으로(검토 중) | 규칙·전수 조회·정답지 채점 유지, Jev 안 붙임 |
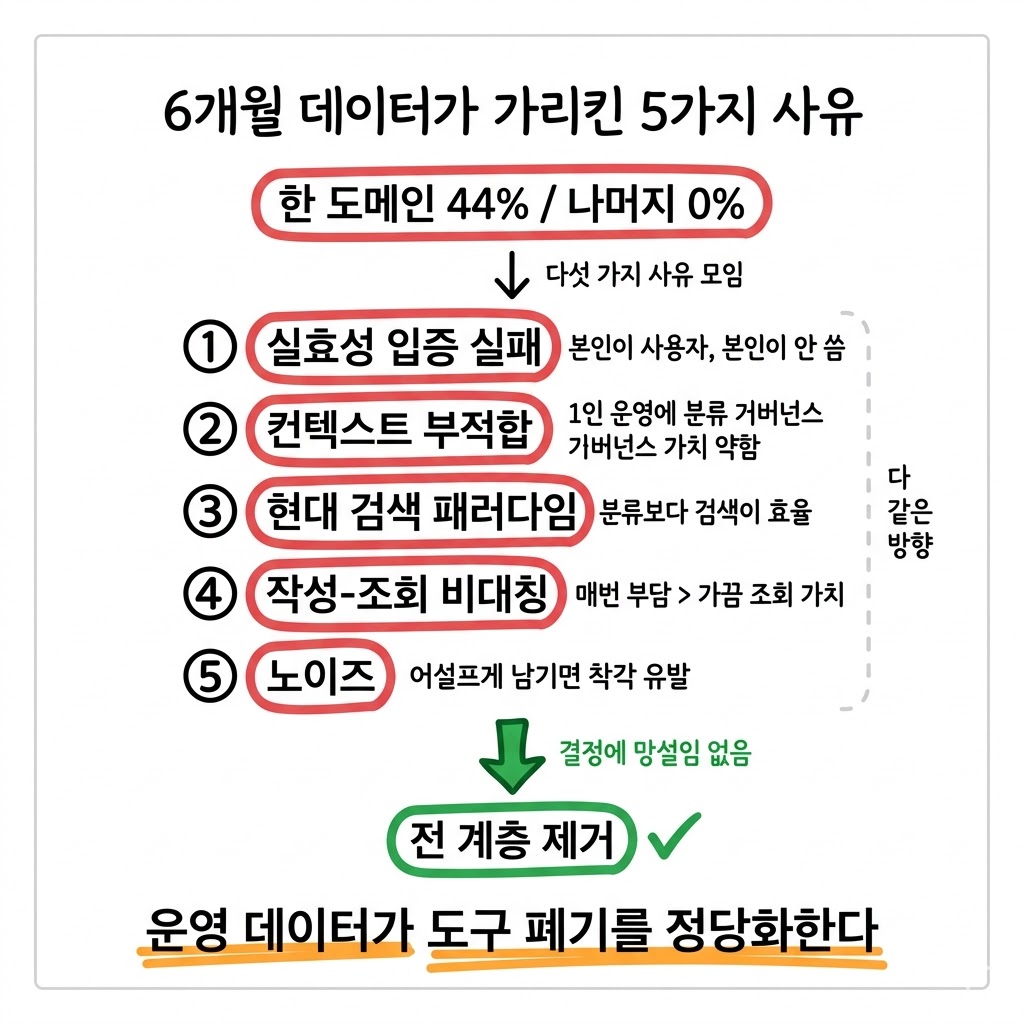
흔들리는 값을 관문 없이 그대로 쌓으면 어떻게 되는지는 태그 시스템에서 먼저 겪었습니다. 그때는 6개월 운영 뒤 태그를 통째로 폐기했습니다. 이번 실험에서는 값을 버리는 대신 문턱을 걸어 채택할 것만 골라 봤고, 그 방향을 검토 중입니다.
순서는 하나입니다 — 규칙, 조회, 그리고 남는 저울질만 모델
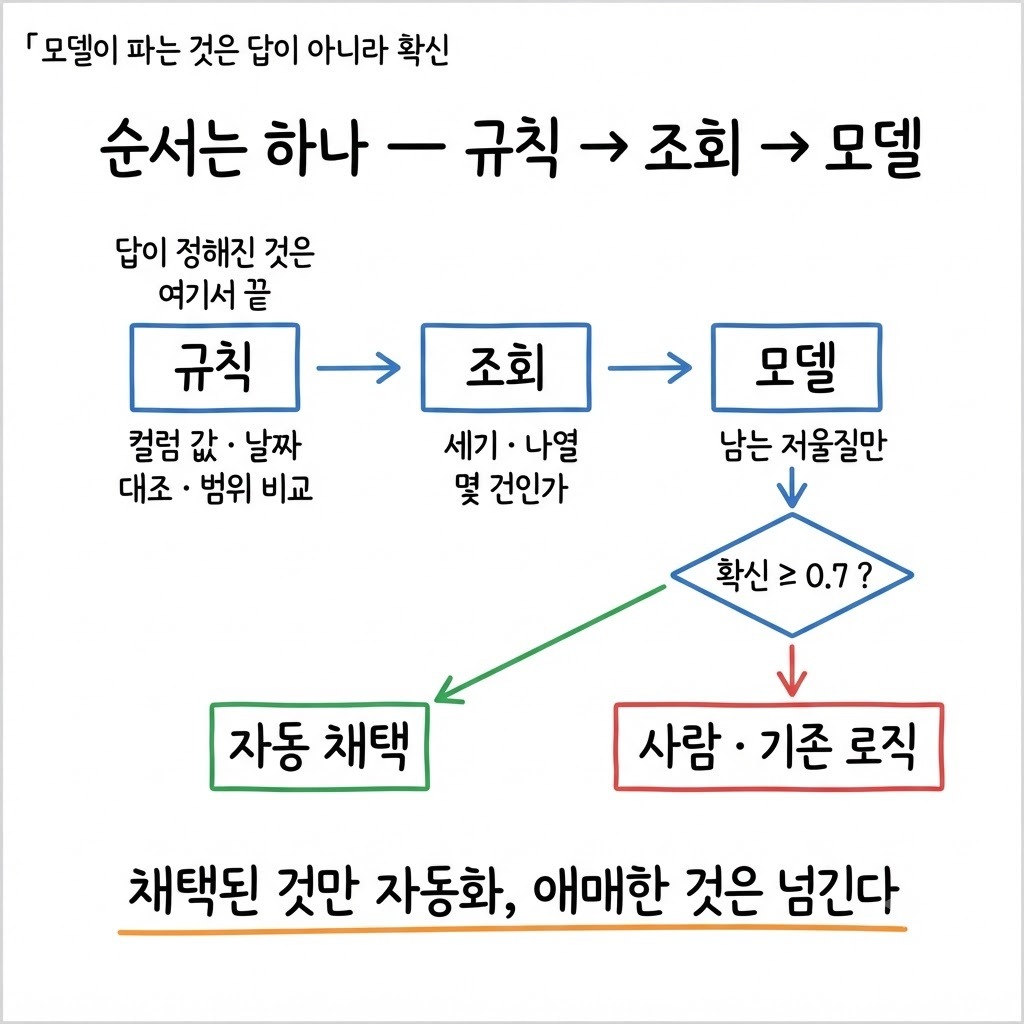
이 갈림선을 작업 순서로 바꾸면 세 단계가 됩니다.
규칙으로 확정되는 것은 규칙이 정합니다. 컬럼 값, 날짜 대조, 범위 비교로 답이 나오는 판정 전부가 여기입니다.
세고 나열하는 것은 조회가 답합니다. 「조치필요가 몇 건인가」「어느 차수에 몰려 있나」는 쿼리의 일입니다.
남는 저울질만 모델이 맡습니다. 모델이 준 확률에 문턱을 걸어 자동 채택과 수동 검토를 가릅니다.
이 순서는 이번에 새로 만든 것이 아닙니다. LLM 에 어디까지 맡길지를 실측으로 그었을 때, 「조회는 조회」로 남겨야 도구 라우팅이 틀려도 답변이 안 망가진다는 결론이 먼저 있었습니다. 이번 일은 그 앞에 「규칙은 규칙」 한 칸을 더 세운 것입니다.
세 번째 단계에서도 모델이 파는 것은 답이 아니라 확신입니다. 문서 분류에서 Jev 가 값을 낸 방식이 그랬습니다. 확신 0.7 이상만 자동으로 채택하고, 그 아래는 기존 LLM 판정으로 넘겼습니다. 채택된 것만 자동화하고 애매한 것은 사람이나 기존 로직에 넘겨야, 모델의 오답이 시스템의 오답으로 곧장 번지지 않습니다.
모델을 붙이기 전에 볼 것
이 판정의 입력만 보면 답이 이미 정해지는가. 정해지면 형식과 무관하게 규칙입니다.
같은 입력에 같은 답이 나오는가. 사람이든 모델이든 회차마다 갈린다면 그 자리가 모델 후보입니다.
지금 아픈 것이 「판단이 흔들려서」인가, 「규칙이 빠져서」인가. 뒤쪽이면 모델은 답이 아닙니다.
모델을 붙인다면 확률에 문턱이 있는가. 문턱이 없으면 관문이 아니라 판정기가 하나 더 늘어난 것입니다.
정답지가 있는가. 30건이라도 있어야 규칙이든 모델이든 채점이 됩니다.
반례 — 그 시스템에도 모델 자리가 생길 수 있습니다
B2B 채권 분석 시스템에 Jev 를 붙이지 않기로 한 것은, 지금까지 확인한 판정이 전부 컬럼에 답이 있는 종류였다는 뜻입니다. 그 시스템의 모든 판단이 영원히 규칙으로 끝난다는 뜻이 아닙니다.
자유 문장 형태의 처리 메모, 법원 서류를 OCR 한 텍스트, 입금자명 매칭처럼 저울질이 남는 입력이 들어오는 자리가 생기면 그 자리는 다시 모델 후보가 됩니다. 기준은 그대로입니다. 형식이 아니라 답이 정해져 있느냐입니다.
정리
같은 팀이 같은 모델을 두 시스템에 대본 결과는 「한쪽은 관문, 한쪽은 자리 없음」이었습니다. 문서 분류에서는 Jev 를 확신 0.7 관문으로 넣는 방향을 검토하고 있습니다. 상각 원장 판정은 규칙과 전수 조회, 정답지 채점을 그대로 둡니다. 미검출 1건은 소급 등록일을 보는 규칙 하나를 더하면 막힙니다 — 모델이 아니라 규칙의 일입니다.
모델을 어디에 붙일지 고를 때 먼저 묻는 질문은 하나로 줄었습니다. 이 입력만 보고 답이 이미 정해지는가입니다. 정해져 있으면 규칙이 0원에 이깁니다.
덧 — 배경 수치는 20건 표본입니다
이 글의 배경인 「채택분 오답 0건」은 20건 표본 결과입니다. 같은 날 저녁 300건으로 다시 재니 확신 0.7 이상 채택분의 기존 라벨 일치는 문서 종류 80%, 0.9 이상은 96%였습니다. 「확신이 흔들릴 곳을 가리킨다」는 300건에서도 그대로였고(뒤집힌 16건 전부 확신 0.5 아래), 문턱의 위치와 정확도는 눈가림 정답표를 채운 뒤에 말하겠습니다.
이 글의 주장 — 답이 컬럼에 있으면 규칙이 정한다 — 은 그 숫자와 무관하게 성립합니다. 문서 분류 쪽에서 모델을 어디까지 믿을지가 달라질 뿐입니다.