무음 오디오를 전사 모델에 세 번 넣었더니, 세 번 다 회의록이 나왔습니다
회의 녹음을 넣으면 회의록을 돌려주는 전사 도구를 매일 쓰고 있습니다. 어느 날 그 도구에 사실상 아무 소리도 없는 파일을 넣었습니다. 돌아온 것은 빈 결과가 아니라 **회의록**이었습니다. 아무도 말하지 않은 회의의 회의록입니다. 세 번 넣었고 세 번 다 그랬습니다.
이 글은 그 결과를 보고 어디에 방어선을 뒀는지에 대한 기록입니다. 결론부터 말하면 응답을 검사하지 않고, 모델을 부르기 전에 입력의 볼륨을 재서 호출 자체를 막았습니다.
다른 걸 조사하다 무음 파일이 생겼습니다
처음 하던 일은 따로 있었습니다. 맥에서 내 목소리와 상대 목소리를 두 트랙으로 따로 녹음할 수 있는지 실측하는 중이었습니다. 이어폰을 낀 온라인 회의에서 상대 목소리를 디지털로 잡을 수 있느냐가 질문이었습니다. 우선순위가 낮은 조건부 작업이었습니다.
검증하는 과정에서 무음에 가까운 짧은 녹음 파일이 여럿 생겼습니다. 녹음부터 전사까지 이어지는지 보려고 그 파일들을 그대로 전사 모델에 넣었습니다. 그런데 문제가 드러난 쪽은 조사하던 녹음 도구가 아니었습니다. **이미 매일 돌아가고 있는 회의 전사 도구** 쪽이었습니다.
아무도 말하지 않은 회의의 회의록
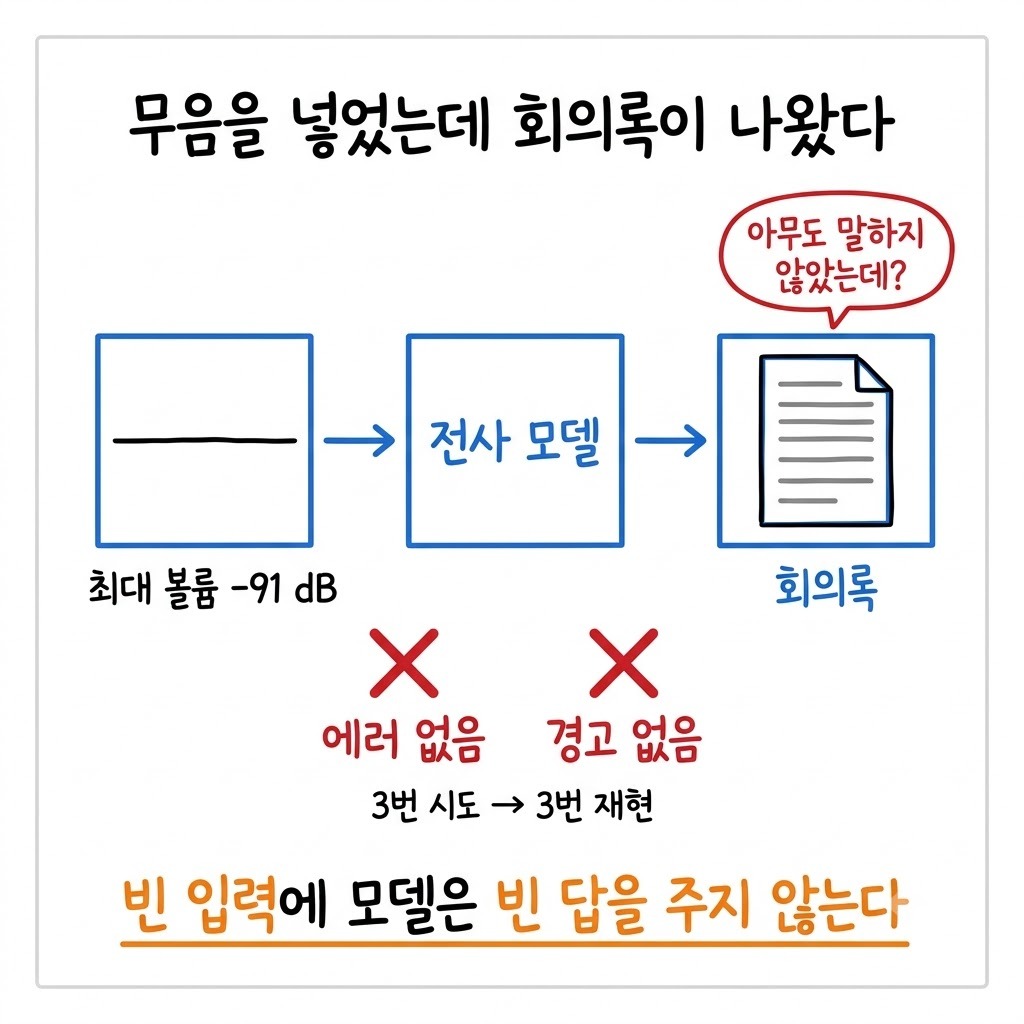
넣은 파일의 최대 볼륨은 **-91 dB**였습니다. 귀로 들으면 아무 소리도 없는 수준입니다. 이 파일을 넣자 회의록 형태의 문장이 통째로 나왔습니다. 한 번은 우연일 수 있어서 두 번 더 돌렸습니다. **3번 시도에 3번 모두 재현**됐습니다.
더 곤란한 점은 따로 있었습니다. 에러도 경고도 없었습니다. 응답은 형식상 완전히 정상이었고 내용만 사실이 아니었습니다. 회의록을 받아 보는 사람은 이게 지어낸 것인지 알 방법이 없습니다. 실제 출력 문장은 이 글에 옮기지 않습니다. 지어낸 문장이라도 발화 형태로 붙이면 독자가 진짜와 가려낼 방법이 없기 때문입니다.
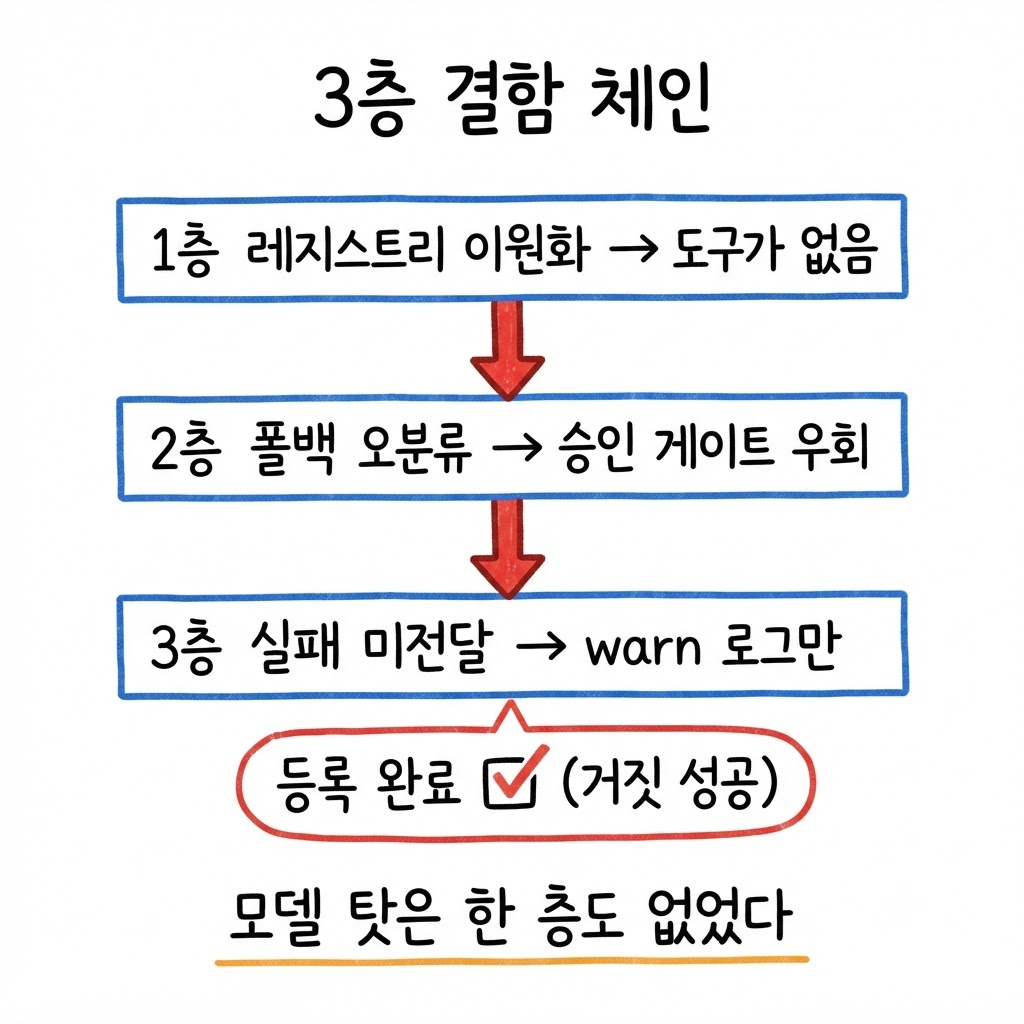
에러 없이 형식만 정상인 응답이 내용으로 틀리는 일은 처음이 아니었습니다. AI 가 '등록 완료'라고 보고했는데 DB 에는 아무것도 없던 경우도 같은 모양이었습니다.
조사를 멈추고 쓰고 있는 도구부터 고쳤습니다
여기서 길이 둘로 갈렸습니다. 조사 결과 노트에 '이런 것도 봤다'고 적고 원래 조사를 마저 하는 길이 하나였습니다. 조사를 멈추고 지금 돌아가는 전사 도구를 먼저 고치는 길이 다른 하나였습니다.
두 번째를 골랐습니다. 조사 대상은 아직 만들지도 않은 도구였습니다. 반면 전사 도구는 매일 사람이 쓰는 도구였고, 그 도구에 결함이 있다는 게 방금 드러났습니다. 우선순위를 '원래 하려던 일'로 정하지 않고 '지금 누가 쓰고 있나'로 정했습니다.
응답을 검사할지, 호출을 막을지
가드를 어디에 둘지에서 한 번 더 갈렸습니다.
방법 | 무엇을 보나 | 걸리는 점 |
|---|---|---|
응답을 검사한다 | 나온 회의록이 진짜인지 판정 | 원본이 무음이라는 걸 이미 알아야 판정할 수 있다 |
호출 앞에서 막는다 | 입력 파일의 최대 볼륨 한 값 | 볼륨 한 값을 재는 비용뿐, 토큰도 안 든다 |
응답 검사는 스스로 모순이었습니다. 회의록이 지어낸 것인지 판정하려면 원본이 무음이라는 사실을 먼저 알아야 합니다. 그걸 이미 안다면 애초에 모델을 부를 이유가 없습니다. 응답 검사를 택했다면 판정 기준을 만드느라 결국 입력을 재는 코드를 따로 짰을 겁니다.
그래서 전사 스크립트 안, 모델 호출 **직전**에 무음 가드를 넣었습니다. 파일의 최대 볼륨을 재서 '문턱'(이 값보다 조용하면 무음으로 보는 기준)보다 낮으면 모델을 부르지 않고 끝냅니다. 조건 한 줄과 숫자 하나가 전부입니다.
max_volume = 파일의 최대 볼륨(dB)
if max_volume < -60: 모델을 부르지 않고 종료
else: 전사 모델 호출
볼륨은 이미 후처리에 쓰던 ffmpeg 의 볼륨 측정 필터로 쟀습니다. 새로 붙인 의존성은 없습니다.
문턱은 숫자 하나가 아니라 분포를 보고 정했습니다
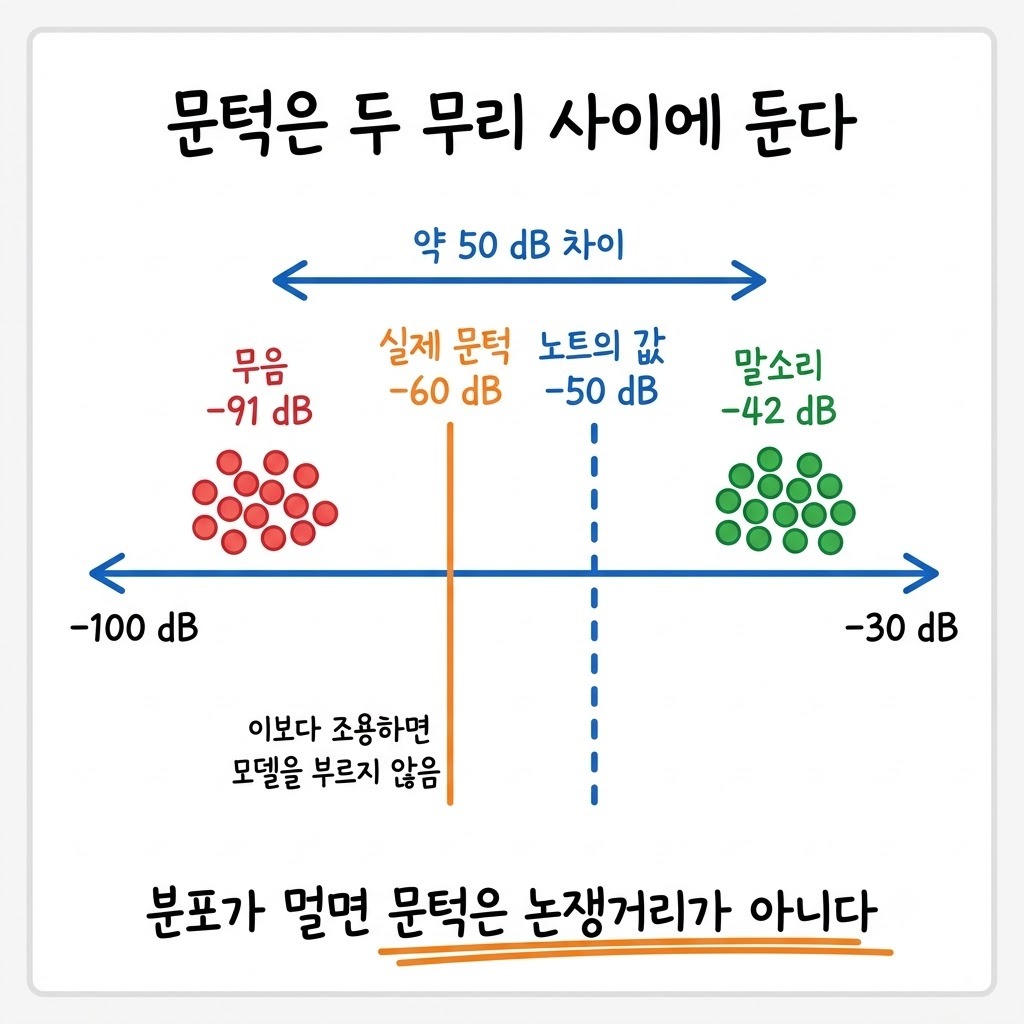
문턱 값은 전에 노트에 **-50 dB**로 적어 둔 것이 있었습니다. 그 값을 그대로 믿지 않고 이번 실측으로 확인했습니다. 무음 파일은 **-91 dB**, 말소리가 든 파일은 **-42 dB**였습니다. 두 무리 사이가 50 dB 가까이 벌어져 있었고, -50 dB 는 그 사이에 있어 맞는 값이었습니다.
실제로 넣은 값은 한 단계 더 보수적인 **-60 dB**입니다. 말소리가 든 파일을 무음으로 잘못 거르지 않도록 여유를 둔 값입니다. 두 무리가 이만큼 떨어져 있으면 그 사이 어디에 두든 결과가 같습니다. 이 가드는 미세 조정할 것이 없는 종류라는 뜻이기도 합니다.
가드와 함께 **테스트 22건**을 붙였습니다. 무음인 경우, 문턱 바로 근처의 경계 경우, 정상 말소리 경우 세 갈래를 덮습니다. 다음에 누가 문턱을 건드리면 테스트에서 바로 걸립니다.
원래 하던 녹음 조사는 그 자리에서 접었습니다. 조건부 작업이 필요로 한 건 '되는가'에 대한 답 하나였고 그 답은 나왔습니다. 다시 시작할 때 30분 정도면 되도록 노트에 남겨 뒀습니다. 결국 이 조사에서 코드가 바뀐 곳은 원래 목표가 아니라 곁가지에서 발견한 전사 도구였습니다.
이 가드가 막지 못하는 것
볼륨은 '소리가 있나'에만 답합니다. '말이 있나'에는 답하지 못합니다. 에어컨 소리만 녹음된 파일은 볼륨이 문턱을 넘어 그대로 모델로 갑니다. 그쪽은 말소리가 있는지를 가려내는 음성 활동 감지(VAD)가 맡을 일입니다.
**녹음 환경이 바뀌면 다시 잽니다.** 마이크가 바뀌어 무음의 바닥이 올라오면 두 무리가 가까워집니다. 분포가 겹치면 문턱 하나로는 못 가릅니다
**가드가 걸린 사실은 사람에게 보여야 합니다.** 조용히 빈 결과만 돌려주면 '녹음이 안 됐다'는 사실까지 같이 묻힙니다
**모델·버전이 바뀌면 행동도 바뀝니다.** 그래서 결론은 '이 모델이 지어낸다'가 아니라 '지어낼 수 있으니 부르지 않는다'입니다
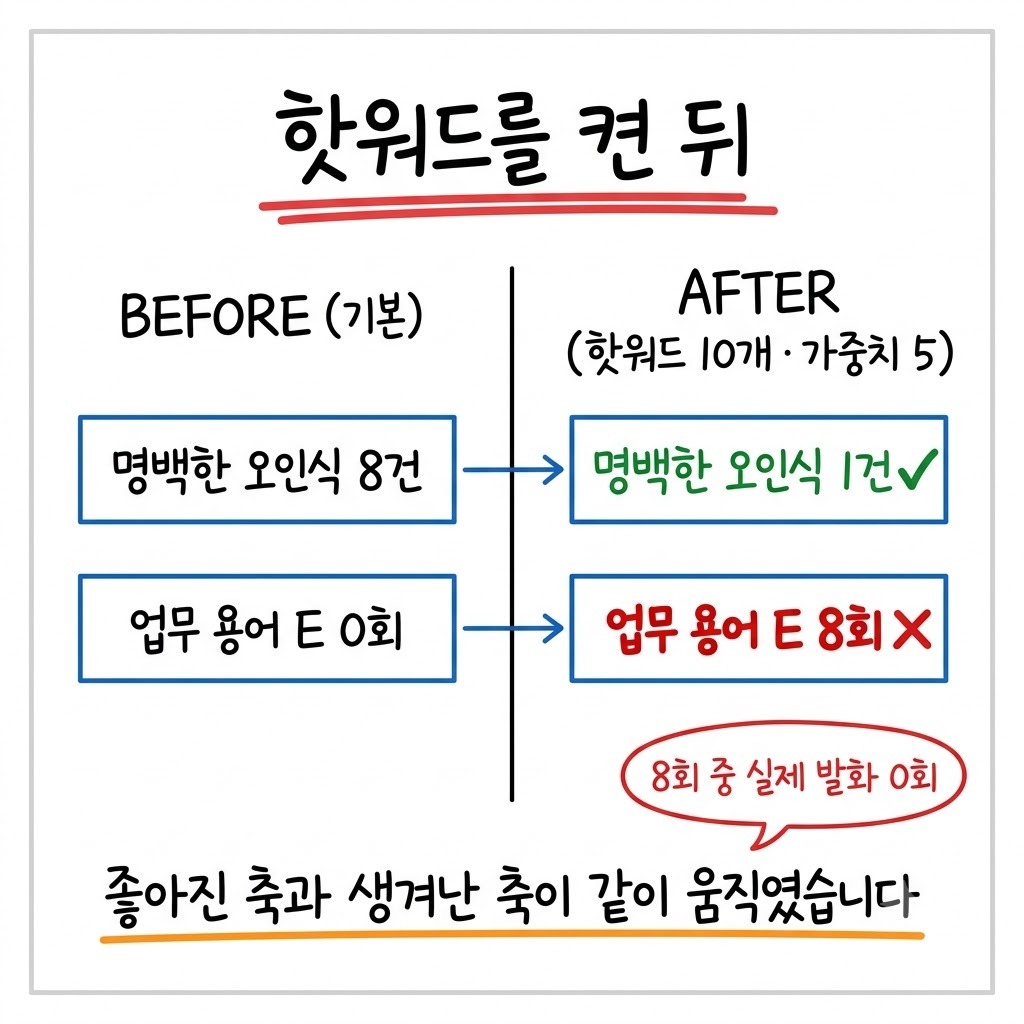
전사 모델이 없던 말을 만드는 일은 무음일 때만 생기지 않습니다. 말소리가 있는 녹음에서도 오인식을 줄이려고 손을 댔다가 없던 말이 생긴 적이 있습니다.
빈 입력에 모델은 빈 답을 주지 않습니다
생성 모델은 '입력이 없다'를 답으로 돌려주지 않습니다. 빈 문자열이나 '모르겠다'는 일부러 유도해야 나오는 행동입니다. 빈 입력에 대한 기본 행동은 그럴듯한 생성이었습니다. 이런 결함은 에러가 없어 알림도 오지 않습니다. 출력이 자연스러워 사람도 못 알아챕니다. 이번에도 무음 파일을 직접 넣어 보기 전까지는 드러나지 않았습니다.
AI 를 업무 도구에 붙이고 있다면 아래 항목을 한 번 확인해 볼 만합니다.
빈 입력·무음·빈 파일을 일부러 넣었을 때 무엇이 나오는지 직접 확인해 봤는가
모델을 부르기 전에 입력이 비었는지 재는 단계가 있는가
그 문턱을 정상 입력과 빈 입력의 실제 분포로 확인했는가
가드가 걸렸을 때 사용자에게 그 사실이 보이는가
문턱 근처의 경계 값을 덮는 테스트가 있는가
응답이 맞는지 나중에 가리는 것보다 부르기 전에 막는 쪽이 비용이 덜 듭니다. 이번에는 숫자 하나와 조건 한 줄로 충분했습니다.