데드코드를 지웠다고 적었는데, 읽는 코드가 두 곳이었습니다
사내 문서 지식그래프 검색 도구에 분류 개선안을 하나 올렸습니다. 문서와 폴더에 붙여 둔 분류 태그의 정확도가 낮아 모델을 붙여 보자는 제안이었습니다. 고객 쪽에서 되물었습니다. 그 태그는 없앤 것 아니었나.
확인해 보니 절반만 없앤 상태였습니다. 보름쯤 전에 문서 쪽 태그는 뺐고, 폴더 노드에 붙은 분류 속성 셋은 그대로 남아 있었습니다. 그리고 남은 쪽이 하는 일이 거의 없었습니다. 다시 헷갈리지 않게 전부 지우기로 방향이 잡혔고, 데이터와 코드와 화면과 문서를 한 번에 걷어냈습니다. 그 두 시간 동안 제 판단이 세 번 뒤집혔습니다.
기능을 더할 때는 틀려도 안 쓰면 그만입니다. 뺄 때는 틀리면 조용히 망가지고 되돌리기도 번거롭습니다. 그런데 정작 아무도 안 쓴다는 판단은 근거 없이 서기가 제일 쉽습니다.
읽는 코드가 한 곳뿐이라는 답은 틀렸습니다
첫 답은 이 태그를 읽는 곳은 사업 찾기 화면 한 곳뿐이라는 것이었습니다. 저장소의 속성 이름으로 grep 해서 센 값이었습니다. 두 번째 소비자가 뒤늦게 나왔습니다.
인력 조회 축이 있었습니다. 특정 유형의 사업을 경험한 사람을 찾는 기능입니다. 이쪽은 문서 엔진의 인력 조회 API 가 내려주는 응답 칸을 읽고 있었고, 그 칸의 원천이 바로 문제의 폴더 속성이었습니다. 소비 쪽 코드에는 속성 이름이 한 번도 나오지 않습니다. 칸 이름으로 읽기 때문입니다.
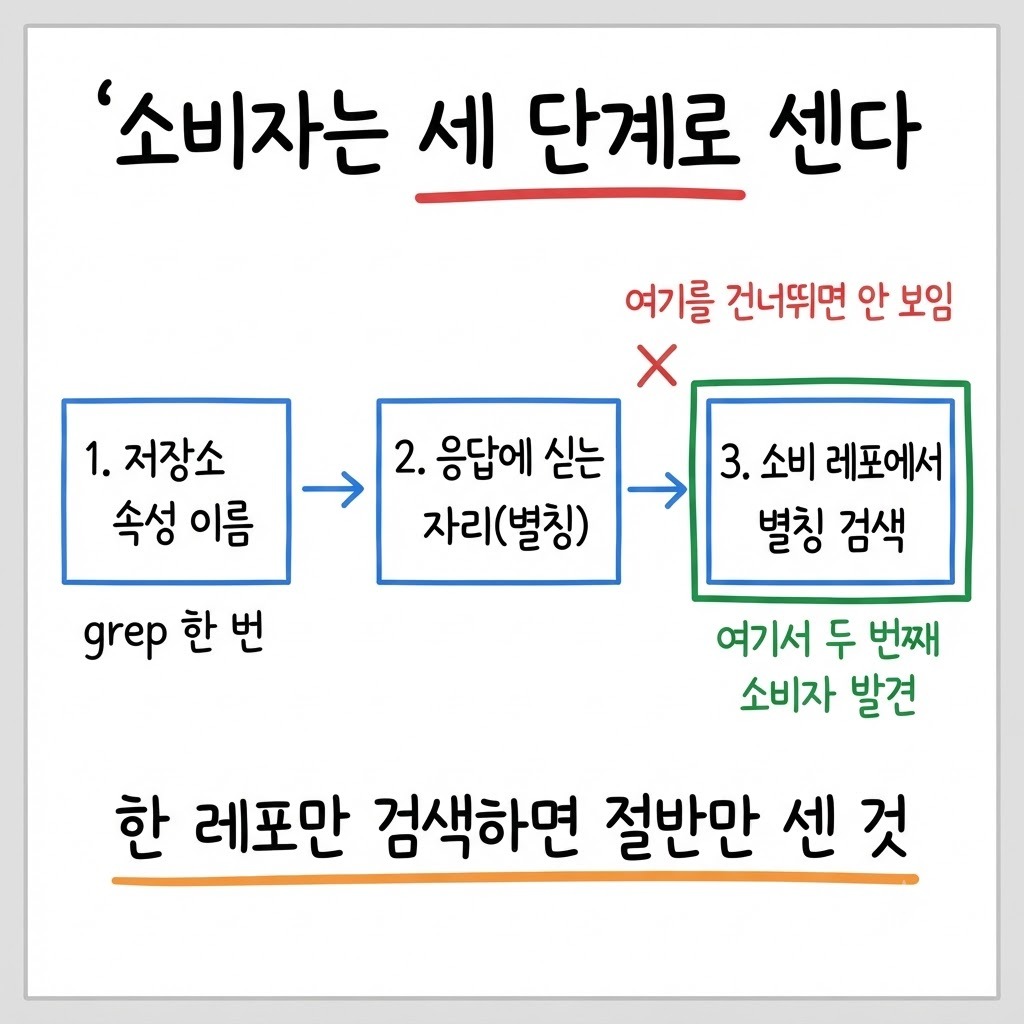
필드를 뺄 때 소비자를 세는 일은 한 단계가 아니라 세 단계입니다.
저장소의 속성 이름으로 검색한다
그 속성을 응답에 싣는 자리를 찾는다. 조회에서 별칭을 붙이는 지점이다
그 별칭을 소비 레포에서 다시 검색한다
이날 빠진 것은 3번이었습니다. 한 레포 안에서만 속성 이름을 검색하면 다른 레포의 소비자는 원리상 보이지 않습니다. 그쪽은 속성을 모르고 칸 이름만 압니다. 서비스가 둘 이상으로 갈린 순간부터 속성 이름 검색은 증거 능력을 잃습니다. 엔진과 화면이 다른 레포로 나뉜 구조라면 그날부터 해당합니다.
덧붙여, 보름 전에 문서 태그를 빼면서 제가 적어 둔 읽는 코드가 0곳이라는 문장도 문제였습니다. 그때는 맞는 말이었습니다. 다만 무엇의 소비자가 0곳인지 범위가 적혀 있지 않았습니다. 그래서 나중에 폴더 태그까지 없다는 뜻으로 읽혔고, 그 문장을 잘못 읽은 다음 사람이 보름 뒤의 저였습니다.
쓸지도 모른다는 말 대신 표식을 셌습니다
검수 화면에는 태그 편집기가 하나 붙어 있었습니다. 누가 쓸지 모르니 두자는 말이 나올 자리입니다. 이런 논쟁은 양쪽 다 근거가 없어서 목소리 큰 쪽이 이깁니다.
이날은 논쟁 대신 표식을 셌습니다. 그 편집기는 사람이 값을 고치면 해당 노드에 잠금 표식(사람이 손댔으니 배치가 덮어쓰지 말라는 플래그)이 붙도록 설계돼 있었습니다. 삭제 스크립트를 드라이런으로 돌려 세어 보니 대상 폴더 전량에서 잠금 표식이 0건이었습니다. 한 번도 쓰인 적 없는 화면이었습니다. 세는 데 30초가 들었습니다.
여기서 남는 것은 편집기를 뺐다는 사실이 아닙니다. 죽었다는 판단을 추측이 아니라 사람이 남긴 표식으로 증명할 수 있었다는 점입니다. 잠금 플래그, 수정 시각, 최종 사용일, 출처가 사람인지 배치인지를 적어 두는 칸이 그런 표식입니다.
뒤집어 말하면, 표식이 없는 기능은 나중에 뺄 근거가 없어서 못 뺍니다. 편집 기능을 만들 때 사람이 손댔다는 표식을 같이 두는 일은 미래의 삭제 비용을 미리 내는 일입니다. 이번에 30초로 끝난 이유는 설계 때 그 플래그를 넣어 뒀기 때문입니다. 표식이 없었다면 지금부터 표식을 남기고 몇 주를 관측하는 대기 비용을 냈을 겁니다.
동작이 같은지 보려다 옛 동작이 틀렸다는 걸 알았습니다
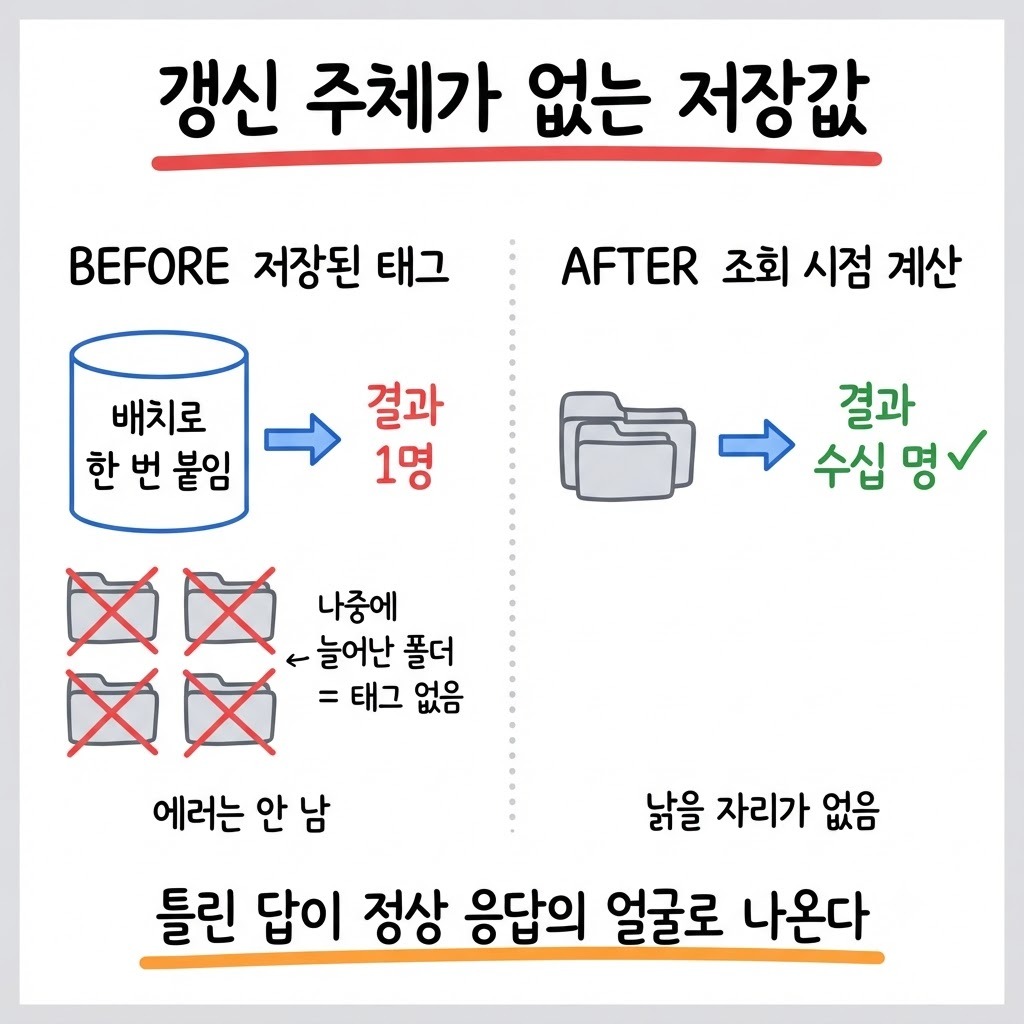
살아 있던 유일한 소비자는 저장된 태그 대신 폴더명 글자 규칙으로 판정하도록 바꿨습니다. 대체 구현이 맞는지 보려고 운영 데이터로 재현해 옛 결과와 대조했습니다. 숫자가 크게 벌어졌습니다. 이전 회차에 정답으로 받아 둔 답은 한 명이었는데, 새 방식은 폴더 열 개와 사람 수십 명을 냈습니다.
처음에는 새 구현을 의심했습니다. 파고 보니 낡은 쪽이 틀린 것이었습니다. 그 태그는 폴더가 백 개 남짓이던 시절에 배치로 한 번 붙인 값이었습니다. 그 뒤 백필로 폴더가 두 배 넘게 늘었고, 늘어난 폴더에는 태그가 한 번도 붙지 않았습니다. 옛 축은 그 폴더들을 통째로 못 보고 있었습니다.
그동안 에러는 한 번도 나지 않았습니다. 저장된 파생값이 낡으면 장애가 나는 게 아니라 틀린 답이 정상 응답의 얼굴로 나옵니다. 이 종류는 아무도 신고하지 않습니다. 사용자는 조회 결과가 한 명이면 그냥 한 명인 줄 압니다.
저장된 파생값이 늘 나쁘다는 뜻은 아닙니다. 원본 계산이 비싸거나, 값이 그 시점의 스냅샷이어야 하는 경우에는 저장이 정답입니다. 정산 내역이나 감사 이력이 그렇습니다. 문제는 저장 자체가 아니라 갱신 주체가 없는 저장입니다.
그래서 처방은 둘 중 하나입니다. 조회 시점 계산으로 바꿀 수 있으면 바꿉니다. 안 되면 원본이 늘 때 같이 도는 자리에 갱신을 붙입니다. 색인 파이프라인이나 적재 배치가 그런 자리입니다. 별도 스크립트로 한 번 돌리고 끝낸 값은 그날치입니다.
이 건에서 하나 더 얻은 것이 있습니다. 이월된 판정은 근거가 아니라는 사실입니다. 이전 회차에 정답으로 통과시킨 그 판정 자체가 사실은 그 시점 데이터에서만 정답이었습니다. 백필이나 대장 정리처럼 데이터가 크게 바뀐 뒤에는 지난 회차의 합격 판정을 그대로 들고 오지 않습니다. 다시 던져야 현재 값입니다.
지우는 순서는 코드 먼저, 데이터는 마지막입니다
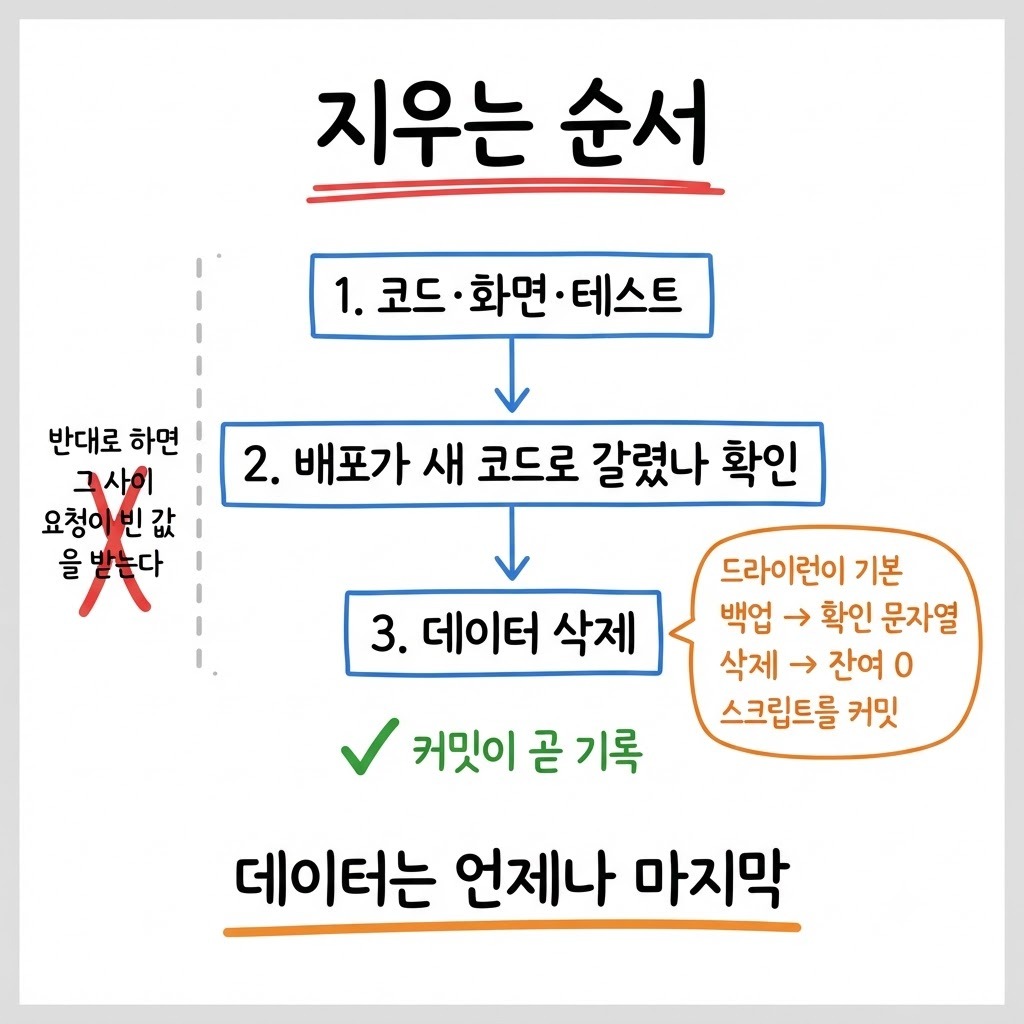
세고 나서 실제로 걷어낸 순서는 이렇습니다.
코드와 화면과 테스트를 먼저 고친다. 문서 엔진 876개, 업무 화면 961개 테스트를 통과시킨다
배포한 뒤 실제로 새 프로세스로 갈렸는지 확인한다. 기동 시각과 프로세스 아이디를 본다
데이터는 레포에 커밋한 마이그레이션 스크립트로 지운다
데이터를 마지막에 두는 이유는 단순합니다. 코드가 아직 그 값을 읽고 있는 상태에서 값을 지우면 그 사이에 들어온 요청이 빈 값으로 답합니다. 반대 순서는 안전합니다. 코드가 안 읽게 된 뒤의 데이터는 그냥 남아 있는 것이고, 남아 있는 동안 아무 일도 일어나지 않습니다.
삭제 스크립트는 이렇게 짰습니다. 드라이런이 기본값이고, 적용 경로는 JSON 백업, 확인 문자열 입력, 삭제, 남은 것 0 확인 순서입니다. 스크립트를 레포에 커밋하면 그 자체가 기록이 됩니다. 그날 무엇을 몇 건 지웠는지가 커밋에 남습니다.
드라이런은 부수 발견도 줬습니다. 잠금 표식 0건이라는 숫자가 나온 자리가 바로 이 드라이런입니다. 지우기 전에 한 번 세어 본 값이 왜 지우는지에 대한 근거가 됐습니다.
온톨로지 정의 파일과 설계 문서는 지우지 않았습니다. 대신 문서 머리에 폐기 표식만 달았습니다. 그때 이렇게 설계했다는 기록이 남아야 같은 제안이 또 올라오지 않습니다. 이번 일 자체가 그 제안이 다시 올라온 사건이었습니다.
기능을 빼기 전에 세는 항목
이번에 쓴 순서를 그대로 옮기면 이렇습니다. 확신이 아니라 세는 방법을 정해 두는 쪽입니다.
소비자를 세 단계로 셌는가. 속성 이름, 응답 칸 이름, 소비 레포 순서로 본다
죽었다는 판단에 사람이 남긴 표식이 붙어 있는가. 잠금, 수정 시각, 최종 사용일 중 하나라도 센 값이 있어야 한다
같은 개념이 앉아 있는 층을 전부 셌는가. 데이터, 코드, 화면, 사전, 설계 문서까지
남기기로 한 것에 왜 남겼고 누가 읽는지를 적었는가
지우기 전에 되돌릴 장치가 있는가. 백업, 드라이런, 커밋된 마이그레이션 스크립트
넷째 항목이 이번 사고의 원인이었습니다. 보름 전에 절반만 지우고 남긴 쪽에 왜 남겼는지를 안 적었습니다. 절반만 지우는 것이 항상 틀린 것은 아닙니다. 한 층씩 빼면서 관측하는 편이 안전한 규모도 있습니다. 다만 그때는 남긴 쪽에 이유를 반드시 적어야 하고, 이번에는 그걸 안 적어서 두 시간을 썼습니다.
셀 수 없는 구조도 있습니다
세 단계로 세는 방법이 늘 통하지는 않습니다. 외부 클라이언트가 응답을 받아가거나, 맵이나 리플렉션으로 필드 이름을 동적으로 읽거나, LLM 프롬프트 문자열 안에 필드명이 들어 있으면 검색으로는 원리상 못 잡습니다.
그럴 때는 세는 대신 관측합니다. 먼저 값을 비워 두고, 그 값을 읽는 호출이 있으면 로그를 남기고, 일정 기간 로그가 비어 있으면 삭제합니다. 세는 비용이 없는 대신 기다리는 비용이 듭니다. 어느 쪽이든 되돌릴 수 있는 삭제가 전제입니다. 백업과 마이그레이션 스크립트와 드라이런이 없다면 세기 전에 그 장치부터 만드는 것이 순서입니다.
이번 일에서 제가 바꾼 습관은 하나입니다. 전부, 없다, 뿐이다 같은 말을 문서나 커밋 메시지에 적을 때는 센 다음에 적고, 무엇의 범위인지를 같이 적습니다. 대화에서 틀린 말은 흘러갑니다. 문서에 적힌 틀린 범위는 남아서 다음 사람의 근거가 됩니다. 그리고 그 다음 사람은 대체로 몇 주 뒤의 자신입니다.