느린 쿼리 여덟 곳을 전부 쟀더니, 파생테이블 최적화는 세 곳만 맞았습니다
프랜차이즈 ERP 에서 매입 내역을 모아 보여주는 집계 팝업이 있습니다. 전 매장 21개월을 펼치면 3.7초가 걸렸습니다. 담당자는 그 화면을 하루에 여러 번 엽니다. 3.7초는 장애는 아니지만, 매번 기다리게 되는 길이입니다.
고치는 방법 자체는 어렵지 않았습니다. 어려웠던 쪽은 다른 질문이었습니다. 같은 형태의 쿼리가 여덟 곳 있었는데, 거기에 같은 최적화를 다 적용해도 되는가입니다. 결론부터 적으면 세 곳만 고쳤습니다. 나머지 다섯 곳은 같은 모양으로 바꿨을 때 오히려 느려졌습니다.
조인 키가 없어서 생긴 느림입니다
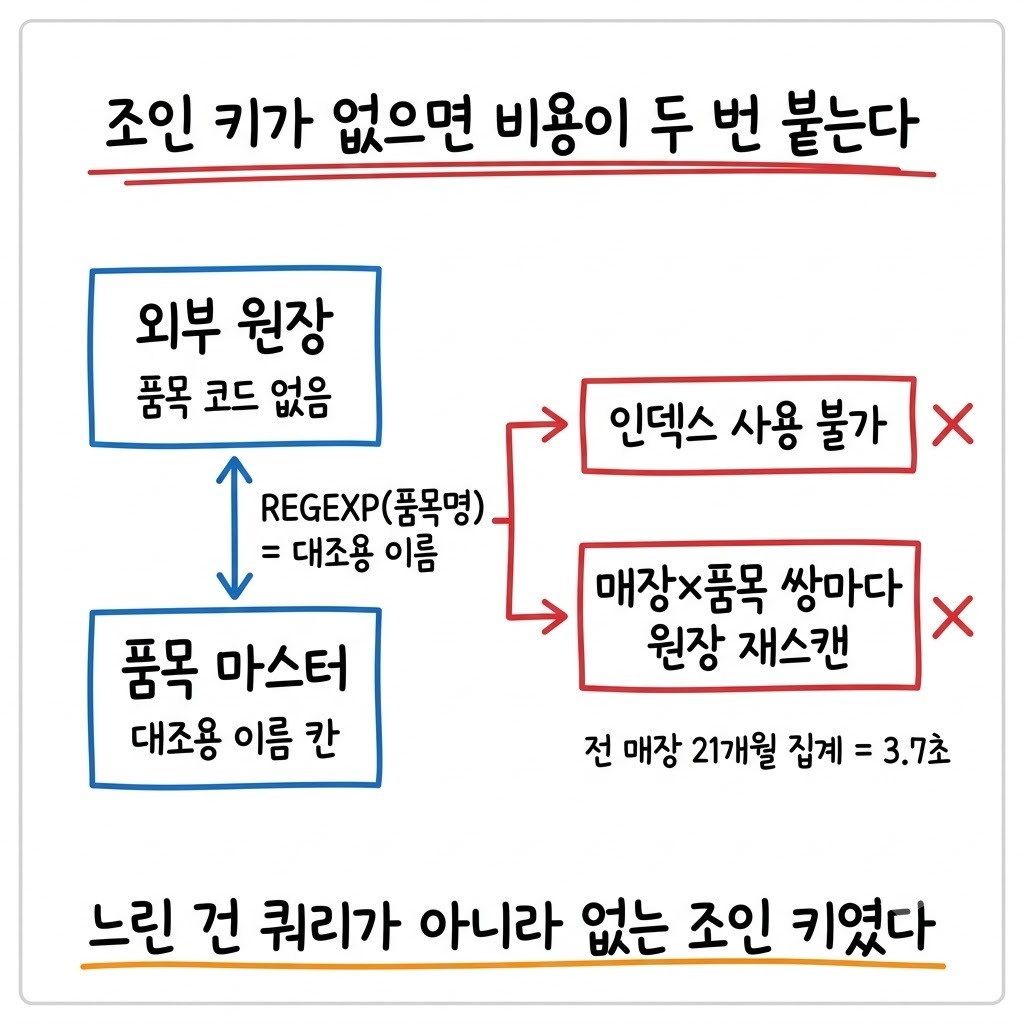
매입 원장은 외부 공급사 시스템에서 받아 옵니다. 그 원장에 품목 코드가 없습니다. 그래서 우리 쪽 품목 마스터와 붙이려면 품목명 문자열을 정규식으로 다듬어 대조용 이름 칸과 맞추는 수밖에 없었습니다.
여기서 두 가지 비용이 같이 발생합니다. 첫째, 컬럼 값을 가공해서 비교하므로 인덱스를 쓸 수 없습니다. 둘째, 조회 단위가 매장과 품목의 쌍이라, 쌍마다 원장 전체를 다시 훑으면서 같은 정규식을 반복합니다. 쌍이 늘어나는 만큼 같은 계산이 그대로 늘어납니다.
세 가지 길 중 쿼리 모양만 바꾸는 쪽을 골랐습니다
근본 문제는 조인 키가 없다는 것입니다. 그걸 두고 선택지가 세 개였습니다.
길 | 내용 | 왜 안 골랐나 / 골랐나 |
|---|---|---|
수집 쪽 수정 | 공급사에서 품목 코드를 받아 저장한다 | 가장 깨끗하지만 외부 시스템이 코드를 주지 않는다. 우리가 할 수 있는 선택이 아니다 |
컬럼 추가 | 대조용 이름을 미리 계산해 컬럼으로 저장하고 인덱스를 건다 | 스키마 변경에 과거 데이터 재적재와 수집 시점마다의 갱신이 따라온다 |
쿼리 모양 변경 | 정규식 계산 횟수를 줄이도록 쿼리만 바꾼다 | 스키마를 안 건드린다. 대신 쿼리마다 이득이 다를 수 있다 — 이쪽을 골랐다 |
고친 모양은 단순합니다. 고른 매장과 기간의 원장만 먼저 뽑는 파생 테이블(상위 쿼리 안에 중간 결과로 들여앉히는 하위 조회)을 두고, 옵티마이저가 그 파생 테이블을 상위 쿼리와 합쳐 버리지 않게 'NO_MERGE' 힌트를 붙였습니다. 좁혀진 그 결과 안에서 정규식을 한 번만 계산한 뒤 해시 조인으로 마스터에 붙입니다. 인덱스 추가도 스키마 변경도 없습니다.
쿼리 모양만 바꾸는 쪽을 고르면서 같이 적어 둔 것이 '쿼리마다 이득이 다를 수 있다'였습니다. 그 한 줄이 그대로 두 번째 질문이 됐습니다. 같은 형태인 여덟 곳에 전부 적용해도 되는가입니다.
여덟 곳을 하나씩 전후로 쟀습니다
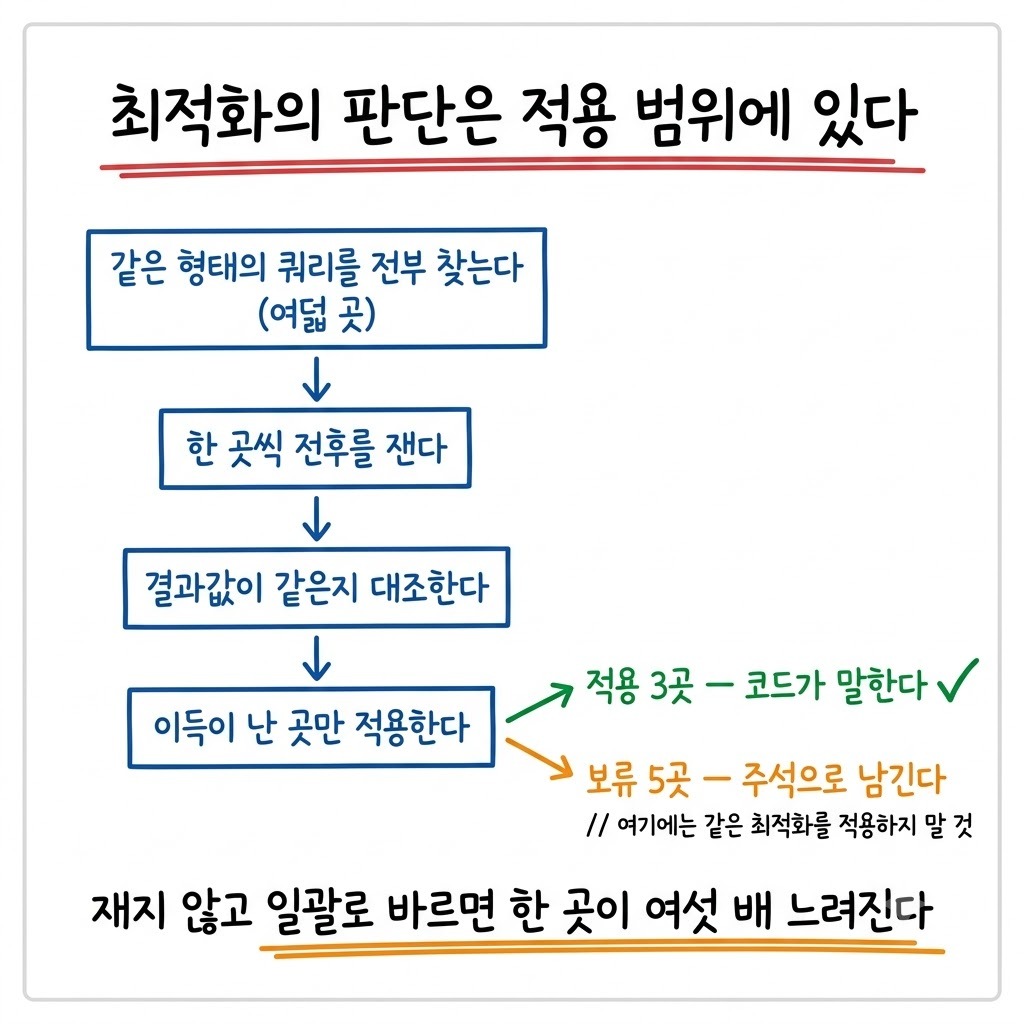
같은 형태의 쿼리를 찾아보니 여덟 곳이었습니다. 일괄로 바꾸지 않고 여덟 곳 전부를 바꾸기 전과 바꾼 뒤로 재고, 결과값이 모두 같은지 대조했습니다. 세 곳에서 이득이 나왔습니다.
대상 | 범위 | 전 | 후 |
|---|---|---|---|
집계 팝업 | 전 매장 21개월 | 3.7초 | 0.7초 |
집계 팝업 | 한 지역 | 0.28초 | 0.09초 |
발주 차이 화면 — 실발주 | 매장 한 곳 6개월 | 0.3초 | 0.004초 |
발주 차이 화면 — 제외 집계 | 매장 한 곳 24개월 | 0.81초 | 0.013초 |
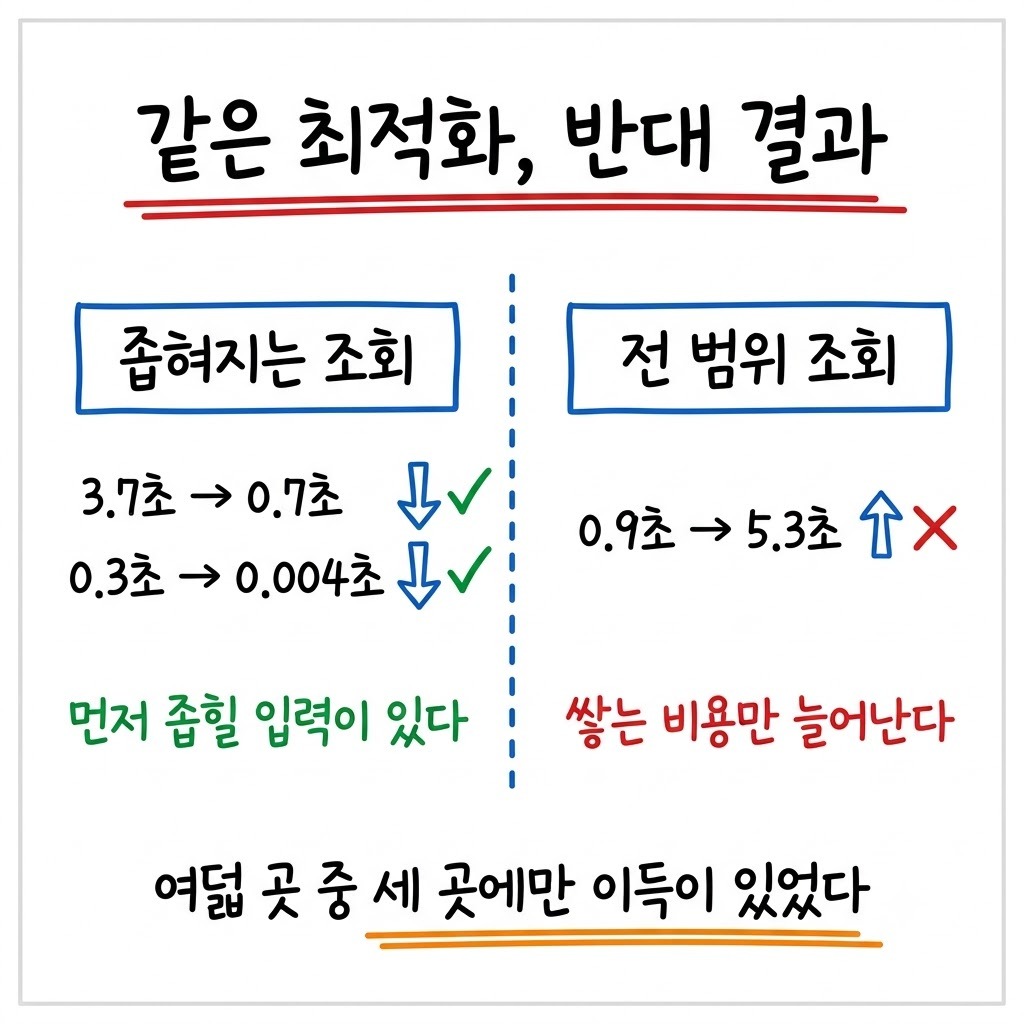
매장 하나로 좁히는 조회가 가장 크게 내려갔습니다. 0.3초에서 0.004초, 24개월을 펼쳐도 0.81초에서 0.013초입니다. 두 자릿수 배입니다.
나머지 다섯 곳은 반대였습니다. 애초에 매장으로 좁혀지지 않는 조회라 이미 빨랐고, 같은 형태로 바꾸니 더 느려졌습니다. 한 곳은 0.9초에서 5.3초가 됐습니다. 여섯 배 가까이 느려진 것입니다.
이유는 바꾼 모양 안에 그대로 있습니다. 이 방식은 먼저 좁혀 둔 입력이 있을 때 이깁니다. 전 범위를 훑는 조회에는 먼저 좁힐 대상이 없으니, 파생 테이블은 중간 결과를 쌓는 비용만 더하는 셈이 됩니다.
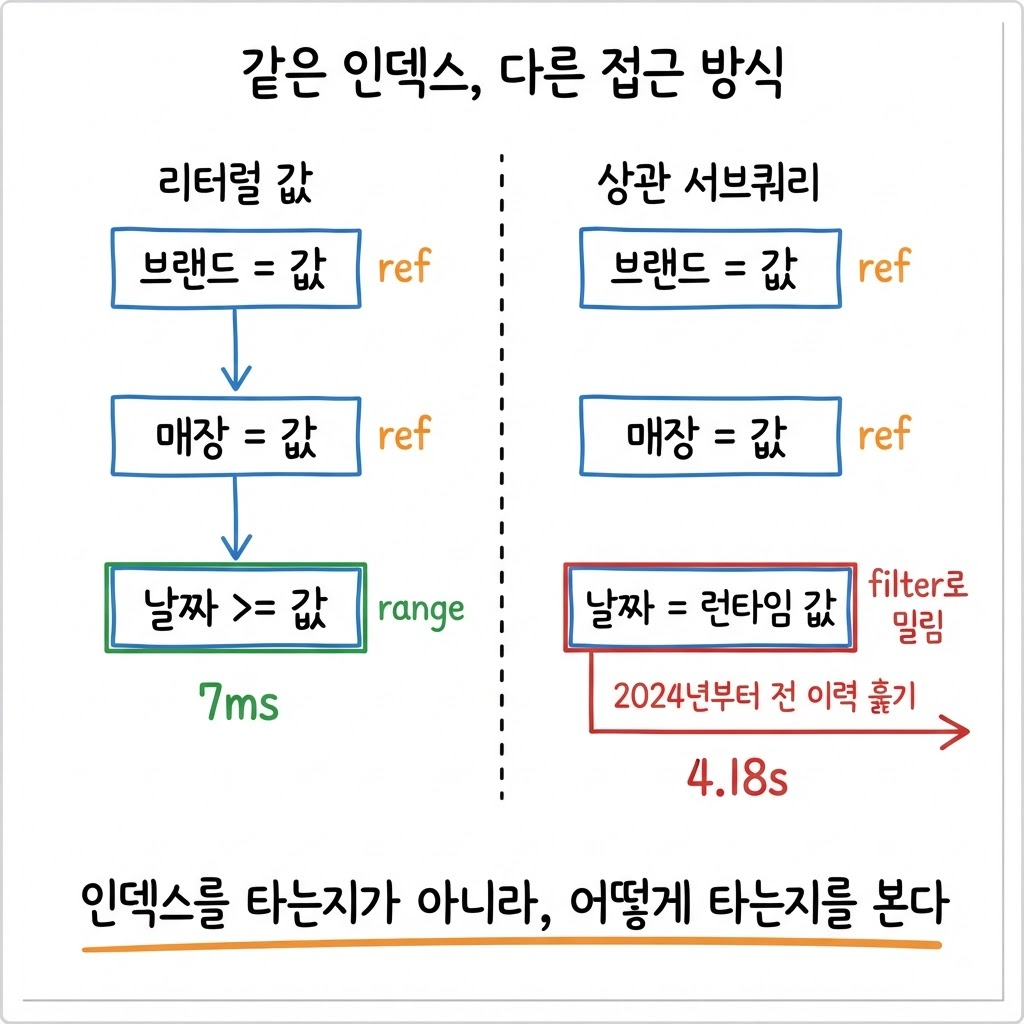
느린 이유를 실행계획까지 열어 봐야 알게 되는 일은 자주 있습니다. 인덱스를 타고 있는데도 4.1초가 걸린 쿼리를 하나씩 뜯어본 기록이 있습니다.
안 한 이유를 코드에 남겼습니다
적용한 세 곳은 코드가 스스로 말합니다. 문제는 적용하지 않은 다섯 곳입니다. 그 자리는 아무 말도 하지 않습니다. 정리하는 사람에게 보이는 건 '여기만 아직 옛 모양이다'라는 사실뿐입니다.
그래서 다섯 곳에는 여기에는 같은 최적화를 적용하지 말라는 경고를 주석으로 남겼습니다. 재 봤고, 느려졌고, 왜 느려지는지까지 한 토막으로 적었습니다. 이 주석이 없으면 다음 사람이 손이 덜 간 자리로 보고 똑같이 적용할 겁니다. 그러면 0.9초짜리 조회가 다시 5.3초가 됩니다.
남긴 흔적이 두 개라고 보는 편이 맞습니다. 하나는 고친 세 곳의 쿼리, 다른 하나는 안 고친 다섯 곳의 주석입니다. 뒤쪽이 코드로는 아무것도 안 바꾸지만 다음 판단을 바꿉니다.
성능 작업의 완료 조건에 결과값 대조를 넣습니다
전후를 재면서 같이 본 것이 결과값입니다. 조인 방식을 바꾸면 행이 늘거나 줄 수 있습니다. 빨라졌는지만 보면 숫자가 달라진 것을 모른 채 지나갑니다. 성능 작업이 집계를 조용히 틀리게 만드는 일은 속도가 아니라 이 결과값 대조를 건너뛸 때 생깁니다.
이번에 쓴 점검 항목은 다섯 개였습니다.
같은 형태의 쿼리를 전부 찾았는가 — 한 곳만 고치면 다음 사람이 나머지를 다르게 판단한다
바꾸기 전과 바꾼 뒤를 같은 범위로 쟀는가
범위를 좁힌 조회와 전 범위 조회를 둘 다 쟀는가 — 이득의 방향이 거기서 갈린다
결과값이 바꾸기 전과 같은가
적용하지 않기로 한 자리에 그 이유를 적었는가
재는 시간이 기법을 찾는 시간보다 길었습니다
이번 작업에서 가장 오래 걸린 쪽은 쿼리 모양을 찾는 일이 아니었습니다. 여덟 곳을 하나씩 재고 결과값을 대조하는 일이었습니다. 그 시간을 아끼려고 일괄로 적용했다면 다섯 곳 중 한 곳이 여섯 배 느려진 채로 나갔을 겁니다.
한계도 분명합니다. 실행계획은 DB 버전과 옵티마이저 설정에 따라 다르게 풀리므로, 환경이 바뀌면 같은 쿼리를 다시 재야 합니다. 이번 측정도 반복 측정의 평균이 아니라 전후 한 번씩이라 캐시 상태의 영향이 섞여 있습니다. 다만 0.3초에서 0.004초처럼 차이가 두 자릿수 배일 때는 그 영향으로 판단이 뒤집히지 않습니다.
그리고 이번 건은 근본 해결이 아닙니다. 조인 키가 없다는 문제는 그대로 남아 있고, 쿼리 모양으로 청구서를 미뤄 둔 것입니다. 조회 패턴이 더 늘면 코드를 받거나 대조용 이름을 저장하는 쪽이 다시 올라올 안건입니다.
감이 아니라 측정으로 적용 범위를 가르는 같은 방식을, 검색 유입 쪽 작업에서도 한 번 썼습니다. 지적받은 항목을 전부 고치지 않고 검색 콘솔 수치로 세 건만 골라낸 기록입니다.