SQL 튜닝 뒤 '결과가 같다'는 비교가 두 번 거짓으로 통과할 뻔했습니다
한 회사의 ERP 관리자 대시보드에 '담당자별 요약'이라는 화면이 있습니다. 담당자마다 맡은 매장의 발주가 이상한지 판정해 보여주는 화면입니다. 조회 기간을 늘릴수록 느려졌고, 10개월을 조회하면 8.5초가 걸렸습니다.
같은 날 대시보드의 다른 탭도 이 판정 결과를 그대로 다시 쓰게 됐습니다. 느린 쿼리 하나를 여러 화면이 함께 기다리게 된 셈입니다. 고친 뒤 10개월 조회는 3.0초가 됐습니다.
다만 이 글에서 더 길게 적을 것은 그 뒤의 일입니다. 고친 쿼리가 예전과 같은 결과를 내는지 확인하는 과정에서, 비교 스크립트가 두 번이나 근거 없이 '같다'고 판정할 뻔했습니다.
비싼 함수가 행이 가장 많을 때 실행되고 있었습니다
기간에 비례해 느려진다는 것은 하나의 신호입니다. 기간이 늘면 행도 늘어나는 곳에서, 행마다 비싼 계산이 실행되고 있다는 뜻입니다. 느린 쿼리를 하나씩 재 보니 매장별 품목 분류 매입을 구하는 쿼리 하나가 10개월 기준 25초였습니다.
이 쿼리는 외부 공급사 시스템의 품목을 ERP 품목과 맞추려고 품목명에 'TRIM(REGEXP_REPLACE(...))'(정규식으로 기호를 지우고 앞뒤 공백을 자르는 문자열 정리)를 적용했습니다. 문제는 정리하는 시점이었습니다.
원장을 매장·품목과 먼저 조인한 뒤에 정리 함수를 실행했습니다. 그래서 함수가 매장×품목 조합마다 한 번씩, 모두 수백만 번 실행됐습니다.
고친 방법은 순서를 바꾼 것입니다. 매입 원장을 **거래처·품목별로 먼저 합친 뒤** 매장·품목에 연결했습니다. 이제 문자열 정리는 합친 뒤의 적은 행에서만 실행됩니다.
-- 전: 조인으로 행이 늘어난 뒤, 행마다 정리
원장 JOIN 매장·품목  ->  TRIM(REGEXP_REPLACE(품목명))  ->  GROUP BY

-- 후: 먼저 합치고, 적은 행에서 정리한 다음 연결
원장 GROUP BY 거래처·품목  ->  TRIM(REGEXP_REPLACE(품목명))  ->  JOIN 매장·품목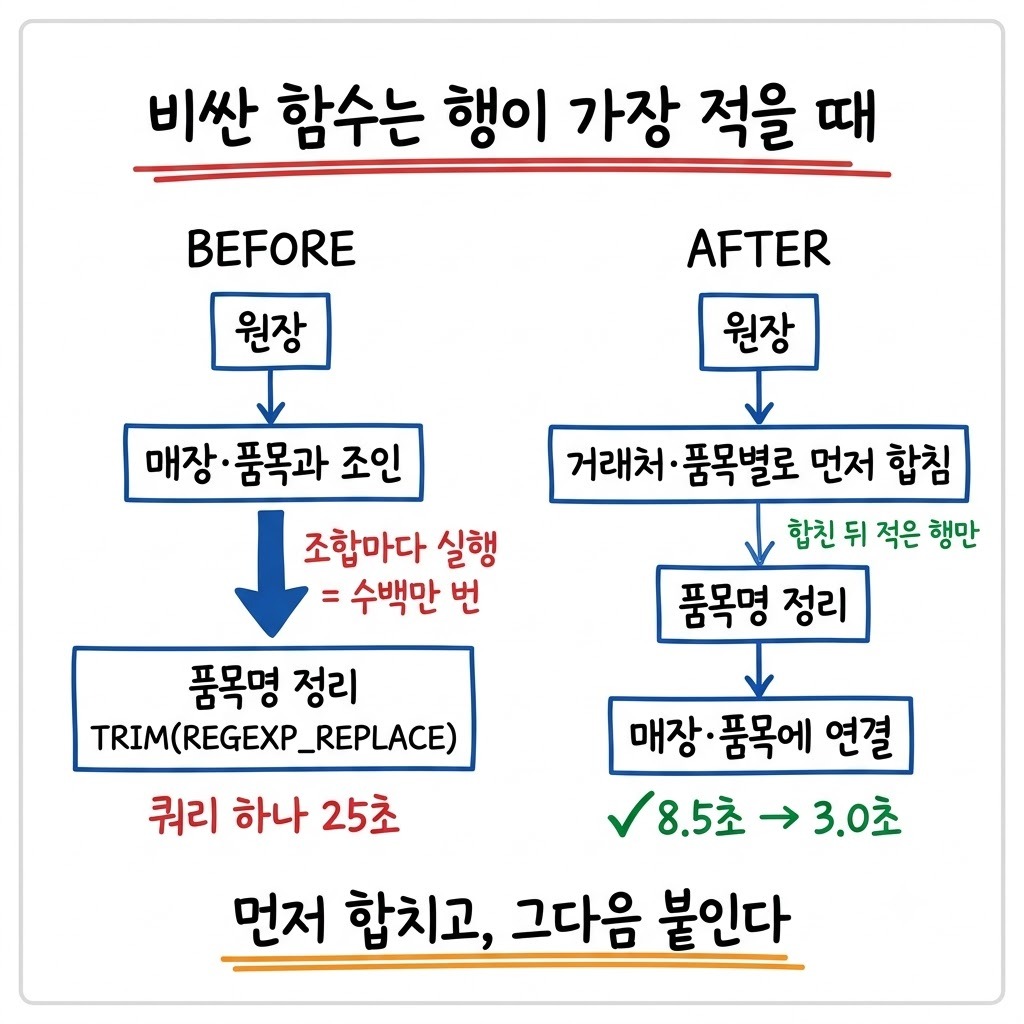
같은 구조의 쿼리 다섯 곳에 같은 방식을 적용했습니다. 화면에서 잰 결과는 아래와 같습니다.
화면 | 전 | 후 |
|---|---|---|
담당자별 요약 10개월 | 8.5초 | 3.0초 |
담당자별 요약 10개월 (운영 환경) | 8.3초 | 2.4초 |
담당자별 요약 22개월 | 16초 | 4.3초 |
전기 비교 팝업 | 1.9초 | 0.46초 |
기간이 길수록 효과가 컸습니다. 22개월 조회는 약 3.7배 빨라졌습니다.
이 다섯 곳 말고 따로 시도했다가 되돌린 쿼리가 둘 있습니다. 기간 비교 물류 쿼리는 같은 방식으로 고쳤더니 5.4초에서 8.0초로 오히려 느려졌습니다. 애플리케이션에서 실행되는 실행계획이 이미 빨랐던 쿼리였습니다. 매장 매입 원장 행 쿼리는 효과가 없었습니다. 둘 다 원래대로 되돌렸습니다.
DB 가 이미 좋은 실행계획을 고르고 있는 쿼리는 손대면 손해입니다. 고치기 전에 실행계획부터 보는 이유는 예전 글에 적어 두었습니다.
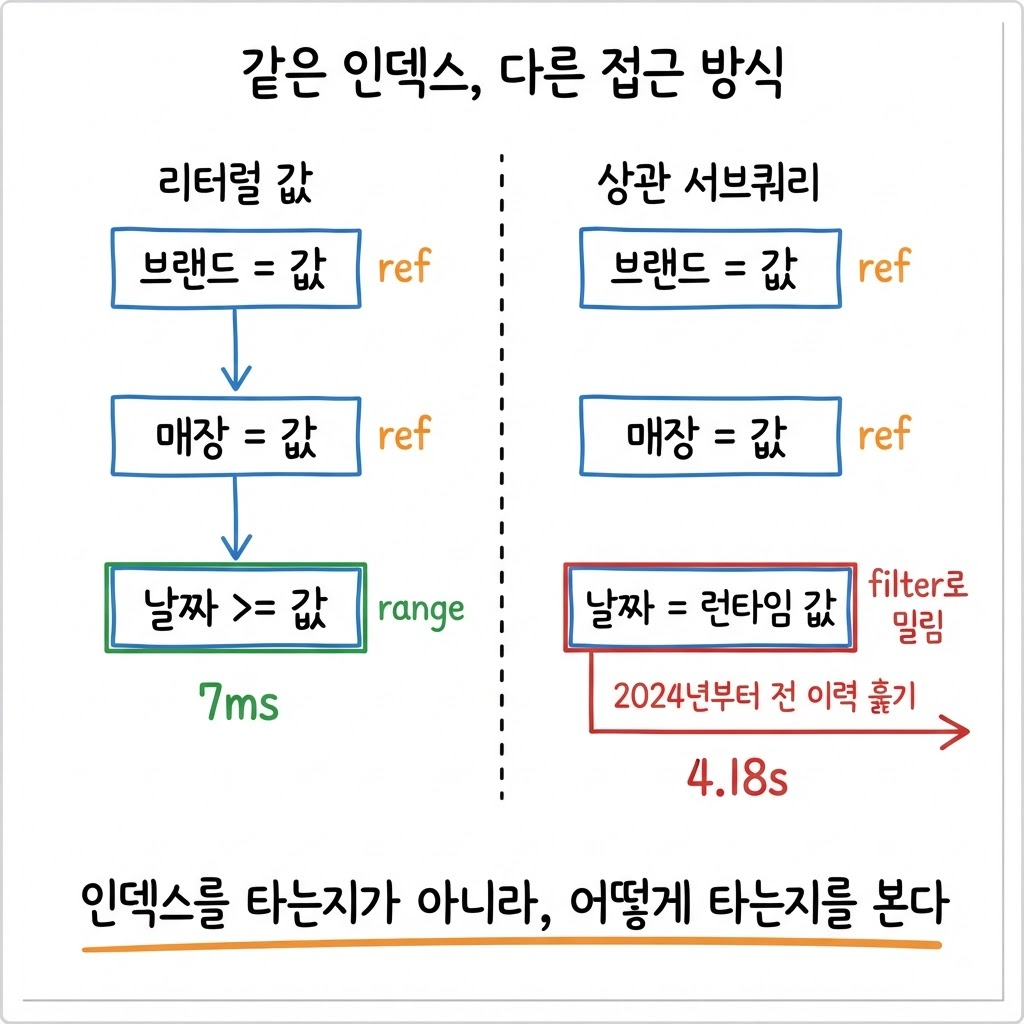
같은 처방이 모든 쿼리에 맞지 않는다는 점은 앞선 글에서 품목명 정규식 쿼리 여덟 곳을 하나씩 재며 정리했습니다. 여기서는 그 뒤의 검증 이야기로 넘어갑니다.
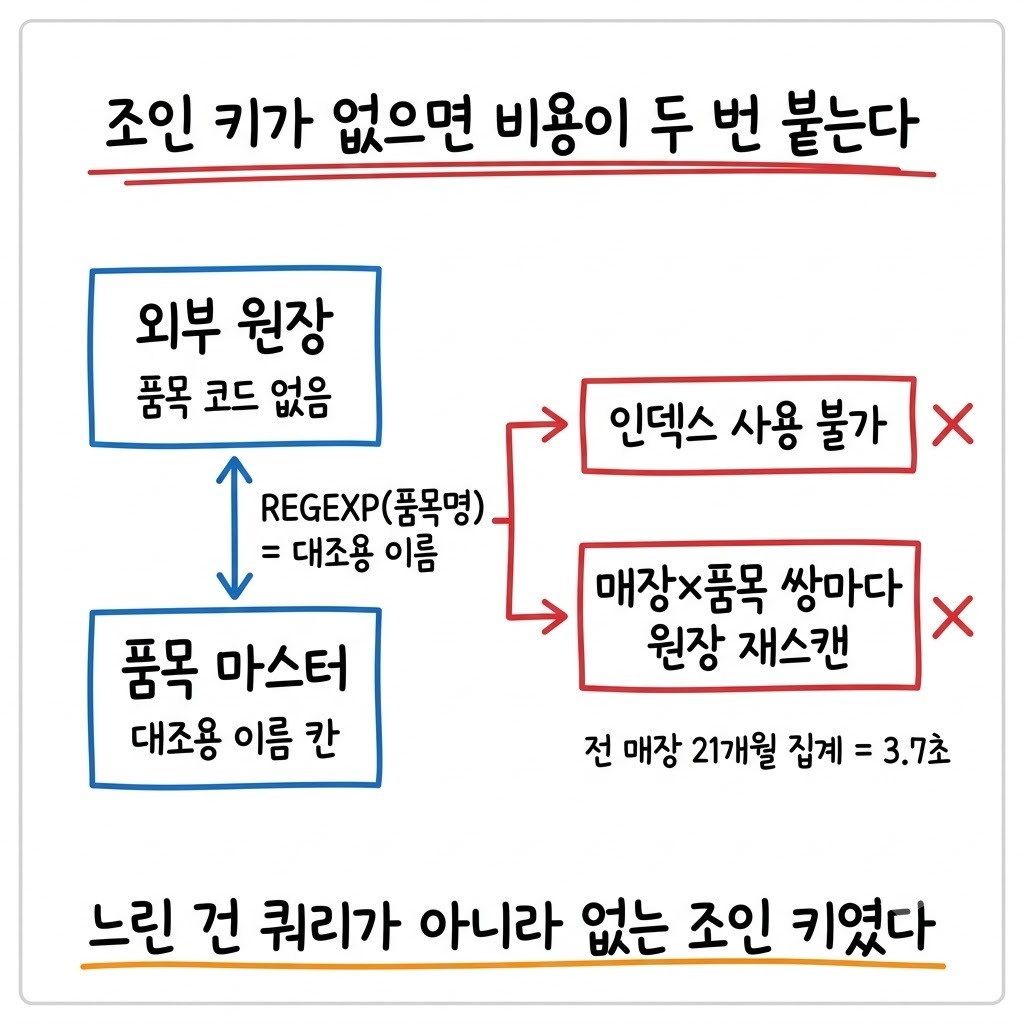
결과가 같은지는 두 겹으로 확인했습니다
빨라진 쿼리가 다른 값을 내면 속도는 의미가 없습니다. 판정 결과가 바뀌면 담당자가 보는 '이상 발주' 목록이 달라지기 때문입니다. 그래서 결과가 같은지를 두 겹으로 확인했습니다.
쿼리 출력 비교: 10개월·2025년 한 해·1개월, 세 기간을 전 매장으로 수정 전후 출력을 diff
화면 API 비교: 24개 조합의 응답을 수정 전후 바이트 단위로 비교
화면 API 쪽은 수정 전 응답을 먼저 두 번 받아 같은 값이 나오는지부터 봤습니다. 원래부터 실행할 때마다 달라지는 값이 있으면 그 차이를 수정 탓으로 오해하게 됩니다.
수정 전 기준이 흔들리지 않는다는 것을 확인한 뒤에 수정 후 응답과 비교했습니다. 24개 중 23개가 바이트까지 같았고, 1개는 순서만 달랐습니다.
결과 동일성 대조를 완료 조건에 넣는 방식은 예전 집계 최적화 때부터 써 온 것입니다.
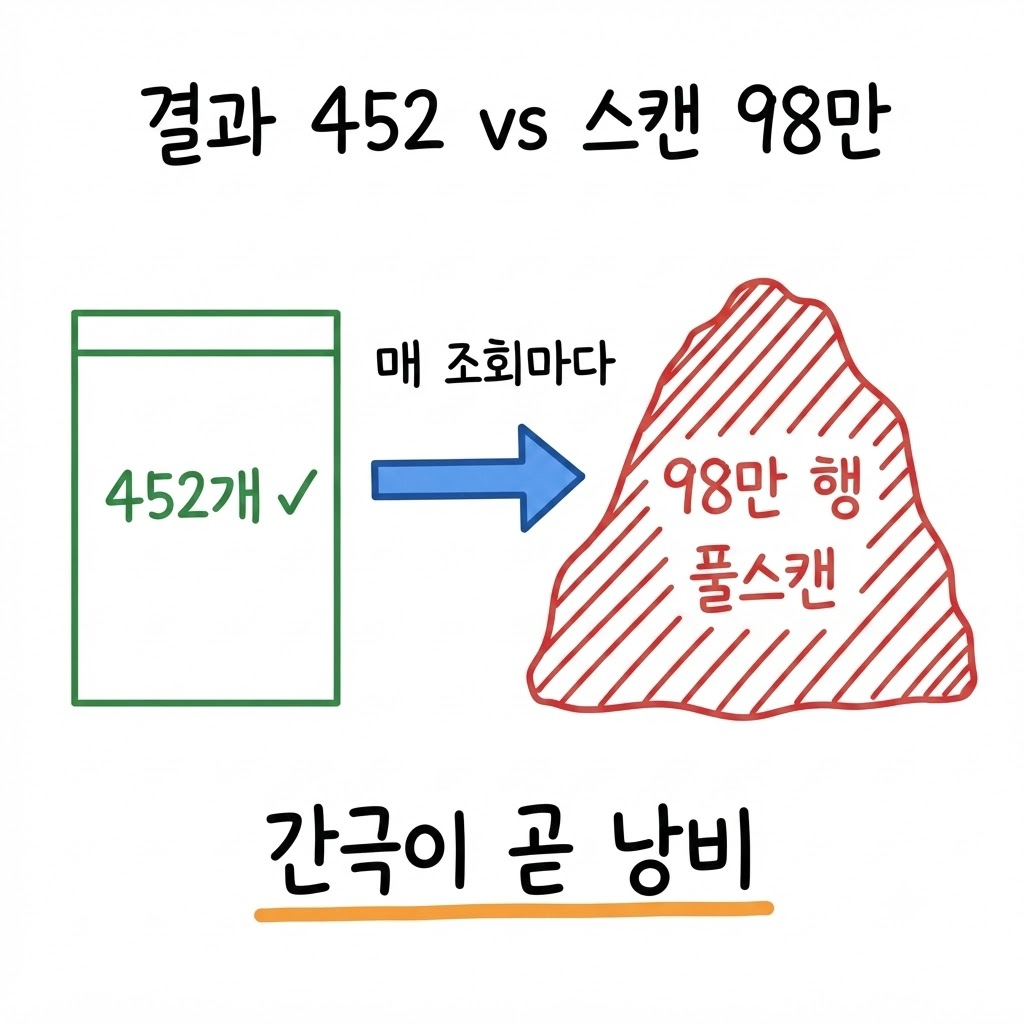
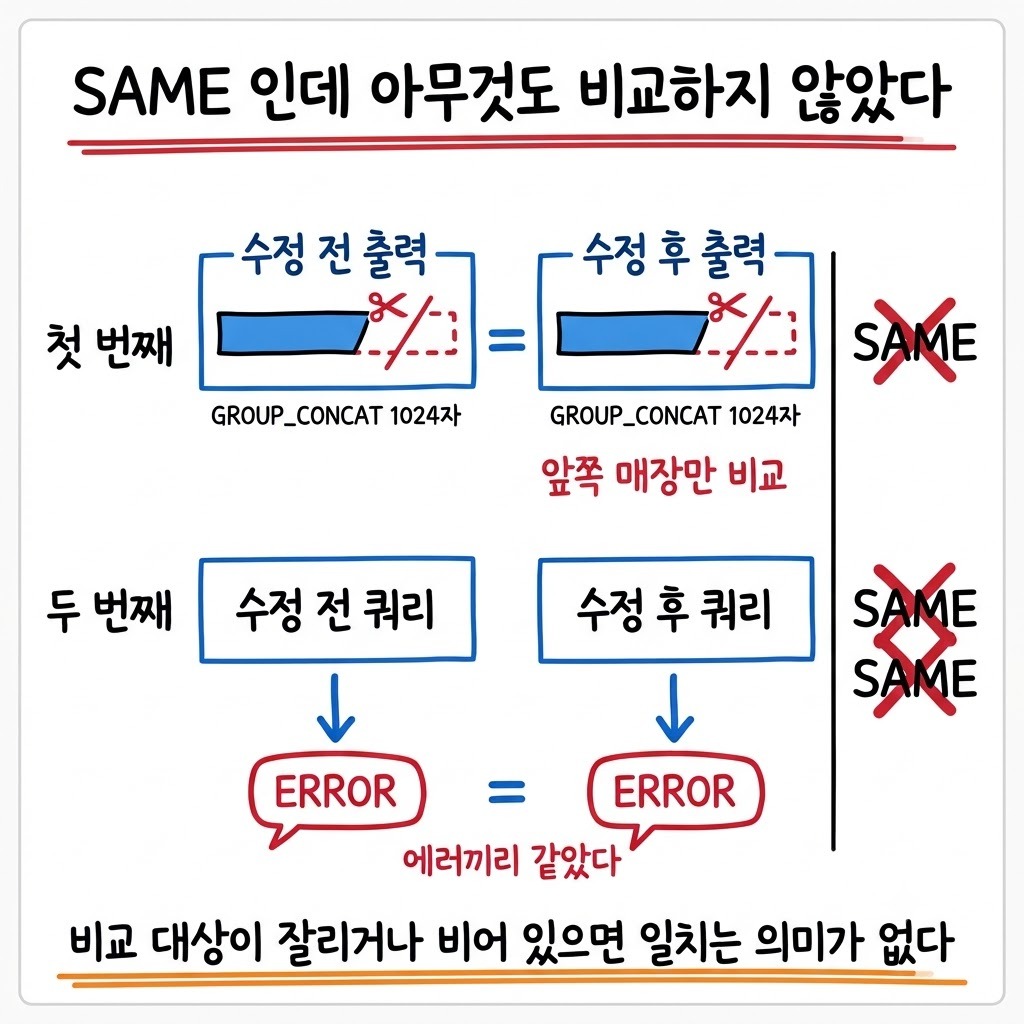
여기까지는 계획대로였습니다. 문제는 쿼리 출력 비교 쪽에서 나왔습니다. 비교 스크립트가 두 번, 근거가 없는데도 '같다'는 판정을 낼 뻔했습니다.
첫 번째: 비교 스크립트가 일부 매장만 보고 있었습니다
비교 스크립트는 매장별 값을 'GROUP_CONCAT'(여러 행의 값을 문자열 하나로 이어 붙이는 MySQL 함수)으로 한 줄로 만든 뒤, 수정 전후의 그 문자열을 비교했습니다. 문자열이 같으면 전 매장이 같다고 보는 구조였습니다.
그런데 'GROUP_CONCAT' 은 기본 길이 상한이 1024자입니다. 상한을 넘으면 에러 없이 뒷부분을 잘라 냅니다. 처음 비교는 1024자 안에 들어간 **일부 매장만** 비교하고 있었습니다.
잘려 나간 쪽 매장의 값이 달랐어도 결과는 '같다'로 나왔을 겁니다. 'group_concat_max_len'(이어 붙일 최대 길이 설정)을 올리고 전 매장으로 다시 비교했습니다.
두 번째: 두 쿼리가 같은 에러를 내서 SAME 이 나왔습니다
두 번째는 셸에서 생겼습니다. zsh 에서 인자가 의도대로 나뉘지 않은 채 스크립트로 넘어간 적이 있었습니다. 그러자 수정 전 쿼리와 수정 후 쿼리가 **똑같은 에러**를 냈습니다.
비교 스크립트는 두 출력이 같으니 'SAME' 을 출력했습니다. 스크립트만 보면 틀린 판정은 아닙니다. 두 출력은 실제로 글자 하나까지 같았습니다. 다만 비교한 것이 쿼리 결과가 아니라 에러 메시지였습니다.
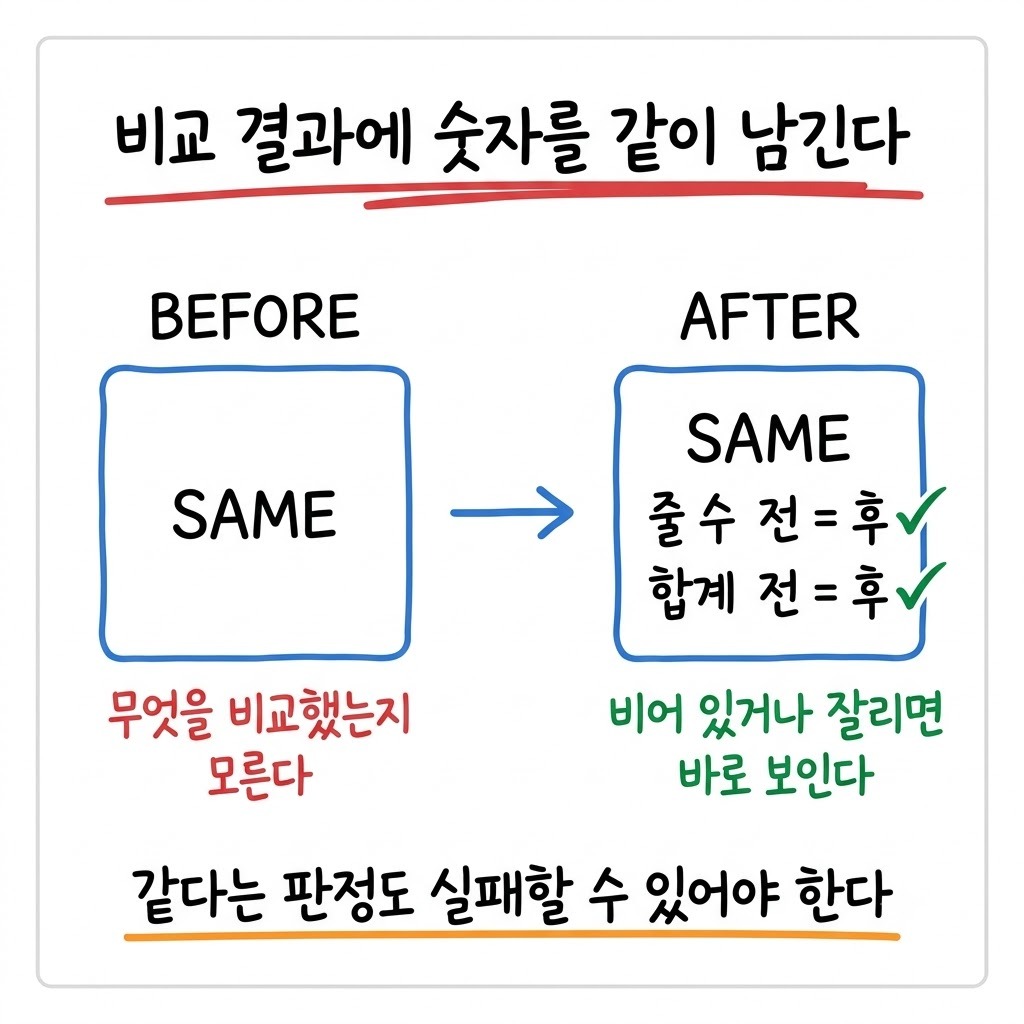
같다는 판정도 실패할 수 있어야 합니다
두 경우 모두 비교 자체는 정확했습니다. 비교 대상이 잘려 있거나 쿼리 결과가 아니었을 뿐입니다. 비교 대상이 온전하지 않으면 '같다'는 판정은 아무것도 증명하지 못합니다.
그래서 비교 스크립트가 '같다/다르다'만 출력하지 않고, **줄 수와 합계를 함께 출력**하도록 바꿨습니다. 에러 메시지끼리 비교하면 합계가 나오지 않습니다. 문자열이 잘렸으면 줄 수나 전체 길이가 기대와 다르게 나옵니다. 숫자 몇 개를 같이 보면 두 경우 모두 바로 드러납니다.
쿼리를 고친 뒤 결과 비교에서 확인할 것
수정 전 결과를 두 번 받아 같은 값이 나오는지부터 확인했는가
비교 결과에 줄 수·합계·전체 길이가 함께 나오는가
'GROUP_CONCAT' 처럼 길이 상한이 있는 함수로 결과를 이어 붙여 비교하지 않는가
일부 기간·일부 매장이 아니라 전 범위를 비교했는가
두 쪽이 모두 에러이거나 비어 있을 때 '같다'가 아니라 실패로 나오는가
고친 것과 남은 것
속도 개선은 순서 하나를 바꾼 일이었습니다. 비싼 함수는 행이 가장 적을 때 실행합니다. 먼저 합치고, 그다음 붙입니다.
다만 이 방법은 품목을 맞추는 규칙이 거래처·품목 수준에서 정해질 때만 통합니다. 매장마다 규칙이 다르면 먼저 합칠 수 없습니다. 품목명을 쿼리마다 정리하는 것 자체가 근본 원인일 수도 있습니다. 정리된 이름을 컬럼으로 저장하거나 매핑 표를 두는 쪽이 더 나은 답일 수 있는데, 이번에는 쿼리 순서만 바꿨습니다.
검증에도 한계가 남아 있습니다. 화면 API 24개 조합은 전체 경우의 일부입니다. 세 기간의 쿼리 출력 diff 로 보완했지만 모든 기간을 본 것은 아닙니다.
이번 일에서 더 오래 남는 쪽은 검증입니다. 두 번의 'SAME' 은 겉으로는 통과였고, 둘 다 근거가 없었습니다. 지금은 비교 결과를 볼 때 '같다'보다 줄 수와 합계를 먼저 봅니다.