OCR 다섯을 같은 자로 재니 결론이 두 번 뒤집혔습니다
사내 문서 지식그래프 검색 도구가 PDF·이미지·슬라이드를 색인합니다. 그 안의 OCR 은 빌려 쓰는 사내 GPU 위에 올린 오픈 웨이트 범용 VLM(이미지와 글을 같이 읽는 모델) 하나로 돌고 있었습니다. 대여가 끝나면 색인이 멈춥니다.
그래서 로컬에서 도는 것으로 갈아탈 수 있나를 보려고 후보를 늘려 같은 문서로 쟀습니다. 재는 동안 결론이 두 번 뒤집혔고, 두 번 다 먼저 거짓말한 쪽은 모델이 아니라 측정하는 쪽이었습니다.
재기 전에 비교할 문서가 거의 없었습니다
후보를 다섯으로 놓았습니다. 사내 GPU 의 범용 VLM(Gemma-4-31B-it) · 고전 검출과 인식을 잇는 PP-OCRv5(CPU 에서 도는 18MB) · 문서 파싱 전용 VLM(PaddleOCR-VL-1.6, 0.9B, 애플 실리콘 맥에서 동작) · DeepSeek-OCR 을 이어 학습한 VLM(3.34B) · 상용 API(gemini-3.5-flash-lite, temperature 0).
첫 실행이 12초에 끝나서 이상했습니다. 텍스트 층을 세 보니 전체 PDF 중 글자 층이 아예 없는 진짜 스캔본은 4건뿐이었습니다. 나머지는 텍스트 층이 있어 OCR 자체가 돌지 않습니다. 비교 대상이 몇 건인지를 모른 채로 비교를 시작한 것이 첫 번째 잘못이었습니다.
1차 채점에서는 체크박스가 갈림길이었습니다
스캔본 신청서 8쪽을 원본 이미지로 직접 보면서 5칸을 채점했습니다. 성명·주소·기업명·체크 표시·장비 선택 칸입니다. 값은 적지 않고 맞췄는지만 셌습니다.
후보 | 5칸 중 맞춘 수 |
|---|---|
범용 VLM | 2 |
고전 OCR | 2 |
문서 파싱 전용 VLM | 4 |
이어 학습 VLM | 1 |
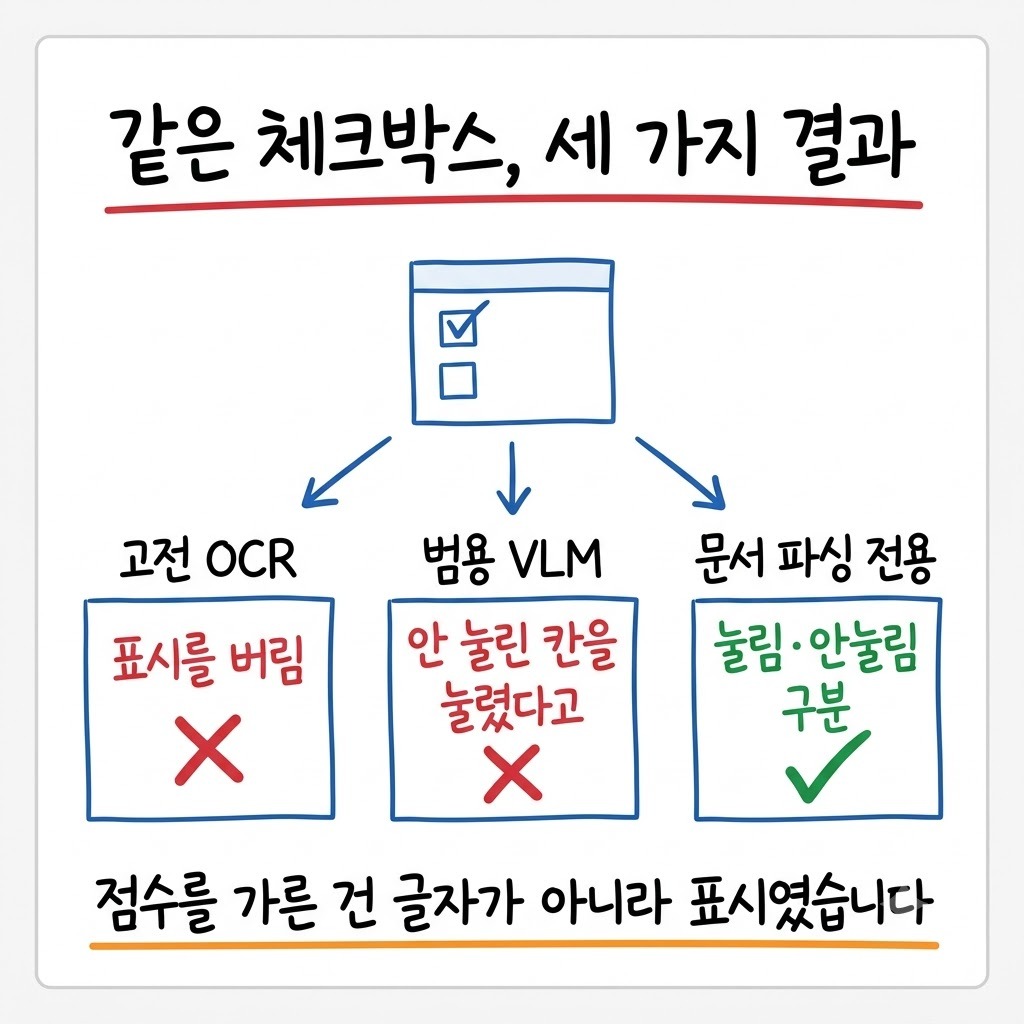
점수를 가른 것은 체크박스였습니다. 고전 OCR 은 표시를 통째로 버렸고, 범용 VLM 은 안 눌린 칸을 눌렸다고 적었습니다. 눌린 것과 안 눌린 것을 구분해 옮긴 것은 문서 파싱 전용 모델뿐이었습니다.
입력 종류를 바꾸니 순위가 반대로 뒤집혔습니다
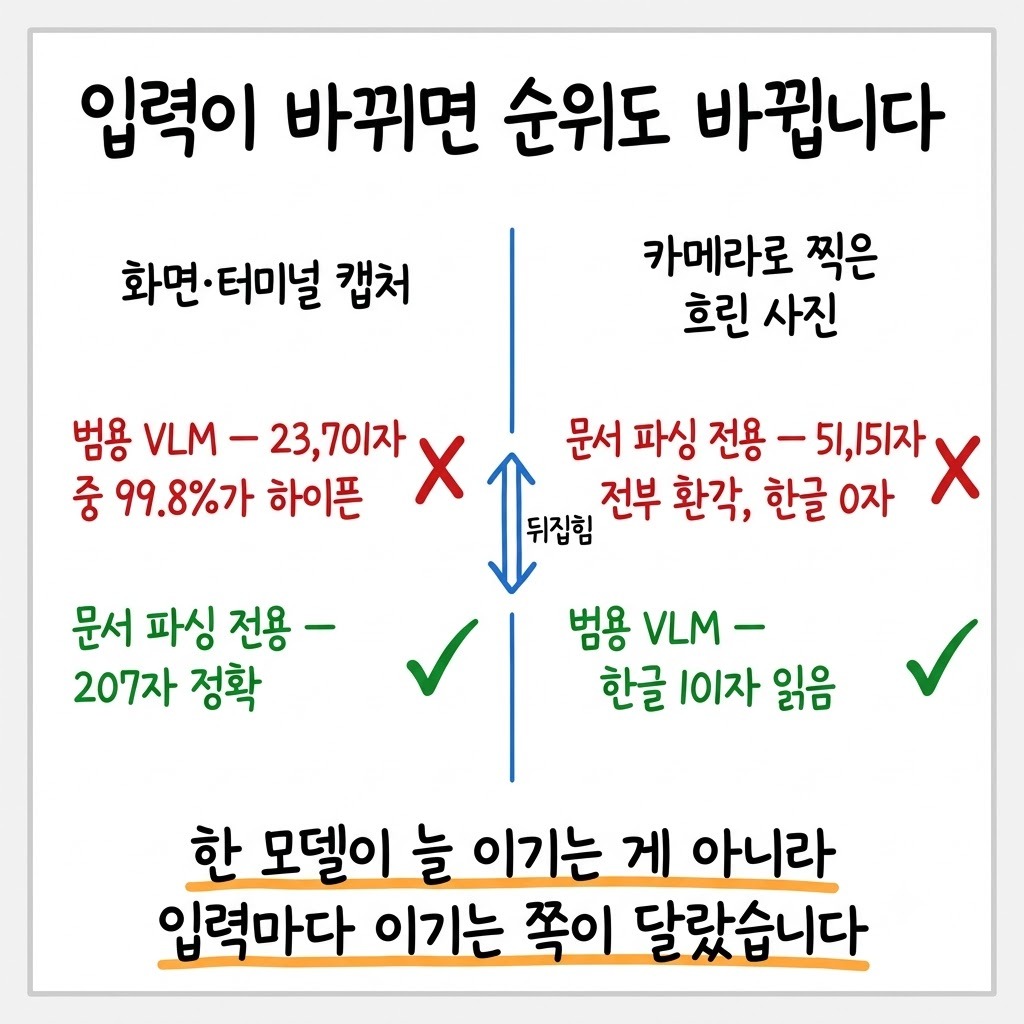
이미지 8건(터미널·화면·메일 캡처, 사진, 도표)으로 같은 자를 다시 댔습니다. 범용 VLM 이 터미널 캡처에서 23,701자를 뱉었는데 그중 99.8%가 하이픈이었습니다. 화면 캡처는 97.4%, 메일 캡처는 96.3%가 같은 문자 반복이었습니다. 같은 이미지를 문서 파싱 전용 모델은 207자·967자·837자로 정확히 읽었습니다.
반대 자리도 있었습니다. 카메라로 찍은 흐린 모니터 사진에서 문서 파싱 전용 모델은 51,151자를 냈는데 전부 중국어 환각이었고 한글은 0자였습니다. 같은 사진을 범용 VLM 은 5,336자(한글 101자)로 읽어 한국어 메뉴를 옮겼습니다.
상용 API 는 같은 8건에서 한 번도 무너지지 않았습니다. 반복 붕괴 0건이고, 흐린 사진에서도 1,430자 중 한글 436자로 가장 잘 읽었습니다. 대신 결과 앞에 '이미지가 흐릿하여' 같은 설명을 붙여서, 그게 그대로 색인됩니다.
여기서 1차 결론을 냈습니다. 입력 종류로 갈라 창구를 둘 두는 것입니다. 스캔본·화면 캡처·표는 문서 파싱 전용으로, 카메라로 찍은 사진은 범용 VLM 으로 보내고 한쪽이 무너질 때 다른 쪽이 받게 하는 그림이었습니다.
길이를 품질의 대리 지표로 읽은 자리에서 틀렸습니다
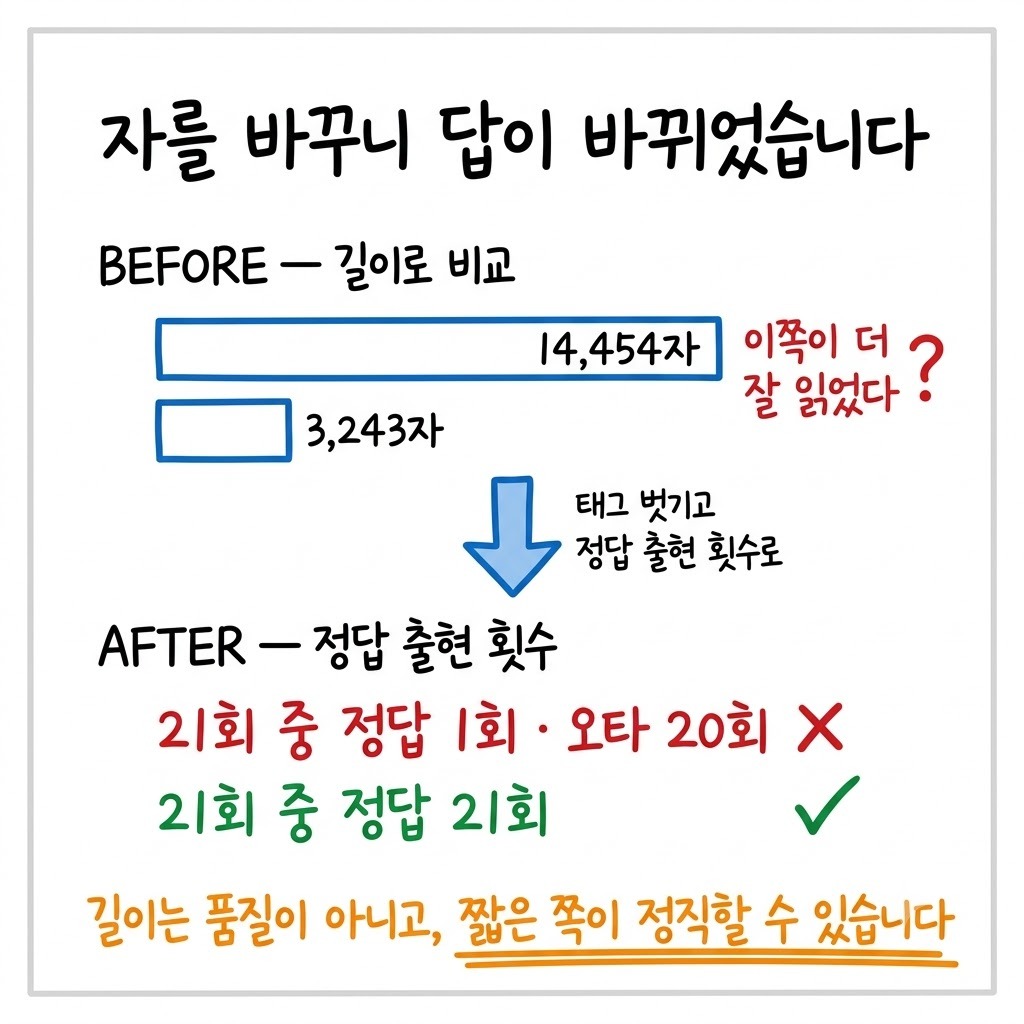
로그 표 캡처에서 문서 파싱 전용 14,454자, 상용 API 3,243자가 나왔습니다. 저는 '빽빽한 표에서는 상용 쪽이 줄을 자른다' 고 적었습니다. 그게 틀렸습니다.
마크업 태그를 벗기고 다시 세니 실제 글자는 4,279자 대 3,243자였습니다. 마크업을 내는 모델과 평문을 내는 모델은 애초에 길이로 비교가 되지 않습니다. 그리고 잘렸다고 본 그 줄은 원본에서 모달 대화상자가 그 자리를 덮고 있어서 거기까지만 보이는 것이었습니다. 짧은 쪽이 정직했고, 긴 쪽이 가려진 자리를 표에 채워 넣었습니다.
그래서 자를 바꿨습니다. 정답 문자열이 몇 번 나왔는지로 셉니다. 로그 테이블 이름은 문서 파싱 전용이 21회 중 정답 1회·오타 20회였고, 타임존 표기는 정답 0회·오식 20회였습니다. 상용은 각각 21회 중 21회, 20회 중 20회였습니다.
스캔본도 칸별로 다시 쟀습니다. 눌린 칸 6개를 원본 이미지로 하나씩 확인해 채점하니 범용 VLM 4개, 문서 파싱 전용 5개, 상용 5개였습니다. 스캔본은 동률이고 이미지는 상용 우세입니다. 1차 결론이 여기서 무너졌습니다.
세 번 더 틀렸는데 전부 제 호출 쪽이었습니다
재는 동안 못 쓸 결과가 세 번 더 나왔고, 세 번 다 모델이 아니라 제가 모델을 부른 방식이 원인이었습니다.
한 쪽이 0자로 나왔습니다. 추론 함수의 평가 모드 기본값이 꺼져 있어서 결과를 화면으로 흘려보내고 반환값은 None 을 주고 있었습니다
8쪽이 2자로 나왔습니다. 다중 페이지 함수가 튜플을 돌려주는데 그걸 문자열로 보고 길이를 쟀습니다
한자가 무한 반복됐습니다. 그 저장소가 같이 배포하는 반복 방지 처리기를 제가 걸지 않았습니다
세 번째가 특히 아팠습니다. 저장소의 실행 스크립트에 박힌 상수는 장식이 아니라, 없으면 결과가 무너지기 때문에 거기 있는 것입니다. 모델을 재기 전에 그 스크립트가 넘기는 인자를 그대로 베끼는 편이 빠릅니다.
이어 학습 VLM 은 후보에서 뺐습니다. 한국어에 중국 글자가 섞였고, 거의 빈 쪽에 1,400행짜리 표를 지어냈고, 쪽당 63초였습니다. 문서 파싱 전용이 로컬 맥에서 46쪽을 160초에 끝낸 것과 비교하면 쪽당 7배입니다. 다만 이 수치는 그 모델이 의도한 하드웨어에서 잰 것이 아닙니다. '우리 환경에서 못 쓴다' 의 근거일 뿐이고 모델 평가로 인용하면 틀린 인용이 됩니다.
실패가 에러로 오지 않았습니다
이미 색인된 쪽도 확인했습니다. OCR 로 들어간 문서를 같은 글자 50회 이상 연속이라는 기준으로 훑으니 3건이 본문의 96~99%가 반복 문자였습니다. 그 셋이 청크 78개와 벡터 78개를 차지하고 있었습니다.
예외는 하나도 나지 않았습니다. 오히려 글자를 가장 많이 뽑은 문서 1·2·3위로 보였습니다. 표본을 글자 수 순으로 고르지 않았으면 못 봤을 자리입니다. 그래서 가드를 하나 넣었습니다. 글자로 옮긴 결과(전사)에서 같은 글자 50회 이상 연속이 본문의 20%를 넘으면 실패로 보고 다른 창구로 넘기거나 그 구간을 잘라냅니다.
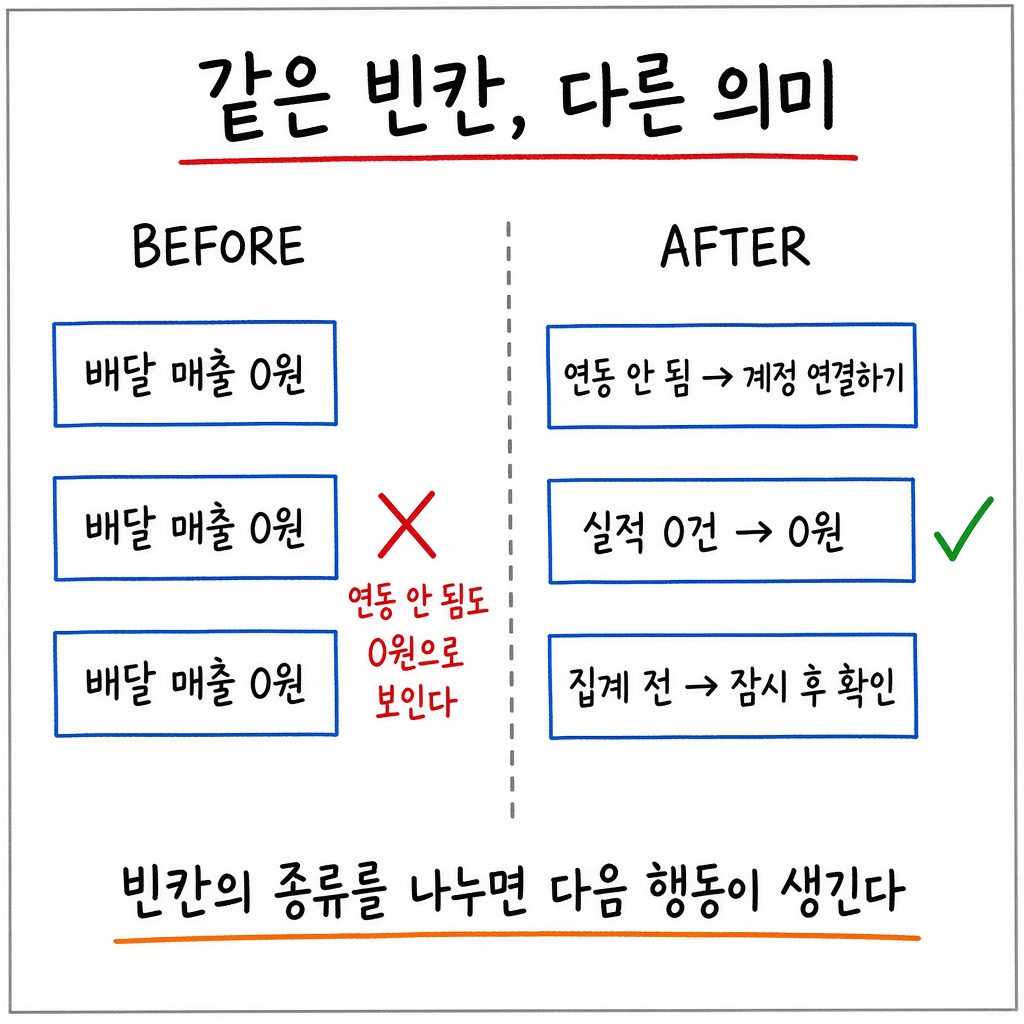
정상처럼 보이는 실패는 따로 검사를 붙여야만 보입니다. 집계가 아직 안 된 상태와 값이 0인 상태를 같은 빈칸으로 둔 대시보드도 같은 모양이었습니다.
다 재고 나니 선택 기준이 품질이 아니었습니다
최종 결과는 이렇습니다. 전송이 허용되는 조직이라면 상용 창구 하나로 끝납니다. 스캔본은 동률이고 이미지에서는 상용이 앞서고, 반복 붕괴가 0건이라 가드를 걸 이유도 줄어듭니다. 문서 파싱 전용 모델을 쓸 이유는 자료를 밖으로 못 내보낼 때 하나뿐이었습니다.
그 시스템은 여전히 로컬 쪽을 씁니다. 고객 자료를 반출하지 않기로 코드 수준에서 정해 둔 상태이고, 상용은 쓴 만큼 내는 과금이라 크레딧이 마르면 색인이 멈춥니다. 선택은 그대로인데 이유가 바뀌었습니다. 품질이 좋아서가 아니라 제약 때문입니다.
이 구분을 적어 두는 것이 중요합니다. 품질 비교가 선택의 근거라고 적으면, 나중에 그 선택을 바꿀 조건이 보이지 않습니다. 제약 때문이라고 적으면 제약이 없어지는 날 바꾼다는 조건부 메모가 됩니다. 곁다리 소득도 하나 있었습니다. 문서 파싱 전용 모델은 애플 실리콘 맥에서 돌아서, 지금 대여 GPU 에 묶여 있는 OCR 이 그 의존에서 풀립니다.
모델을 비교하기 전에 볼 것
길이로 비교하지 않습니다. 마크업을 내는 모델과 평문을 내는 모델은 길이가 다른 단위입니다. 태그를 벗기고 정답 문자열의 출현 횟수로 셉니다
원본을 직접 본 사람만 채점합니다. '이 모델이 줄을 잘랐다' 가 사실은 '원본이 거기까지만 보였다' 였습니다
재기 전에 그 저장소의 실행 스크립트가 넘기는 인자를 그대로 베낍니다. 측정 코드가 모델보다 먼저 틀립니다
에러가 안 나는 실패에는 따로 검사를 붙입니다. 반복 붕괴는 예외 없이 지나가고 글자를 가장 많이 뽑은 문서로 보입니다
선택 기준이 품질인지 제약인지를 나눠 적습니다
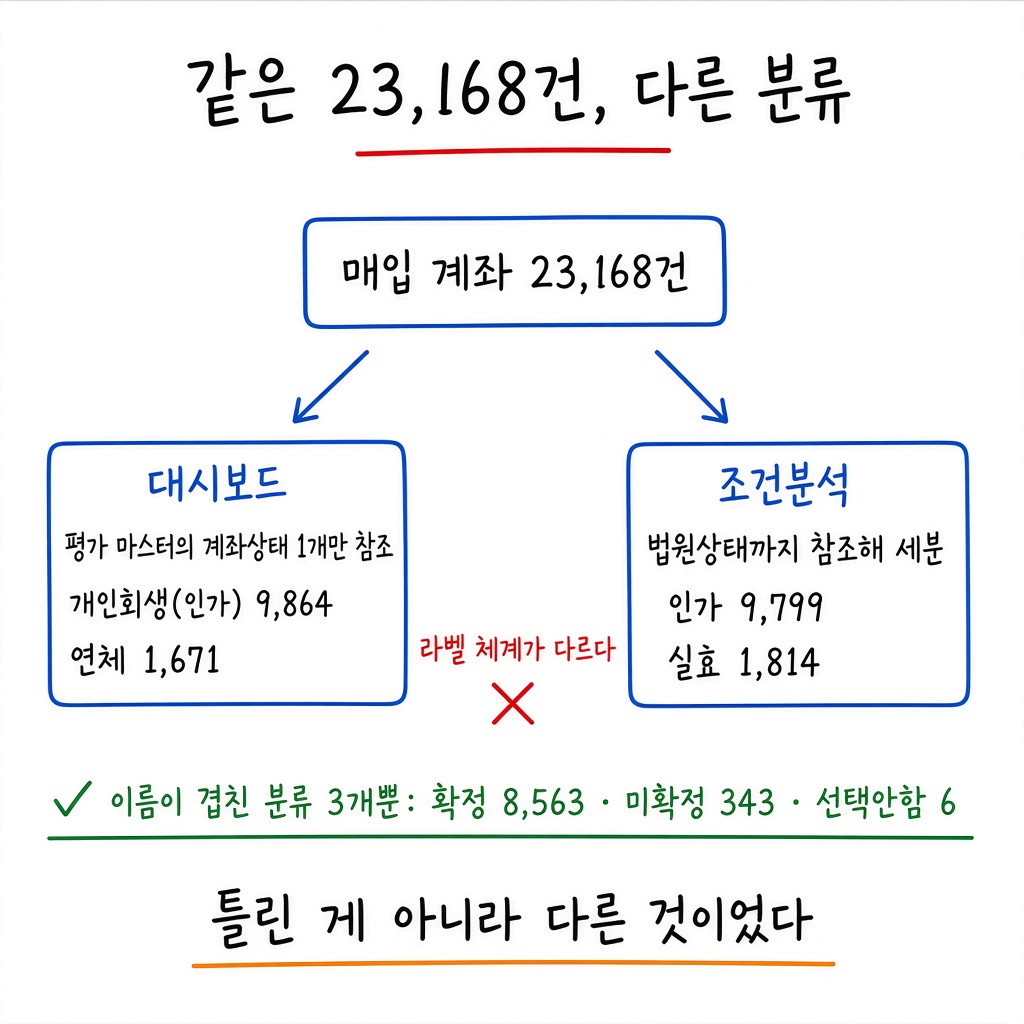
같은 대상을 두 자로 재면 결론이 둘로 갈립니다. 같은 계좌를 두 화면이 다르게 분류한 일도 자가 두 개였기 때문이었습니다.
이 결과의 범위도 적어 둡니다. 표본은 스캔본 4건과 이미지 8건입니다. 입력 분포가 바뀌면 결론도 바뀌고, 카메라로 찍은 사진 비중이 큰 곳이라면 문서 파싱 전용 모델은 여전히 쓸 수 없습니다. 반복 20% 가드도 문턱을 손으로 정한 값입니다. 다섯을 재서 남은 것은 순위표가 아니라 다음에 다시 잴 때 쓸 자 하나였습니다.