LLM 평가 지표가 33%에서 51%로 올랐는데, 틀린 답이 맞음으로 세어졌습니다
사내 문서 지식그래프 검색 도구의 답변 품질을 회차마다 같은 문항 63개로 잽니다. 13회차는 모델을 한 세대 올린 뒤의 재측정이었습니다. 숫자는 전부 좋아진 방향으로 나왔고, 그대로 '좋아졌습니다' 한 줄로 닫을 수 있는 회차였습니다.
그렇게 결론 내리지 않은 이유는 하나입니다. 지표가 올랐다는 것과 답이 좋아졌다는 것이 같은 말이 아니었습니다.
숫자는 전부 좋은 방향이었습니다
63문항 전부 응답이 돌아왔고 실패는 없었습니다. 회차 사이의 변화는 이렇게 나왔습니다.
항목 | 12회차 | 13회차 |
|---|---|---|
도구 일치 | 21/63(33%) | 32/63(51%) |
지연 평균 | 15.0초 | 7.5초 |
답 길이 평균 | 739자 | 286자 |
근거 칸 평균 | 14.3 | 10.3 |
'도구 일치'는 평가표에 문항마다 적어 둔 기대 도구와 실제로 그 질문을 받은 도구가 같은지를 센 값입니다. 라우팅이 제자리를 찾고 있는지를 보는 지표입니다. 답이 짧아지고 근거 칸이 줄어든 것도 나쁜 신호가 아니었습니다. 전 회차는 확신이 없을 때 근거를 더 끌어와 답을 늘리는 쪽이었습니다.
회차 사이에 달라진 항목도 유형별로 나눠 셌습니다. 도구가 바뀐 것 15문항, 근거가 바뀐 것 25문항, 문장만 바뀐 것 17문항, 그대로인 것 6문항입니다. 이 중 문장만 바뀐 17문항은 다시 판정하지 않기로 했습니다. 표현 차이는 모델 변덕이라 판정 노동만 들고 결론이 안 바뀝니다.
틀린 답 하나가 맞음으로 세어졌습니다
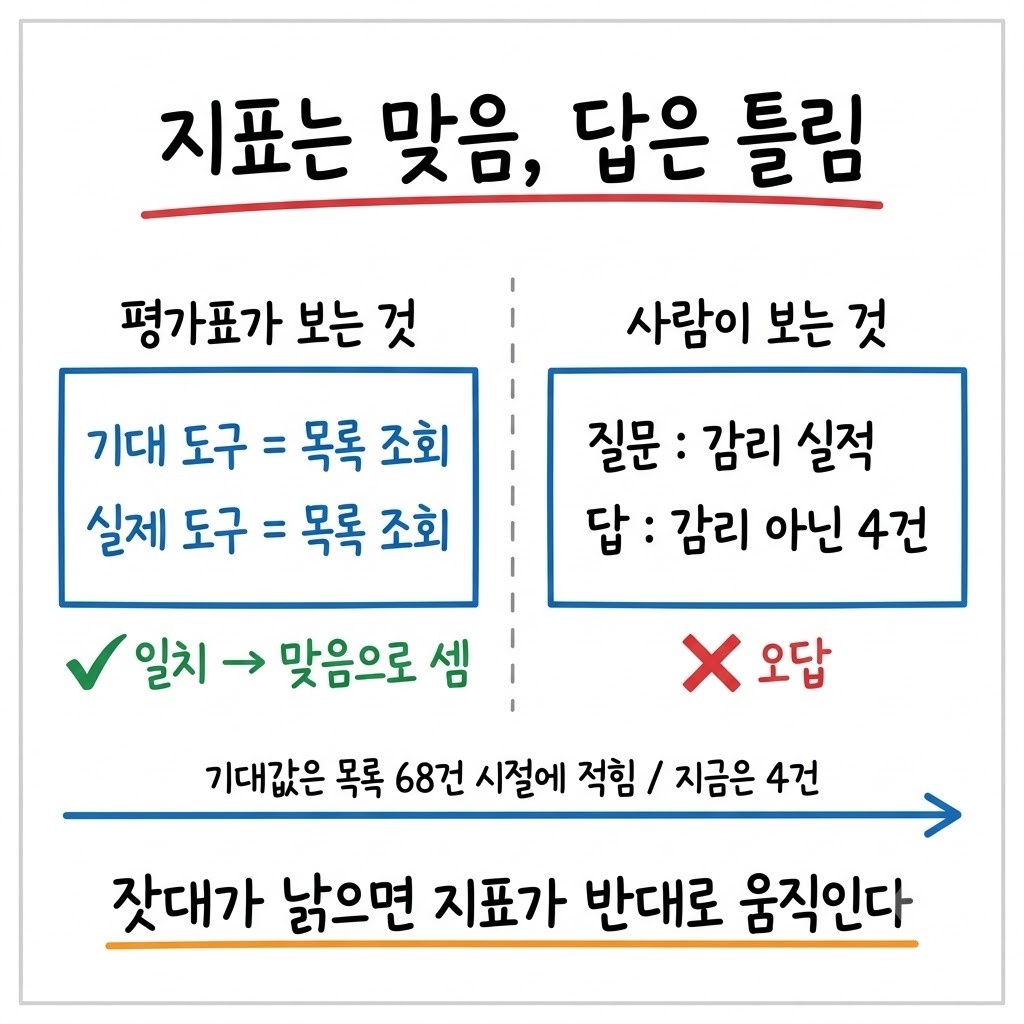
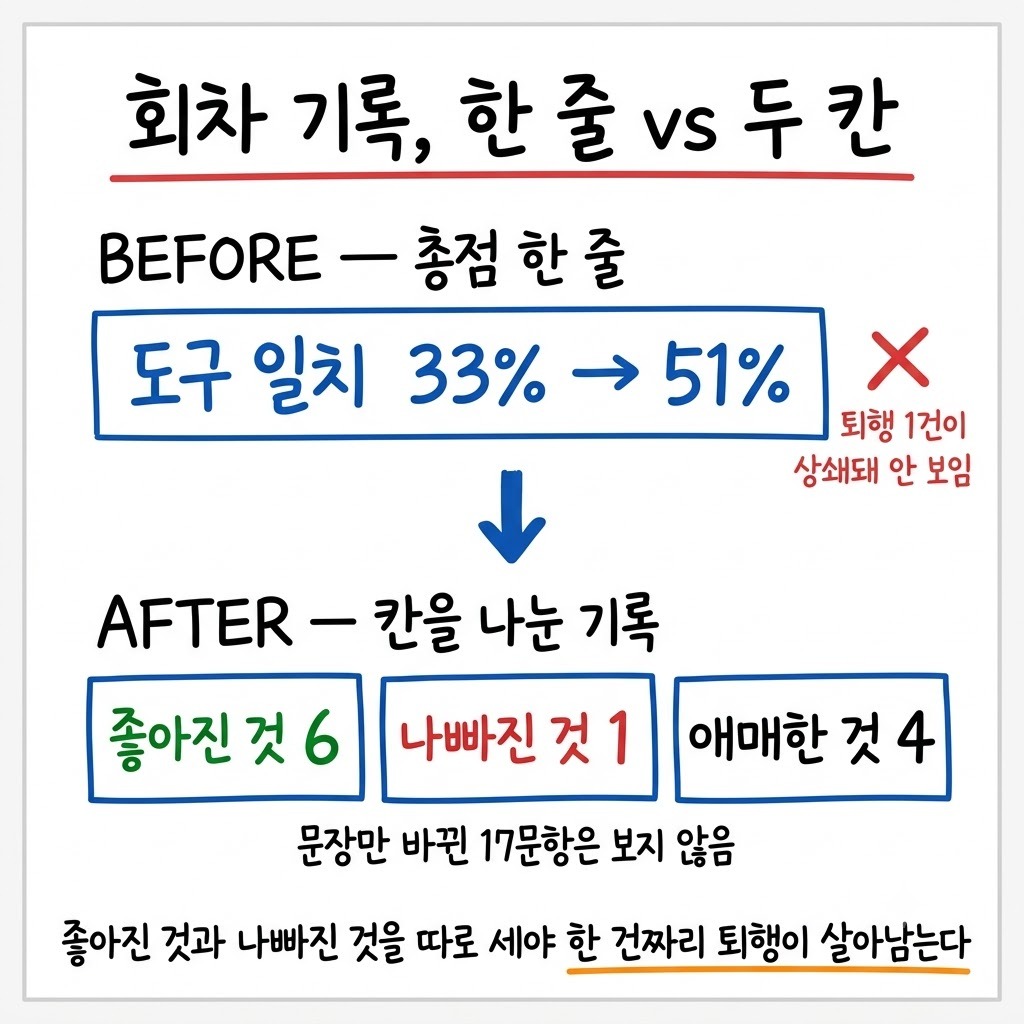
다시 판정한 문항을 좋아진 것 6 · 나빠진 것 1 · 애매한 것 4로 갈랐습니다. 좋아진 쪽의 성격이 뚜렷했습니다. '그 발주처와 한 일이 있습니까' 같은 질문에 전에는 투입인력 이력이나 발주처 소개를 끌어와 답을 만들었는데, 지금은 '사업 목록에 없습니다. 폴더는 17개이니 폴더 이름으로 물어보세요'로 옵니다. 없는 것을 없다고 말하기 시작한 것입니다.
나빠진 것은 한 건이었습니다. '최근 1년간 감리 사업 실적'을 물었더니 감리와 무관한 사업 4건을 전부 냈습니다. 앞 회차에서는 이 질문을 문서 검색이 받아 '확인할 수 없습니다'라고 답했고, 프리랜서 경력과 발주처 요구까지 구분해 설명했습니다. 한 회차 만에 명백히 퇴행한 문항입니다.
문제는 평가 방식에 있었습니다. 그 문항이 도구 일치에서 맞음으로 세어졌습니다. 기대 도구와 실제로 받은 도구가 같았기 때문입니다. 기대값은 등록된 사업 목록이 68건이던 시절에 적힌 것이고, 지금 그 연도에 등록된 사업은 4건입니다. 데이터가 줄었으니 같은 도구가 받아도 답은 달라집니다. 그런데 잣대는 그대로였습니다.
답이 틀렸는데 지표는 올랐습니다. 이 한 건을 확인한 뒤로 51%라는 숫자를 그대로 쓸 수 없게 됐습니다.
원인은 모델이 아니라 정확해진 라우터가 드러낸 구멍이었습니다
처음엔 모델 교체의 부작용으로 봤습니다. 따라가 보니 라우팅의 마지막 층이었습니다. 질문 유형을 알아보지 못해도 연도만 들어 있으면 그대로 통과해 그 해 사업을 전부 내놓는 자리가 있었습니다. 감리라는 낱말은 아무 역할을 못 했습니다.
같은 자리에서 '올해 새로 시작한 컨설팅 사업 목록'도 같은 방식으로 답했습니다. 앞 회차에는 태그를 보는 층이 이 질문을 정확히 받았는데, 그 층을 이틀 전에 걷어낸 상태였습니다. 라우터가 앞쪽에서 정확해질수록 마지막 층으로 흘러드는 질문이 늘었고, 거기 있던 구멍이 그제야 드러났습니다.
오른 숫자를 그대로 믿지 않는 습관은 성능 쪽에서도 같은 역할을 합니다.
원인을 말하고 나서 재봤더니 다른 답이 나왔던 사례도 같은 자리에 있습니다.
네 가지 방안 중 모르면 답하지 않는 방식을 골랐습니다
무관한 4건을 낸 문항을 놓고 선택지가 넷이었습니다.
선택지 | 내용 | 판단 |
|---|---|---|
A | 낱말표에 감리를 더한다 | 접음 — 다음엔 PMO 가 오고 그 다음엔 보안진단이 온다 |
B | 등록된 사업 목록의 유형 칸을 채운다 | 접음 — 사용자가 사업을 직접 등록할 일이 없다고 했다 |
C | 라우터가 질문에서 유형을 뽑게 한다 | 접음 — B 가 비어 있으면 뽑아도 맞춰 볼 데가 없다 |
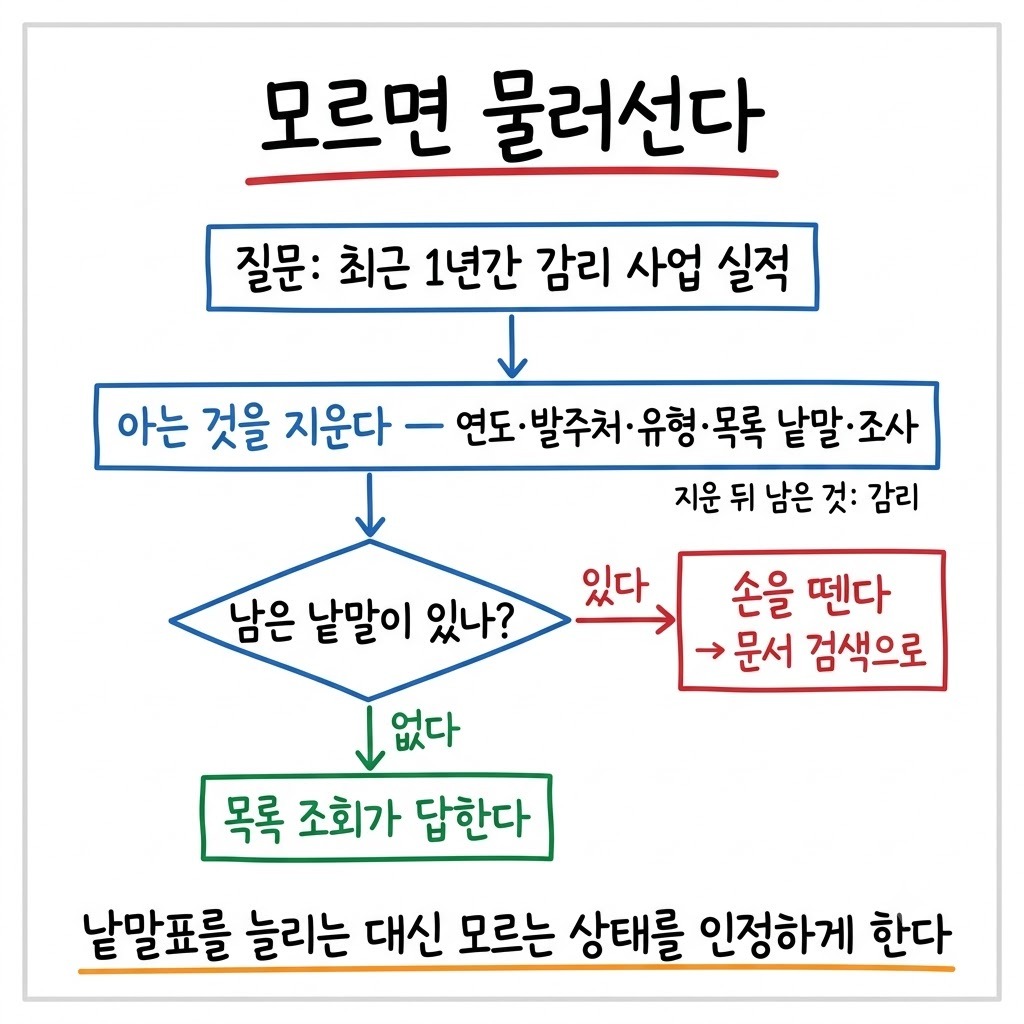
D | 모르면 물러선다 | 채택 |
A 부터 C 까지는 시스템이 더 알게 하는 방향이고, D 는 모르는 상태를 인정하게 하는 방향입니다. 앞쪽은 도메인 낱말이 늘어나는 만큼 유지비가 같이 늘고, 뒤쪽은 낱말이 늘어도 그대로입니다.
D 는 이렇게 동작합니다. 질문에서 시스템이 아는 것을 전부 지웁니다. 연도, 발주처, 유형, 목록을 가리키는 낱말, 조사를 지우고 나서 낱말이 남으면 이 도구가 답하지 않게 합니다. 남은 낱말이 감리인지 PMO 인지는 판별하지 않습니다. 모르니까 답하지 않고, 답은 문서 검색이 합니다. 낱말표는 한 글자도 늘리지 않았습니다.
건수를 세어 답하는 자리에는 '등록된 목록에 있는 것만 셉니다. 지난 자료에는 더 있을 수 있습니다'를 같이 내보내도록 했습니다. 실제로 그 연도 문서에는 52건이 있고 등록된 목록에는 훨씬 적게 들어 있습니다.
개선된 항목뿐 아니라 악화된 항목도 전수로 셌습니다
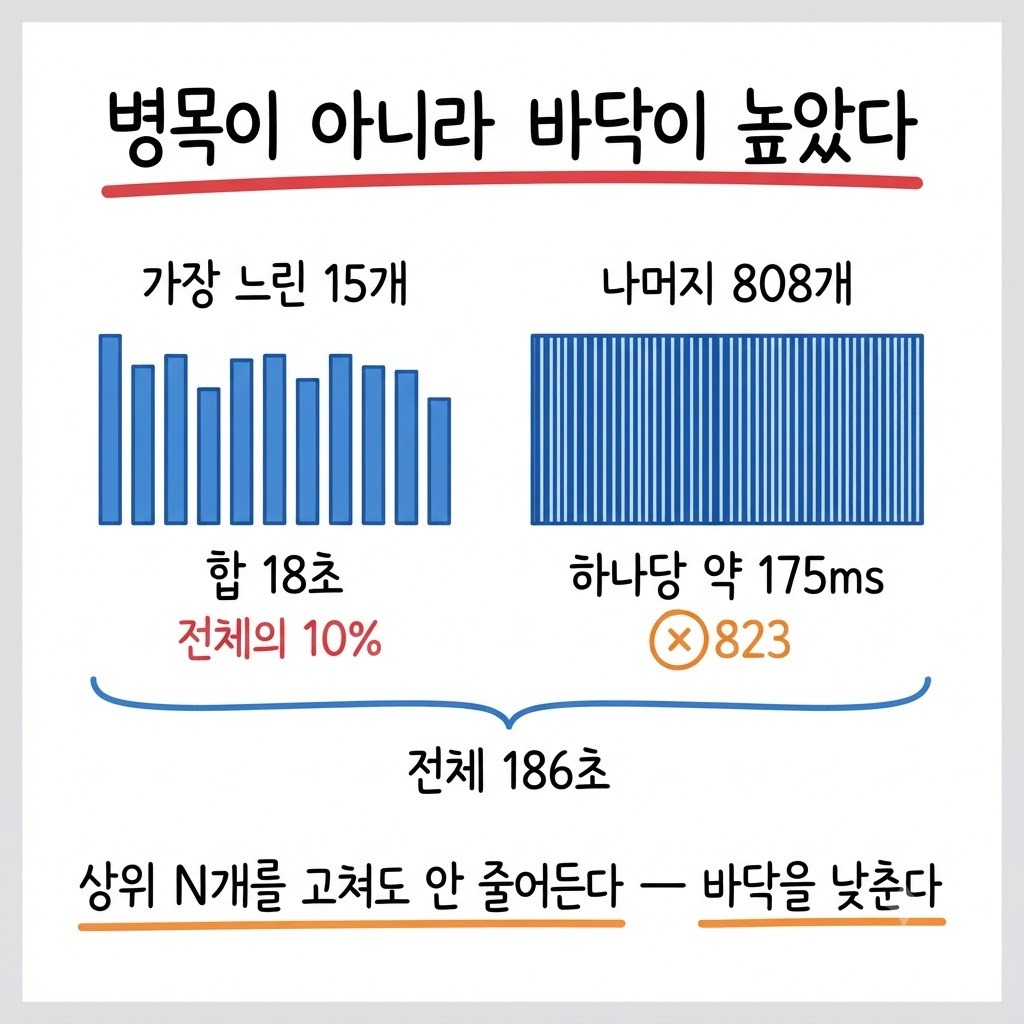
고친 규칙이 두 문항을 고쳤다는 것만으로 배포할 수는 없었습니다. 손을 떼게 만드는 규칙은 성질상 멀쩡히 답하던 문항까지 같이 막을 수 있습니다. 그래서 157문항에 옛 판과 새 판을 같은 입력으로 돌려 전수로 비교했습니다. 규칙과 DB 조회만 타는 구간이라 모델 비용은 들지 않았습니다.
첫 판은 실제로 멀쩡한 문항 둘을 같이 막았습니다. '수행한 사업'이라는 질문에서 목록을 가리키는 낱말이 먼저 지워져 '수행'이라는 조각이 남았고, 그 조각을 모르는 낱말로 센 탓이었습니다. 지우는 순서 하나가 만든 손해였습니다. 고친 뒤 다시 전수로 돌리니 달라진 문항은 감리와 컨설팅 둘뿐이었고, 둘 다 지금 틀린 답을 내던 문항이라 손해는 0이었습니다.
새로 만든 테스트 묶음은 옛 코드에 대고도 돌렸습니다. 전부 실패하는 것을 확인하고 나서야 검사로 인정했습니다. 새 코드에서만 통과하는 테스트는 무엇을 막는지 알 수 없습니다.
회차 기록을 개선과 퇴행을 나눠 기록했습니다
총점 한 줄로 적으면 좋아진 6과 나빠진 1이 서로 상쇄돼 둘 다 안 보입니다. 그래서 좋아진 것과 나빠진 것을 따로 세어 나란히 적었습니다. 한 건짜리 퇴행이 살아남게 하는 것이 목적입니다.
회차 노트에는 세 줄을 그대로 남겼습니다.
답이 틀렸는데 지표는 올랐다
51%는 그대로 못 믿는다
창구가 달라 앞 회차와 같은 조건이 아니다
세 번째 줄이 지연 시간의 측정 조건을 분명히 합니다. 앞 두 회차는 업무 화면의 채팅 경로에 관리자 토큰으로 요청을 넣어 돌렸고, 이번 회차는 토큰 파일이 없어 답변 생성 함수를 직접 호출했습니다. 답을 만드는 함수는 같지만 HTTP 계층과 대화 저장은 안 거칩니다. 15.0초에서 7.5초로 줄어든 값의 상당 부분이 건너뛴 구간의 몫일 수 있습니다. 이 숫자를 모델 교체의 성과로 옮겨 적으면, 다음 회차에 원래 자리로 돌아온 것을 퇴행으로 읽게 됩니다.
남은 몫은 사람에게 넘겼습니다. 평가표의 기대 도구를 지금 데이터 크기에 맞게 갱신하는 일입니다. 이걸 안 하면 지표가 계속 거짓말을 합니다. 다만 매 회차 기대값을 새로 적으면 회차 사이의 비교가 불가능해집니다. 잣대를 갱신하는 것과 잣대를 흔드는 것은 다릅니다. 변경 이력을 남기고 총점을 옛 잣대와 새 잣대 두 개로 적는 편이 안전합니다.
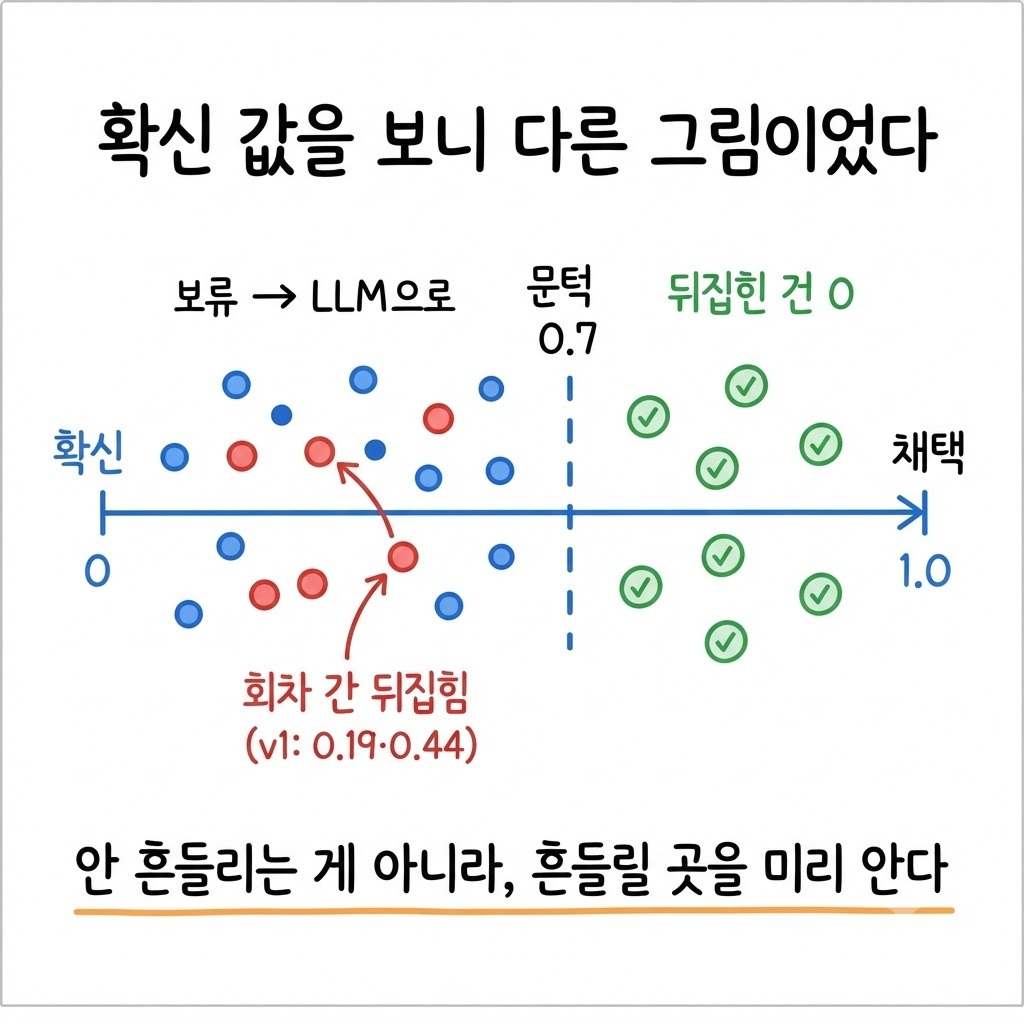
평가 지표를 어떻게 읽을지 정하는 문제는 정확도 한 줄로는 안 끝납니다. 확신 값을 관문으로 세워 오답을 막은 사례도 같은 축에 있습니다.
같은 자리에 서 있다면 점검할 것
평가 회차를 돌리는 팀이라면 아래 다섯 줄만 먼저 봐도 됩니다.
시스템을 고칠 때 평가표의 기대값도 같이 고쳤는지 확인합니다. 데이터가 바뀌었는데 기대값이 그대로면 그 기대값은 예전 시스템이 무엇을 해야 했는지를 재고 있습니다
총점 한 줄 대신 좋아진 것과 나빠진 것을 따로 셉니다
다시 판정하지 않을 것을 먼저 정합니다. 문장만 바뀐 문항을 다 보면 판정 노동의 대부분이 결론을 안 바꾸는 곳으로 갑니다
숫자 바로 옆에 어떻게 재서 나온 값인지를 적습니다. 창구가 달라진 회차의 지연 개선은 모델의 공이 아닐 수 있습니다
고친 규칙은 전수로 손해까지 세고, 새 테스트는 옛 코드에 대고도 돌려 실패하는지 봅니다
마무리
63문항은 작은 표본입니다. 한 문항만 달라져도 약 1.5%p가 움직이니 퍼센트의 소수점은 읽지 않는 편이 낫습니다. 그래도 이 회차에서 남은 것은 숫자가 아니라 숫자를 못 믿게 된 이유 한 줄입니다.
모르면 물러서게 하는 선택은 정답률이 아니라 오답률을 줄이는 선택입니다. 틀려도 좋으니 뭐라도 답해야 하는 제품에서는 반대로 가야 합니다. 이 도구에서는 답이 실적의 근거로 쓰이기 때문에 틀린 확신이 침묵보다 비쌌습니다.
회차 평가가 아예 없는 팀에게는 이 절차가 과하게 느껴질 수 있습니다. 다만 잣대 없이 고치는 것과 낡은 잣대로 고치는 것 중에서 더 위험한 쪽은 뒤쪽입니다. 앞쪽은 모른다는 것을 알고 있고, 뒤쪽은 틀린 숫자를 근거로 다음 결정을 합니다.