LLM 사실 검수를 '문제 있어?'로 물었더니 Gemma 4 가 지어낸 사건도 통과시켰습니다
블로그 글마다 요약 문서를 하나 만듭니다. 주장·흐름·살아남은 디테일·쓰면 안 되는 것이 들어 있고, 쓰레드 원고 5편은 이 문서만 보고 클라우드 모델 에이전트가 씁니다. 이 일을 맥북에서 LM Studio 로 도는 공개 가중치 모델에 맡길 수 있는지 시험했습니다. 이틀 전 Qwen 으로 한 번 해 봤을 때는 3편 중 2편에서 사실이 뒤집혔습니다. '중복 게시는 없었다'가 '두 번 올라갔다'가 된 식입니다.
그래서 이번엔 두 가지를 같이 봤습니다. 어느 모델이 나은가, 그리고 모델 바깥에 검사 장치를 붙이면 얼마나 나아지나입니다. 이 글에서는 그 장치를 '하네스'(모델 밖에서 생성·검사·재시도를 묶는 틀)라고 부릅니다.
작성자를 가리고 채점한 결과부터
모델은 Gemma 4 26B-A4B(GGUF)와 Qwen3.6-35B-A3B(MLX 4bit)였고, 샘플링은 제작사 권장값을 그대로 썼습니다. 요약 문서 3편으로 조건마다 한 번씩 돌렸습니다. '기준선'은 운영 중인 에이전트 지시문을 그대로 넣고 한 번에 5편을 쓰게 한 판입니다. 이미 게시된 운영판까지 섞어 작성자를 가린 뒤, 오푸스가 판마다 15편을 문장 단위로 요약 문서와 대조했습니다.
판 | 사실 오류 | 그대로 올릴 수 있는 편 | 읽힘(10점) | 글 한 편 시간 |
|---|---|---|---|---|
운영 중인 클라우드 모델 판 | 8 | 7 | 8.3 | - |
Gemma 기준선 | 11 | 9 | 7.0 | 67~97초 |
Gemma 하네스 | 8 | 8 | 6.3 | 374~667초 |
Qwen 하네스 | 6 | 4 | 3.7 | 806~1,313초 |
Qwen 기준선 | 22 | 1 | 3.7 | 81~189초 |
하네스는 Qwen 의 사실 오류를 22건에서 6건으로 줄였습니다. 대신 시간이 5~10배 늘었습니다. Gemma 에서는 그대로 올릴 수 있는 편이 오히려 기준선(9)이 하네스(8)보다 많았습니다. 하네스가 늘 이기는 것은 아니었습니다.
표를 읽을 때 조건이 있습니다. 조건마다 한 번씩만 돌렸으니 1~3건 차이는 우연 범위입니다. 심판도 LLM 이라 기준이 엄격했고, 운영판도 8건이 걸렸습니다. 하네스 시간에는 두 모델을 동시에 돌리며 서로 기다린 시간이 섞여 있습니다. 길이·말투·금지어 같은 기계 검사는 기준선도 거의 다 통과해서, 판 사이 차이는 이 블라인드 채점에서만 보였습니다.
'문제 있어?'라고 물으면 '없다'에서 끝납니다
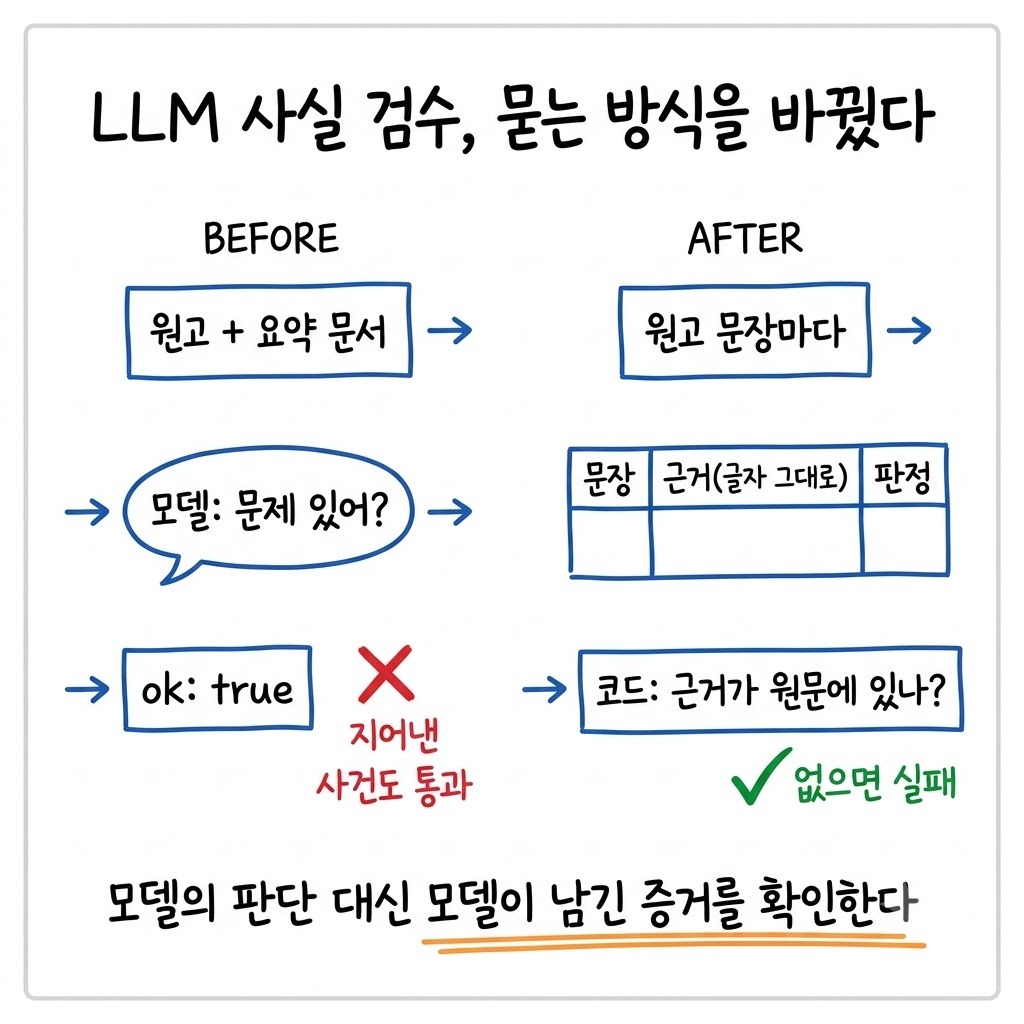
하네스의 핵심은 사실 검수기였습니다. 처음에는 같은 모델에게 원고와 요약 문서를 주고 {"ok": ..., "problems": [...]} 형태로 문제 목록을 받았습니다. 이 검수기가 Gemma 원고의 두 문장을 **전부 통과**시켰습니다. 하나는 'API 잘못 막았다가 다 터뜨릴 뻔했어'로, 요약 문서에 없는 사건을 지어낸 문장입니다. 다른 하나는 '증거가 없으면 고칠 수도 없어'였는데, 실제로는 고친 일이었습니다.
'문제 있나'라는 질문은 모델이 '없다'고 답하면 거기서 끝납니다. 그 답이 맞는지 확인할 방법이 없습니다. 그래서 질문을 바꿨습니다. 원고 문장마다 세 칸을 채우게 했습니다.
{문장, 근거(요약 문서 구절을 글자 그대로), 판정(일치·질문·일반론·지어냄·반대·과장)}그리고 통과 여부는 모델이 아니라 코드가 정합니다. 판정이 지어냄·반대·과장이면 실패입니다. 판정이 '일치'인데 근거로 붙인 구절이 요약 문서에 실제로 없으면 그것도 실패입니다. 모델의 판단을 믿는 대신, 모델이 남긴 증거가 원문에 있는지를 문자열 대조로 확인하는 구조입니다.
검수기도 먼저 시험합니다 — 놓침과 오탐을 따로
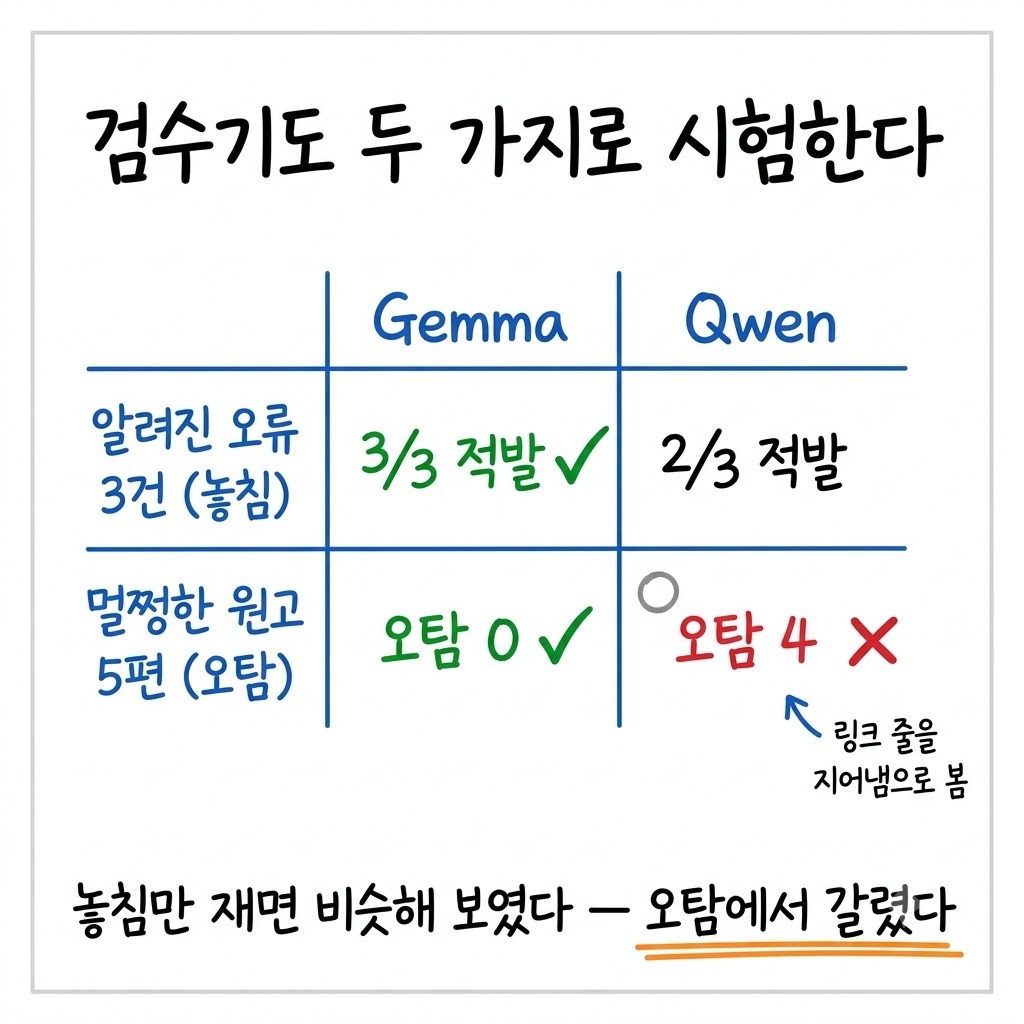
바꾼 검수기를 하네스에 붙이기 전에 검수기 자체를 시험했습니다. 넣은 재료는 두 묶음이었습니다.
알려진 오류 3건 — 놓침을 잽니다. Gemma 3/3, Qwen 2/3 을 잡았습니다
멀쩡한 운영 원고 5편 — 오탐을 잽니다. Gemma 오탐 0, Qwen 오탐 4 였습니다. Qwen 은 원고 끝의 링크 안내 줄을 '지어냄'으로 봤습니다
알려진 오류만 넣었다면 두 모델의 차이는 3건 중 1건이라 비슷해 보였을 겁니다. 멀쩡한 글을 넣고 나서야 0 대 4 로 갈렸습니다. 그래서 검수는 두 하네스 모두 Gemma 로 돌렸습니다. 알려진 오류만 넣으면 오탐을 모르고, 멀쩡한 글만 넣으면 놓침을 모릅니다.
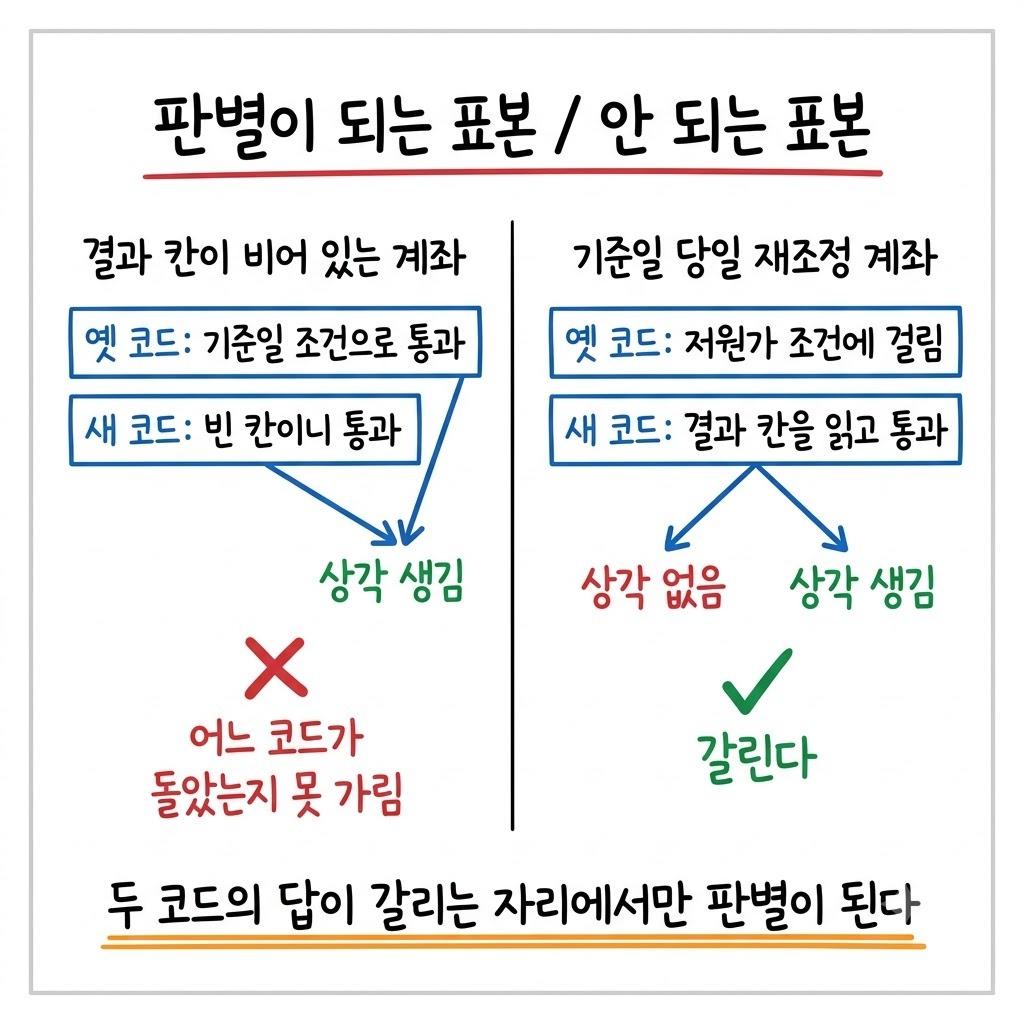
검사를 고를 때 '이게 아니라면 무엇이 보일까'를 먼저 묻는 것도 같은 자리에서 나온 습관입니다.
멀쩡한 원고를 18분 동안 다시 쓰게 한 관문
하네스에는 사실 검수 말고 기계 관문도 있었습니다. 존댓말·길이·첫 줄·홑낫표 같은 것을 세고, 걸리면 고칠 말을 붙여 최대 3번 다시 쓰게 했습니다. 돌려 보니 글 한 편 시간이 예상보다 훨씬 길었습니다.
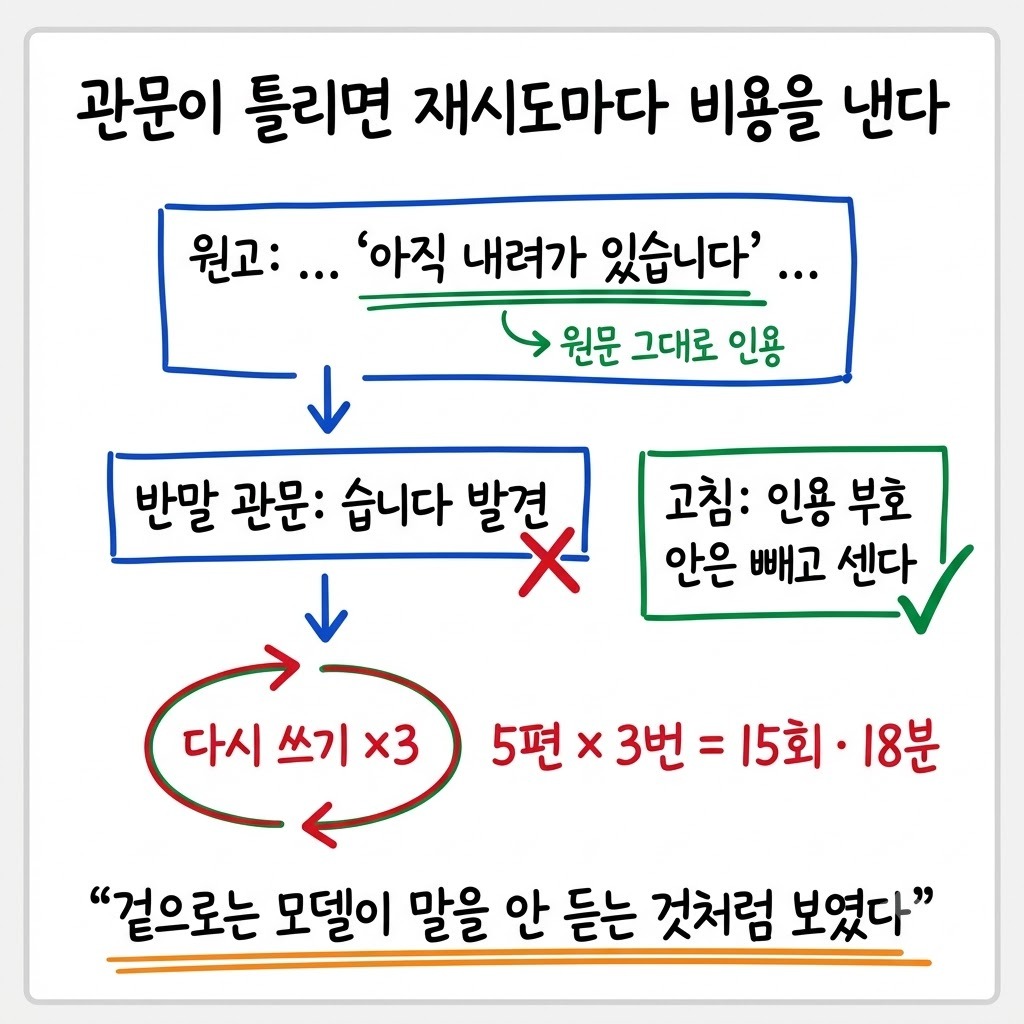
원인은 반말 관문이었습니다. 원고에서 '습니다'를 세어 걸었는데, 모델은 요약 문서에 있던 알림 문구 '아직 내려가 있습니다'를 작은따옴표로 정확히 인용한 것이었습니다. 관문은 멀쩡한 원고 5편을 3번씩 다시 쓰게 했고, 그렇게 **15회·18분**이 버려졌습니다. 처음엔 이 기록을 '모델이 말을 안 듣는다'로 읽을 뻔했습니다.
재시도 루프에 붙은 관문이 틀리면 한 번 틀리는 것으로 끝나지 않습니다. 재시도마다 생성 비용을 다시 냅니다. 그리고 겉으로는 모델 탓처럼 보입니다. 인용 부호 안은 빼고 세도록 고쳤습니다. 운영 중인 검사기의 존댓말 검사도 같은 방식으로 세고 있었습니다. 운영에서 실제로 오탐이 났는지는 확인하지 않았습니다.
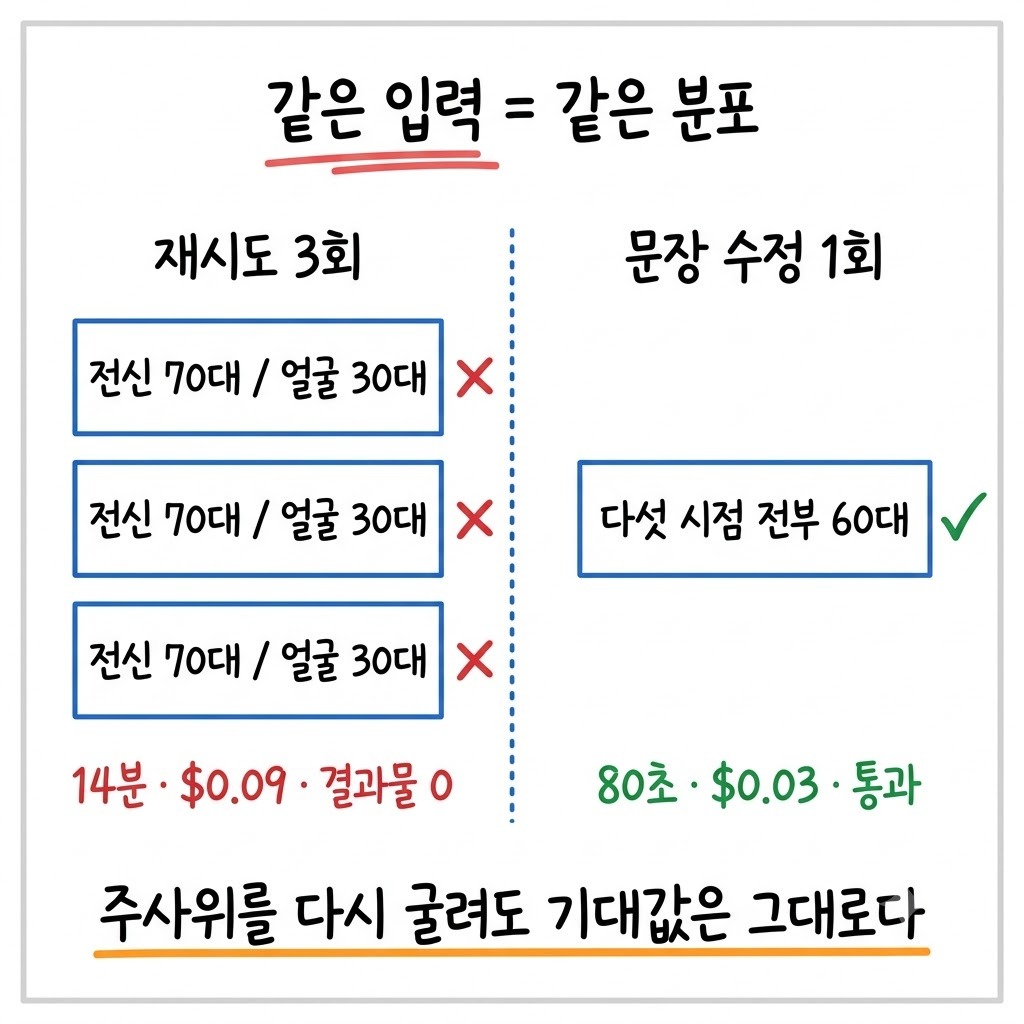
같은 입력으로 다시 생성하는 재시도가 시간을 어떻게 키우는지는 앞서 따로 정리했습니다.
Qwen 을 못 쓴 이유는 사실 오류가 아니라 오타였습니다
Qwen 원고에는 이상한 글자가 섞여 있었습니다. 처음엔 '깨진 글자'라고 불렀는데 틀린 이름이었습니다. 유니코드 깨짐은 0건이었고, 있는 글자로 틀린 음절을 고른 오타였습니다. 멀쩡→멀쩴, 반나절→반나짝, 회수→횟수 같은 식이고 한자도 섞였습니다.
범위는 하나씩 바꿔 가며 좁혔습니다.
샘플링 값 — 이미 쓴 토큰을 누르는 presence_penalty 1.5 가 한국어 음절 재사용을 막는다고 봤습니다. 1.5 와 0 을 6판씩 돌리니 1.5 가 9건, 0 이 13건이었습니다. 값을 내려도 줄지 않아 기각했습니다
압축 형식·실행기 — 같은 모델의 GGUF 판을 llama.cpp 로 올려 6판을 더 돌렸습니다. MLX 4건 대 GGUF 8건으로 오타는 남았습니다
결론 — 4bit 모델 자체의 한국어 음절 실수로 봅니다. 8bit 이상은 보지 않았습니다. 같은 조건의 Gemma 는 오타가 거의 없었습니다
세는 쪽도 흔들렸습니다. 같은 MLX 6판을 한 소넷은 9건, 다른 소넷은 4건으로 셌습니다. 그래서 4 대 8 의 차이는 믿지 않고 '압축 형식을 바꿔도 없어지지 않았다'까지만 말합니다.
검수기가 아직 못 잡는 것
하네스판에도 새 약점이 보였습니다. 요약 문서의 '그럴 수 있었다'·'확인 안 함'을 '덮어버린 거야'·'효과는 확실했어'처럼 확신을 올려 쓴 문장이 나왔습니다. 운영판에서도 같은 유형이 있었는데, 검수 판정 목록에 이 유형이 없어 빠져나갔습니다. 그래서 다음 판의 판정 목록에 '단정' 유형을 넣기로 했습니다.
근거 인용 방식은 원문이 있을 때만 쓸 수 있습니다. 근거 문서가 없는 창작·추론에는 바로 적용되지 않습니다. 인용 부호 안을 검사에서 빼면, 모델이 일부러 따옴표로 감싸 규칙을 피할 여지도 생깁니다.
원문이 있는 LLM 검수에 붙일 때 확인할 것
판정을 '문제 있나'로 묻지 않고, 문장마다 근거 구절을 글자 그대로 붙이게 했는가
근거가 원문에 실제로 있는지는 코드가 대조하는가
검수기를 붙이기 전에 알려진 오류(놓침)와 멀쩡한 글(오탐)을 따로 넣어 봤는가
재시도 루프의 관문이 원문을 정확히 인용한 문장까지 걸고 있지 않은가
판끼리 비교할 때 기계 검사 대신 작성자를 가린 채점을 했는가
RAG 답변 검증·요약 검수·계약서 대조처럼 원문이 있는 검수라면 같은 구조를 그대로 쓸 수 있습니다. 모델에게 판단을 묻는 대신 증거를 남기게 하고, 그 증거는 코드가 확인합니다. 그리고 그 검수기도 붙이기 전에 한 번 시험합니다.