LLM 분류 확신 문턱을 '오답 0건'으로 발행했는데, 같은 날 300건에서 80% 였습니다
오후에 블로그 두 편을 발행했습니다. 그중 한 편은 제목 자체가 '확신 0.7 이상이면 오답 0건'이었습니다. 같은 날 저녁, 다른 세션에서 표본을 키워 다시 쟀더니 그 숫자가 80% 로 내려앉았습니다.
틀린 문장을 쓴 것이 문제의 전부는 아니었습니다. 더 비쌌던 것은 그 문장이 이미 여러 층으로 퍼져 나간 뒤였다는 점입니다. 본문은 고칠 수 있었고, 아직 안 나간 원고는 단서를 달 수 있었고, 이미 게시된 것은 못 고쳤습니다. 이 글은 그 하루의 기록입니다.
20건으로 만든 두 문장
사내 문서 지식그래프 검색 도구에 분류 전용 모델(Jev)을 넣을지 검토하던 중이었습니다. 색인이 문서마다 종류(무슨 문서인가)와 편(우리 수행분인가 남의 것인가)을 판정하는데, 그 자리를 범용 LLM 대신 싼 분류 전용 모델로 바꿀 수 있는지가 논점이었습니다.
먼저 표본 20건으로 재서 두 문장을 뽑았습니다. 그리고 그대로 기록에 남겼습니다.
빠른 분류기를 넣으면 색인의 LLM 호출 60% 가 사라진다
확신 0.7 이상이면 오답 0건이다 (12건 중 12건)
이 기록이 며칠 뒤 글감이 됐고, 글감이 블로그 두 편이 되어 발행까지 나갔습니다. 표본 20건이라는 사실은 기록에는 적혀 있었지만, 글로 옮겨지는 동안 결론만 남고 분모가 떨어져 나갔습니다.
호출을 열어 보니 분류만 떼어낼 수가 없었습니다
같은 날 고객 대표가 이걸 실제로 코드에 넣을지 물었습니다. 그래서 색인 코드를 열어 봤습니다.
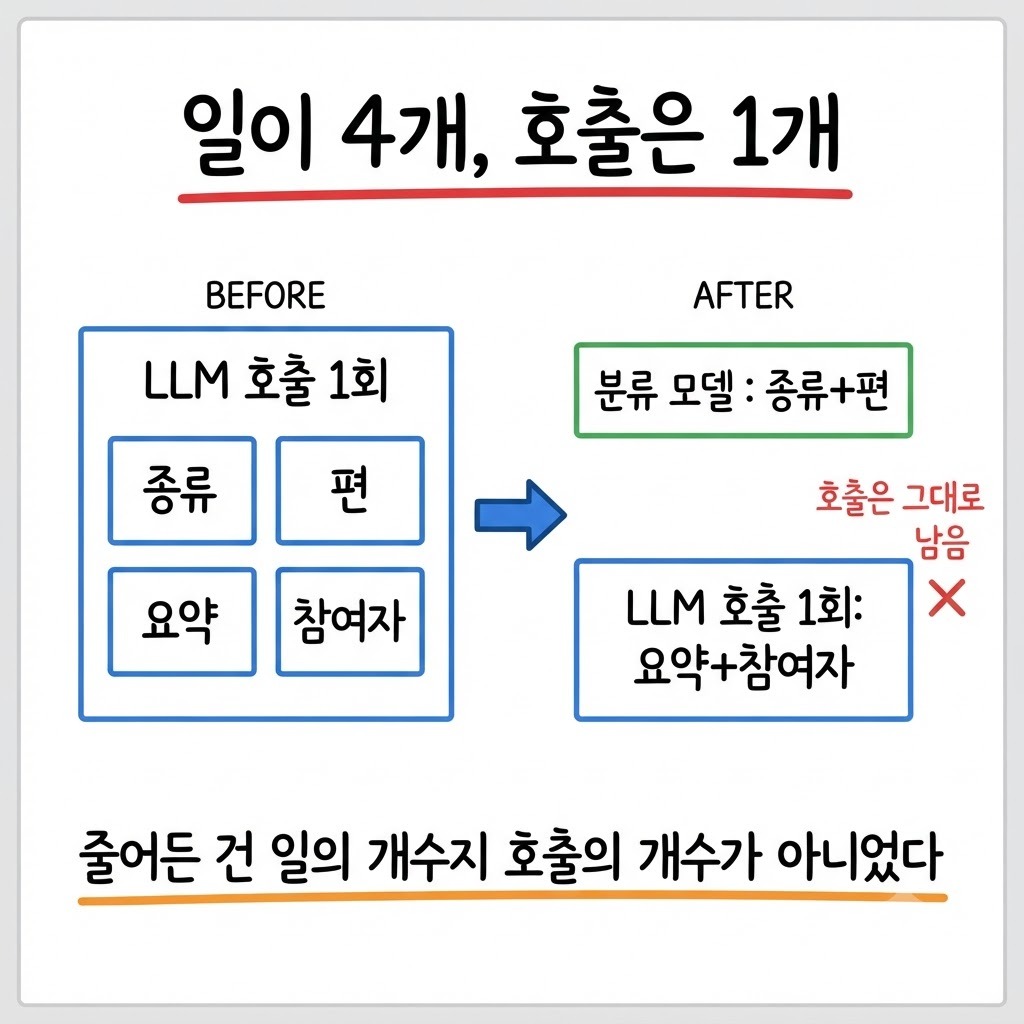
색인의 카드 생성은 한 번의 LLM 호출로 종류·편·요약·참여자를 함께 뽑고 있었습니다. 분류 전용 모델은 이 중 종류와 편만 답합니다. 요약과 참여자는 못 합니다. 그러니 분류를 떼어내도 그 호출은 남은 두 가지를 위해 그대로 남습니다. 색인 비용 이득은 0 이었습니다.
줄어드는 것은 한 호출이 하는 일의 개수였지 호출의 개수가 아니었습니다. 호출 단위를 열어 보기 전까지는 60% 라는 숫자에 근거가 없었습니다.
실제로 대체되는 자리는 둘뿐이었습니다. 분류 체계를 바꿀 때 코퍼스 9,044건을 전량 재분류하는 작업과, 채팅 라우팅입니다. 전량 재분류는 범용 모델 대비 약 30배 싸서 여전히 의미가 있습니다. 다만 그건 상시 비용이 아니라 가끔 도는 배치입니다.
300건으로 다시 재니 80% 였습니다
같은 날 저녁, 별도 세션에서 표본을 300건으로 늘려 다시 쟀습니다. 지시문 버전을 그대로 두고, 같은 입력을 2회, 고정 seed 로 돌렸습니다. 전체 176초가 걸렸습니다. 재실측 비용은 사실상 없었습니다.
문턱 | 표본 20건 | 표본 300건 |
|---|---|---|
확신 0.7 이상 | 12건 중 12건 (오답 0) | 80% |
확신 0.9 이상 | 측정 구간 없음 | 96% |
확신 0.5 미만 | 흔들린다 | 흔들린다 (유지) |
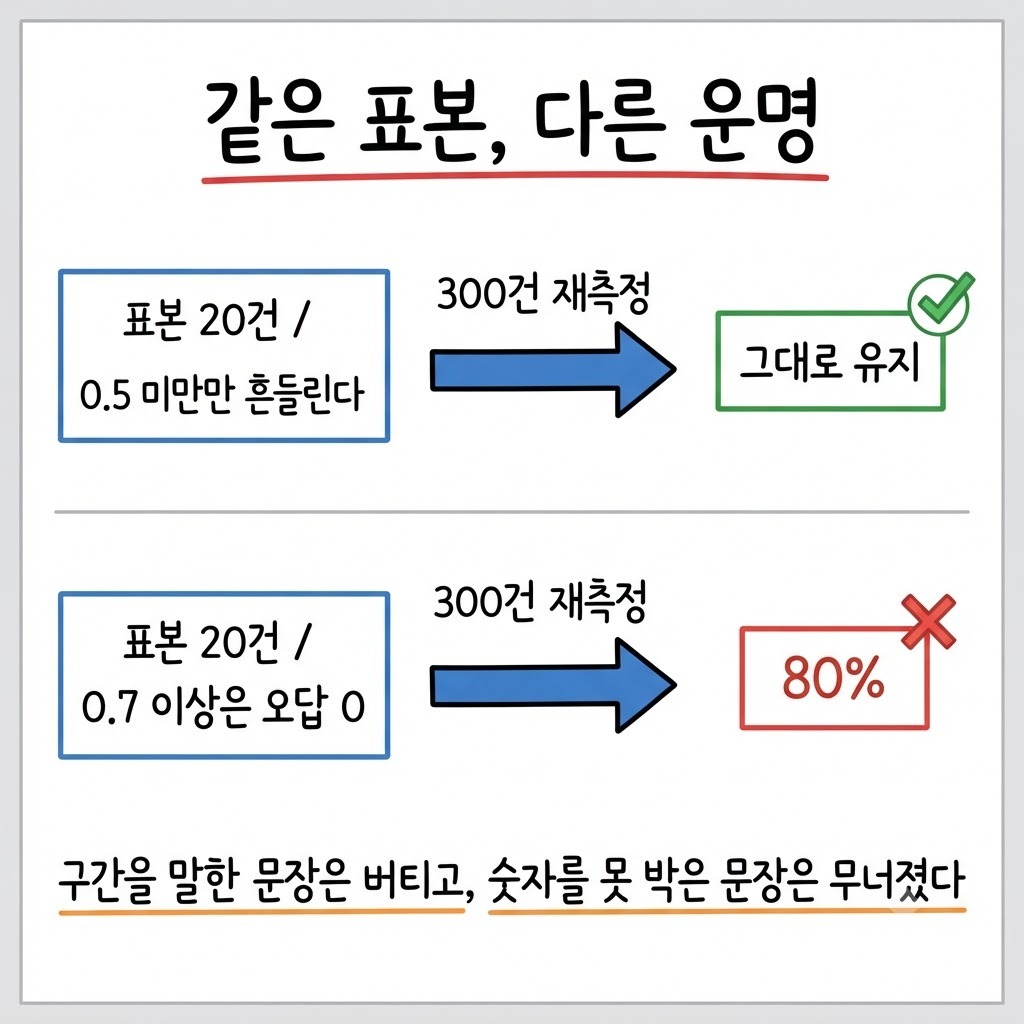
0.7 이라는 문턱 자체가 틀렸다기보다, 그 문턱에서 오답이 0 이라고 못 박은 문장이 틀렸습니다. 12건 중 12건이 맞았다는 것은 오답이 없다는 뜻이 아니라 12건 안에서는 아직 오답을 못 봤다는 뜻입니다. 작은 분모의 100% 는 언제나 이 두 가지를 동시에 의미합니다. 글로 옮길 때 앞쪽 뜻만 가져갔습니다.
버틴 문장과 무너진 문장의 차이
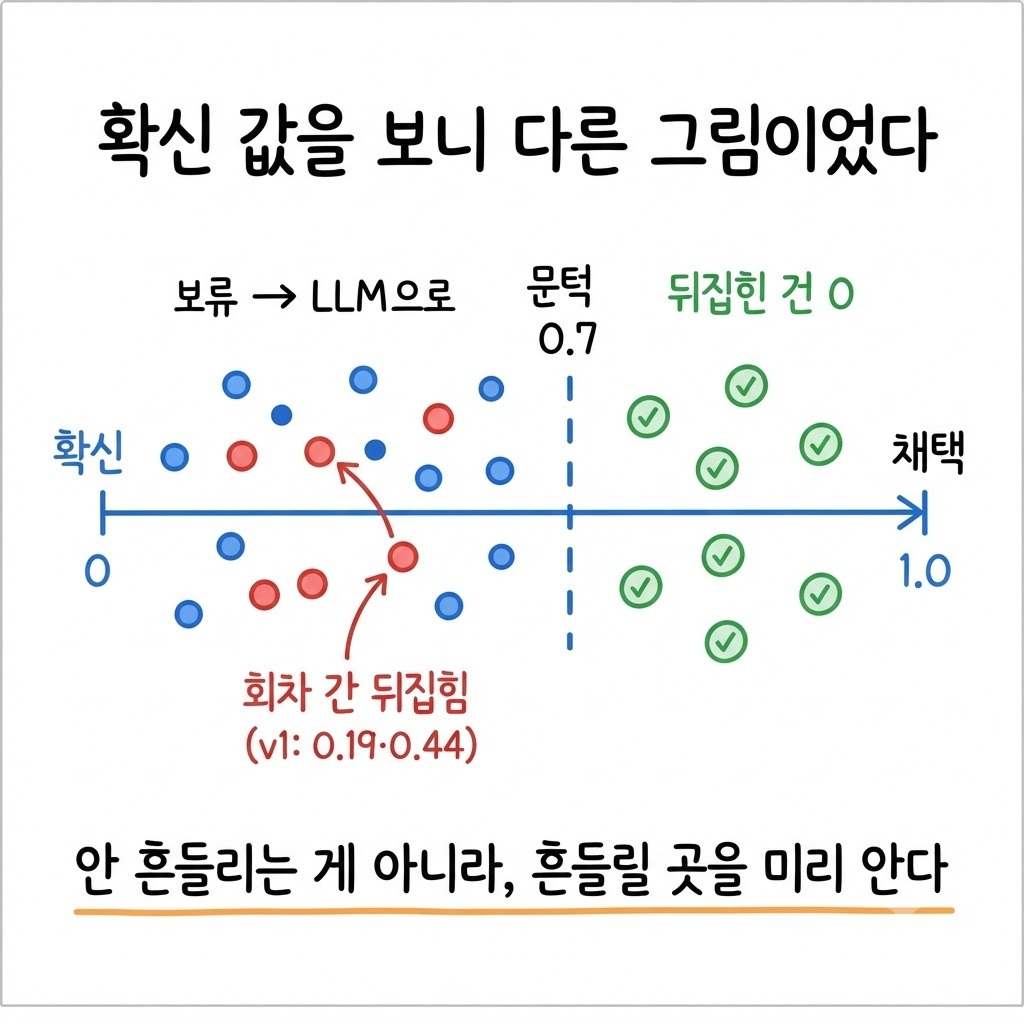
흥미로운 것은 같은 20건 표본에서 나온 문장 중 하나는 300건에서도 버텼다는 점입니다. 확신 0.5 미만 구간만 흔들린다는 문장입니다. 두 회차에서 판정이 뒤집힌 16건이 전부 0.5 미만이었습니다.
두 문장의 차이는 표본 크기가 아니라 주장의 형태였습니다.
버틴 쪽: 방향과 구간을 말했습니다. 어디쯤이 위험한가
무너진 쪽: 문턱 숫자와 결과를 못 박았습니다. 0.7 위는 오답 0
표본 20건이 말할 수 있는 데까지가 앞쪽이었습니다. 표본이 작으면 다 틀렸다는 것이 교훈이 아닙니다. 작은 표본은 어디까지 말할 수 있나가 교훈입니다.
불일치의 절반은 모델 문제가 아니었습니다
80% 라는 숫자를 보고 처음 든 생각은 모델이 약하다는 것이었습니다. 불일치 건을 하나씩 열어 보니 절반은 모델이 틀린 게 아니었습니다. 분류 체계 자체가 그 경계를 못 가르는 자리였습니다.
같은 문서에 형식으로 부르는 이름과 내용으로 부르는 이름이 동시에 성립하는 경우가 있습니다. 어느 쪽으로 불러도 사람이 납득합니다. 이런 문서는 모델을 아무리 키워도 안 맞습니다. 고쳐야 할 것이 모델이 아니라 분류 기준이기 때문입니다.
편 판정은 더 분명했습니다. 24건 중 13건이 남의 것에서 우리 것으로 뒤집혔습니다. 한 발주처의 관리 문서와 다른 발주처의 인터뷰 회의록이었습니다. 이 값은 그 사업에 우리가 수행사로 들어갔는지에 달려 있어서, 문서 내용만 봐서는 갈리지 않습니다. 문서 안에 답이 없는 질문을 모델에게 시키고 있었습니다.
여기서 한 가지가 더 무너졌습니다. 재실측 300건의 정답은 기존 데이터에 붙어 있던 라벨인데, 그 라벨 자체가 못 가르는 자리가 절반이라면 정확도의 분모를 믿을 수 없습니다. 그래서 눈가림 정답표 57건(불일치 47건 + 대조군 10건)을 만들어 사람에게 넘겼습니다. 이게 채워지기 전까지는 문턱별 정확도를 말하지 않기로 했습니다.
정정 경로가 층마다 달랐습니다
기술적으로는 여기서 끝입니다. 실제로 시간을 쓴 쪽은 그 다음이었습니다. 두 문장은 이미 발행물로 나간 뒤였고, 정정 방법이 층마다 달랐습니다.
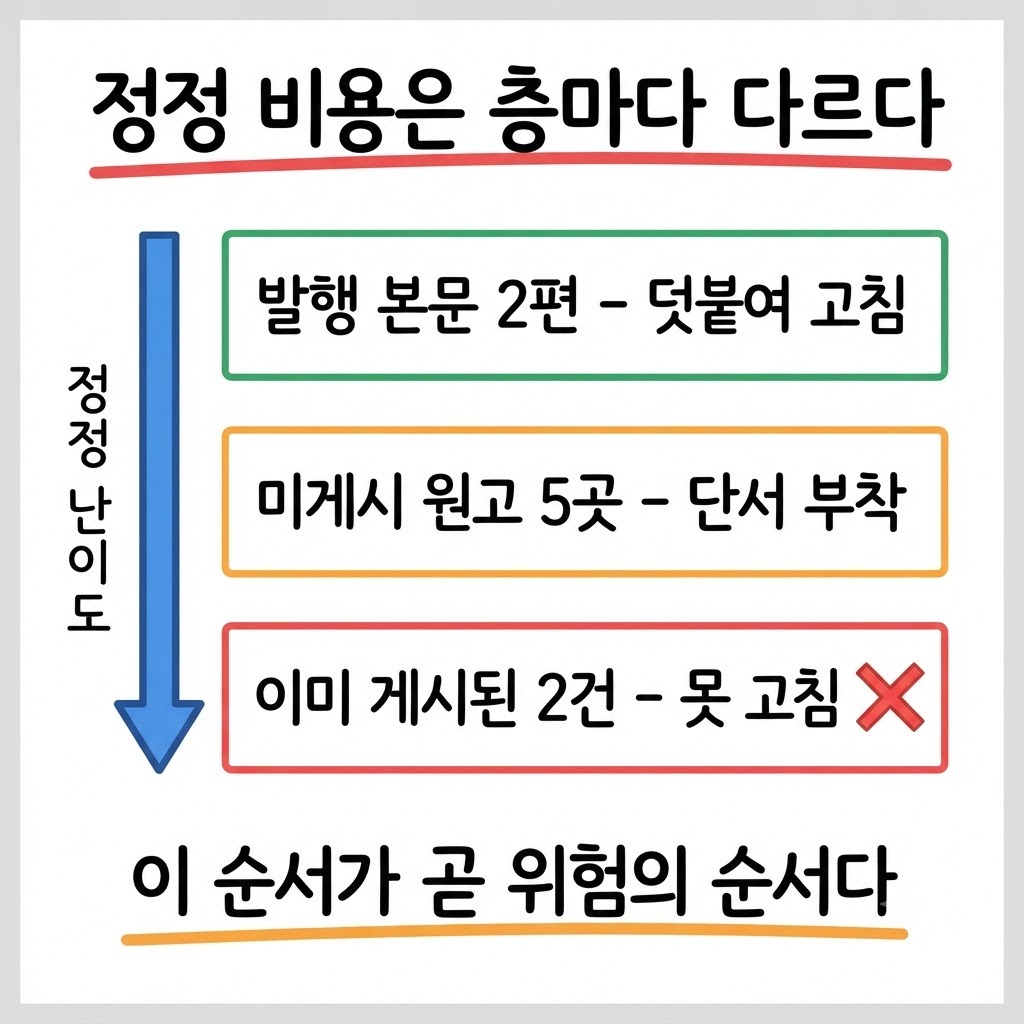
층 | 상태 | 할 수 있었던 것 |
|---|---|---|
발행된 본문 2편 | 공개돼 있지만 내가 소유 | 글 끝에 재실측 결과를 덧붙임 |
미게시 SNS 원고 10건 | 아직 안 나감 | 해당 문구 5곳에 표본 단서 부착 |
이미 게시된 SNS 2건 | 회수 불가 | 원문 그대로 남음 |
위에서 아래로 갈수록 비용이 커집니다. 그리고 이 순서가 곧 위험의 순서입니다. 본문은 언제든 고칠 수 있으니 실은 가장 안전한 자리였습니다. 위험한 것은 손이 닿지 않는 곳으로 이미 나간 두 건이었습니다.
여기서 SNS 원고를 미리 쌓아 두는 구조가 비용으로 돌아온다는 것을 확인했습니다. 재고가 많을수록 손볼 곳이 늘어나고, 그중 나간 것은 못 돌립니다. 재고를 쌓는다면 한 군데를 고치면 재고 전체가 따라오는 형태여야 합니다. 지금은 문구가 원고마다 복사돼 있어서 다섯 곳을 하나씩 열어 고쳤습니다.
뒤집힌 근거를 실은 글은 내리지 않고 그대로 뒀습니다. 결론의 방향이 유지되고 숫자만 내려앉은 경우라 덧붙이는 것으로 충분하다고 봤습니다. 결론이 통째로 뒤집혔다면 본문을 고치거나 내리는 편이 맞습니다.
다음부터 발행 전에 보는 것
같은 일을 막으려고 정한 것은 네 가지입니다. 모두가 발행 전에 300건을 돌릴 수는 없습니다. 다만 이 건은 재실측이 176초였고, 안 돌린 것이 순수한 손해였습니다. 재실측이 싼지부터 재보는 것이 실무적인 갈림선입니다.
결론에 숫자가 있으면 그 숫자를 만든 분모를 같은 문장에 적습니다. 분모가 두 자리면 결론이 아니라 관찰입니다
호출 수를 줄인다고 말하기 전에 그 호출이 몇 가지 일을 겸하는지 코드를 엽니다
불일치를 모델 탓으로 돌리기 전에 라벨 체계가 그 경계를 가를 수 있는지 봅니다
재실측 비용을 먼저 잽니다. 몇 분이면 발행 전에 돌립니다
기록을 다룰 때 하나를 더 정했습니다. 20건 실측을 적어 둔 원본을 300건 기준으로 덮어쓰지 않고, 그 아래에 재실측 절을 이어 붙였습니다. 원본을 고쳐 버리면 다음 사람이 같은 20건 표본을 보고 같은 문장을 다시 씁니다. 뒤집힌 자리가 남아 있어야 왜 그때 그렇게 썼는지가 같이 남습니다.
마무리
도입은 보류했습니다. LLM 호출을 60% 줄인다는 것이 근거였는데 그 근거가 없어졌기 때문입니다. 남은 두 자리인 전량 재분류와 채팅 라우팅은 따로 판단합니다.
이 하루에서 남은 것은 표본이 작으면 틀린다는 문장이 아닙니다. 20건이 만든 두 문장 중 하나는 300건에서도 버텼습니다. 작은 표본은 흔들리는 구간이 어디쯤인가까지 말할 수 있고, 거기서 문턱 숫자를 결론에 박는 순간 그 문장은 발행물 층마다 다른 비용으로 돌아옵니다.
정답표가 채워지면 문턱 이야기를 다시 씁니다. 그때는 분모를 먼저 적겠습니다.