LLM 라우터를 0.3초짜리 분류 모델 Jev 로 바꾸면 1.4초가 준다고 했는데, 이득은 0 이었습니다
사내 문서 지식그래프 검색 도구에 분류 전용 모델 Jev(TypeSafe 의 분류 모델) 를 문서 종류 분류에 실측한 기록이 있습니다. 그 기록 끝에 '어디에 더 쓸 수 있나' 표를 적으면서 채팅 라우팅을 후보로 올려 뒀습니다. 'LLM 이 도구를 고름, 수 초' 한 줄이었고, 코드를 열어 보지 않고 적은 줄이었습니다.
그 표를 본 고객사 대표가 물었습니다. '채팅 라우팅에 이걸 넣으면 좋다고?' 한 시간 동안 물음이 네 번 이어졌고, 그 사이 제 결론이 세 번 움직였습니다. 이 글은 그 순서를 그대로 적은 것입니다. 같은 모델의 문서 분류 실측은 별도 글로 정리했고, 여기서는 라우팅 자리만 다룹니다.
처음 답은 '넣으면 좋다'였습니다
기록에 '수 초'라고 적혀 있었으니 먼저 라우터를 직접 쳐 봤습니다. 문서 엔진의 라우팅 단계에 4문항을 넣었습니다. 지연은 1.58~1.93초였고, 모델은 코덱스 구독으로 붙인 gpt-5.6(reasoning low) 이었습니다. 넷 다 맞는 도구를 골랐습니다. 사업 목록 조회·참여자 조회·문서 검색이 맞게 나왔고, 제안서 초안 요청은 사업 목록 조회에 깊은 답변을 붙여 나왔습니다. '수 초'가 아니라 2초 아래였습니다.
Jev 의 문서 분류 실측 지연은 평균 0.29초였습니다. 라우터 1.7초에서 0.29초를 빼면 턴당 약 1.4초가 줍니다. 다만 이 1.4초는 라우팅을 Jev 로 돌려서 잰 값이 아닙니다. 라우터 실측과 문서 분류 실측, 서로 다른 자리에서 잰 두 숫자의 뺄셈입니다. 그래도 이 시점의 답은 '넣으면 좋다'였습니다.
호출을 열어 보니 셋을 한 번에 하고 있었습니다
뺄셈이 성립하려면 라우터 호출이 '도구 고르기'만 해야 합니다. 라우터 코드를 읽으니 한 호출로 세 가지를 하고 있었습니다.
도구 고르기 — 사업 목록 조회·참여자 조회·문서 검색 중 어느 것을 부를지
답변 능력 고르기 — 빠른 답변으로 끝낼지 깊은 답변으로 갈지
찾을 말 풀어쓰기 — 검색에 넘길 문장을 새로 만드는 일
셋째가 문제였습니다. '그중 2026년 것만' 같은 이어 묻기는 그 문장만으로는 검색이 안 됩니다. 라우터가 앞 대화에서 사업명과 발주처를 가져와 혼자서도 뜻이 통하는 한 문장으로 다시 씁니다. 첨부가 있는 턴에는 '첨부에 없어서 사내 문서에서 찾아야 할 것'만 골라 적습니다. 문장을 만드는 일입니다. 분류 모델은 라벨과 확신을 돌려주는 모델이라 이 일을 못 합니다. 확신이 아무리 높아도 이 호출은 사라지지 않습니다.
코드 주석에 이유까지 적혀 있었습니다.
라우터는 어차피 매 턴 LLM 을 한 번 돌린다. 풀어쓰기를 여기 얹으면 호출이 안 늘어 지연도 비용도 그대로다.
풀어쓰기가 라우터에 있는 것은 우연이 아니라 설계였습니다. '어차피 부르니 공짜'라는 흔한 최적화이고, 그 자체는 맞는 판단입니다. 다만 그 호출을 나중에 빼려 하면 이 결정이 발목을 잡습니다. 앞 대화가 없는 첫 턴은 풀어쓸 것이 없으니 호출 하나가 통째로 0.29초짜리로 바뀔 수 있습니다. 이어 묻기 턴은 LLM 이 그대로 필요해 호출 수도 지연도 지금과 같습니다. 결론이 '넣으면 좋다'에서 '첫 턴만 된다'로 움직였습니다.
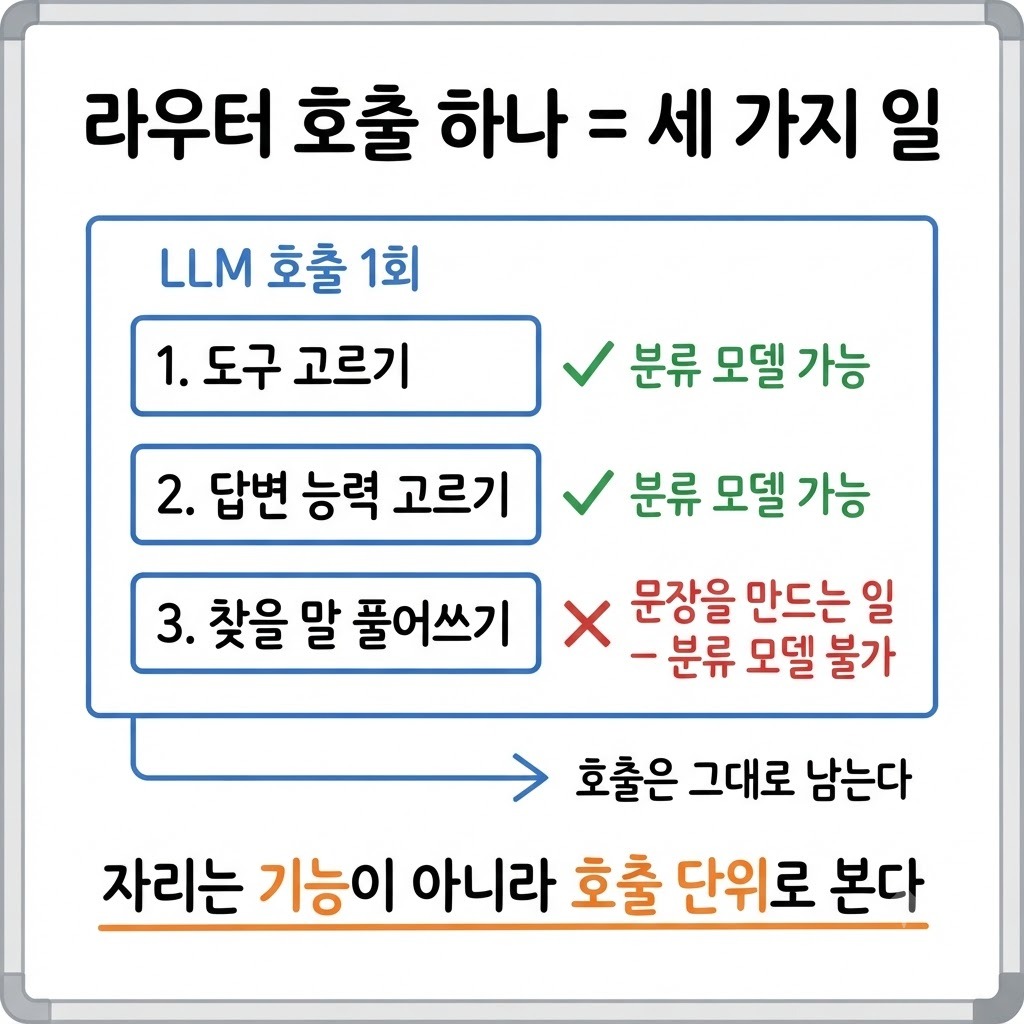
같은 날 오전에 문서 카드 파이프라인에서 똑같은 자리에 걸렸습니다. 카드 생성 호출도 종류·저자 편 같은 고르기와 요약·참여자 같은 생성을 한 호출로 뽑고 있어서, 분류 모델이 들어가도 그 호출은 그대로 나갑니다. 하루에 두 번이었습니다. 호출 단위로 보는 것은 앞서 LLM 호출 9군데를 매핑할 때와 같은 결론입니다.
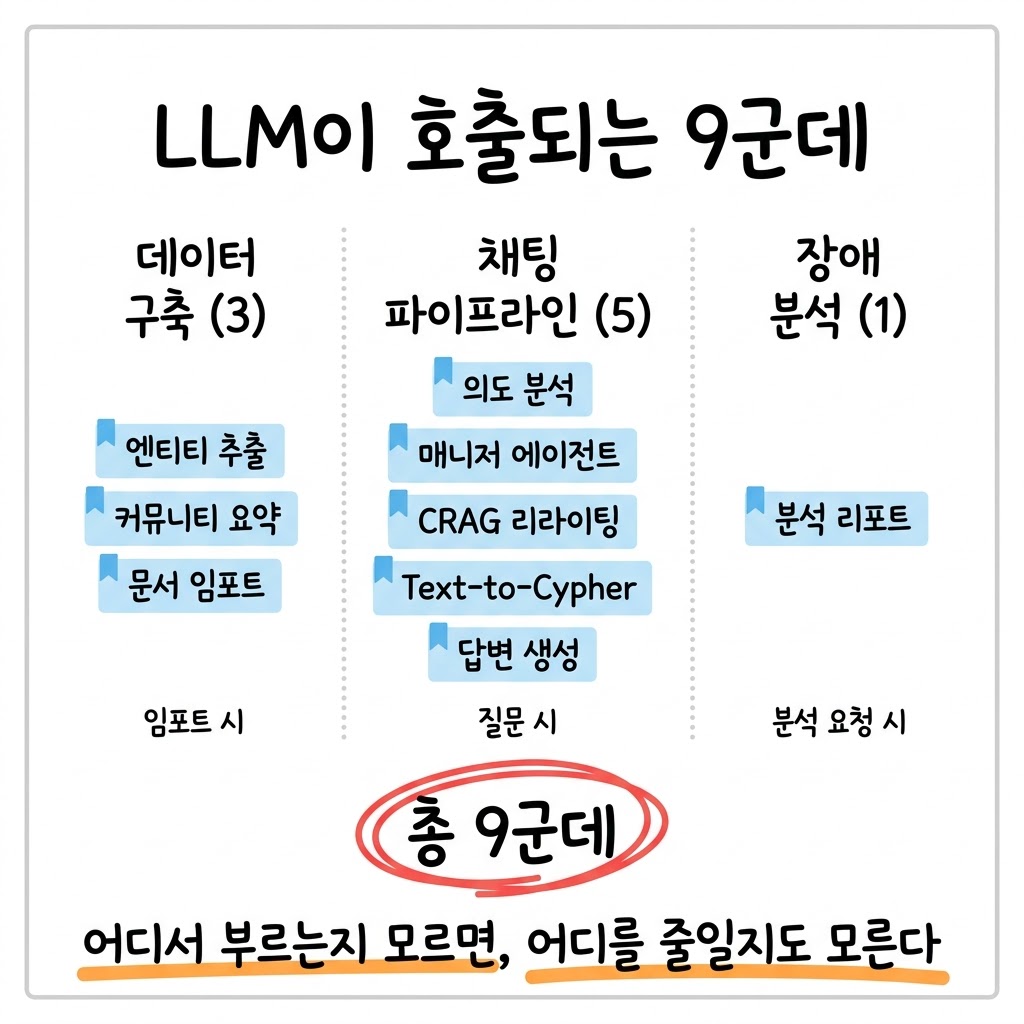
융합하면 유리한가 — 대화 DB 를 셌습니다
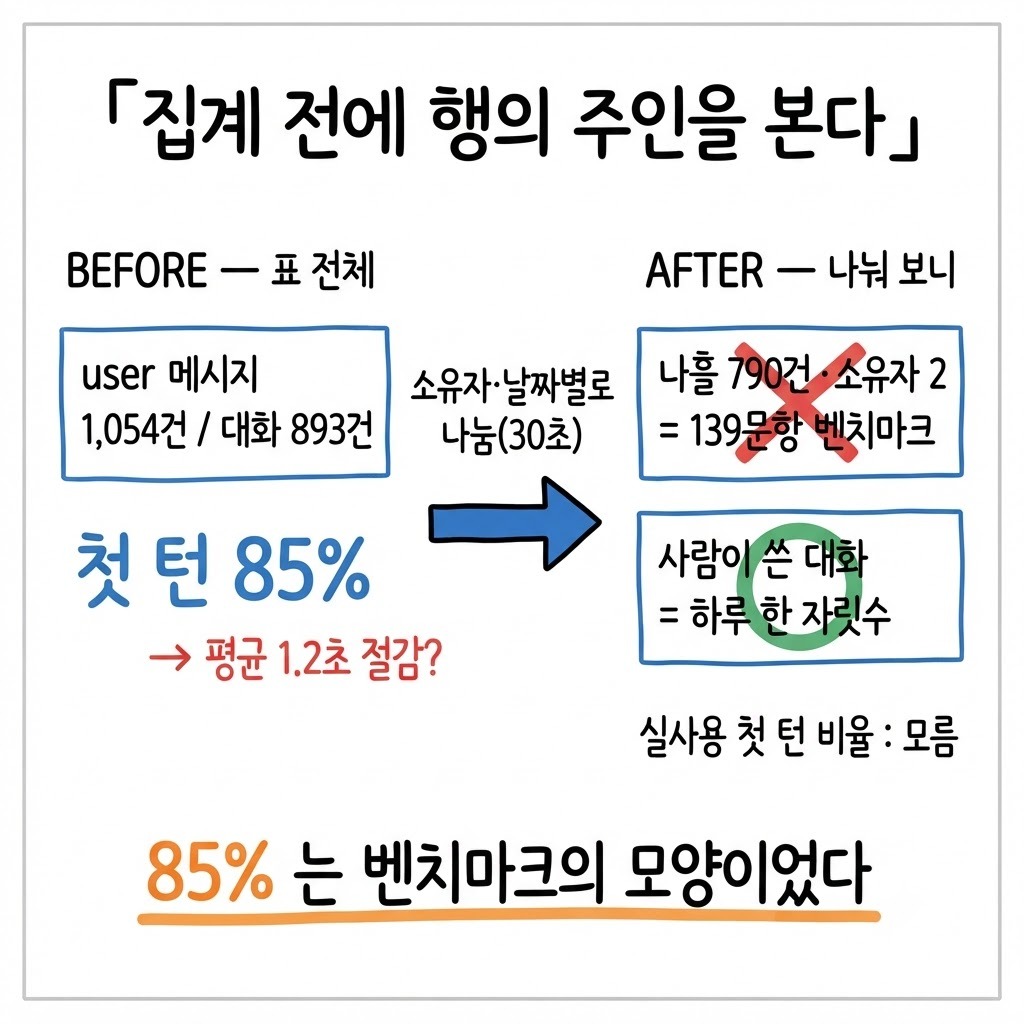
세 번째 물음은 '그러면 첫 턴은 Jev, 이어 묻기는 LLM 으로 나누면 유리한가'였습니다. 설계 모양으로는 맞습니다. 나빠지는 자리가 없고 첫 턴만큼 좋아집니다. 얼마나 좋아지는지는 식이 하나입니다. 이득 = 첫 턴 비율 × 1.4초. 그래서 업무 화면의 대화 DB 를 셌습니다.
user 메시지 1,054건, 대화 893건이었습니다. 겉으로는 첫 턴이 85% 이고 대화의 93% 가 질문 하나로 끝납니다. 여기서 멈췄으면 '융합하면 평균 1.2초가 준다'로 갔을 겁니다. 날짜별로 다시 보니 나흘에 790건이 몰려 있었고 소유자가 둘이었습니다. 139문항 답변 품질 기준선 재측정이었습니다. 벤치마크는 애초에 단발 질문으로 만들어져 있어서, 이 85% 는 벤치마크의 모양이지 사람의 모양이 아닙니다.
사람이 실제로 쓴 대화는 하루 한 자릿수였습니다. 실사용 첫 턴 비율은 아직 모릅니다. 이득 식에 넣을 항이 '모름 × 하루 한 자릿수'가 되면서 결론이 한 번 더 움직였습니다.
정확도가 좋다는 말은 아니었습니다
네 번째 물음은 '그러면 Jev 가 도구를 더 잘 고른다는 말이냐'였습니다. 아닙니다. 앞에서 말한 '유리'는 속도 하나였고 정확도 근거는 없습니다. 지금 라우터는 4/4 이고 알려진 오답 문제가 없습니다. Jev 는 라우팅으로 0건 측정입니다. 간접 근거가 하나 있는데 방향이 반대입니다. 문서 분류에서 문턱 없이 쓰면 확실한 라벨 17건 기준으로 LLM 이 100%, Jev 가 88% 였습니다. 라우팅도 같은 성격이라 비슷할 가능성은 있지만 추정입니다. '더 낫다'가 아니라 '검증된 쪽이 라우터'입니다.
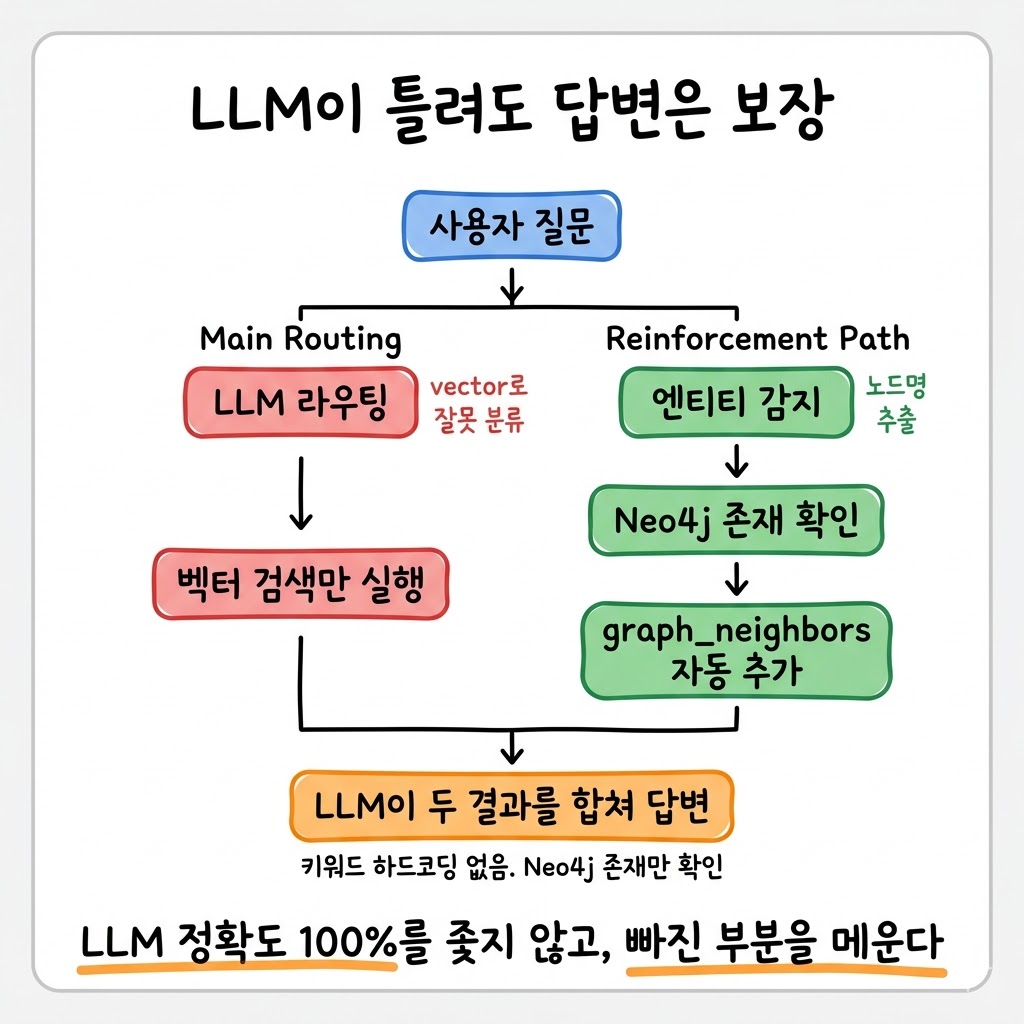
기대할 수 있는 것은 확신값입니다. 지금 LLM 라우터는 확신을 돌려주지 않아서, 낮으면 안전한 도구로 보내는 신호가 없습니다. 분류 모델은 그 신호를 줍니다. 다만 정확도가 아니라 틀렸을 때를 다루는 장치이고, 라우터가 틀려도 답이 무너지지 않게 하는 보강은 이미 다른 방식으로 넣어 뒀습니다.
손익표와 결정
선택지는 셋이었습니다.
선택지 | 얻는 것 | 내는 것 |
|---|---|---|
(A) 라우터를 통째로 Jev 로 | — | 풀어쓰기 때문에 성립하지 않는다 |
(B) 첫 턴만 Jev, 이어 묻기는 LLM | 첫 턴 1.4초(뺄셈값) · 확신값 신호 | 라우팅 경로가 둘이 되어 도구 설명을 양쪽에 맞춘다 · Jev 장애 시 타임아웃 뒤 LLM 으로 떨어져 그 턴은 더 느려진다 · 얼리액세스 API 가 핫패스(매 턴 도는 채팅 응답 경로)에 들어온다 |
(C) 지금은 안 넣는다 | 대가를 안 낸다 | 사용량이 붙었을 때 첫 턴 1.4초를 아직 못 얻는다 |
(C) 를 골랐습니다. 설계 모양으로는 (B) 가 맞지만 시점이 아닙니다. 사용량이 하루 한 자릿수라 절감 총량이 사실상 0 이고, 경로가 둘이 되는 대가만 먼저 내게 됩니다. 사용량이 늘어 '답이 느리다'가 실제 불만으로 나오면 그때 실사용 첫 턴 비율을 다시 재고 첫 턴 Jev 부터 검토합니다. 기록에 적혀 있던 '채팅 라우팅' 줄은 지우지 않고 '이렇게 적었는데 틀렸다'를 붙여 뒀습니다. 지우면 같은 추론이 다음에 또 들어오고, 사용량이 늘면 그 줄이 다시 맞는 줄이 되기 때문입니다.
분류 모델이 LLM 호출을 실제로 대체하는 자리로 남은 것은 하나입니다. 종류 체계를 바꿀 때 문서 9,044건을 전량 재분류하는 일입니다. 요약과 참여자는 건드리지 않고 종류만 다시 매기는 일이라 고르기만 남고, 건당 지연으로 계산하면 LLM 은 수 시간, Jev 는 수십 분입니다. 이것도 돌려 본 값이 아니라 계산입니다. 호출을 열어 봤을 때 고르기만 남는 자리가 진짜 자리입니다.
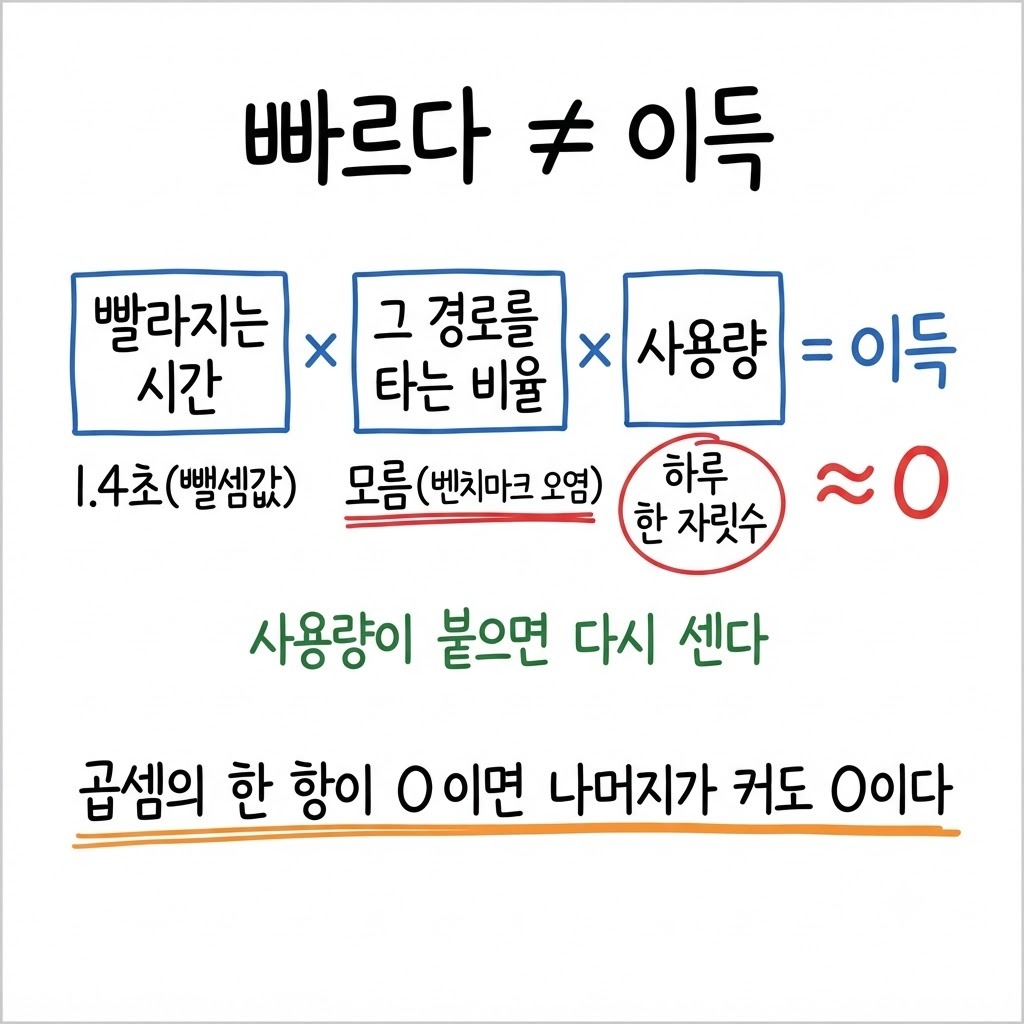
빠른 모델을 끼우기 전에 보는 순서
자리는 기능이 아니라 호출 단위로 본다 — 실제 호출을 열어 그 안에 문장을 만드는 일이 있는지부터 본다
이득은 곱셈으로 센다 — 빨라지는 시간 × 그 경로를 타는 비율 × 사용량. 한 항이 0 에 가까우면 전체가 0 이다
집계 전에 행의 주인을 본다 — 벤치마크·크론·테스트가 사람과 같은 표에 쌓이면 비율이 그쪽 모양이 된다
'좋다'를 들었으면 무엇이 좋다는 건지 되묻는다 — 말한 쪽은 속도였는데 듣는 쪽은 정확도로 듣는다
한 시간 동안 결론은 '넣으면 좋다'에서 '첫 턴만 된다'로, '첫 턴 비율을 모른다'로, 다시 '지금은 안 넣는다 — 사용량이 붙으면 첫 턴부터'로 세 번 움직였습니다. 처음 표의 한 줄은 코드를 안 열어 본 채 기능 이름만 보고 적은 것이었고, 두 번째 숫자는 표를 나누지 않고 센 것이었습니다.