LLM이 입력 메타를 출력에 복사하는 버릇 — 프롬프트로 못 막아서 후처리로 갔습니다
"title 한글 사이에 영어 메타가 끼었습니다"
추천 시스템을 운영하다가 LLM 출력에서 이상한 패턴을 발견했습니다.
LLM이 응답으로 만들어주는 추천 카드의 title 필드에 입력 메타데이터가 그대로 복사되고 있었어요.
title="[검색 조건 확장] 필터 추가 기능 (priority=medium) (due 2026-05-20) — project=alpha"원래 title은 한글 제목 한 줄("검색 조건 확장 — 필터 추가 기능")이어야 했는데, LLM이 입력으로 받은 raw 직렬화 텍스트를 거의 그대로 출력에 복사한 결과였습니다. priority, due, project 같은 메타가 한글 사이에 끼어서 어색한 출력이 됐어요.
원인은 입력 포맷에 있었습니다. LLM에 후보 데이터를 raw 직렬화 텍스트로 주입하고 있었거든요. 직렬화 헬퍼가 다음과 같은 포맷을 만들고 있었어요.
[검색 조건 확장] 필터 추가 기능 (priority=medium) (due 2026-05-20) — project=alpha대괄호 안에 카테고리, 본문, 그리고 메타(priority, due, project)가 한 줄에 압축된 형식. LLM이 후보를 식별하는 데 유용한 정보였지만, 응답을 만들 때 이 raw 텍스트를 title에 그대로 복사하는 버릇이 생겼습니다.
시스템 프롬프트 강화로는 못 막혔습니다
본능적으로 시스템 프롬프트 강화를 시도했어요. "title 필드에 메타(priority, due, project)를 넣지 마"라고 명시했습니다.
결과: 일부 개선, 불완전.
프롬프트 강화로 어느 정도는 잡혔지만, 일부 응답에서는 여전히 메타가 끼었어요. LLM이 입력 텍스트를 그대로 복사하는 패턴이 학습 데이터에서 강하게 자리잡은 버릇이라, 프롬프트 지시만으로 100% 제어가 안 됐습니다.
이게 흥미로운 지점이었어요. 프롬프트로 못 막는 LLM 버릇이 있다는 사실을 알게되었습니다.
LLM의 학습 데이터에는 "입력에 있는 텍스트를 출력에 활용하는" 패턴이 압도적으로 많습니다. 요약, 인용, 재구성 같은 작업이 다 이 패턴이에요. 그래서 "입력에 있는 메타를 출력에 복사하지 마"라는 지시는 LLM의 학습된 본능과 정면 충돌합니다. 프롬프트가 강력해도 본능을 100% 이기지는 못해요.
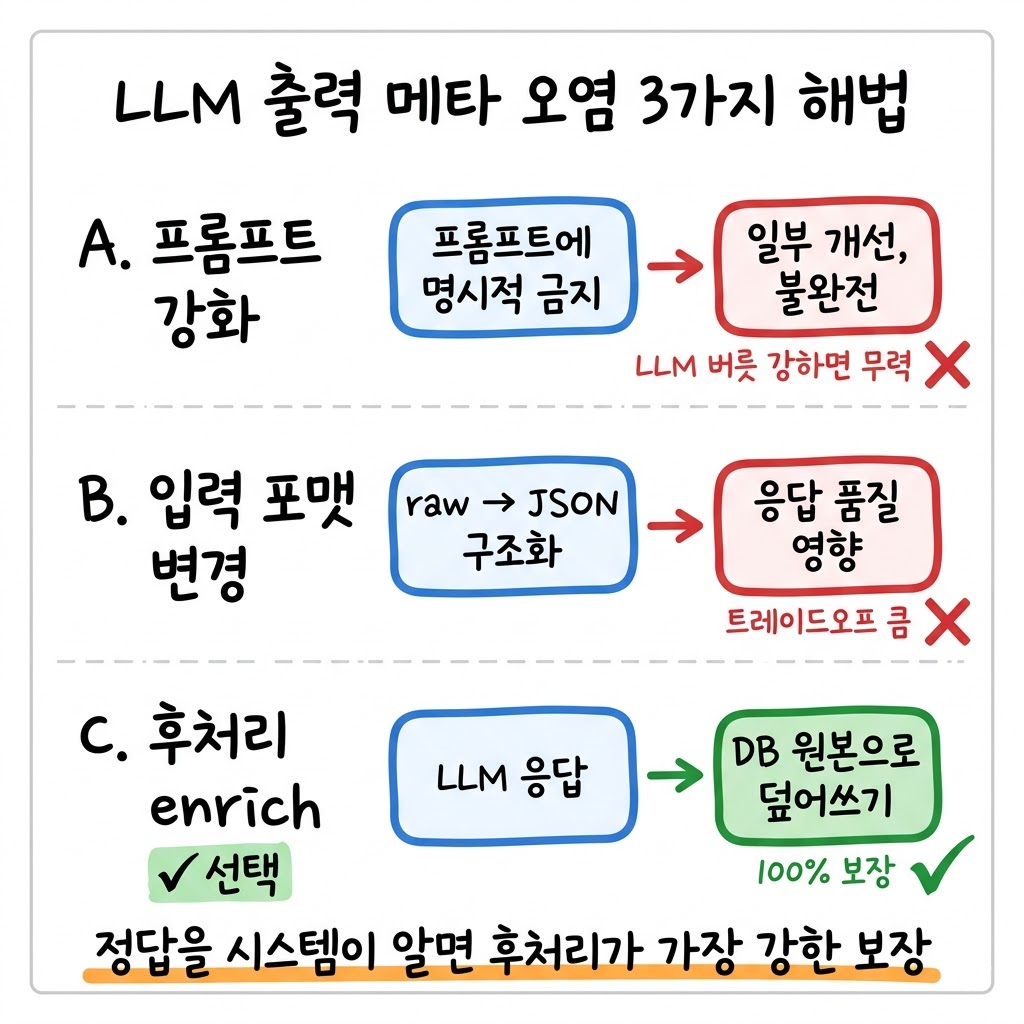
3가지 해법의 트레이드오프
LLM 출력 품질 문제에 보통 세 가지 해법이 있습니다.
해법 | 동작 | 한계 |
|---|---|---|
A. 프롬프트 강화 | 시스템 프롬프트에 명시적 금지 | LLM 버릇 강하면 불완전 |
B. 입력 포맷 변경 | raw 텍스트 → JSON 같은 구조화 | 응답 품질 자체에 영향 |
C. 후처리 enrich | LLM 응답을 DB 원본으로 덮어쓰기 | 정답을 시스템이 알아야 가능 |
해법 A — 프롬프트 강화
장점: 구현 단순, 코드 변경 없음
한계: LLM 학습 데이터의 패턴이 강하면 무력. 응답마다 일관성 보장 X
해법 B — 입력 포맷 변경
raw 텍스트 대신 JSON으로 후보를 주입하는 방식입니다. 메타가 별도 필드로 분리되어 있으니 LLM이 title 필드에 복사할 가능성이 줄어요.
장점: 구조적 분리로 오염 가능성 감소
한계: LLM이 JSON 입력을 받았을 때 응답 품질이 달라질 수 있음. 자연어 입력일 때 더 풍부한 응답이 나오는 경우가 많아서, 입력 포맷을 바꾸면 응답 품질 자체에 영향이 가요. 이건 트레이드오프가 큰 변경입니다.
해법 C — 후처리 enrich
LLM 응답을 받은 후 ID로 DB에서 진짜 title을 다시 조회해서 덮어씁니다.
장점: 100% 보장. LLM이 어떻게 가공하든 깨끗한 원본 title만 노출
한계: 정답을 시스템이 미리 알아야 가능. DB 조회 비용이 추가됨
선택은 해법 C였습니다. 이번 케이스의 조건이 후처리 enrich에 딱 맞았어요.
추천 시스템이라 정답(원본 title)을 시스템이 이미 알고 있음
LLM은 후보 선정·정렬·이유 생성에 집중하고, title은 표시용
DB 조회를 N+1 없이 단일 쿼리로 처리 가능
후처리 enrich 구현 — N+1 없이 단일 Cypher
후처리 비용이 크면 메인 흐름에 부담이 됩니다. 비용을 작게 만드는 게 핵심이었어요.
핵심 구현
LLM 응답에서 ID 목록을 추출한 후, DB에서 한 번에 조회합니다.
MATCH (n) WHERE n.id IN $ids
RETURN n.id AS id,
       coalesce(n.title, n.question, n.name) AS title
id IN $ids로 단일 쿼리. N+1 회피의 기본 패턴입니다. 추천이 10개여도 50개여도 DB 조회는 1회예요.
노드 타입별 필드 매핑
추천 후보가 여러 노드 타입에서 옵니다. 어떤 건 title 필드를 쓰고, 어떤 건 question, 어떤 건 name을 씁니다. coalesce로 한 번에 매핑했어요.
coalesce(n.title, n.question, n.name) AS title이렇게 하면 노드 타입을 분기하지 않고 단일 쿼리로 모든 타입의 표시용 텍스트를 가져옵니다.
적용 위치
두 군데에 같은 enrich를 적용했어요.
generate() — LLM 응답 파싱 직후
toResponse() — 옛 캐시 노드 로드 시
캐시된 옛 응답에도 같은 enrich를 적용한 게 중요했습니다. 이렇게 하면 캐시 마이그레이션 없이 점진 정상화가 일어나요. 옛 캐시도 표시될 때 자동으로 깨끗한 title로 덮어쓰기됩니다.
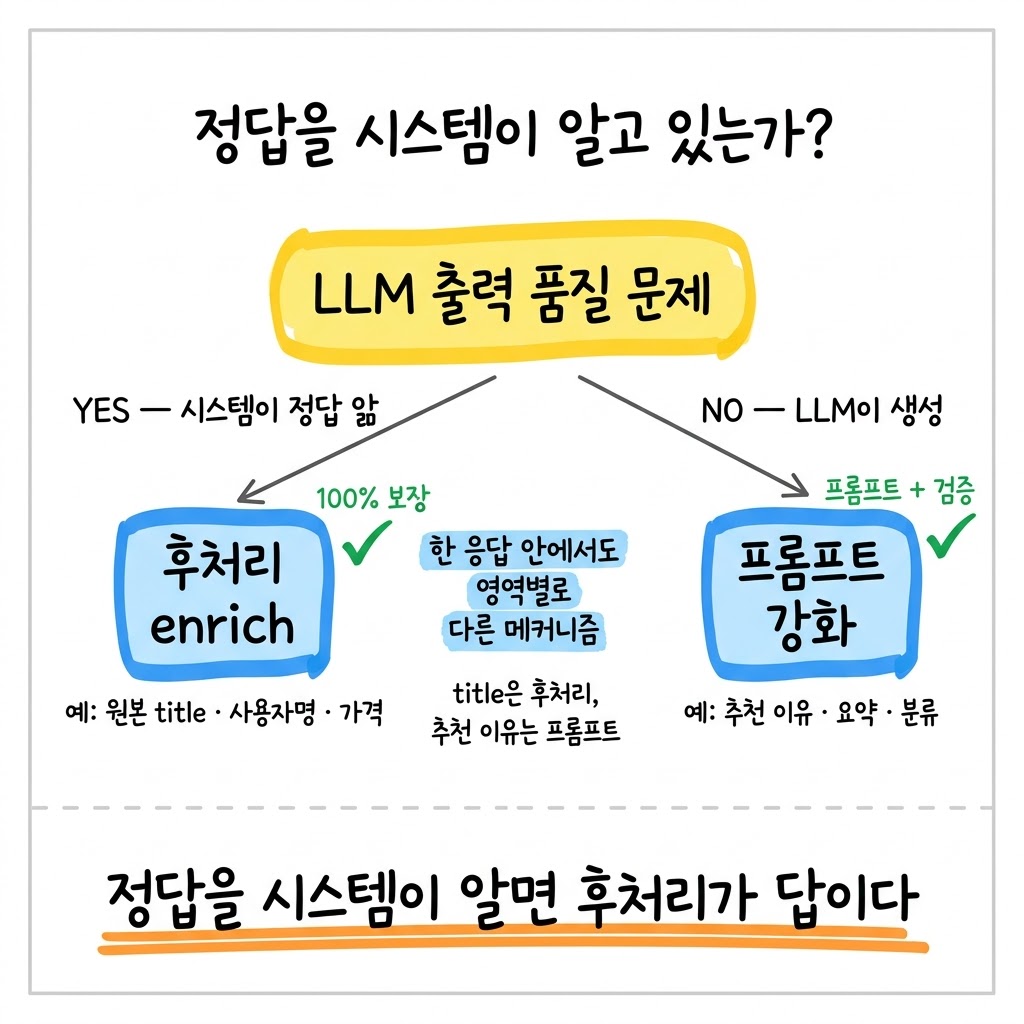
일반 패턴 — "정답을 시스템이 알면 후처리, 모르면 프롬프트"
이번 결정에서 나온 일반 원칙입니다.
LLM 출력 품질 문제를 만나면 가장 먼저 던질 질문이 있어요. "정답을 시스템이 미리 알고 있는가?"
정답 출처 | 적합한 해법 |
|---|---|
시스템이 정답을 알고 있음 (DB·설정·규칙) | 후처리 enrich로 덮어쓰기 |
LLM이 자유롭게 생성해야 함 (글쓰기·요약) | 프롬프트 강화 + 검증 |
일부만 시스템이 알고 일부는 LLM이 생성 | 부분 enrich + 나머지는 프롬프트 |
이번 케이스는 정답이 명확했습니다. title은 DB에 있는 원본이 정답이고, LLM은 그 title을 가공하면 안 되는 영역이었어요. 정답이 명확한데 LLM에게 자유를 주면 오염이 발생합니다.
반대로 추천 이유, 카테고리 분류, 우선순위 같은 부분은 LLM이 생성해야 합니다. 이런 영역은 후처리로 덮어쓸 정답이 없어요. 프롬프트로 가는 게 맞습니다.
한 추천 응답 안에서도 영역별로 다른 메커니즘을 써야 했어요.
title — 후처리 enrich (정답 있음)
추천 이유 — 프롬프트 (정답 없음, LLM 생성)
카테고리 — 프롬프트 (LLM 판단)
이 분리가 LLM 출력 품질의 안정성을 만듭니다.
LLM 운영 검토 체크리스트
LLM 출력 품질 관리·후처리 설계·프롬프트 엔지니어링을 검토하실 때 점검할 일반 체크리스트입니다.
1. 프롬프트로 못 막는 LLM 버릇이 있다는 점을 인정합니다
"프롬프트 강화하면 되겠지"가 본능이지만, LLM 학습 데이터의 패턴이 강한 영역은 프롬프트로 100% 제어가 안 됩니다. 입력 텍스트를 출력에 복사하는 패턴, 특정 어휘 선호, 특정 포맷 출력 같은 영역은 프롬프트만으로 안 풀립니다.
2. "정답을 시스템이 알고 있는가"부터 묻습니다
LLM 출력 품질 문제를 만나면 가장 먼저 묻습니다. 정답을 알면 후처리, 모르면 프롬프트. 이 결정이 안정성을 좌우합니다.
3. 한 응답 안에서도 영역별로 다른 메커니즘을 씁니다
title은 후처리, 추천 이유는 프롬프트. 응답 전체를 같은 메커니즘으로 처리하지 않습니다. 영역별로 정답 출처가 다르면 메커니즘도 달라야 안정적입니다.
4. 후처리 비용을 작게 만듭니다
N+1 회피, 단일 쿼리, 인덱스 활용. 후처리가 메인 흐름에 부담이 되면 도입 자체가 어려워집니다. 단일 쿼리로 가능한 경우가 많으니 설계 단계에서 비용을 작게 만드는 게 중요합니다.
비슷한 발상이 다른 LLM 운영 결정에서도 흐릅니다. LLM 단독에 책임을 떠넘기지 않는 것, 정답이 있는 영역과 없는 영역을 분리하는 것, 후처리·검증 레이어를 부담 없이 깔 수 있도록 설계하는 것. LLM 운영 안정성의 핵심 기준입니다.
:::link-preview:::{"url":"https://deoklab.com/b/58","title":"LLM이 검색 도구를 잘못 골랐을 때, 답변까지 망가지지는 않게 했습니다","description":"라우팅이 100%가 되지 않았습니다저희 RAG 시스템에는 LLM 라우팅 단계가 있습니다. 사용자 질문이 들어오면 LLM이 먼저 의도를 분류하고 어떤 검색 도구를 쓸지 결정합니다. 벡터 검색만 쓸지, 그래프 검색을 같이 쓸지, 후속 질문으로 처리할지 같은 결정입니다.:::link-prev","image":"https://d1uz7z458wk5xu.cloudfront.net/blog/2026/05/f8691c3d-e910-48b4-8986-cb2b312ac6b8.jpeg","siteName":""}:::end:::
마무리
추천 시스템 LLM 응답의 title 필드에 입력 메타가 복사되는 문제가 있었습니다. 시스템 프롬프트 강화로는 일부만 잡혔고, 완전 제어가 안 됐어요. LLM이 입력 텍스트를 출력에 활용하는 패턴이 학습 데이터에 강하게 자리잡은 버릇이라 프롬프트로 못 막는 영역이었습니다. 결국 후처리 enrich로 DB 원본 title을 덮어쓰는 방식을 선택했고, 단일 Cypher + coalesce로 비용도 작게 만들었습니다.
핵심 교훈은 세 가지입니다.
프롬프트로 못 막는 LLM 버릇이 있다 — 학습 데이터의 패턴이 강한 영역은 프롬프트만으로 100% 제어 어려움
"정답을 시스템이 알고 있는가"가 결정 기준 — 알면 후처리, 모르면 프롬프트
한 응답 안에서도 영역별로 다른 메커니즘이 안정적 — title은 후처리, 추천 이유는 프롬프트
LLM 출력 품질·후처리 설계·프롬프트 엔지니어링을 검토하신다면, 이번 글의 4가지 체크리스트(프롬프트 한계 인정 / 정답 출처 진단 / 영역별 메커니즘 / 후처리 비용 최소화)를 한 번 살펴보시길 추천합니다. 프롬프트가 만능이 아니라는 점을 인정하면 더 안정적인 해법이 보일 때가 많았습니다.