Gemma 4 검수기는 생각을 끄니 최대 14배 빨라졌고, 글쓰기 모델은 켜 뒀습니다
같은 로컬 모델인데 검수를 맡길 때 생각을 끄니 6~14배 빨라졌고, 잡아내는 오류 수는 거의 같았습니다. 그래서 글을 쓰는 쪽도 끄려고 생각 내용을 열어 봤습니다. 모델은 그 안에서 첫 줄을 스스로 두 번 고치고 있었습니다.
1인 개발사인 저희는 블로그 글마다 요약 문서를 만들고, 그것을 쓰레드 반말 글 5편으로 옮깁니다. 지금은 Claude 가 이 일을 합니다. 이것을 작업용 노트북의 로컬 모델(Gemma 4 26B-A4B, LM Studio 로 4건 동시 실행)로 바꿀 수 있는지 시험하고 있습니다.
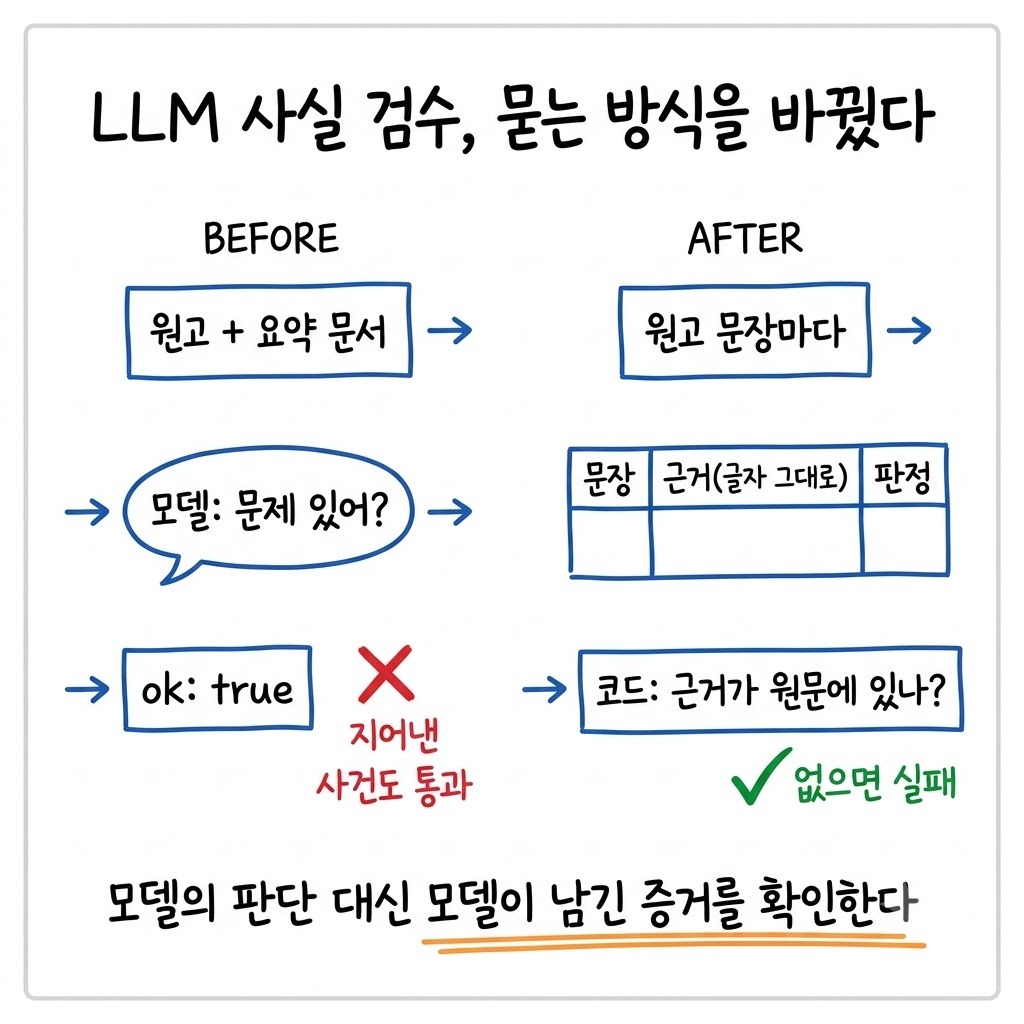
전날에는 근거 문장을 인용하게 하는 검수와, 지적이 있으면 최대 3회 다시 쓰게 하는 '하네스'를 만들었습니다. 그래도 요약 문서가 확정하지 않은 일을 확정처럼 쓰는 오류와, 다섯 편이 같은 장면으로 시작하는 '도입 겹침'이 남았습니다. 이 글은 그다음 날 새로 알게 된 것만 다룹니다.
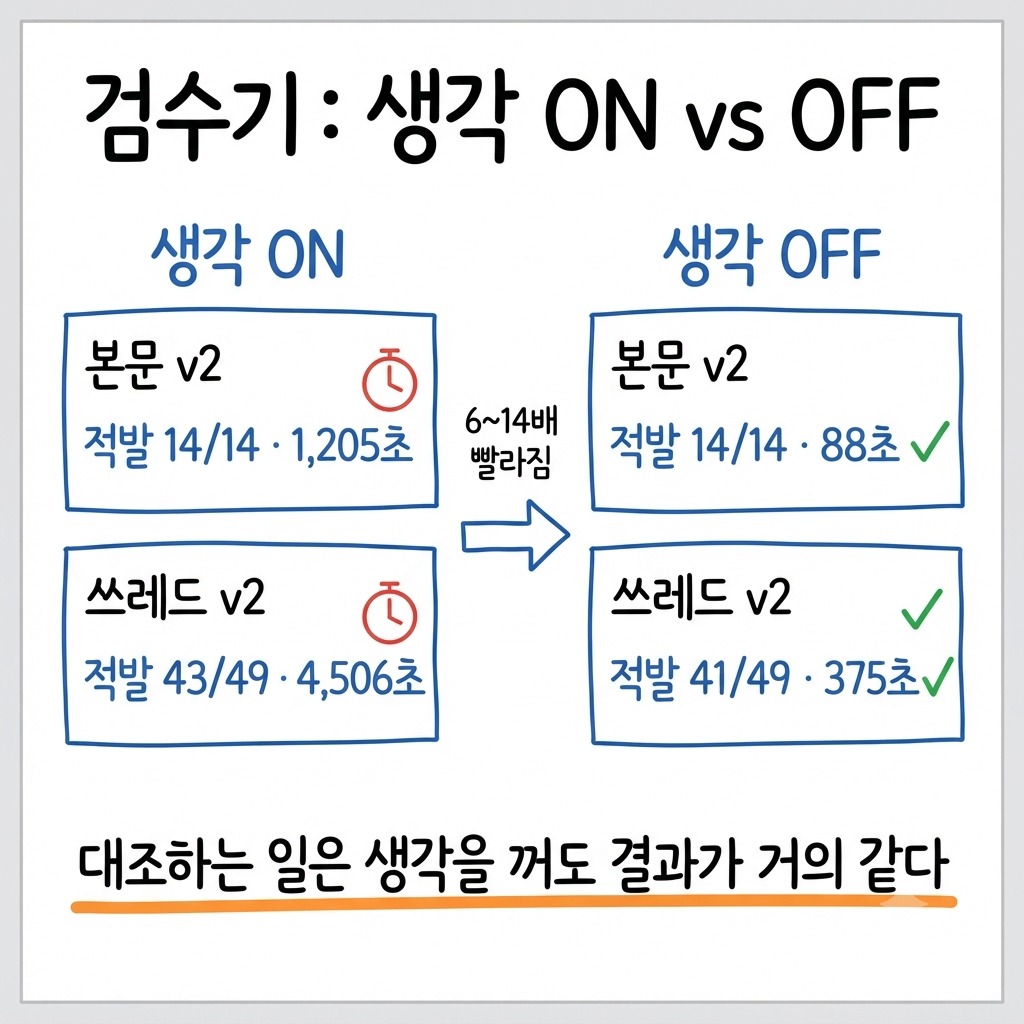
검수기는 생각을 꺼도 결과가 거의 같았습니다
검수기만 떼어 시험 문제를 만들었습니다. 쓰레드 90편(앞선 채점에서 오류가 있던 편 49, 없던 편 41)과 본문 30문단(오류를 하나씩 심은 문단 14개, 원래 문단 16개)입니다. v1 은 지어냄·반대·과장만 대조했고, v2 는 인과·단정·금지를 더했습니다.
시험 | 생각 켬 (적발 / 오탐 / 시간) | 생각 끔 (적발 / 오탐 / 시간) |
|---|---|---|
본문 v1 | 14/14 · 8/16 · 533초 | 14/14 · 8/16 · 71초 |
본문 v2 | 14/14 · 9/16 · 1,205초 | 14/14 · 9/16 · 88초 |
쓰레드 v1 | 24/49 · 9/41 · 1,935초 | 21/49 · 10/41 · 311초 |
쓰레드 v2 | 43/49 · 27/41 · 4,506초 | 41/49 · 22/41 · 375초 |
본문에서는 적발과 오탐이 한 건도 다르지 않았습니다. 쓰레드에서는 끄자 적발이 2~3건 줄었습니다. 시간은 본문 v2 가 1,205초에서 88초로 줄었습니다. 원고와 원문을 대조하는 일은 답이 이미 원문에 있어서, 오래 생각해도 결과가 크게 나아지지 않는 것으로 보입니다.
끄는 방법에서도 한 번 막혔습니다. LM Studio 에서는 reasoning_effort 를 none 으로 줬을 때만 생각이 꺼졌습니다. 같은 뜻으로 보이는 chat_template_kwargs.enable_thinking 을 false 로 줬을 때는 생각 토큰이 그대로 나왔습니다. 옵션 이름만 믿었다면 느린 검수기를 그대로 쓰면서 빨라졌다고 생각했을 겁니다. 출력에 생각 토큰이 남는지 직접 요청해 보고 확인했습니다.
오탐 13건이 사실은 빈 응답이었습니다
이 표를 만들기 전에 저는 본문 v2 오탐을 13/16 으로 보고했습니다. 이렇게 적었는데 틀렸습니다. 위반이 없을 때 Gemma 는 빈 배열 대신 빈 객체를 돌려주는 경우가 있었습니다. 결과를 세는 코드는 이것을 '읽지 못함'으로 보고 '문제 있음'으로 셌습니다.
# 기대한 응답: {"위반": []}
# 실제 응답:   {}
violations = result.get("위반", [])  # 고친 뒤
한 줄을 고치자 오탐이 9/16 으로 내려갔습니다. 모델이 아니라 세는 코드가 '없음'과 '못 읽음'을 한 값으로 묶은 것입니다. 이 버그를 못 봤다면 v2 검수기가 지나치게 예민하다고 결론 내렸을 겁니다.
쓰레드 v2 오탐 27건 중 '단정 검수'(요약 문서의 유보 문장을 정규식이 먼저 추출해 번호를 붙이고, 원고가 그것을 확정처럼 말했는지만 묻는 검수)에서만 잡힌 8건도 읽었습니다. 절반쯤은 실제 단정이었습니다. 정답표를 만든 채점이 놓친 것입니다. 8건 표본으로 본 판단입니다.
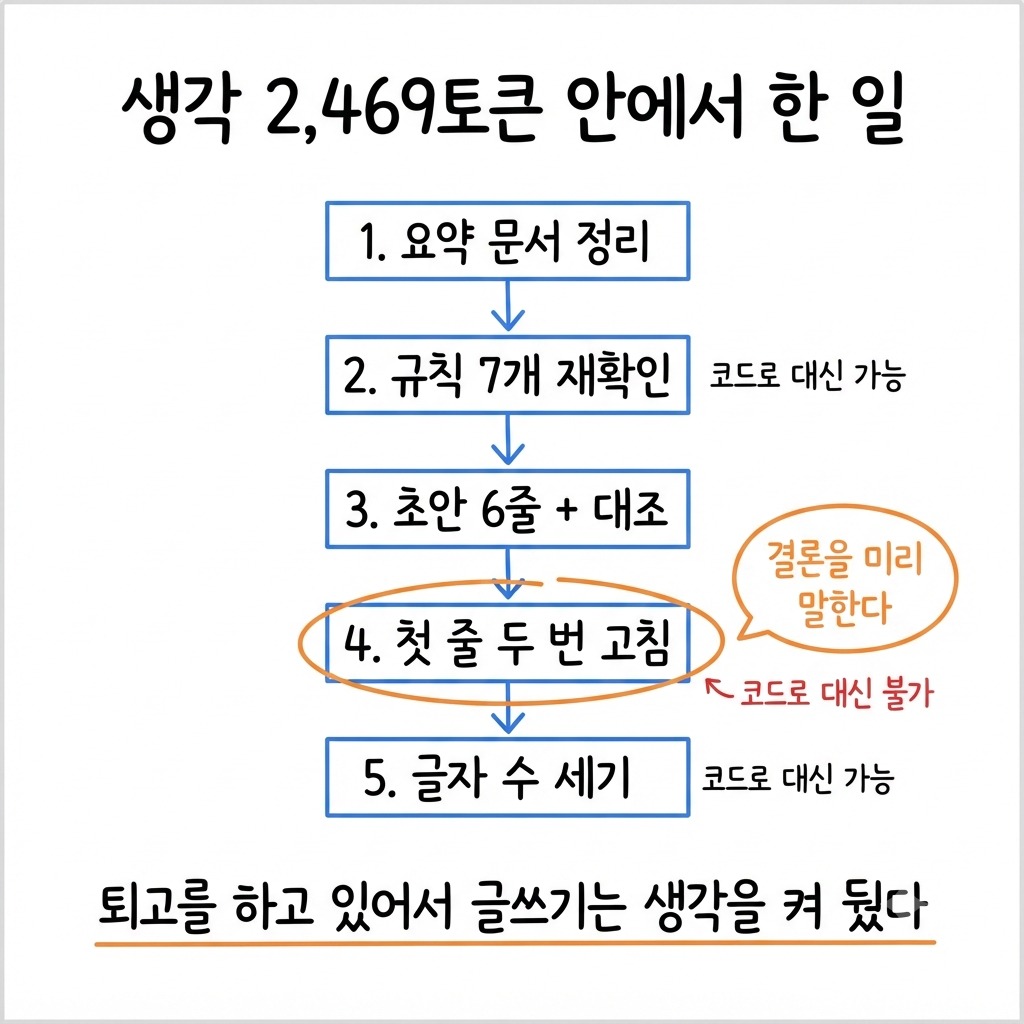
글쓰기 모델의 생각을 열어 보니 퇴고를 하고 있었습니다
하네스 한 판에서 출력 토큰 31,824개 중 27,374개, 86%가 생각이었습니다. 글쓰기도 끄고 싶었습니다. 끄기 전에 한 편을 쓸 때의 생각 2,469토큰을 처음부터 읽었습니다.
요약 문서를 정리합니다
글쓰기 규칙 7개를 다시 확인합니다
초안 6줄을 쓰고 요약 문서와 대조합니다
첫 줄이 결론을 미리 말한다고 스스로 지적하고 두 번 고칩니다
글자 수를 셉니다
네 번째 단계가 판단을 정했습니다. 글자 수나 말투는 코드 검사가 대신할 수 있습니다. 첫 줄이 결론을 먼저 말해 버리는지는 코드가 판단하지 못합니다. 그래서 검수 모델만 생각을 끄고 글쓰기 모델은 켜 두었습니다.
시작 장면을 정해 주자 장면을 채우려고 지어냈습니다
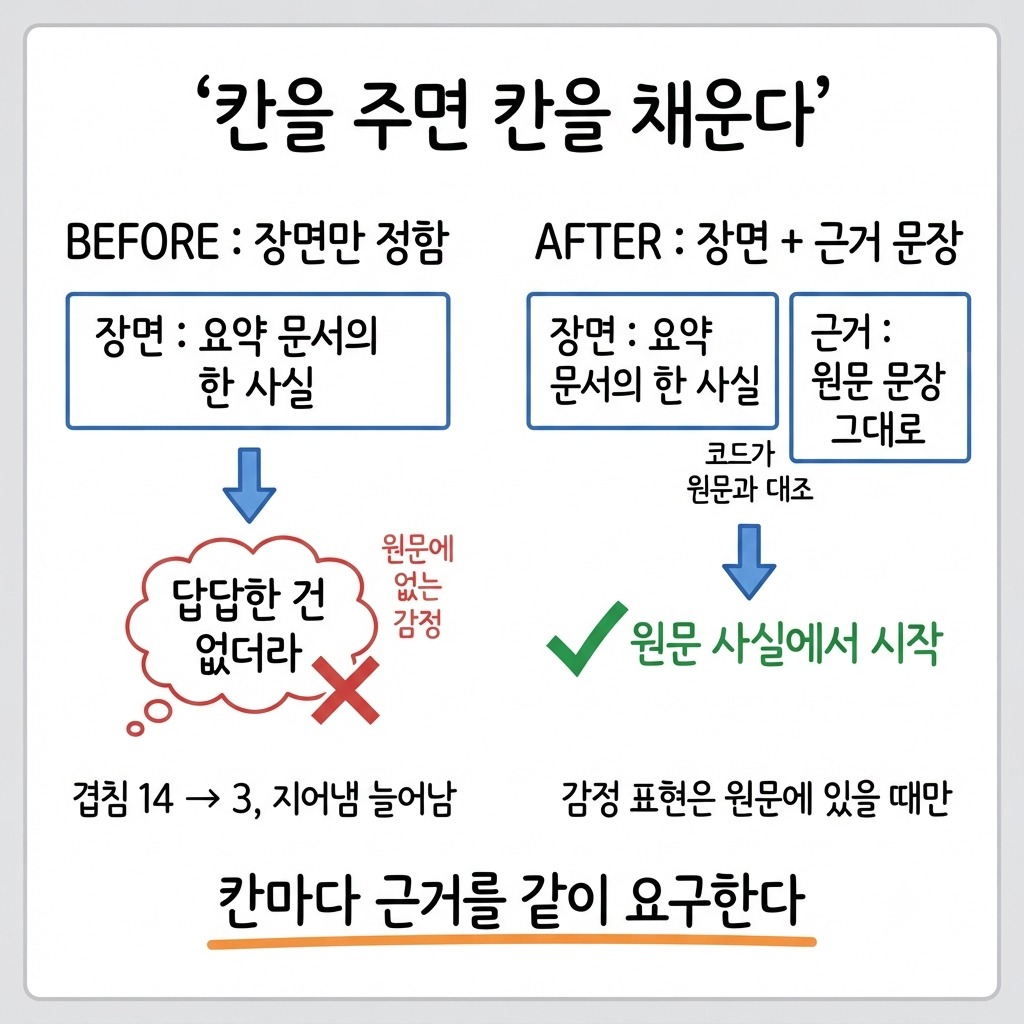
도입 겹침을 줄이려고 '시작 장면 계획'을 붙였습니다. 다섯 편을 쓰기 전에 한 번만 호출해서, 편마다 요약 문서의 어느 사실에서 시작할지 정하게 하는 단계입니다. 4회차 채점에서 겹침은 14에서 3으로 줄었습니다.
대신 정해 준 장면을 채우려고 원문에 없는 감정이나 결과를 지어냈습니다. '답답한 건 없더라', '결과가 좋아졌거든' 같은 문장입니다. 모델에게 칸을 주면 칸을 채웁니다. 그래서 장면마다 근거 문장을 원문에서 글자 그대로 옮기게 하고, 그 문장이 원문에 있는지 코드가 대조하게 했습니다. 감정·정도 표현(한참·아무리 류)은 원문에 있을 때만 쓰게 했습니다. 로컬 모델 오류의 큰 비중이 이런 표현이었습니다.
심판 점수도 회차마다 흔들렸습니다
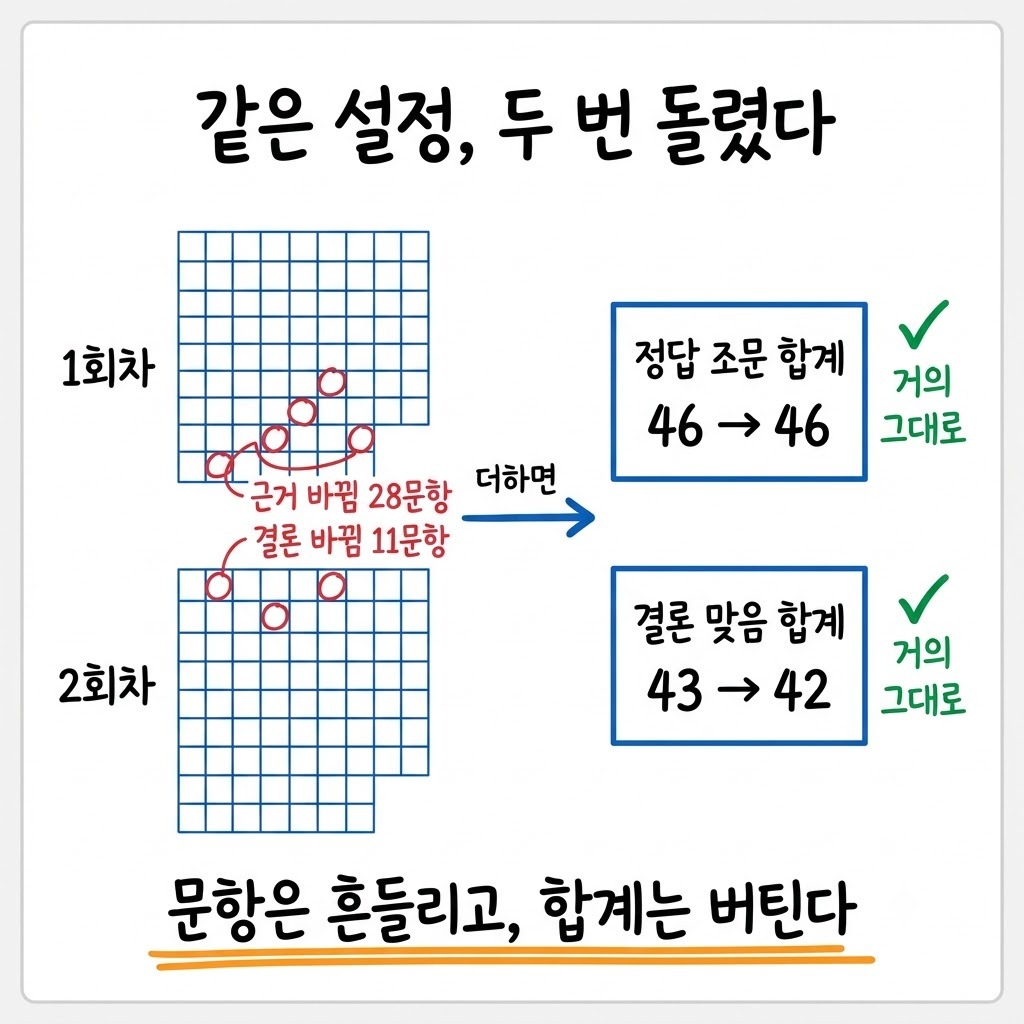
결과는 '블라인드 채점'으로 쟀습니다. 작성자를 가린 판을 섞어 오푸스에게 문장 단위로 사실 대조를 시키고, 정답표는 주지 않았습니다. 그런데 같은 v2 원고가 3회차에 오류 3, 4회차에 4, 5회차에 10으로 나왔습니다. 같은 Claude 운영 원고도 8, 4, 6이었습니다.
그래서 회차를 넘어 숫자를 비교하지 않고, 같은 회차에 섞은 판끼리만 견줬습니다. 아래는 5회차, 세 글 15편 합계입니다.
판 | 사실 오류 | 올릴 수 있는 편 | 읽힘(10점) | 도입 겹침 |
|---|---|---|---|---|
Claude 운영판 | 6 | 10 | 8.0 | 4 |
Gemma v2 | 10 | 8 | 5.0 | 14 |
v2 + 시작 장면 계획 | 7 | 9 | 5.7 | 2 |
v2 + 계획(근거 문장) + 감정 규칙 | 2 | 13 | 6.0 | 4 |
마지막 판은 세 글 모두에서 v2 보다 순위가 높았고, 두 글에서는 Claude 운영판보다도 높았습니다. 글 하나(5편)에 걸린 시간은 464~664초로, 검수도 생각을 켰던 전날의 374~667초와 비슷했습니다. 읽힘 점수는 Claude 8점, Gemma 5~6점에서 거의 움직이지 않았습니다. 검수는 틀린 것을 빼 줄 뿐 잘 쓰게 만들지는 않습니다.
정리한 규칙
검수 모델은 생각을 끄고, 글쓰기 모델은 켭니다
확정하지 않은 것을 확정처럼 쓴 오류는 유보 문장 목록과 원고를 대조하는 검수로 따로 봅니다
시작 장면을 먼저 정하되, 장면마다 원문 문장을 그대로 옮기게 하고 코드가 대조합니다
검사 코드는 빈 응답과 실패를 나눠서 셉니다
원고를 고치기 전에 요약 문서부터 봅니다. 세 글 모두 제목은 원인을 확정하는데 본문은 유보하고 있었습니다
아직 모르는 것
같은 설정을 반복해 재지 않아, 오류 2 대 10의 차이가 얼마나 재현되는지 모릅니다
쓰레드에서는 끄자 적발이 2~3건 줄었습니다. 놓치면 비용이 큰 일이라면 판단이 달라질 수 있습니다
이미 유보한 문장('줄일 수 있을 것 같아' 류)도 단정으로 잡는 검수기 오탐은 그대로 두어, 세 번 고쳐 써도 통과 못 한 편이 글마다 0~3편 남았습니다
생각 모드를 끄기 전에 확인할 것
같은 시험 문제로 생각 켬과 끔을 나란히 재 봤는가
끄기 전에 생각 내용을 열어 무슨 일을 하는지 읽어 봤는가
끄는 옵션을 준 뒤 출력에 생각 토큰이 정말 사라졌는가
결과를 세는 코드가 빈 응답과 읽기 실패를 나누는가
LLM 심판의 흔들림을 먼저 재고, 같은 회차 안에서만 비교하는가
생각 모드는 모델 단위가 아니라 일 단위로 정합니다. 답이 원문에 있는 대조는 꺼도 결과가 같았고, 생각 안에서 퇴고하는 글쓰기는 켜 둘 이유가 있었습니다. 결론이 이상하게 좋거나 나쁘면 모델보다 결과를 세는 코드와 심판부터 다시 확인합니다. 이번에는 빈 응답 하나와 회차 하나가 결론을 반대로 만들 뻔했습니다.