AI 가 메일에서 뽑은 지식그래프 관계 922개를 전부 지운 이유 — 출처가 없으면 골라낼 수 없습니다
인프라 운영 조직에 AI 운영 도구를 만들어 넣었습니다. AI 채팅, 지식그래프, 운영 모니터링이 지금 서버에서 돌고 있습니다. 이 글은 AI 를 붙인 자리보다 AI 를 멈춰 세운 자리를 적은 기록입니다.
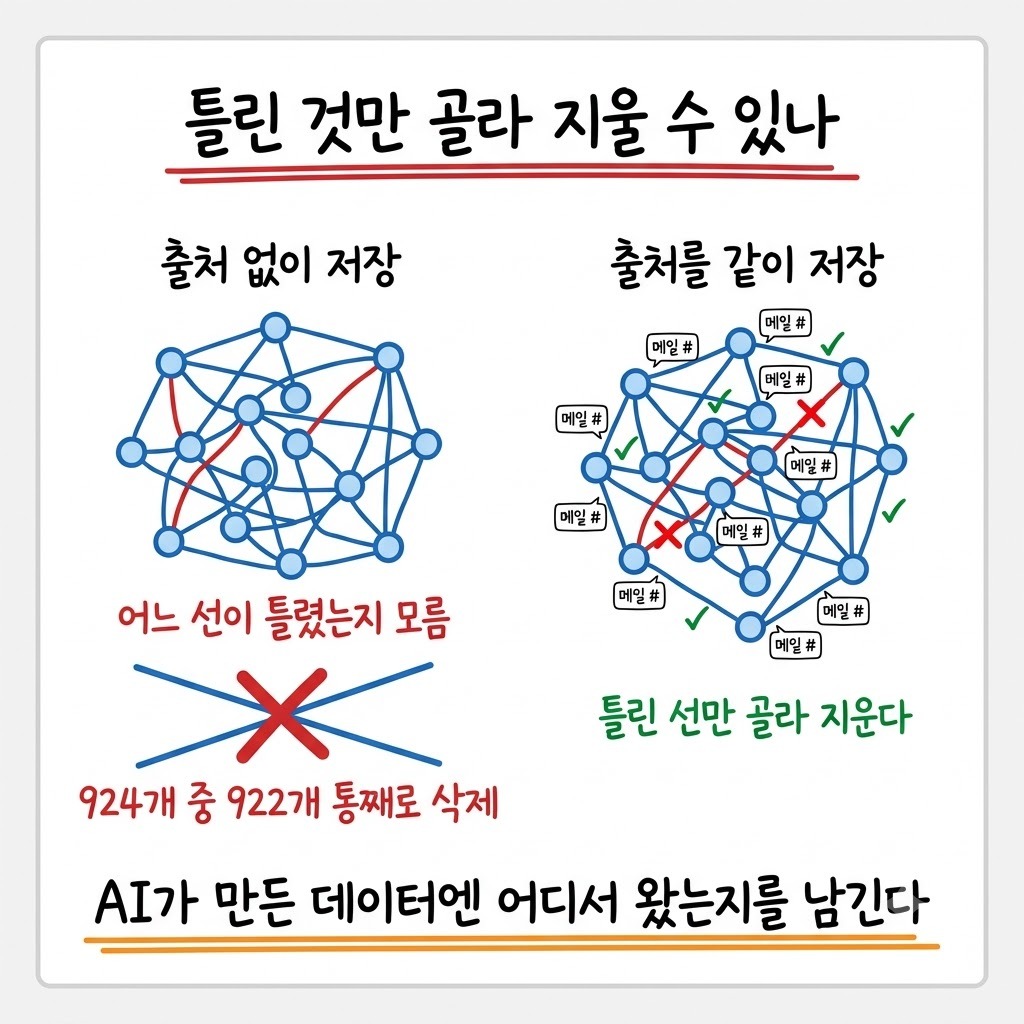
AI 가 메일에서 뽑아 만든 장애 관계 924개 중 922개를 한꺼번에 지웠습니다. 하나씩 검증해서 틀렸다고 판정한 것은 아닙니다. 어느 것이 맞는지 골라낼 근거를 남기지 않아서 통째로 지울 수밖에 없었습니다.
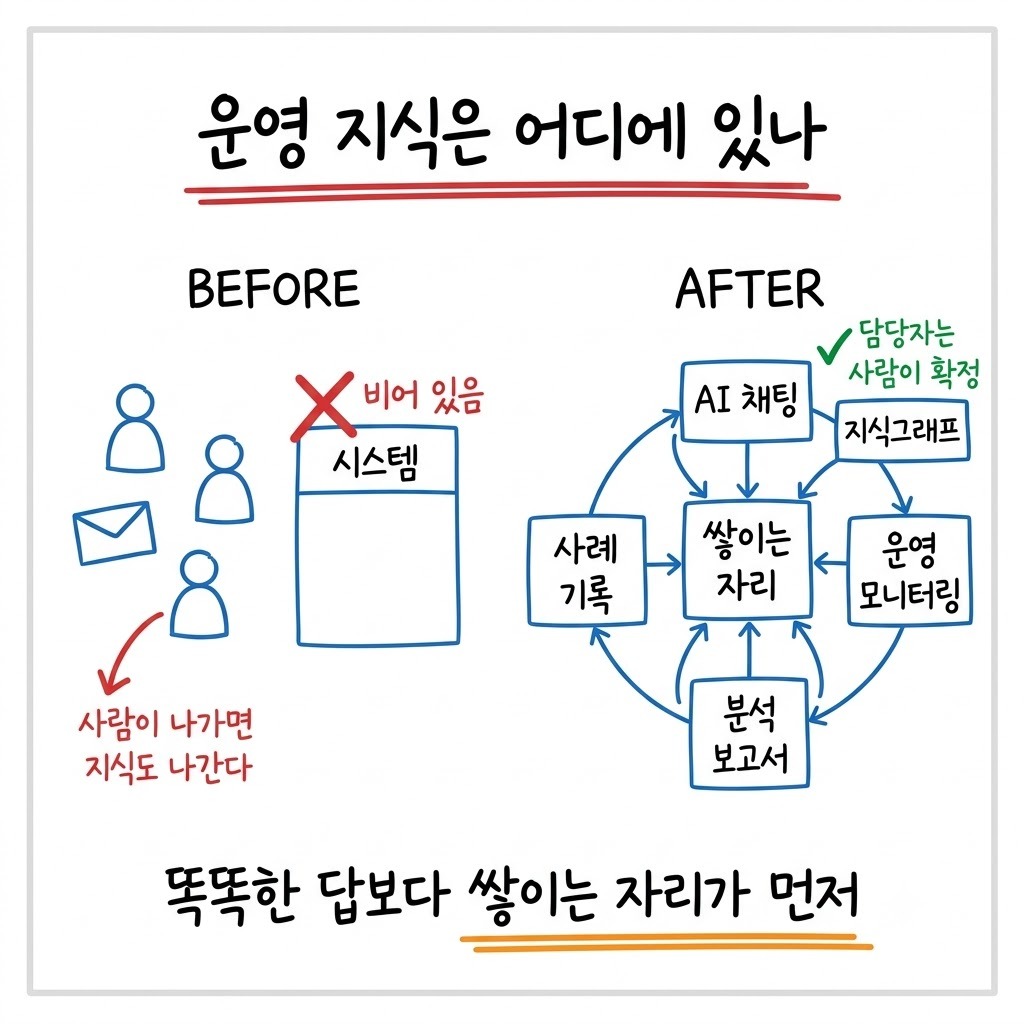
운영 지식이 메일함에만 있었습니다
이 조직의 장애 처리는 처음부터 끝까지 메일로 돌았습니다. 고객에게 직접 물어 받은 흐름은 이렇습니다.
장애 메일이 들어온다
원인 파악 회의를 연다
담당자에게 전달한다
개발하고 테스트한다
반영·배포하고 메일로 보고한다
에러 코드는 있었지만 '그래서 무엇을 해야 하나'를 적은 문서는 없었습니다. 시스템별 담당자를 정리한 엑셀도 없었습니다. 옆에서 본 바로는 한 건이 끝나는 데 며칠에서 몇 달까지 걸렸습니다. 느린 것보다 얼마나 걸릴지 예측이 안 되는 것이 더 큰 문제였습니다.
운영 지식이 사람과 메일함에 있고 시스템에는 없었습니다. 그 사람이 나가면 지식도 같이 나갑니다.
무엇을 만들어 넣었나
문서는 직접 올린 것과 메일 첨부를 합쳐 850건을 들여왔습니다. 그 위에 다섯 가지를 만들었습니다.
AI 채팅 — 메일·문서·지식그래프를 찾아 답합니다. 여러 에이전트가 질문에 맞는 도구를 골라 씁니다
지식그래프 — 메일과 문서에서 시스템·서비스·담당자·장애 사이의 관계를 뽑습니다. 미리 정한 유형 밖의 것은 따로 모아 사람이 검토합니다
운영 모니터링 — 로그와 서버 자원을 모아 알람으로 묶고, 매일 07:30 에 일일 보고서를 냅니다
장애 분석 보고서·영향 시뮬레이션 — 사람이 요청하면 만듭니다
사례 기록 — 알람과 메일에서 사례 후보를 만들고 비슷한 과거 사례를 붙입니다
이 글이 다루는 것은 기능 목록이 아니라, 어느 칸까지 AI 가 채우게 뒀는지입니다.
메일에서 뽑은 관계를 표본 10개만 열어 봤습니다
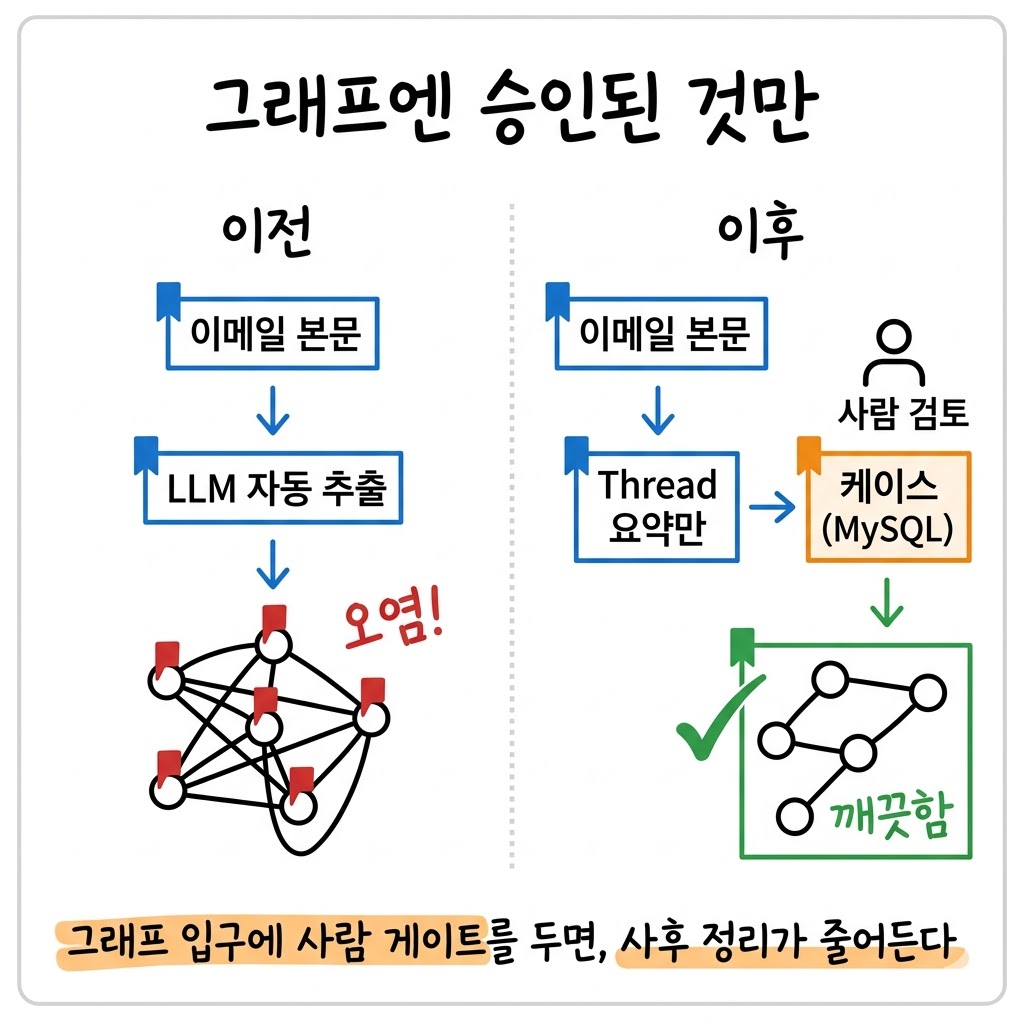
처음에는 메일을 AI 에게 읽혀 '어떤 장애가 어떤 시스템에 영향을 줬나'를 관계로 만들게 했습니다.
만들어진 관계에서 표본 10개를 골라 직접 확인했습니다. 그중 6개는 메일 제목과 상관없이 본문에 단어가 한 번 스친 것을 근거로 만들어져 있었습니다. 다만 표본이 10개뿐이라 이것을 전체 정확도로 말하지는 않습니다. 말할 수 있는 것은 열어 본 10개 중 6개가 그랬다는 것까지입니다.
표본 크기를 결론에 같이 적어야 하는 이유는 다른 프로젝트에서 먼저 겪었습니다.
출처가 없어서 골라낼 수 없었습니다
문제는 나머지였습니다. 각 관계가 어느 메일에서 나왔는지 기록하지 않았습니다. 맞는 관계만 남기려 해도 하나하나를 원래 메일과 다시 맞춰 볼 근거가 없었습니다.
그래서 출처를 기준으로 통째로 지웠습니다. 메일 자동 추출로 생긴 장애→시스템 관계 924개 중 922개를 지웠고, 남은 2개는 사람 검토 경로로 들어온 것이었습니다. 같은 정리에서 메일 자동 추출로 생긴 장애 노드(그래프에서 장애 하나를 나타내는 항목)도 1,464개에서 1개로 줄었습니다.
되짚어 보니 원인은 다섯 가지였습니다.
정해 둔 범위를 넘었다 — 원칙은 메일에서 사람·조직 같은 연락 정보만 뽑는 것이었는데 코드가 장애와 관계까지 만들었다
LLM 의 판단을 검토 없이 그대로 저장했다
이름을 소문자로 맞추는 과정에서 중복 노드가 생겼다
사람 검토 경로를 새로 붙이면서 옛 자동 생성 경로를 남겨 뒀다
출처 정보를 기록하지 않았다
정리한 뒤에는 원래 원칙으로 되돌렸습니다. 메일에서는 사람·조직 정보만 뽑고, 장애와 시스템 사이의 관계는 메일 본문에서 뽑지 않습니다.
메일 본문에서 자유롭게 뽑은 항목이 그래프를 어떻게 오염시켰고 어떤 검토 단계를 뒀는지는 앞선 글에 적었습니다.
담당자는 지금은 사람이 확정합니다
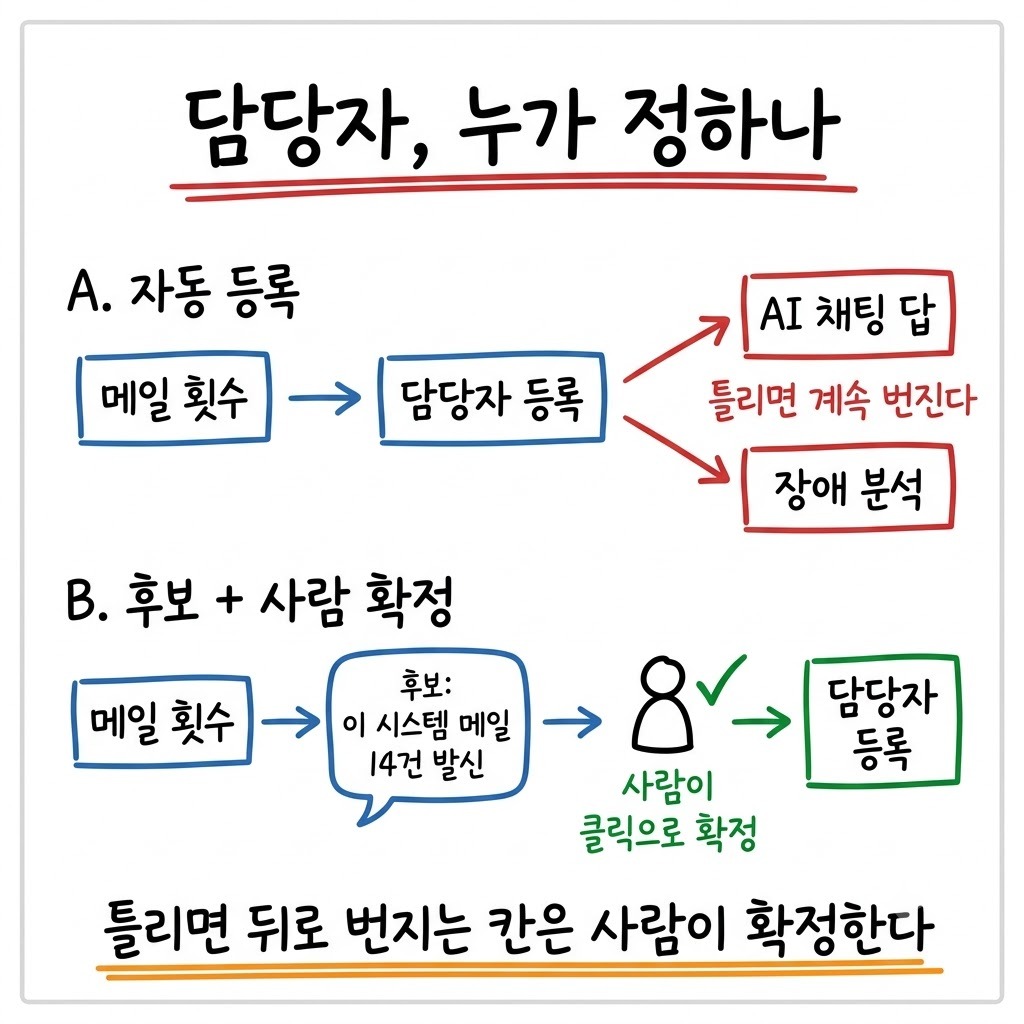
장애 관계와 별개로, 담당 관계는 0건이었습니다. 시스템마다 누가 맡는지가 그래프에 하나도 없었습니다. 선택지는 둘이었습니다.
방식 | 어떻게 | 판단 |
|---|---|---|
A. 자동 등록 | 메일을 많이 주고받은 사람을 담당자로 바로 등록 | 정확도 절반 수준으로 예상(잰 값 아님) |
B. 후보 표시 + 사람 확정 | 메일 횟수를 참고 정보로 보여 주고 사람이 화면에서 클릭으로 확정 | 후보를 보고 클릭 한 번으로 확정 |
B 를 골랐습니다. 담당자는 한 번 틀리면 그 한 번으로 끝나지 않습니다. 잘못 들어간 담당자는 AI 채팅의 답과 장애 분석에 계속 섞여 들어갑니다.
그래서 지금은 메일 언급 횟수를 후보로 보여 주고 사람이 화면에서 확정합니다. 후보 옆에는 '이 시스템 메일 14건 발신' 같은 참고 정보가 붙습니다. 숫자는 판단을 돕는 정보이고, 등록은 사람의 클릭으로 합니다. 담당자 자동 연결은 앞으로 개발할 항목으로 남겨 두었습니다.
장애가 뜨면 과거 사례부터 꺼냅니다
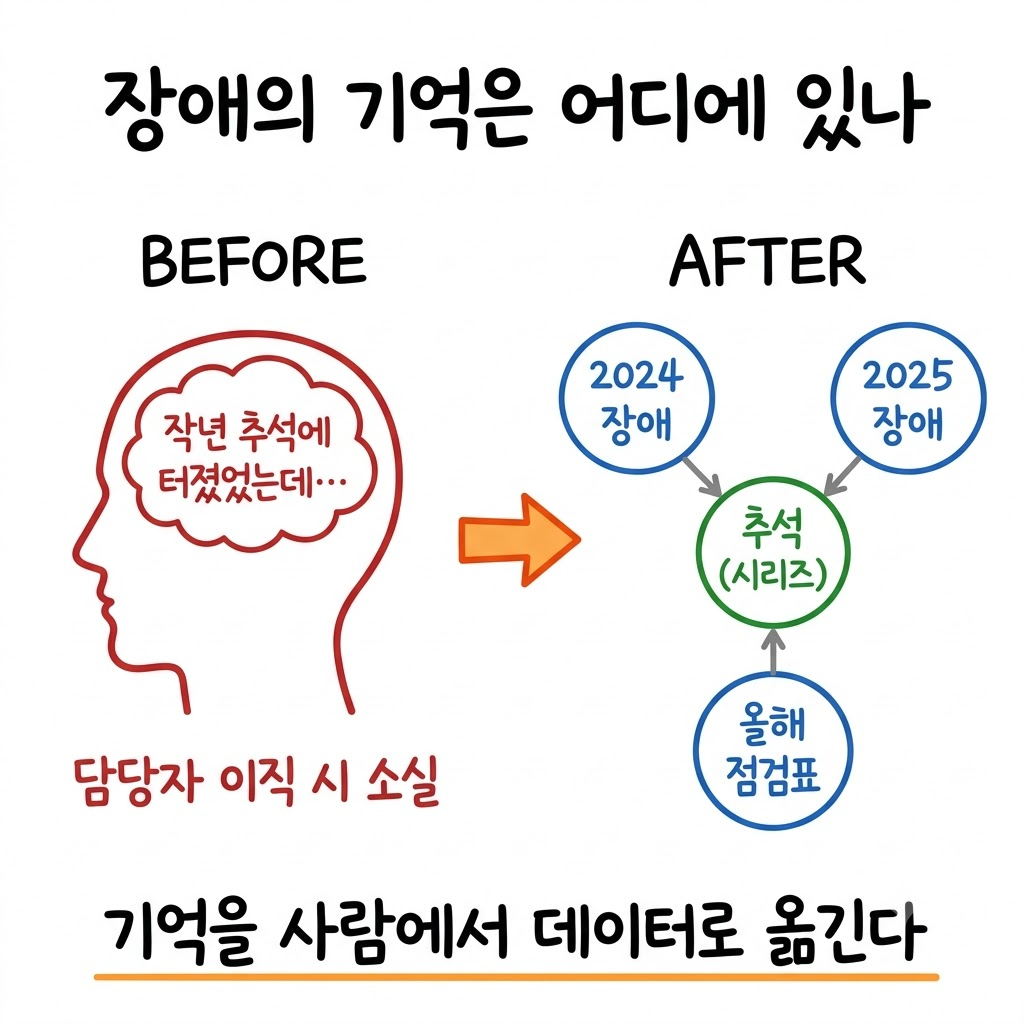
장애가 뜨면 비슷한 과거 사례를 찾아 그때의 조치와 함께 보여 줍니다. 이 찾기 단계에는 LLM 을 쓰지 않습니다. 같은 패턴, 같은 유형·시스템, 비슷한 글 순서로 SQL 중심으로 찾습니다.
심각도가 높은 알람은 AI 가 사례 초안까지 써 둡니다. 초안은 틀려도 사람이 읽고 고치면 거기서 끝나는 칸이라 AI 에게 맡겼습니다. 반대로 AI 가 인프라를 직접 손대는 자동 조치는 범위에서 뺐습니다.
사례 기록은 지금 431건이고, 그중 102건이 사람 확인을 거쳤습니다. 같은 유형의 장애를 두 번째 겪을 때 처음부터 다시 시작하지 않도록 쌓아 두는 자리를 먼저 만들었습니다.
지난 장애를 출처와 함께 다음 대비에 다시 꺼내 쓰는 구조는 따로 정리해 두었습니다.
AI 를 어디서 멈춰 세울지 정하는 기준
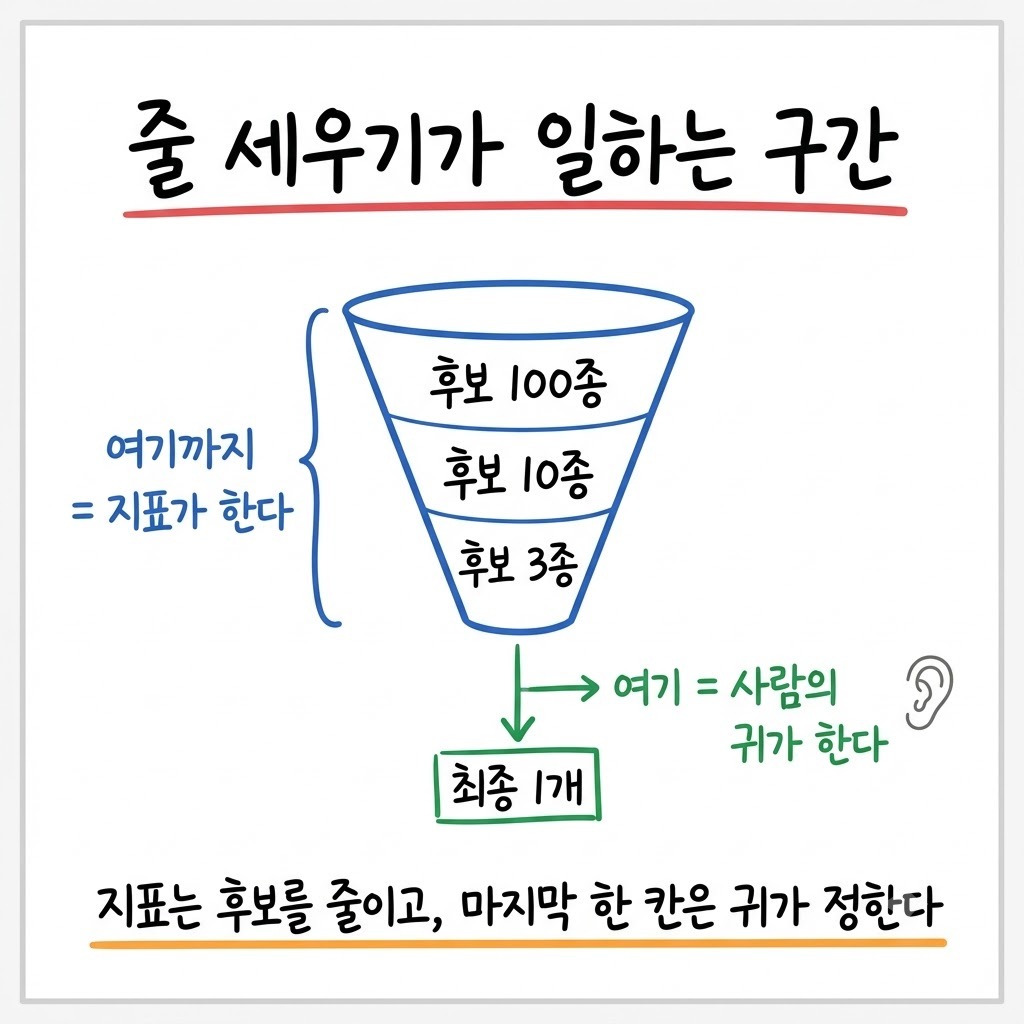
돌아보면 기준은 하나였습니다. 틀렸을 때 그 한 번으로 끝나는 칸인지, 뒤로 번지는 칸인지입니다. 요약과 초안은 틀려도 읽는 사람이 고치면 끝납니다. 담당자·권한·기준값은 한 번 잘못 들어가면 그 값을 참조하는 답이 전부 같이 틀립니다. 그런 칸은 AI 가 후보를 내고 사람이 확정하게 했습니다.
AI 가 낸 값을 후보로만 쓰고 마지막 칸을 사람에게 남기는 판단은 다른 사례에서도 같았습니다.
AI 를 업무에 넣기 전에 아래를 먼저 확인해 보시길 권합니다.
AI 가 만든 데이터마다 어디서 왔는지(출처)를 같이 저장하는가
틀리면 뒤로 번지는 칸(담당자·권한·기준값)을 따로 구분해 두었는가
그 칸에 AI 는 후보만 내고 사람이 확정하는 화면이 있는가
사람 검토 경로를 붙일 때 옛 자동 생성 경로를 껐는가
표본으로 검증했다면 표본 크기를 결론에 같이 적는가
마무리
처리 시간이 얼마나 줄었는지, 답이 얼마나 정확해졌는지 같은 숫자는 아직 없습니다. 그걸 재기 위한 평가셋을 만드는 중입니다. 담당자가 몇 명 안 되는 작은 조직이라면 자동 추론이 틀려도 금방 고칠 수 있어 이 판단의 무게가 덜합니다.
다만 조치 절차가 문서로 없는 조직이라면 똑똑한 답보다 지식이 쌓이는 자리가 먼저입니다. 그리고 AI 가 만든 데이터에 출처를 남기지 않으면, 틀린 것이 섞였을 때 골라낼 수 없어 전부 버려야 합니다. 922개를 지우면서 확인한 사실입니다.