헬스체크 무응답에 launchd 감시가 엔진을 재시작했는데, 그 엔진은 아직 일하고 있었습니다
9월 중순, 사내 문서 지식그래프 검색 도구의 문서 엔진이 사람이 손으로 복구할 때까지 내려가 있었습니다. 이 엔진은 색인·카드 생성·OCR·임베딩을 맡고, 별도 장비 한 대에서 돌아갑니다.
그 장비에는 macOS 의 스케줄러인 launchd 가 주기적으로 띄우는 감시 스크립트가 있습니다. 헬스체크가 두 번 연속 실패하면 엔진을 '내려감'으로 보고, 기동 스크립트를 불러 되살리는 구조입니다.
그날은 고객사가 맡긴 지난 3년치 문서를 한꺼번에 색인하는 백필 작업 중이었습니다. 감시 스크립트는 엔진이 멈췄다고 판정하고 종료시켰습니다. 그런데 엔진은 멈춘 게 아니라 바빴습니다. 되살린 새 엔진은 33초 뒤 OS 가 다시 종료시켰습니다.
더 불편한 사실도 나왔습니다. 이 감시 스크립트의 되살리기는 기록상 한 번도 성공한 적이 없었습니다. 9월 8일에도 실패해 사람이 복구했습니다.
초 단위로 다시 세운 그날
백필 13분째, 엔진에는 부하가 겹쳐 있었습니다. pptx 변환이 78초씩 기다리는 작업이 여럿이었고, 30쪽짜리 도면 OCR 이 돌았고, 임베딩 API 는 429(요청 한도 초과)로 재시도 중이었습니다. 장비의 load 는 10.7 이었습니다.
시각 | 일어난 일 |
|---|---|
12:40:24 | 헬스체크 5초 타임아웃 2회 연속 → '내려감' 판정 → 재시작 스크립트가 엔진 포트를 쥔 프로세스를 kill |
12:40:33 · 12:40:48 | 판정 뒤인데도 옛 엔진이 카드·색인을 기록 |
12:40:51 | 감시 스크립트가 새 엔진을 기동 |
12:41:23 | 감시 잡 종료. 로그에 '되살리기 끝 rc=0' |
12:41:24 | 새 엔진이 'Shutting down' 을 찍고 정상 종료 |
12:54:18 | 사람이 ssh 로 재시작 스크립트를 돌려 복구 |
판정 9초 뒤와 24초 뒤에도 옛 엔진은 일을 하고 있었습니다. 로그로 확인한 사실입니다. 그 엔진이 종료되면서 진행 중이던 잡을 잃었고, 엔진에 폴더를 넘기던 스캐너도 ConnectionError 로 같이 멈췄습니다.
되살리기 로그는 rc=0, 성공으로 끝났습니다. 그런데 1초 뒤 새 엔진이 종료됐고, 그때부터 13분 가까이 엔진이 없었습니다.
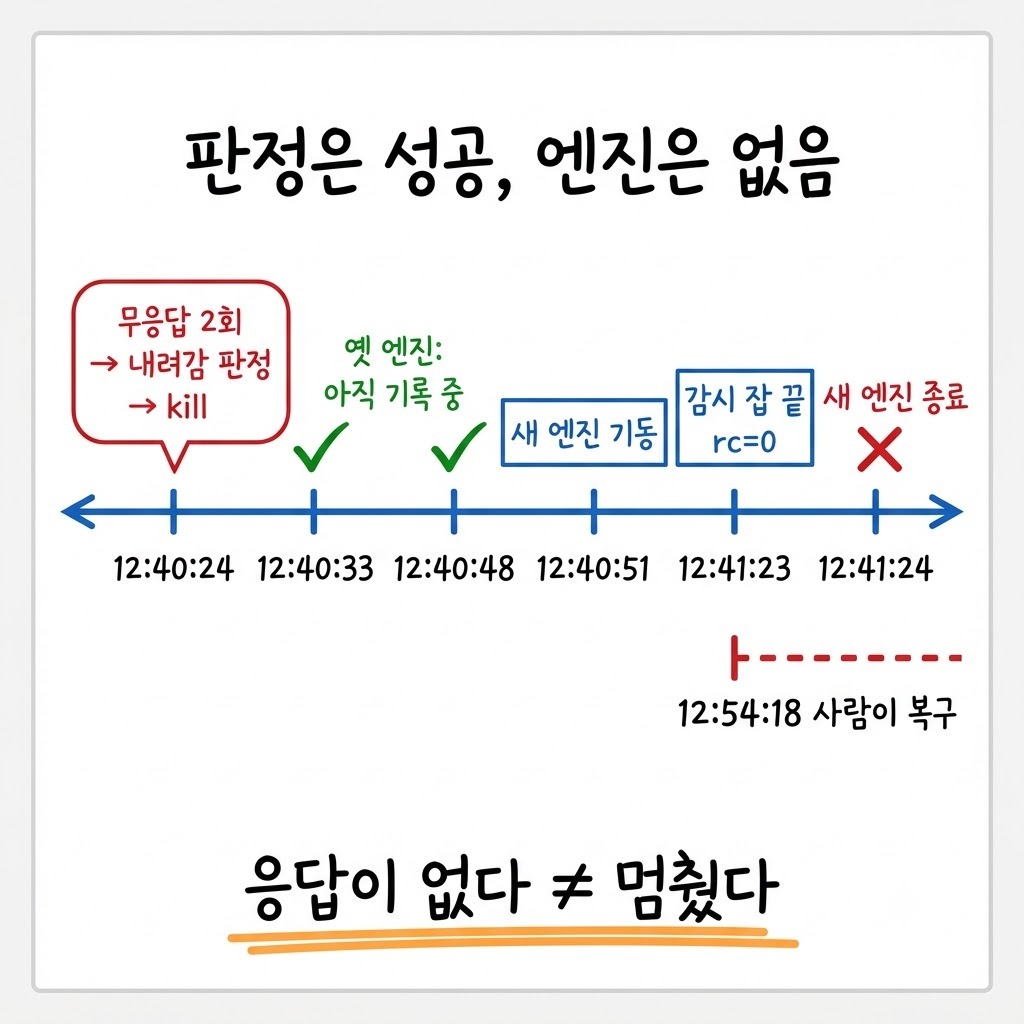
확정한 원인 하나 — 응답 없음을 멈춤으로 읽었다
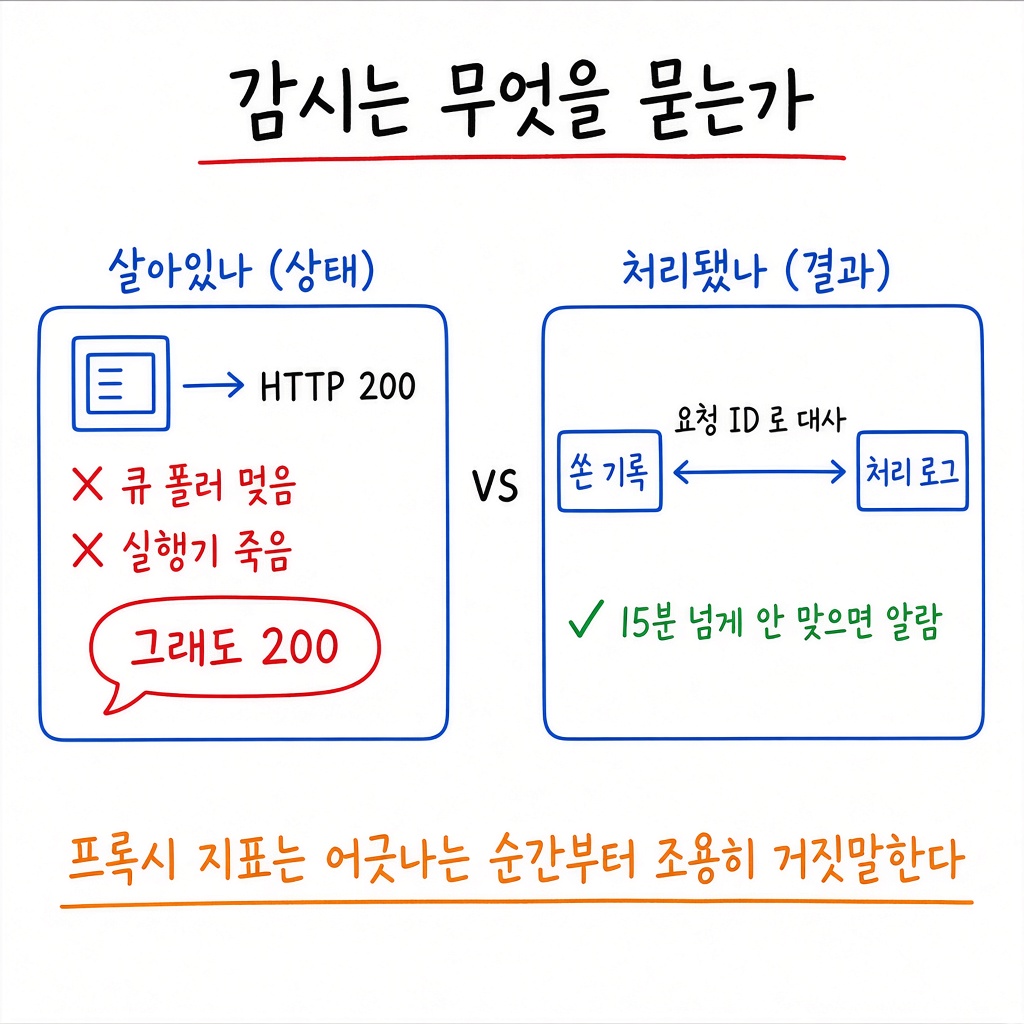
헬스체크 핸들러는 동기 함수였습니다. 그리고 응답에 벡터 저장소(Qdrant)의 exact count, 즉 저장된 벡터 수를 정확히 센 값을 실어 보내고 있었습니다. '살아 있나'라는 질문에 '몇 건 들어 있나'가 얹혀 있었던 셈입니다.
감시 스크립트는 응답이 5초 안에 안 오면 실패로 셌습니다. 두 번 실패하면 엔진이 멈췄다고 보고 종료시켰습니다. '응답이 없다'는 관측이고 '멈췄다'는 결론입니다. 그 사이에 '살아서 일하고 있나'를 확인하는 단계가 통째로 빠져 있었습니다.
사흘 전 같은 제품의 배포 관문에서도 같은 일이 반대 방향으로 있었습니다. 그때는 옛 프로세스가 준 정상 응답을 보고 새 프로세스가 떴다고 통과시켰습니다. 이번에는 응답이 없다는 것만 보고 멈췄다고 판정했습니다. 둘 다 응답이 있느냐 없느냐로 프로세스의 정체를 대신했습니다.
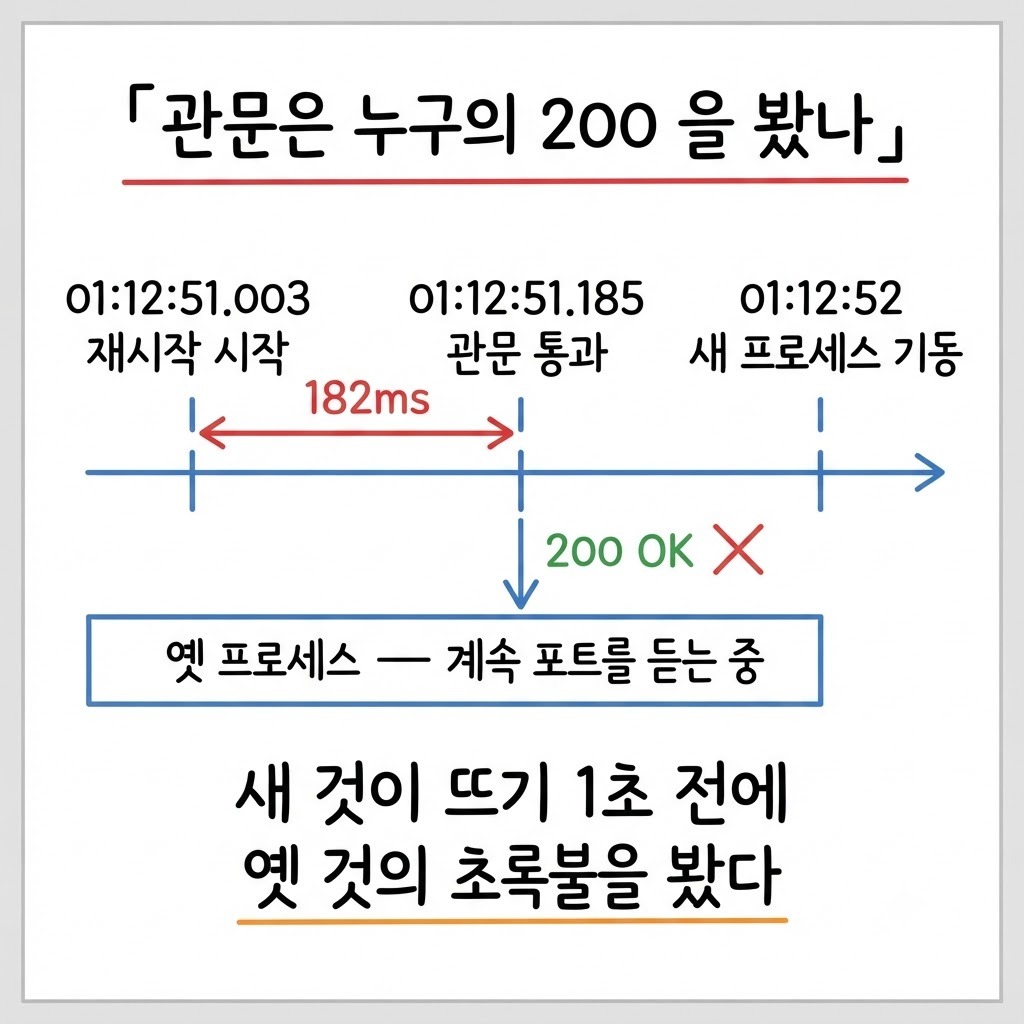
확정한 원인 둘 — launchd 가 잡과 함께 새 엔진을 정리했다
새 엔진이 1초 만에 종료된 이유는 launchd 의 동작에 있었습니다. launchd 는 자기가 띄운 잡이 끝나면, 그 잡과 같은 프로세스 그룹에 남아 있는 프로세스에 TERM 신호를 보내 정리합니다. 이걸 막는 키가 plist 의 'AbandonProcessGroup' 입니다. true 로 두면 남은 프로세스를 건드리지 않습니다.
감시 잡의 plist 에는 이 키가 없었습니다. 되살린 엔진은 기동 스크립트가 nohup 으로 띄운 자식이라 감시 잡과 같은 프로세스 그룹에 있었습니다. nohup 은 HUP 신호만 막고 TERM 은 그대로 받습니다. 그래서 12:41:23 에 감시 잡이 끝나자 1초 뒤 새 엔진이 'Shutting down' 을 찍었습니다.
이 키가 없는 한 되살리기는 구조상 성공할 수 없었습니다. 감지는 매번 됐고 복구는 한 번도 되지 않았습니다.
<!-- 2026-09 실측: 이 키가 없을 때 감시 잡 종료 1초 뒤(12:41:24) 되살린 엔진이 TERM 으로 종료됨 -->
<key>AbandonProcessGroup</key>
<true/>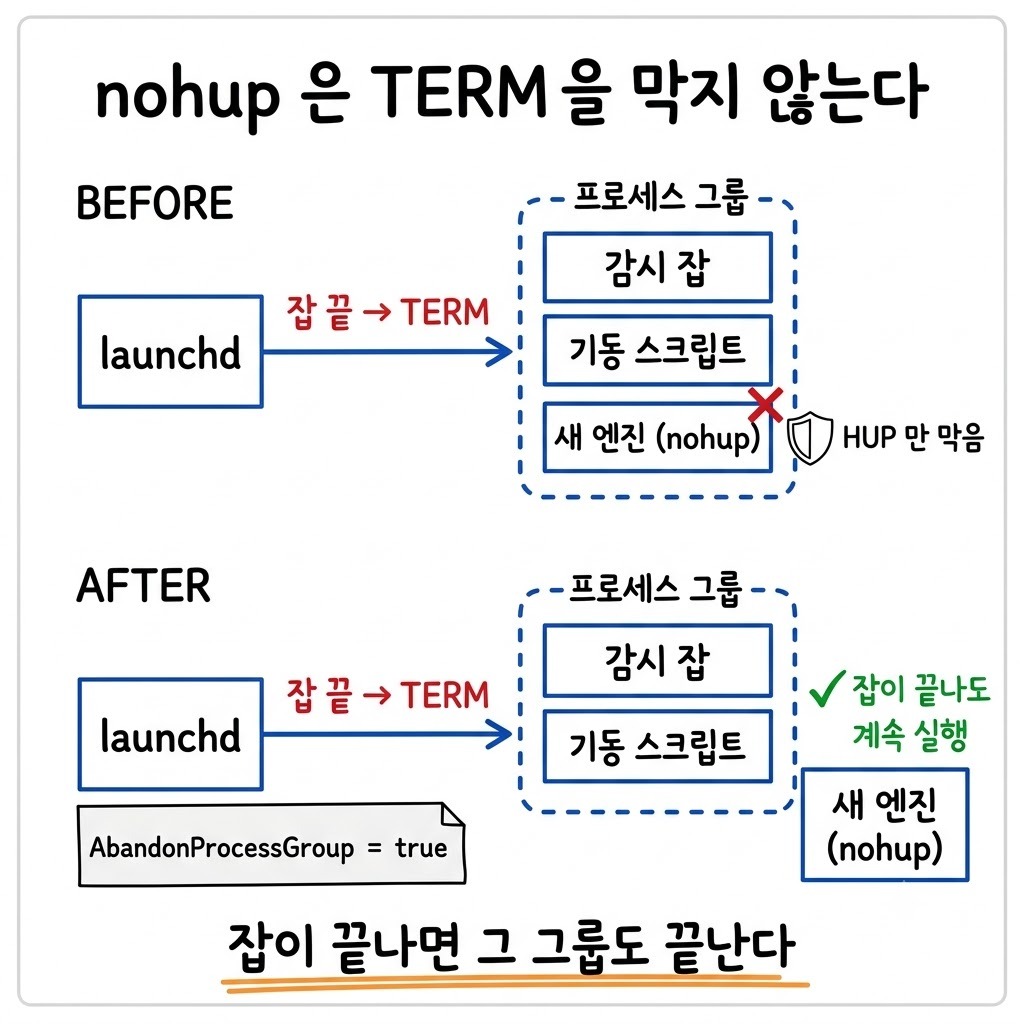
확정하지 못한 것 — 5초는 어디서 왔나
고친 뒤 백필을 다시 돌렸습니다. load 14~20 에서 헬스체크는 200 을 1ms 로 다섯 번 돌려줬습니다. 같은 부하에서 옛 count 를 직접 재 보니 31ms 였습니다(첫 호출은 482ms). count 자체가 5초를 쓴 건 아니었습니다.
동기 핸들러를 돌리는 스레드가 GIL(파이썬이 한 번에 한 스레드만 코드를 실행하게 하는 잠금)과 CPU 를 받지 못해 응답이 늦었다고 추정합니다. 다만 옛 프로세스에는 요청마다 걸린 시간을 남기는 로그가 없었습니다. 재현할 근거가 없으니 확정하지 않고 남겨 둡니다.
그래서 'count 를 빼서 고쳤다'고 쓰지 않습니다. 'count 를 뺐고, 그 뒤로 1ms 다'까지가 확인한 사실입니다. count 를 뺀 것이 원인을 없앤 건지 증상만 가린 건지는 아직 모릅니다. 다시 생기면 요청 시간 로그부터 붙일 생각입니다.
같은 날 고친 것 넷
12:58 에 고치기 시작해 14:44 에 배포했습니다. 테스트는 옛 코드에 대고 먼저 돌려 실패하는지를 확인했습니다.
헬스체크를 비동기 핸들러로 바꾸고 응답은 {"ok": true} 하나만 남겼습니다. count 값을 읽는 곳을 세어 보니 하나도 없었습니다. 배포 스크립트는 ok 만 grep 했고, 감시 스크립트는 상태 코드만 봤고, 재시작 스크립트는 화면에 찍기만 했습니다.
감시 잡 plist 에 AbandonProcessGroup=true 를 넣었습니다. 주석에는 12:41:24 에 새 엔진이 종료된 실측을 남겼습니다.
감시 스크립트에 '바쁨'이라는 세 번째 상태를 만들었습니다. 헬스체크가 응답하지 않아도 엔진 포트에 리스너 pid 가 있고 엔진 로그가 180초 안에 갱신됐으면 되살리지 않고 경고 알림만 주기적으로 보냅니다.
스캐너가 엔진 재시작을 견디게 했습니다. 잡 생성·상태 조회에서 연결 에러가 나면 5초 간격으로 180초까지 재시도합니다. 재시작으로 잡이 사라져 404 가 오면 그 묶음만 실패로 적고 다음 폴더로 넘어갑니다.
테스트는 814개가 통과했습니다. 세 번째의 판정은 테스트가 실제 bash 로 세 갈래를 돌려 확인합니다.
헬스체크 무응답일 때 | 판정 |
|---|---|
리스너 pid 있음 + 로그가 180초 안에 갱신 | 바쁨 — 되살리지 않고 알림만 |
리스너 pid 있음 + 로그 마지막 갱신이 10분 전 | 멈춤 — 되살림 |
리스너 pid 없음 | 멈춤 — 되살림 |
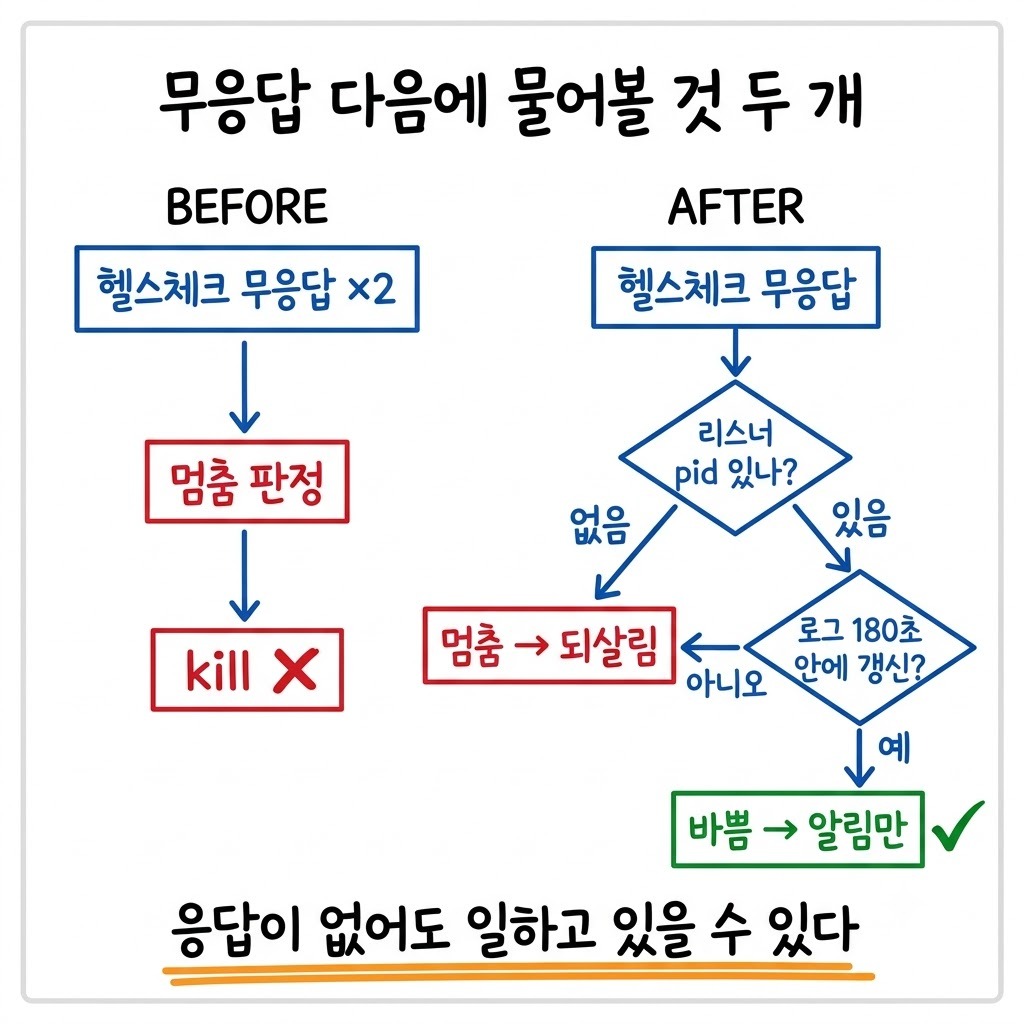
헬스체크를 이렇게 가볍게 두면 반대 방향의 위험이 생깁니다. 프로세스는 살아 있는데 일이 멈춘 상황은 헬스체크로는 안 보입니다. 그건 헬스체크가 아닌 다른 감시가 맡아야 합니다.
아직 남은 약점
'바쁨' 판정에는 반대쪽 오판 위험이 있습니다. 데드락으로 굳었는데 다른 스레드가 로그를 찍고 있으면 바쁨으로 보여 종료시키지 않습니다.
180초는 이번 백필의 잡 크기에서 정한 값입니다. 바쁨이 오래 이어지면 그때는 종료시킨다는 상한도 아직 없습니다. 낮이라 사람이 곧 봤지만 새벽이면 몇 시간이 될 수 있습니다.
되살리기가 이제 성공한다는 건 구조로 따진 추론입니다. 고친 뒤 실제 되살리기가 일어난 기록은 그날에는 없습니다.
단일 장비·단일 프로세스라 한 번 종료시키면 곧바로 서비스가 내려갑니다. 그래서 오판의 대가가 컸습니다.
감시를 붙여 둔 곳이라면 확인할 것
무응답을 곧바로 멈춤으로 판정하지 않는가. 리스너 pid·로그 갱신 시각처럼 응답 없이도 보이는 신호를 같이 보는가
헬스체크에 저장소 조회 같은 무거운 값이 얹혀 있지 않은가. 그 값을 읽는 곳이 실제로 있는가
자동 복구가 성공한 기록을 사고 전에 세어 봤는가
launchd·CI 러너·cron 이 띄운 잡의 자식이 잡과 함께 정리되지 않는가
감지는 되는데 복구는 한 번도 안 되는 감시자는 감시자가 없는 것보다 나쁩니다. 살아 있는 프로세스를 종료시키고 빈자리만 남기기 때문입니다. 되살리기 로그를 미리 세어 봤다면 사고 전에 알 수 있었을 겁니다.