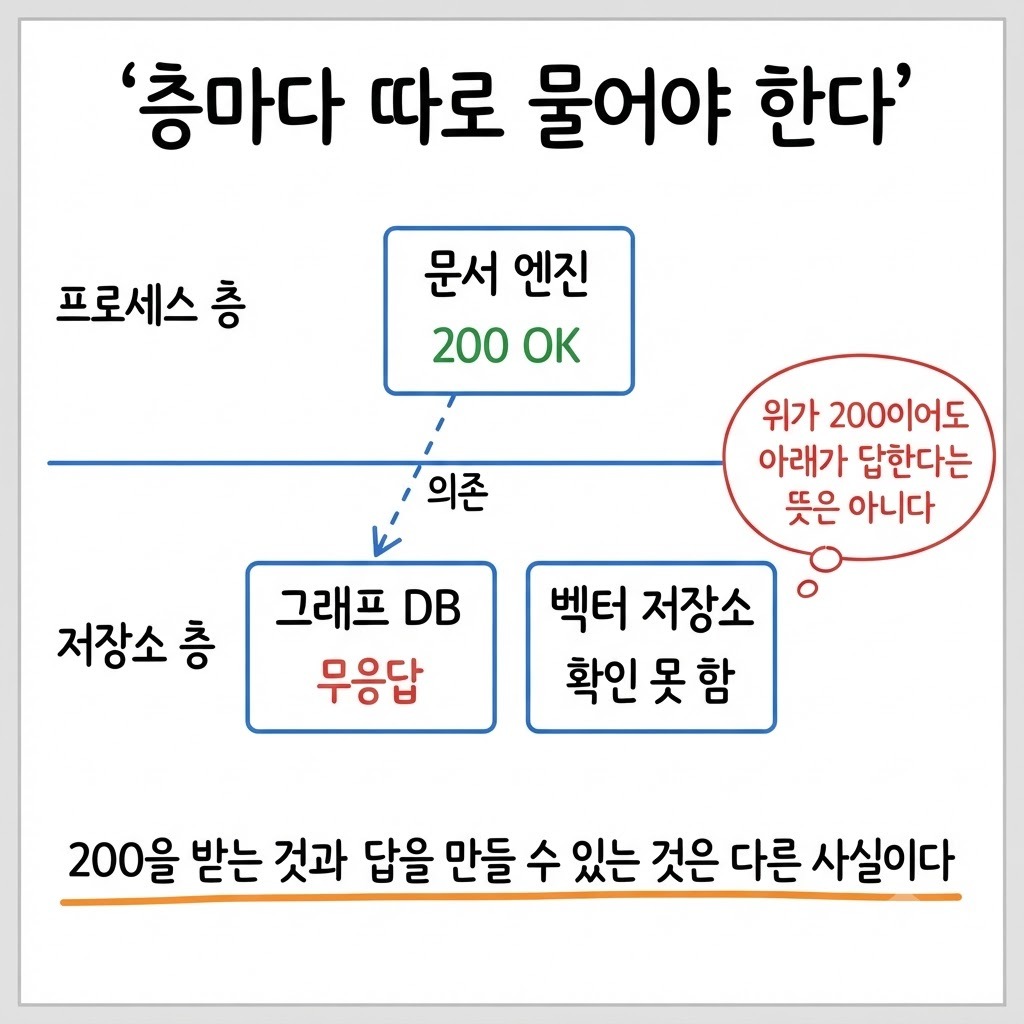
헬스체크는 200이었는데 그래프 DB가 답을 안 했습니다
오전에 사용자 신고가 하나 들어왔습니다. '등록된 문서 확인하기를 누르면 문서를 불러오는 중이라는 문구만 계속 뜬다'는 내용이었습니다. 사내 문서 지식그래프 검색 도구의 화면이고, 그 화면이 부르는 목록 호출은 평소 1초 안에 끝나는 요청입니다.
그 시각 감시 쪽은 아무 말도 하지 않았습니다. 문서 엔진의 헬스체크는 내내 200을 돌려주고 있었습니다. 장애를 사람이 먼저 알아챘고 기계는 끝까지 몰랐습니다.
한 층씩 내려간 40분
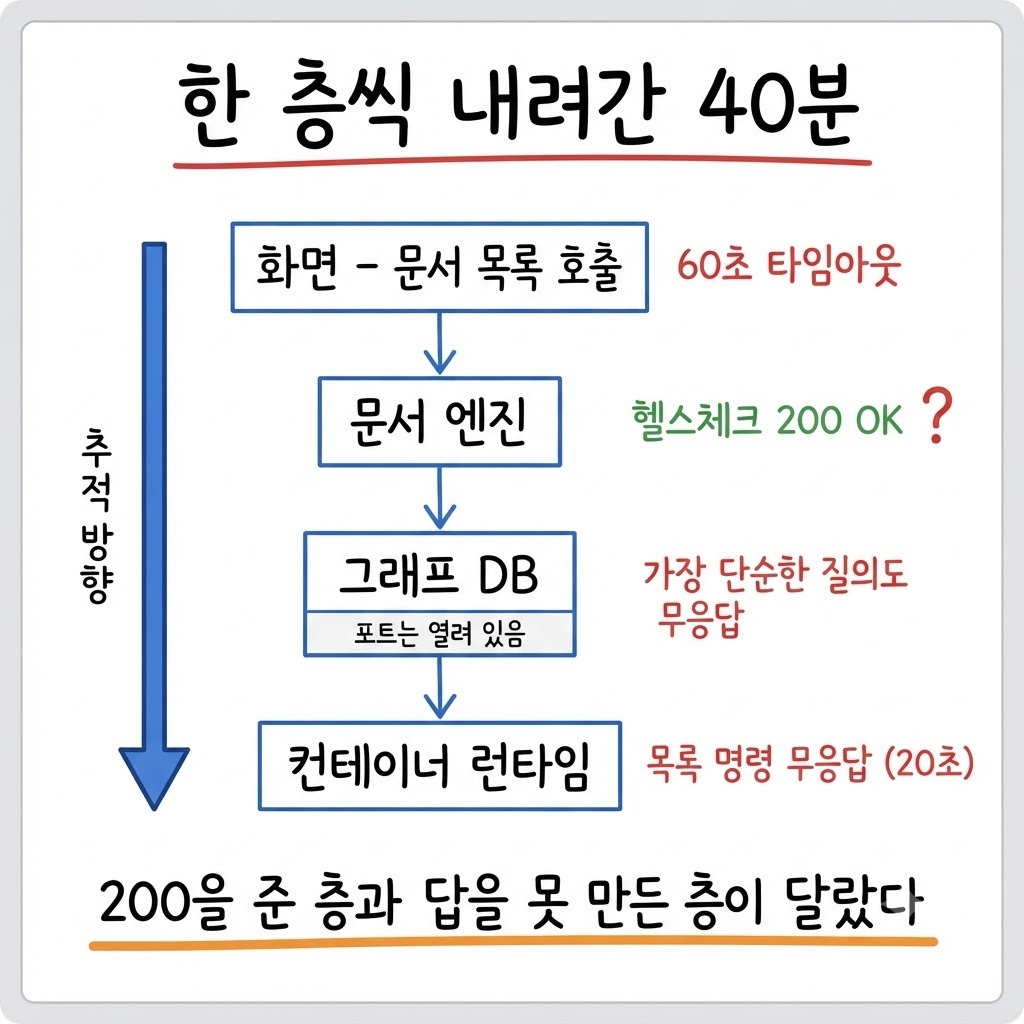
추적은 위에서부터 한 층씩 내려가는 순서로 진행했습니다. 화면 → 엔진 → 저장소 → 컨테이너 런타임 순입니다. 각 층에서 확인한 것은 이렇습니다.
화면이 부르는 문서 목록 호출이 60초 읽기 타임아웃으로 끊겼습니다. 엔진에 직접 같은 요청을 보내도 60초 뒤 500이 돌아왔습니다.
그래프 DB에 가장 단순한 질의를 던졌습니다. 문서 노드 개수를 세는 한 줄인데 그것도 안 돌아왔습니다. 엔진이 아니라 그래프가 답을 안 하고 있었습니다.
그래프의 bolt 포트와 HTTP 포트는 둘 다 열려 있었습니다. 겉으로는 살아 있는 프로세스로 보였습니다.
컨테이너 목록을 부르는 명령이 응답하지 않았습니다. 20초 알람에 걸려 끊었습니다.
엔진 로그에 `No space left on device` 가 남아 있었습니다. 상태 파일을 쓰는 자리에서 난 오류입니다.
마지막 줄이 실마리였습니다. 그날 아침에 같은 장비의 남은 디스크가 135MB 에서 0 바이트까지 내려간 구간이 있었습니다. 원인을 찾아 비웠고 그것으로 끝난 줄 알았습니다.
컨테이너는 데스크톱형 런타임이 들고 있었습니다. 디스크가 0이던 구간에 그 백엔드가 이상 상태로 들어가 컨테이너 목록조차 돌려주지 못했고, 그 안의 그래프 DB가 질의를 처리하지 못했습니다. 정리하면 디스크를 비운 뒤에도 데몬과 그래프 DB가 스스로 돌아오지 않은 것입니다.
복구는 강제 종료 후 재기동으로 끝났습니다. 정상 종료 요청이 처리되지 않아 강제로 내렸고, 올리자 5초 만에 컨테이너 목록이 돌아왔습니다. 세 컨테이너가 restart 정책으로 자동 재기동됐습니다.
복구 뒤 실측 | 결과 |
|---|---|
그래프 문서 노드 세기 | 9,073건 · 1.1초(기동 직후) |
폴더 하나의 등록 문서 목록 | 0.64초 |
벡터 저장소 | 403,348 포인트 · 0.4초 |
아까 60초 뒤 500이던 문서 목록 호출 | 200 · 0.02초 |
그래프 로그 최근 5분 | error·corrupt·recover 없음 |
이틀 전에 우리가 직접 눈을 가렸습니다
엔진 헬스체크가 200을 준 이유는 알고 있었습니다. 이틀 전에 제가 그렇게 고쳤기 때문입니다.
그때는 정반대 방향의 사고였습니다. 백필 작업으로 엔진이 바쁠 때 헬스체크 응답이 늦어졌고, 감시 스크립트가 그 지연을 죽음으로 판정해 멀쩡히 일하고 있던 엔진을 강제로 내렸습니다. 재발을 막으려고 헬스체크에서 벡터 저장소 개수 세기를 빼고 '살아 있나'만 답하게 바꿨습니다. 저장소를 안 보는 헬스체크가 된 것입니다.
그 결정은 오탐을 막는 데는 맞게 작동했습니다. 그리고 이틀 뒤에는 저장소가 멈춘 것을 못 보게 만들었습니다. 같은 결정이 방향에 따라 반대로 작동했습니다.
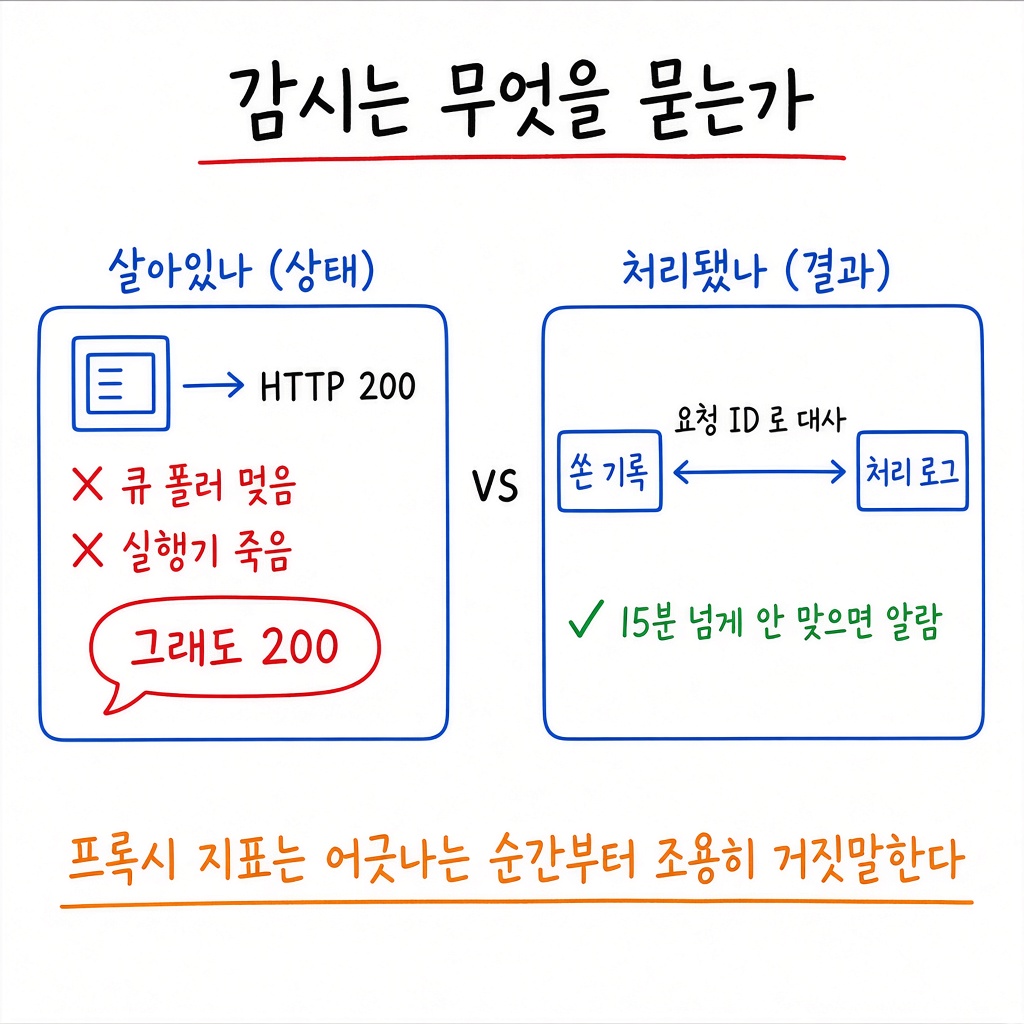
덧붙이면 포트가 열려 있는 것은 가장 싸고 가장 자주 거짓말하는 신호입니다. 리스너는 프로세스가 붙잡고만 있어도 남습니다. '연결이 된다'는 '처리가 된다'와 다른 사실이고, 이번에는 그 간격이 40분이었습니다.
헬스체크가 무엇을 안 묻는지는 다른 사고에서도 같은 모양으로 나왔습니다. 그쪽은 17시간 30분 동안 멈춰 있었는데 알람이 한 건도 안 울린 경우입니다.
한 값으로는 두 사고를 같이 못 막습니다
이 글의 본체는 복구 절차가 아니라 헬스체크를 얼마나 깊게 볼 것인가입니다. 같은 축에서 이틀 사이에 반대 방향으로 두 번 틀렸습니다. 두 사고를 한 표에 놓으면 이렇게 됩니다.
상황 | 헬스체크가 가벼울 때 | 헬스체크가 깊을 때 |
|---|---|---|
프로세스가 바쁠 때 | 통과 — 오탐 없음 | 응답이 늦어져 죽음으로 오판(이틀 전) |
의존 저장소가 멈췄을 때 | 200으로 통과 — 못 본다(이번) | 실패로 잡힌다 |
표의 두 줄을 같이 만족시키는 값이 없습니다. 깊이를 올리면 첫째 줄이 깨지고 내리면 둘째 줄이 깨집니다. 값 하나로 트레이드오프를 풀려고 하면 두 사고 사이를 왕복하게 됩니다.
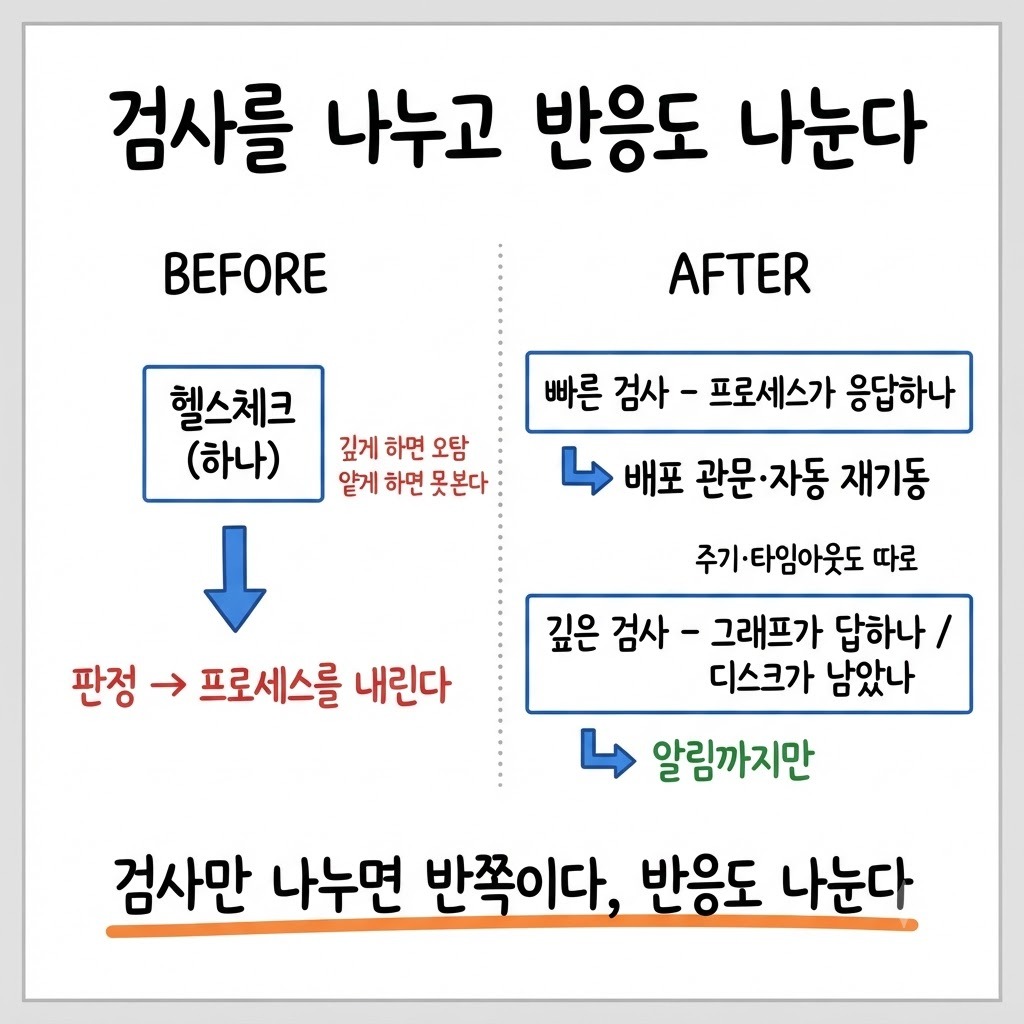
그래서 값을 조정하는 대신 검사를 하나 더 만드는 쪽으로 갔습니다. 헬스체크는 그대로 두고, 깊은 검사를 감시 항목으로 따로 세웠습니다. 헬스체크를 다시 깊게 되돌리는 선택지도 있었지만 그러면 이틀 전 사고가 그대로 돌아옵니다.
감시 항목에 무엇을 넣었나
정한 것은 네 가지입니다.
헬스체크는 되돌리지 않습니다. 배포 관문과 감시자가 쓰는 빠른 신호는 '프로세스가 응답하나'로 충분합니다.
감시에 '그래프가 답하나'를 넣습니다. '무엇이든 응답하나'가 아니라 저장소 질의 하나를 실제로 던져 봅니다.
디스크 남은 공간도 같이 넣습니다. 이번 사고의 뿌리가 그것이고, 같은 사고의 다른 얼굴입니다.
깊은 검사의 판정은 프로세스를 내리는 동작으로 잇지 않습니다. 알림까지만입니다.
마지막 항목이 이틀 전에 배운 것입니다. '그래프가 답하나'도 멈춘 것과 바쁜 것을 구분하지 못합니다. 구분하려면 로그 갱신 시각이나 리스너 pid 같은 다른 신호가 더 필요하고, 그걸 갖추기 전까지는 사람에게 알리는 선에서 멈추는 쪽이 안전합니다.
저장소 질의를 감시에 넣으면 그 질의 자체가 부하가 된다는 점도 감수하는 부분입니다. 그래서 깊은 검사의 주기와 타임아웃은 빠른 검사와 따로 잡습니다. 부하가 큰 시스템에서는 이 감시가 다음 사고의 원인이 될 수 있습니다.
자원 고갈은 치워도 끝이 아닙니다
이번 사고에서 가장 값싸게 배운 것은 이것입니다. '공간을 비웠다'와 '시스템이 돌아왔다'는 다른 사실입니다.
아침에 디스크를 비웠을 때 저는 상황이 종료됐다고 봤습니다. 실제로는 그 구간을 지나는 동안 떠 있던 데몬이 이상 상태로 들어갔고, 공간이 생겼다고 해서 스스로 빠져나오지 않았습니다. 디스크·메모리·파일 핸들이 바닥난 구간을 지난 뒤에는 그때 떠 있던 데몬과 DB가 정상으로 돌아왔는지를 따로 확인해야 합니다.
다만 인과를 재현하지는 못했습니다. 시점이 맞고 오류 로그가 남아 있을 뿐입니다. 재발하면 그 구간의 데몬 상태를 따로 찍어 두려고 합니다. 손상이 없다고 판단한 것도 로그 5분 창에서 본 것이지 정합성 검사를 돌린 결과가 아닙니다.
감시 항목을 정하기 전에 묻는 것
감시 항목을 하나 추가하기 전에 스스로 묻는 질문을 하나 만들었습니다. '이게 아니라면 무엇이 보일까'입니다.
이번 사고에서 그래프가 멈춰 있는 동안 헬스체크는 200이었습니다. 그래프가 살아 있어도 200이고 멈춰 있어도 200이면, 그 검사는 통과해도 아무것도 증명하지 않습니다. 실패할 수 없는 검사를 감시 항목이라고 부르고 있으면 대시보드는 초록인데 서비스는 답을 못 하는 상태가 됩니다.
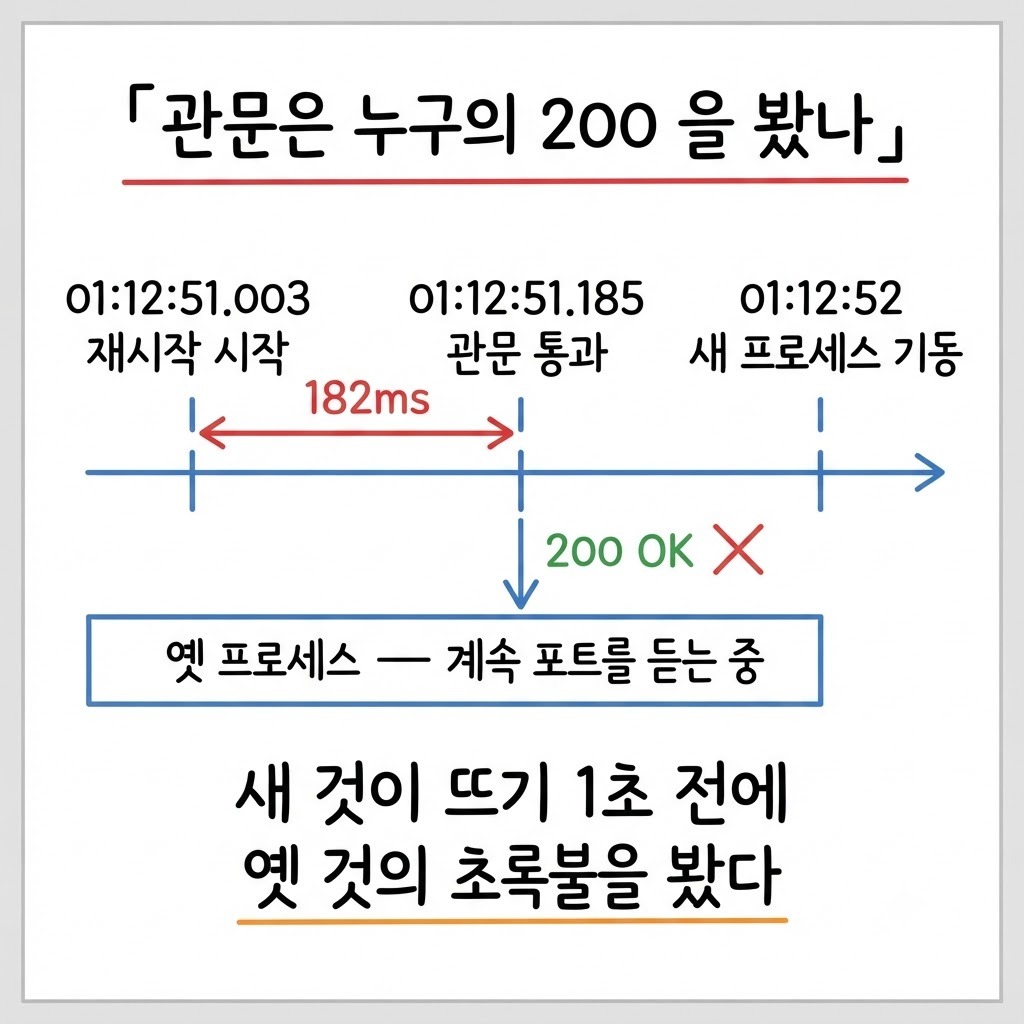
통과한 관문이 엉뚱한 대상을 보고 있던 경우도 같은 자리입니다. 그쪽은 배포 관문이 182ms 만에 통과했는데 옛 프로세스의 헬스체크를 본 것이었습니다.
도입 전에 볼 것
솔루션을 들이거나 감시를 설계할 때 먼저 확인할 항목으로 정리하면 이렇습니다.
빠른 검사와 깊은 검사가 갈라져 있는가. 하나뿐이면 오탐과 미탐 중 하나는 반드시 남습니다.
각 검사의 반응이 다른가. 내리는 판정과 알리는 판정을 같은 검사에 묶지 않습니다.
검사가 실패할 수 있는가. 대상이 멈춰도 통과하는 검사는 항목에서 뺍니다.
의존 저장소가 층으로 보이는가. 프로세스 층만 물으면 저장소 층 장애가 통째로 안 보입니다.
첫 감지가 사람인 사고가 최근에 있었는가. 있으면 복구 시간보다 그 사실을 먼저 기록합니다.
마무리
복구 자체는 강제 종료와 재기동으로 끝났고 저장소 손상 흔적도 없었습니다. 숫자만 보면 큰 사고가 아닙니다. 남은 것은 다른 쪽입니다. 첫 감지가 사용자 신고였다는 사실 하나가 결함 항목입니다.
사고 회고에 복구 시간을 적는 것은 익숙합니다. 거기에 한 줄을 더 적기로 했습니다. 기계가 몇 분 먼저 알 수 있었나입니다. 이번 건은 그 답이 '알 수 없었다'였고, 그래서 헬스체크를 손대는 대신 감시 항목을 하나 늘렸습니다.
덧붙이면 이 이야기는 단일 장비에 인스턴스가 하나인 구성의 것입니다. 인스턴스가 여럿이면 하나가 무응답이어도 서비스는 살아 있어 계산이 달라집니다. 그 경우에는 '어느 하나가 답하나'가 아니라 '몇 개가 답하나'를 감시 항목으로 잡는 편이 맞습니다.