표준학교코드를 유니크키로 잡으려 했는데, 12,668건 중 107건이 겹쳤습니다
전국 학교 목록을 자체 테이블에 적재하려던 자리였습니다. 원천은 교육부 NEIS 교육정보 개방 포털의 '학교기본정보'였고, 학교마다 붙어 오는 코드의 이름이 '표준학교코드'였습니다. 전국 학교에 하나씩 붙는 표준 코드라면 그대로 유니크키로 쓰면 될 것처럼 보였습니다. '표준'이라는 이름이 그 판단을 거들었습니다.
스키마를 굳히기 전에 전량을 받아 세어 봤습니다. 12,668건을 코드별로 묶어 2건 이상인 그룹을 세는 스크립트 몇 줄이었고, 돌리는 데 2분이 걸렸습니다. 그 2분에 107 이라는 숫자가 튀어나왔습니다. 12,668건 중 107건이 같은 코드 값을 다른 행과 공유하고 있었습니다.
세는 방법 자체는 단순합니다. 받은 전량을 임시 테이블에 넣고 키 후보로 묶은 뒤 2건 이상인 그룹만 남깁니다. 파일로 받아 스크립트 안에서 묶어도 같습니다.
SELECT 표준학교코드, COUNT(*) AS n
FROM 전량_수신분
GROUP BY 표준학교코드
HAVING COUNT(*) > 1;
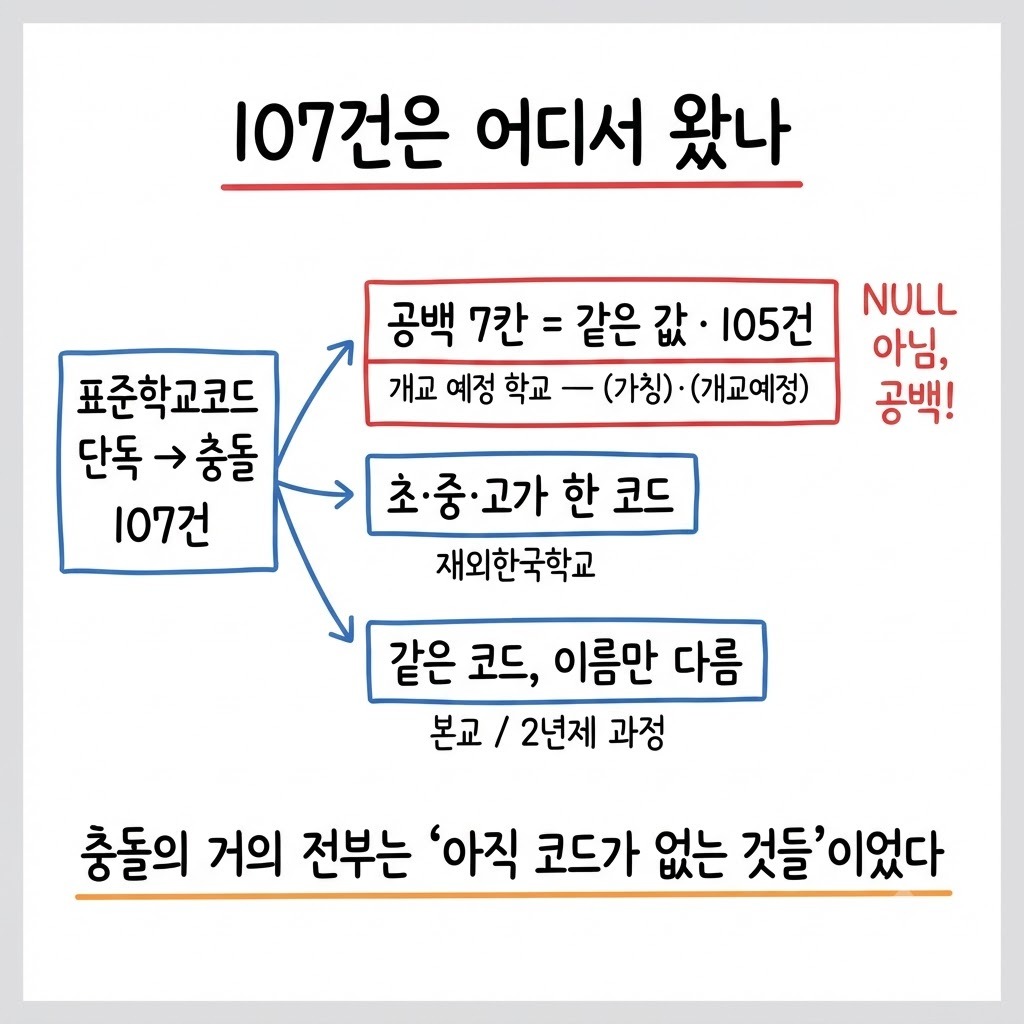
107건은 어디서 왔나
107건을 하나씩 열어 보니 원인이 셋이었습니다.
개교 예정 학교는 코드가 비어 있습니다. 105건이 공백 7칸이라는 같은 값을 공유하고 있었습니다. 이름에 '(가칭)'·'(개교예정)'·'(신설예정)'이 붙은 행들입니다.
재외한국학교는 초·중·고가 같은 코드를 씁니다. 한 재외한국학교의 초등·중등·고등 과정이 한 코드 아래 세 행으로 들어 있었습니다.
같은 코드에 학교명만 다른 경우가 있습니다. 본교와 2년제 과정이 같은 코드를 쓰고, 이름 뒤에 괄호 하나만 달랐습니다.
107건 중 105건이 1번입니다. '아직 코드가 없는 것들'이 한 값에 뭉친 것이 충돌의 거의 전부였고, 나머지 둘은 건수로는 얼마 안 됐습니다. 원천을 탓할 일은 아닙니다. 개교 전이라 코드가 없는 것도, 한 법인 아래 초·중·고가 한 코드를 쓰는 것도 그쪽 체계에서는 정상입니다. 같은 값이 내 테이블에 들어오면 유니크 위반이 될 뿐입니다.
특히 1번은 NULL 이 아니라 공백 문자열이었습니다. NULL 은 대개 유니크 검사에서 빠지지만 공백 7칸은 값입니다. 원천이 '없음'을 공백으로 표현하면, 내 쪽에서 NULL 로 바꿀지 적재에서 뺄지를 먼저 정해야 충돌이 안 납니다.
안 셌으면 어떻게 됐나
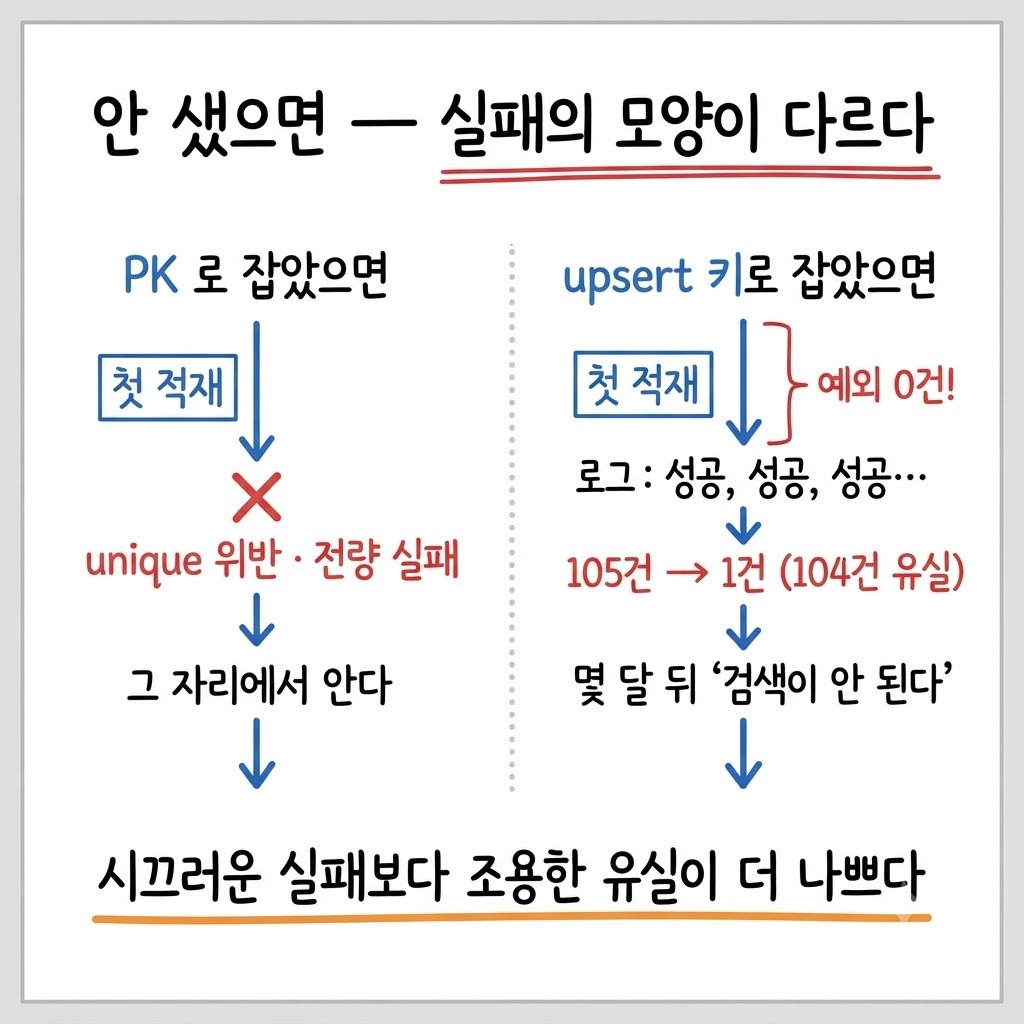
여기서 '안 셌으면'을 두 갈래로 따져 봤습니다. 같은 코드를 키로 쓰더라도, 그 키를 PK 로 걸었는지 upsert 키로 썼는지에 따라 실패의 모양이 다릅니다.
키를 건 자리 | 첫 적재에서 생기는 일 | 드러나는 시점 |
|---|---|---|
PK(유니크 제약) | unique 위반으로 전량 실패 | 그 자리에서 |
upsert 키 | 105건이 서로를 덮어써 1건만 남고 104건 유실 | 몇 달 뒤, 「개교 예정 학교가 검색이 안 된다」로 |
PK 로 잡았으면 첫 적재에서 시끄럽게 죽었을 겁니다. 그나마 낫습니다. 그 자리에서 알게 되니 고칠 시간이 있습니다.
upsert 키로 잡았으면 예외가 한 번도 안 났을 겁니다. upsert 는 같은 키의 행이 들어오면 앞 행을 갱신하는 동작이라, 공백 코드 105건이 차례로 서로를 덮어쓰고 마지막 1건만 남습니다. 로그에는 성공만 찍힙니다. '개교 예정 학교가 목록에 안 보인다'는 문의가 몇 달 뒤에 들어와야 드러나는 종류입니다.
조용한 쪽이 더 나쁩니다. 시끄러운 실패는 고치면 끝나지만, 조용한 유실은 유실이 있었다는 사실부터 다시 찾아야 합니다. 이 데이터를 쓰는 화면에서는 '원래 없는 학교'와 '사라진 학교'가 같은 모습이라, 그 차이를 구분할 단서도 없습니다.
키를 다시 골랐다
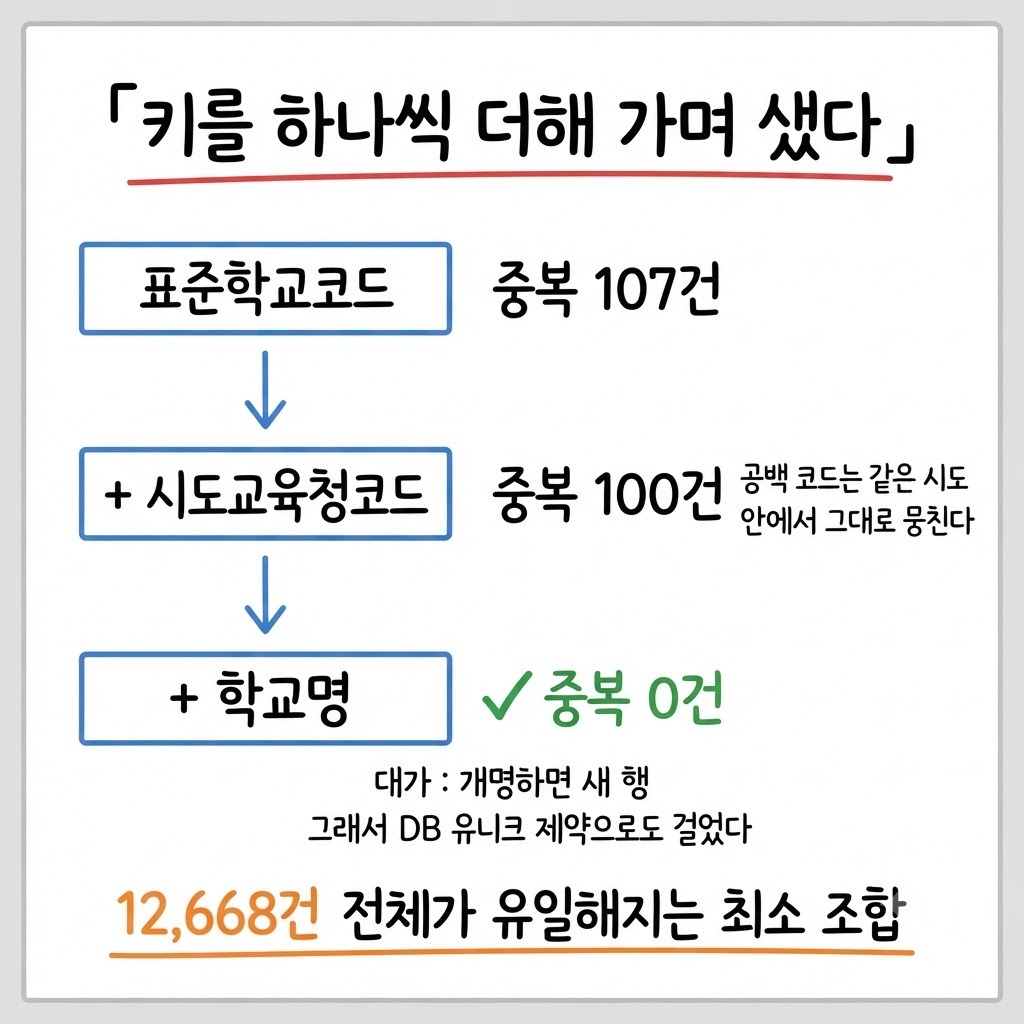
단독키가 안 되니 조합키 후보를 하나씩 더해 가며 다시 셌습니다.
키 조합 | 중복 |
|---|---|
표준학교코드 단독 | 107건 |
시도교육청코드 + 표준학교코드 | 100건 |
시도교육청코드 + 표준학교코드 + 학교명 | 0건 |
시도교육청코드를 붙여도 100건이 남았습니다. 공백 코드는 시도를 붙여도 같은 시도 안에서 그대로 뭉치기 때문입니다. 학교명까지 넣어야 0건이었습니다. 12,668건 전체가 유일해지는 최소 조합이 (시도교육청코드, 표준학교코드, 학교명)이었고, 이 셋을 유니크키로 잡았습니다.
학교명을 키에 넣은 대가가 있습니다. 학교가 개명하면 같은 학교가 새 행으로 들어오고 옛 행은 비활성이 됩니다. 조합에 들어간 값이 바뀌면 다른 행이 된다는 뜻입니다. '개명'과 '폐교 후 신설'이 구분되지 않는다는 뜻이기도 합니다. 이 용도에서는 개명을 새 행으로 봐도 됐습니다. 개명 이력을 추적해야 하는 시스템이라면 키 설계가 달라집니다.
빈 코드를 공유하는 105건은 적재 대상에서 빼는 쪽으로 봤습니다. 조합키 안에서는 학교명으로 갈리니 넣어도 깨지지는 않습니다. 다만 '아직 코드가 없는 것'은 이 테이블이 답해야 할 학교가 아니었습니다. 이것도 용도의 판단입니다. 입학 예정자 배정처럼 개교 예정교를 다뤄야 하는 시스템이면 정반대로 그 105건이 본문입니다.
세어 보고 끝내지도 않았습니다. 0건은 이 시점의 스냅샷입니다. 다음 수신에서 새 유형이 들어와 조합키가 깨질 수 있습니다. 그래서 같은 조합을 DB 유니크 제약으로 걸었습니다. 깨지면 조용히 덮어쓰는 것보다 시끄럽게 알려주는 쪽이 낫습니다.
이름이 아니라 데이터로 건다
이 건에서 남은 것을 정리합니다.
'표준'·'고유'·'ID'는 그 체계 안의 약속입니다. 원천에서 정상인 값이 내 테이블에서는 유니크 위반이 됩니다. 두 체계가 같은 값을 다르게 읽습니다.
유니크 제약은 문서가 아니라 데이터로 겁니다. 전량을 받아 키 후보로 묶어 2건 이상인 그룹을 세면 끝입니다. 그 2분을 건너뛴 제약은 '유일하길 바란다'를 DDL 로 적은 셈입니다.
빈 값·기본값을 공유하는 행이 가장 흔한 충돌 원인입니다. 107건 중 105건이 그랬습니다. 공백 문자열은 NULL 과 달리 값이라 유니크 검사에 걸립니다.
PK 와 upsert 키는 실패의 모양이 다릅니다. PK 는 첫 적재에서 시끄럽게 죽고, upsert 는 예외 없이 덮어써 조용히 줄어듭니다. 조용한 쪽이 더 나쁩니다.
자연키가 안 되면 조합키로 가되, 조합에 든 값이 바뀌면 다른 행이 된다는 것을 알고 갑니다. 그걸 감수할지는 용도가 정합니다.
세는 시점은 첫 적재 전입니다. 이 종류의 발견은 그때만 쌉니다. 세어 보는 스크립트가 곧 수집 로직의 리허설이라 버려지는 일도 아닙니다.
외부 데이터를 적재하기 전에 볼 것
원천 명세가 '고유'라고 적은 필드를, 전량을 받아 실제로 세어 봤는가
'없음'이 NULL 인지 공백 문자열인지 확인했는가. 공백은 값이라 유니크 검사에 걸린다
그 키를 PK 로 걸 것인지 upsert 키로 쓸 것인지, 각각 깨질 때 어떻게 드러나는지 알고 있는가
조합키에 넣은 값 중 바뀔 수 있는 것이 있는가. 바뀌면 새 행이 되는 것을 용도가 허용하는가
세어 본 결과를 DB 제약으로 옮겼는가. 다음 수신에서 깨지면 알 수 있는가
마무리
원천 데이터에 붙은 이름은 그쪽 체계의 약속입니다. 내 테이블의 유니크는 내 데이터로 확인합니다. 이번 건은 12,668건을 세는 데 2분이 들었고, 그 2분이 104건의 조용한 유실을 막았습니다. 외부 식별자를 키로 잡기 전에 전량을 한 번 세어 봅니다. 스크립트 몇 줄이고, 그 스크립트가 수집 로직의 첫 리허설이 됩니다.