인덱스를 타고 있는데 4.1초 상세히 뜯어봤습니다
매퍼 주석에는 이렇게 적혀 있었습니다. 「매핑 행마다 첫 행만 확인하는 프로브라 전범위 스캔 없이 수 밀리초.」 실측은 4.18초였습니다. 화면 응답 시간의 약 45%를 이 서브쿼리 하나가 쓰고 있었습니다.
다른 작업을 검증하다 발견한 4.1초
상품 매출 순위 화면입니다. 화면을 쓰는 쪽에서는 상품 순위 한 번 보려고 매번 몇 초를 기다리는 상황이었고, 기간을 바꿔 다시 조회할 때마다 그 대기가 반복됐습니다.
별개의 성능 작업을 마치고 사후 검증을 돌리던 중에 원인 지점이 드러났습니다. 「이 상품과 관련된 매장 수를 세는」 서브쿼리가 1개월 조회에서 4.18초, 7개월 조회에서 3.37초를 쓰고 있었습니다. 조회 기간이 길어질수록 오히려 빨라지는 방향이라, 데이터 양에 비례하는 단순 스캔은 아니라는 신호였습니다.
인덱스는 타고 있었습니다. 다만 ref로만
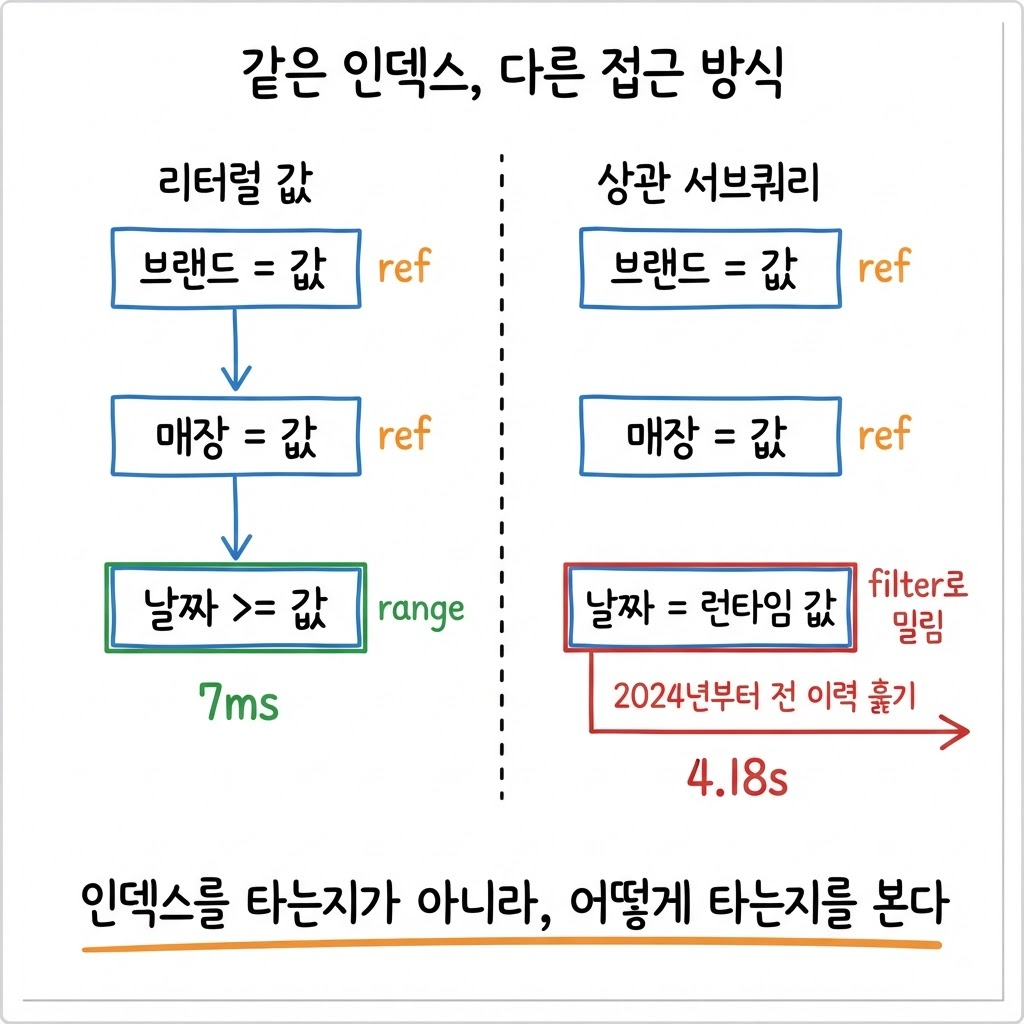
EXPLAIN ANALYZE로 열어보니 인덱스를 안 타는 것이 아니었습니다. (브랜드, 매장, 날짜) 복합 인덱스가 있었고 옵티마이저는 그 인덱스를 선택했습니다. 문제는 타는 방식이었습니다. 앞 두 컬럼만 ref로 접근하고, 날짜는 range 조건이 아니라 filter로 밀려 있었습니다.
사전에서 단어는 찾았는데 뜻은 못 찾는 상태와 비슷합니다. 매장에 해당하는 페이지는 인덱스로 단번에 펼칩니다. 그런데 그 페이지 안에서 원하는 날짜를 찾는 일은 인덱스가 도와주지 않으니, 페이지 첫 줄부터 한 줄씩 읽어 내려갑니다. 인덱스가 날짜 오름차순이라 매장 엔트리는 오래된 것부터 나열되고, 조회 대상은 대개 맨 뒤인 최근 구간에 있습니다. 최근을 볼수록 더 오래 걸리는 구조입니다.
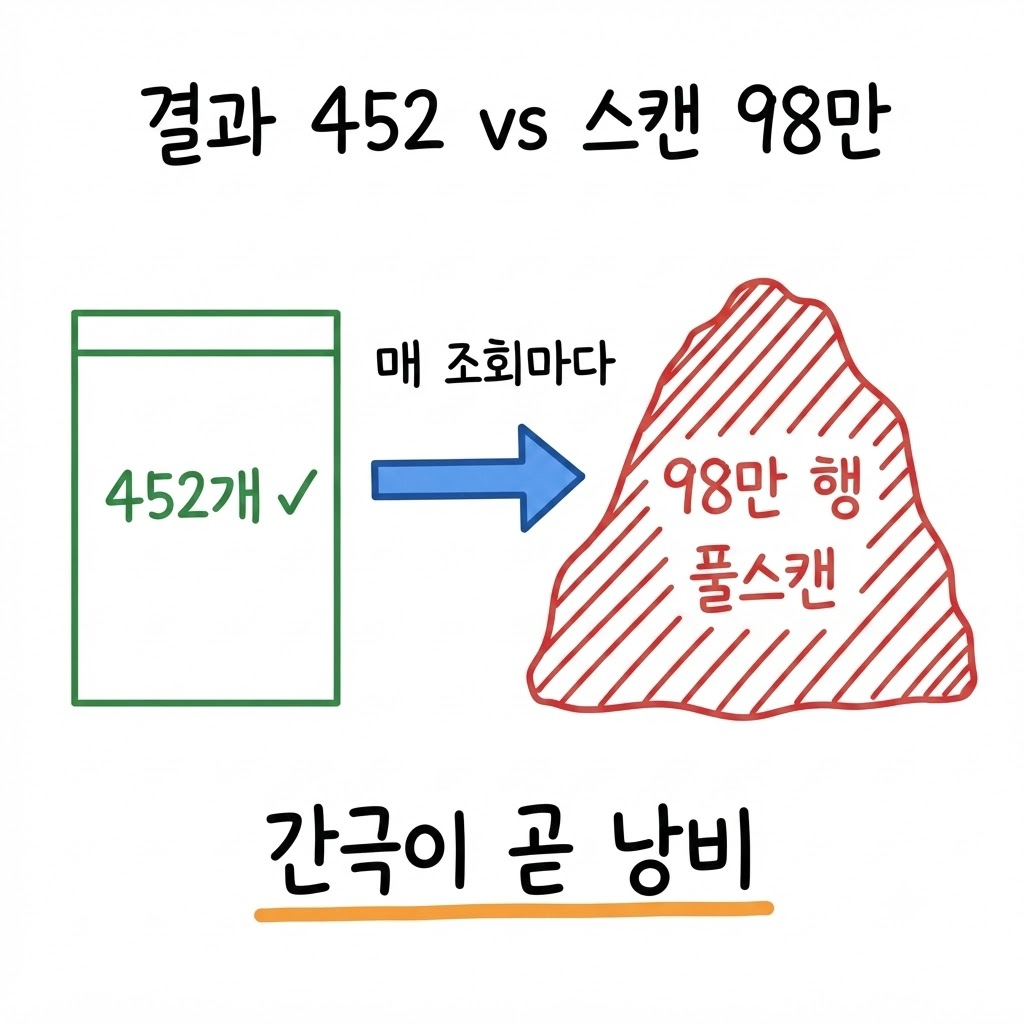
실측 숫자가 그대로 그 모양이었습니다. 서브쿼리 반복 247회에 회당 26,055행, 합해서 약 640만 엔트리를 훑고 있었습니다. 기간을 늘렸을 때 더 빨라진 것도 여기서 설명됐습니다. 반복 횟수와 매장별 훑는 폭의 조합이 바뀌기 때문입니다.
결정적인 대조 실험은 값을 리터럴로 박아본 것입니다. 매장 하나를 지정하고 날짜를 직접 써서 같은 테이블, 같은 인덱스로 프로브하면 7밀리초였습니다. 같은 인덱스가 이번에는 range로 갑니다. 즉 인덱스 설계 문제가 아니라, 값이 런타임에 정해지는 문맥의 문제였습니다. 상관 서브쿼리 안에서는 바깥 행마다 값이 결정되니 옵티마이저가 그 값을 범위 경계로 쓰지 못하고 ref로 고정합니다.
실행계획을 직접 열기 전까지 이 서브쿼리는 의심 목록에 없었습니다. 주석이 이미 「수 밀리초」라고 답을 정해놓고 있었기 때문입니다. 전에도 화면에는 몇백 건만 보이는데 뒤에서는 백만 행 가까이 집계하고 있던 경우가 있었고, 그때도 실측을 하기 전에는 아무도 그 지점을 지목하지 않았습니다.
기각한 다섯 가지
원인을 알고 나서도 답까지는 멀었습니다. 다섯 갈래를 파고 다섯 번 다 실패했습니다. 이 기록이 이 작업의 실제 산출물이라고 생각해 표로 남겼습니다.
시도한 대안 | 실측 결과 | 왜 안 됐나 |
|---|---|---|
리터럴 목록으로 전환 | +4.5초 악화 | 다른 화면에서 효과를 본 패턴이었지만, 여기서는 목록이 커지면서 쿼리 자체가 무거워졌다 |
최댓값 시크로 우회 | 4.08초 (무개선) | 접근 형태가 여전히 ref라 매장별로 앞에서부터 훑는 구조가 그대로 남았다 |
측면 조인 + 1행 제한 | 5.01초 악화 | 바깥 행마다 조인이 다시 붙어 반복 비용이 오히려 늘었다 |
원본 측 중복 제거 파생 테이블 조인 | 3.84초 (미미) | 파생 테이블을 만드는 비용이 줄어든 만큼을 거의 다 먹었다 |
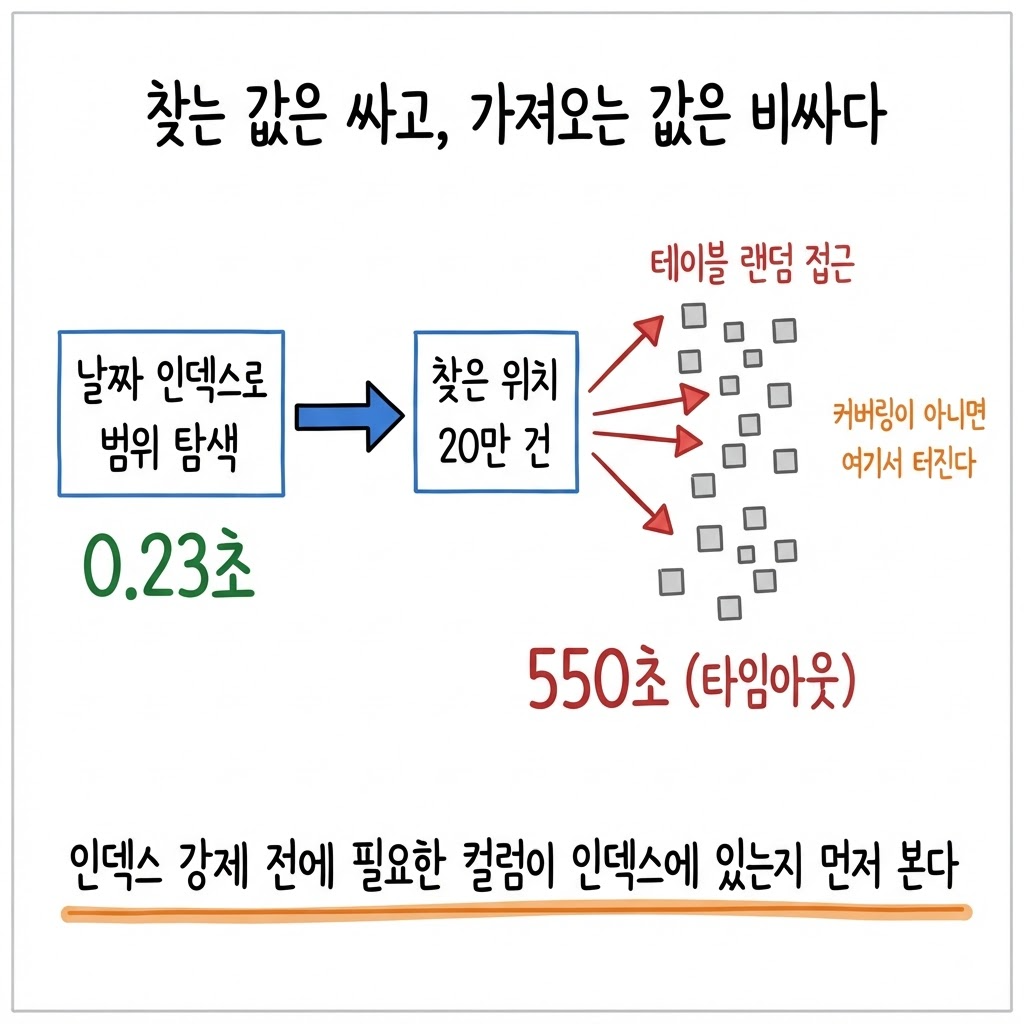
날짜 선두 인덱스 강제 | 550초 타임아웃 | 범위 탐색 자체는 0.23초로 빨랐지만, 그 뒤 20만 건의 랜덤 행 조회가 재앙이었다 |
가장 많이 가르쳐준 것은 마지막 실험입니다. 날짜를 선두로 둔 인덱스를 강제하면 조건에 맞는 위치를 찾는 데는 0.23초면 끝납니다. 그런데 찾은 20만 개의 위치에서 실제 행을 읽어오는 데 550초가 걸렸습니다. 인덱스로 찾는 일은 싸고, 필요한 컬럼을 가져오는 일이 비쌉니다. 인덱스에 필요한 컬럼이 다 들어 있지 않으면 위치마다 테이블을 다시 뒤져야 하고, 그 접근이 흩어져 있을 때 비용이 폭발합니다.
정석으로 통하는 해법, 즉 상관 서브쿼리를 조인으로 펴는 방법도 이번에는 쓸 수 없었습니다. 조인으로 바꾸면 중복 계상 여부가 달라져 의미론이 바뀌기 때문입니다. 정석이 항상 답은 아니라는 사실을 다섯 번의 실측으로 확인한 셈입니다.
쿼리를 고치는 대신 읽는 대상을 바꿨습니다
여섯 번째 시도는 쿼리를 손보는 방향이 아니었습니다. 질문을 바꿨습니다. 「이 서브쿼리가 답하려는 질문에, 더 쉽게 답할 수 있는 다른 테이블이 있는가.」 찾아보니 (매장, 일자) grain으로 이미 집계돼 있고 날짜 인덱스를 가진 테이블이 있었습니다. 세려는 대상이 같으니 그 테이블에 물어도 같은 답이 나옵니다.
소스만 교체했습니다. 1개월 4.18초가 0.107초로, 39배 줄었습니다. 7개월은 3.37초에서 0.231초였습니다. Java와 호출부는 한 줄도 건드리지 않았습니다. 다섯 번의 튜닝이 못 만든 폭을, 읽는 대상 하나 바꾸는 것이 만들었습니다.
읽는 대상 자체를 바꾸는 판단은 처음이 아니었습니다. 전에도 소스 테이블의 grain이 하려는 일과 어긋나 있어서, 쿼리를 다듬는 대신 데이터가 쌓이는 층의 경계를 다시 그은 적이 있습니다. 그때와 이번의 공통점은 병목이 쿼리 문장이 아니라 읽고 있는 대상에 있었다는 점입니다.
값이 214에서 215로 바뀐 순간
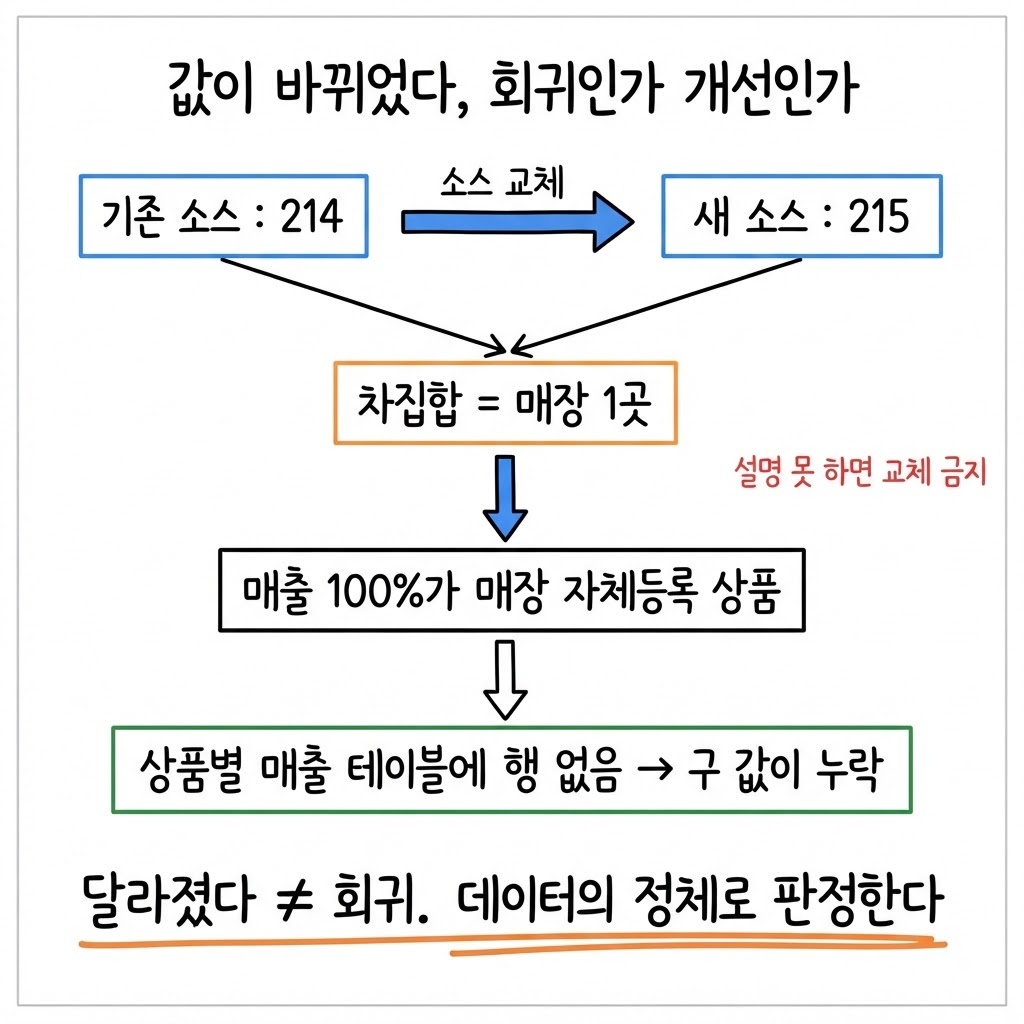
교체 직후 검증에서 결과 값이 달라졌습니다. 1개월 기준 매장 수가 214에서 215로 늘었습니다. 성능 작업에서 결과 값이 바뀌면 기본은 회귀 의심입니다. 빨라진 대신 뭔가를 잘못 세고 있을 가능성부터 보는 것이 순서입니다.
판별은 매장 단위로 했습니다. 두 결과의 차집합을 뽑아 늘어난 한 곳을 특정하고, 그 매장의 매출 구성을 확인했습니다. 그 매장은 매출 100%가 매장이 자체등록한 상품에서 나오고 있었습니다. 그래서 상품별 매출 테이블에는 행이 아예 없었고, 기존 서브쿼리는 그 매장을 볼 방법이 없었습니다. 실제로 영업 중인 매장이니 세어야 하는 대상입니다.
결론은 새 값이 정답이고 구 값이 누락이었다는 것입니다. 달라졌다는 사실만으로 회귀라고 부를 수는 없고, 어느 쪽이 옳은지는 그 차이를 만든 데이터의 정체로 판정합니다. 반대로 말하면, 이 한 건을 설명할 수 없었다면 소스 교체는 채택하지 못했을 것입니다. 두 테이블이 같은 질문에 같은 답을 준다는 보장이 없는 채로 바꾸는 것은 성능 개선이 아니라 계산 결과 변경입니다.
남긴 것과 남은 것
작업을 닫으면서 매퍼 주석을 다시 썼습니다. 「수 밀리초」라는 문장을 지우고, 실측값과 기각한 다섯 대안을 각각의 측정 결과와 함께 적었습니다. 이 주석의 목적은 설명이 아니라 차단입니다. 다음 사람이, 또는 6개월 뒤의 제가 같은 다섯 갈래를 다시 파는 시간을 없애는 쪽입니다.
남은 것도 명시했습니다. 이 화면에는 아직 다른 집계 스캔이 1개월 4.5초, 7개월 13.5초로 남아 있습니다. 이쪽은 커버링 인덱스가 있어야 풀리고, 그건 운영 DDL 승인 대상이라 이번 작업에 묶지 않고 별도 건으로 분리했습니다.
다음에 같은 상황을 만났을 때 볼 것
실행계획에서 「인덱스를 탄다」에 멈추지 않고, ref인지 range인지와 조건이 range로 갔는지 filter로 밀렸는지까지 확인한다
값을 리터럴로 바꿔 같은 쿼리를 한 번 돌려본다. 리터럴에서 빠르면 인덱스 설계가 아니라 값의 출처가 문제다
인덱스를 강제하기 전에 필요한 컬럼이 그 인덱스에 들어 있는지 본다. 탐색 비용과 행 인출 비용은 별개 항목이다
쿼리 튜닝을 시작하기 전에 같은 질문에 답할 수 있는 다른 grain의 테이블이 있는지 먼저 찾는다
결과 값이 달라지면 멈추고 차집합을 뽑아 어느 쪽이 옳은지 데이터의 정체로 판정한다
정리하면 이 작업의 실제 소득은 39배가 아닙니다. 채택안은 한 줄이고, 시간이 든 것은 기각된 다섯입니다. 성능 작업을 반복해보면 기록되는 쪽과 비용이 든 쪽이 어긋나 있다는 것이 보입니다.
코드에 적힌 성능 주장은 작성 시점의 가설입니다. 데이터가 자라면 가설은 틀려지고, 갱신되지 않은 주석은 그 지점을 의심 목록에서 빼버립니다. 오래 운영한 시스템에서 튜닝 대상을 찾을 때, 저는 이제 「이미 빠르다고 적혀 있는 곳」부터 한 번 재봅니다.