'알 방법이 없다'던 구독 LLM 한도, 응답 헤더에 매 호출 실려 오고 있었습니다
'질문당 입력이 13,006자입니다. 148문항이면 약 1.8M 토큰이 나갑니다.' 답변 품질 측정표 여섯 회차 분에 이 계산이 그대로 붙어 있었습니다. 회차마다 구독 한도에 걸려 답이 안 나오는 구간이 생겼습니다. 왜 찼는지를 설명하려고 글자 수를 토큰으로 환산했습니다. 맞는지 확인할 방법은 없다고 생각했습니다.
여섯 회차가 지난 뒤에 그 창구를 curl 로 직접 쳤습니다. 응답 헤더를 전량 출력하는 데 2분이 걸렸습니다. 한도 잔량이 매 호출 헤더에 실려 오고 있었습니다. 여섯 회차 동안 우리는 그 값을 받아서 그대로 버리고 있었습니다.
추정이 여섯 회차를 버틴 이유
사내 제안서 지식검색 도구의 채팅 답변 품질을 회차별로 전수 측정하고 있었습니다. 회차당 148문항입니다. 답변을 만드는 LLM 은 코덱스 구독, 즉 ChatGPT 구독 인증으로 REST 창구를 직접 쳐서 씁니다. 측정을 돌리다 보면 구독 한도에 걸려 답이 안 나오는 구간이 생깁니다.
'왜 찼나'와 '얼마나 남았나'를 알 수 없다고 봤습니다. 그래서 질문당 글자 수에 문항 수를 곱해 토큰을 추정했습니다. 이 추정은 다음 질문에도 그대로 쓰였습니다. '사람 10명이 쓰면 얼마나 가나'라는 용량 계획이 그 위에 얹혔습니다.
추정이 오래 버틴 이유는 틀렸다는 신호가 한 번도 안 왔기 때문입니다. 한도 초과는 에러 문자열에 '한도'를 뜻하는 단어가 들어 있나로 골라내고 있었습니다. 그 문구가 안 맞으면 500 으로 떨어져 원인이 안 보였습니다. 대조할 실측이 없으니 환산식이 얼마나 빗나갔는지도 알 수 없었습니다.
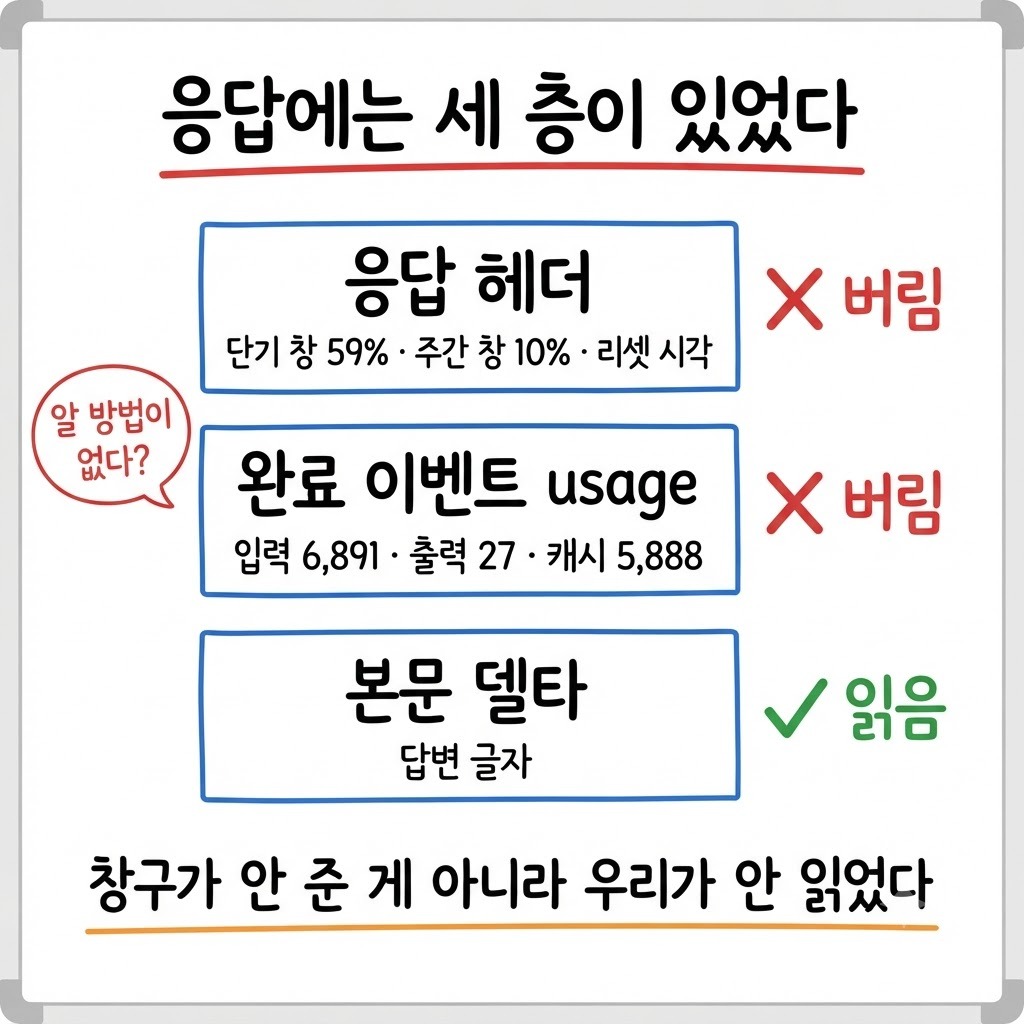
응답에는 세 층이 있었고 한 층만 읽고 있었다
curl 로 받은 응답 헤더에는 한도 정보가 네 종류 실려 있었습니다. 헤더 이름은 제공자가 문서화하지 않은 것이라 뜻으로만 적습니다.
구독 플랜 등급
단기 창의 사용 비율과 창 길이(300분, 곧 5시간), 리셋 시각. 그 시점 값은 59%
주간 창의 사용 비율과 창 길이(10,080분, 곧 7일). 그 시점 값은 10%
크레딧 잔액
스트림의 완료 이벤트 `response.completed` 에는 `usage` 가 붙어 있었습니다. 한 호출의 값을 예로 들면 `input_tokens` 6,891, `output_tokens` 27, `cached_tokens` 5,888, `reasoning_tokens` 0 입니다. 입력 6,891 토큰 중 5,888 이 캐시된 입력이었습니다. 글자 수 환산식에는 이 항목 자체가 없었습니다.
우리 클라이언트는 SSE 에서 본문 델타 이벤트 `response.output_text.delta` 하나만 읽고 있었습니다. 답변 글자를 모으는 데는 그것으로 충분했습니다. 나머지 이벤트와 헤더는 받는 즉시 버려졌습니다. 창구가 안 준 게 아니라 우리가 안 읽고 있었습니다.
응답의 층 | 무엇이 오나 | 읽고 있었나 |
|---|---|---|
응답 헤더 | 두 창의 사용 비율·창 길이·리셋 시각 | 아니오 |
완료 이벤트의 usage | 입력·출력·캐시된 입력 토큰 실측 | 아니오 |
본문 델타 이벤트 | 답변 글자 | 예 |
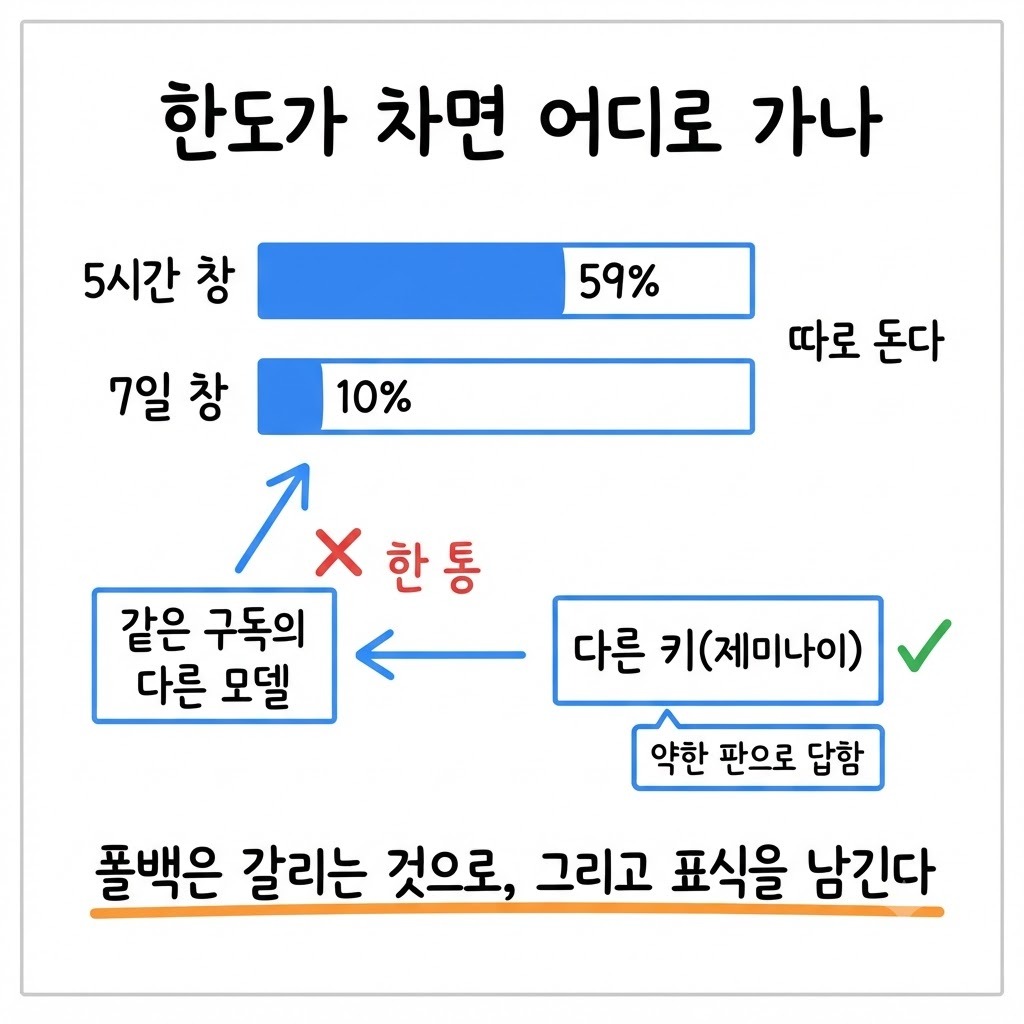
한도 창이 둘이고 따로 돈다는 것도 헤더를 보고서야 알았습니다. 5시간 창이 비어 있어도 7일 창이 차면 막힙니다. 한 창만 보고 '아직 여유 있다'고 읽으면 틀립니다. 폴백 조건도 창별로 갈립니다.
계측은 전송 함수 한 곳에 붙였다
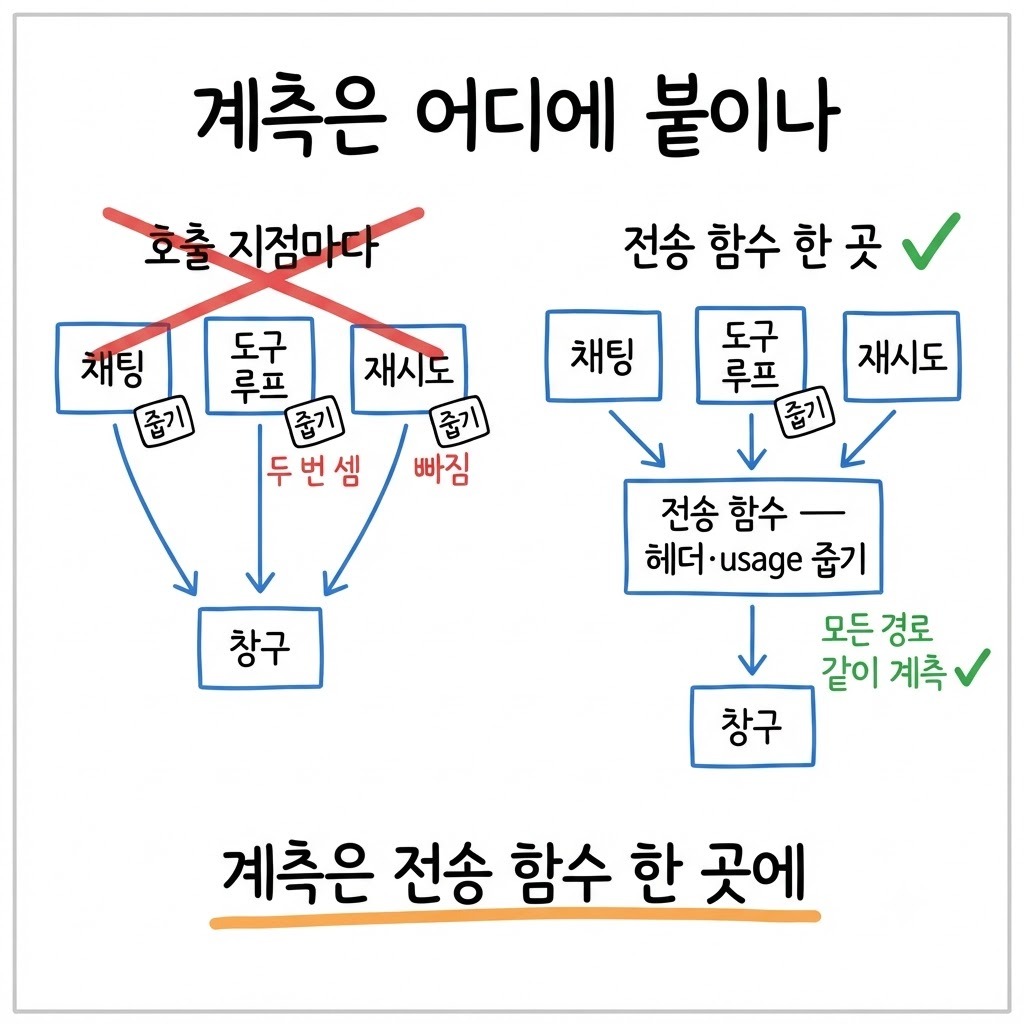
값이 어디에 오는지 알았으니 다음은 어디서 줍나입니다. 선택지는 둘이었습니다. 부르는 쪽마다 헤더와 `usage` 를 줍게 하거나, 전송 함수 한 곳에서 줍게 하거나입니다. 후자로 갔습니다.
호출 지점마다 줍게 하면 새 경로가 생길 때마다 빠집니다. 도구 루프처럼 한 질문이 여러 번 호출되는 경로에서는 빠뜨리거나 두 번 셉니다. 전송 함수 한 곳에 두면 부르는 쪽 코드를 안 고쳐도 모든 경로가 같이 계측됩니다. 전송 함수를 우회하는 경로가 생기면 그 경로는 그 순간부터 사각입니다. 경로가 하나뿐일 때만 성립하는 보장입니다.
소비량을 무엇 단위로 쌓을지도 정해야 했습니다. 인프랩이 공개한 사례는 게이트웨이에 기능 이름을 헤더로 실어 보내 기능별로 집계했습니다. 우리는 능력 이름으로 LLM 인스턴스를 만드는 팩토리가 있어 호출 지점에서 이미 그 이름을 압니다. 같은 원리를 능력 이름 단위 누계로 적용했습니다. 캐시된 입력 토큰도 같이 쌓이므로 실제 캐시율이 화면에 나옵니다.
한도 초과는 문자열이 아니라 타입으로 올린다
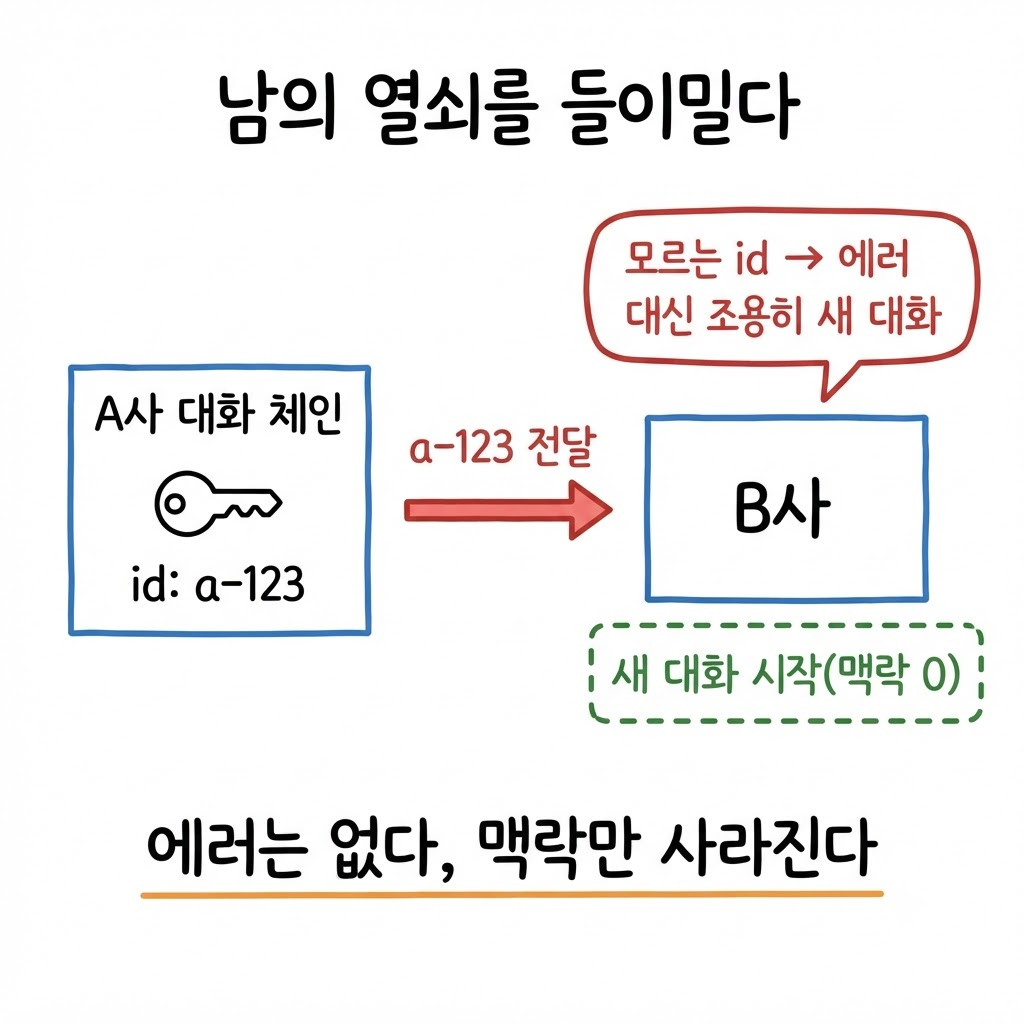
한도 초과 처리도 같이 바꿨습니다. 에러 문자열 검색을 걷어내고 타입 있는 예외로 올립니다. 그 예외는 어느 창이 찼는지와 리셋 시각을 들고 있습니다. 제공자가 문구를 바꿔도 조용히 안 걸리는 일이 없습니다. 제공자의 문구는 계약이 아닙니다.
한도가 차면 별도 키로 한 번 더 시도합니다. 우리는 제미나이 키를 뒀습니다. 같은 구독 안에서 모델만 바꾸는 것은 의미가 없습니다. 한도가 구독 단위로 한 통이라 어느 모델을 불러도 같은 창을 밉니다. 한도가 갈리는 것은 계정이나 키 단위입니다.
폴백으로 답한 건에는 약한 판으로 답했다는 표식을 응답에 싣습니다. 조용히 바꾸면 품질이 내려간 것을 아무도 모릅니다. 측정표에 두 모델의 답이 섞이는데 어느 행이 어느 모델인지 구분할 수 없게 됩니다. 에러 로그는 0건인데 답이 나빠졌다는 신고가 들어온 적이 있습니다.
헤더가 안 오는 날을 위한 자리
비공식 헤더는 계약이 아닙니다. 제공자가 이름이나 의미를 바꾸면 계측이 조용히 0 이 됩니다. 그래서 헤더가 안 온 호출은 '값 없음'으로 따로 기록합니다. 그래야 추정으로 되돌아간 시점을 알 수 있습니다.
창구가 정말 안 주는 경우도 있습니다. 헤더와 이벤트를 다 덤프했는데 없으면 그때는 추정이 맞는 도구입니다. 이 글의 주장은 덤프를 안 하고 추정으로 가지 말라는 것이지 항상 있다는 것이 아닙니다. 두 창의 사용 비율은 오지만 이 호출이 창을 얼마나 밀었나는 안 옵니다. 비율의 변화량과 `usage` 를 대조해야 한 호출의 단가가 나옵니다.
체크리스트
새 창구를 붙일 때 첫 호출에서 헤더 전량과 이벤트 종류를 한 번 덤프해 뒀는가
운영 화면의 한도·토큰 숫자 중 원천이 우리 환산식인 것이 있는가
한도 창이 몇 개인지 알고 있고, 폴백 조건이 창별로 갈리는가
한도 초과 판정이 제공자의 에러 문구에 걸려 있는가, 타입에 걸려 있는가
폴백으로 답한 건이 데이터에 표식으로 남는가
마무리
'이 값은 알 방법이 없다'는 결론은 응답의 일부만 읽은 상태에서 나왔습니다. 스트림 클라이언트는 본문 델타만 읽도록 짜기 쉽습니다. 그러면 헤더와 완료 이벤트가 전부 사각이 됩니다. 덤프 한 번의 비용은 분 단위였습니다. 추정으로 버틴 기간은 여섯 회차였습니다.
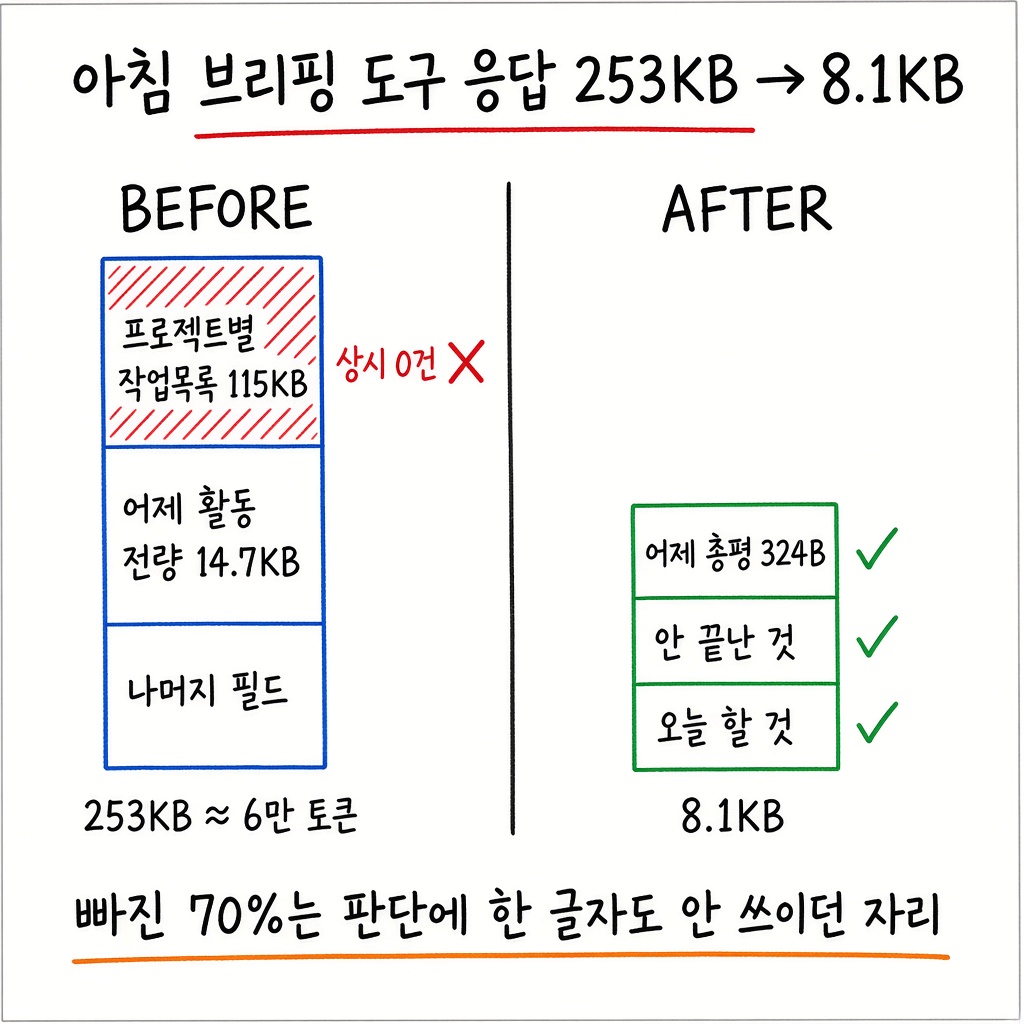
무엇이 오는지 다 본 뒤에 무엇을 읽을지 정하는 일은 반대 방향에서도 같습니다. 도구 응답을 통째로 받았더니 70% 가 판단에 안 쓰이던 일이 있었습니다.
운영자가 가져갈 계측 기준은 한 줄입니다. 한도와 토큰은 우리가 세는 값이 아니라 창구가 매 호출 주는 값입니다. 그 값이 안 온 호출은 '값 없음'으로 따로 셉니다.
연작 '토큰은 어디로 갔나'
이 글은 다섯 편 중 1편입니다. 구독 LLM 을 운영하며 한도·토큰·인증이 어디서 새고 어디서 안 보였는지를 이어서 다룹니다.