문서 파싱이 에러를 안 냈는데, 색인된 건 암호문 1,006 조각이었습니다
사내 문서를 통째로 색인해 검색하게 하는 도구를 운영하고 있습니다. 밤마다 폴더를 훑어 새 문서를 밀어 넣고, 아침에 요약 알림이 옵니다. 그날 알림에서 한 줄의 숫자가 안 맞았습니다. 한 폴더에서 파싱 실패가 났는데, 실패 건수가 폴더 안의 파일 수보다 적었습니다.
폴더를 열어 보니 그 안의 문서는 전부 어떤 보안 제품으로 암호화된 파일이었습니다. 고객사가 산출물을 그 상태로 넣어 둔 것이고, 우리 파이프라인에는 그런 파일을 받는 입구가 아예 없었습니다. 여기까지는 예상 가능한 사고였습니다. 문제는 그다음이었습니다.
절반은 실패로 걸렸고, 절반은 성공으로 들어갔습니다
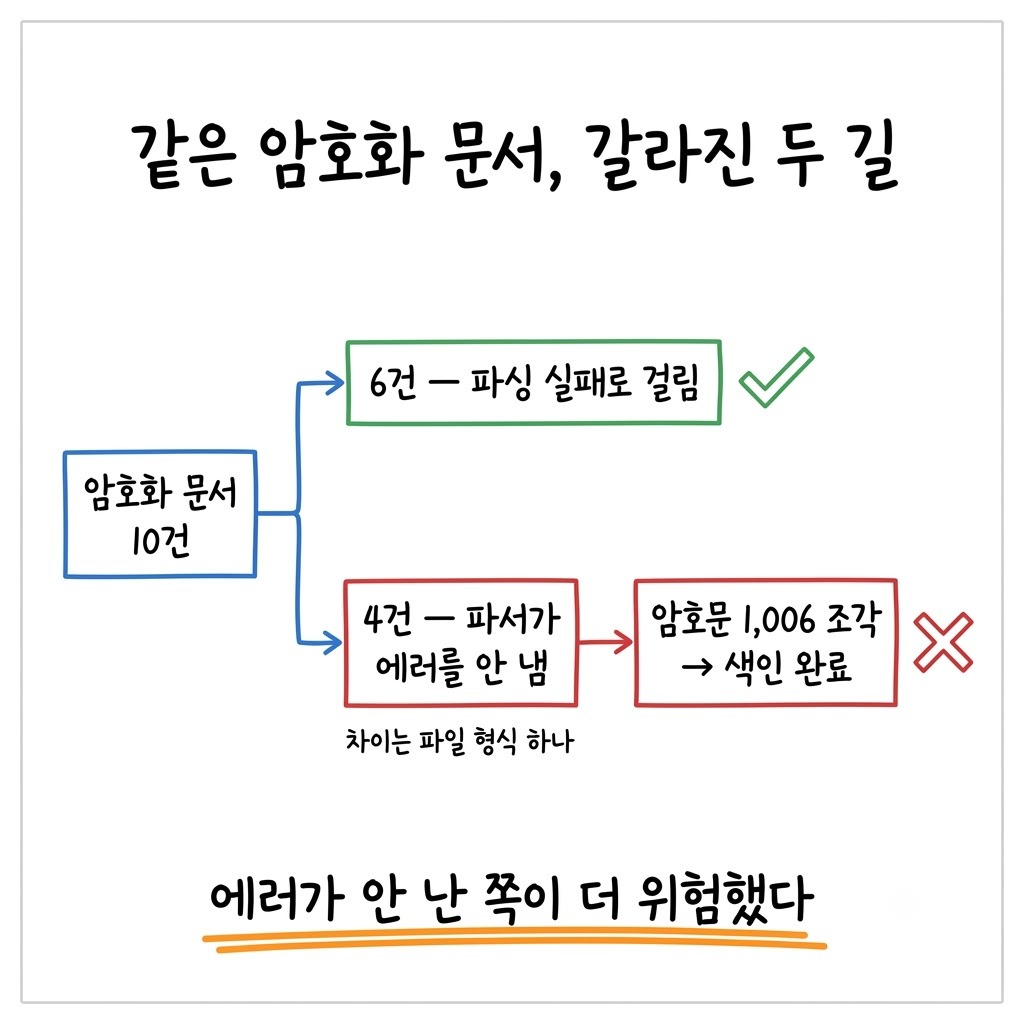
암호화 문서 10건 중 6건은 파싱 실패로 정상적으로 걸러졌습니다. 남은 4건은 국산 문서 형식이었고, 이쪽 파서는 에러를 내지 않았습니다. 암호문 바이트를 받아 글자처럼 풀어냈고, 그 결과 1,006 조각이 '색인 완료'로 저장소에 들어갔습니다. 둘의 차이는 파일 형식 하나뿐이었습니다.
그 4건의 조각을 열어 봤습니다. 사람이 읽을 수 없는 글자 덩어리였습니다. 검색 결과에 섞여 나오면 답변 품질을 깎아 먹을 내용이고, 겉으로는 정상 문서와 구별되지 않습니다.
그리고 조각 요약 카드를 만드는 테이블을 열었을 때 앞이 서늘해졌습니다. 거기에는 이미 '깨진 텍스트, 판별 불가'라고 적혀 있었습니다.
탐지는 되고 있었습니다. 그걸 읽는 코드가 없었습니다
시스템은 이미 알고 있었습니다. 요약 카드 생성 단계가 조각을 보고 판별 불가라고 제대로 판정했고, 그 판정을 테이블에 적어 두기까지 했습니다. 파이프라인은 그 값을 읽지 않고 다음 단계로 넘어가 색인 성공으로 기록했습니다.
그래서 이 사고의 본체는 탐지 실패가 아닙니다. **판정을 만드는 것과 그 판정을 쓰는 것은 다른 일**이었고, 우리는 앞쪽만 만들어 두고 뒤쪽을 안 만들었습니다. 판정을 소비하는 자리가 없으면 판정은 기록에만 남습니다.
그 아래에 더 오래된 문제가 있었습니다. 파서는 계약대로 동작했습니다. 바이트를 받아 글자를 냈습니다. 그 글자에 뜻이 있는지는 파서의 책임이 아닙니다. 그런데 우리 상태 모델은 성공과 실패 두 칸뿐이어서, 에러 없이 읽혔지만 읽은 내용이 쓰레기인 경우를 담을 칸이 없었습니다. 담을 칸이 없으면 그 건은 성공 칸으로 떨어집니다.
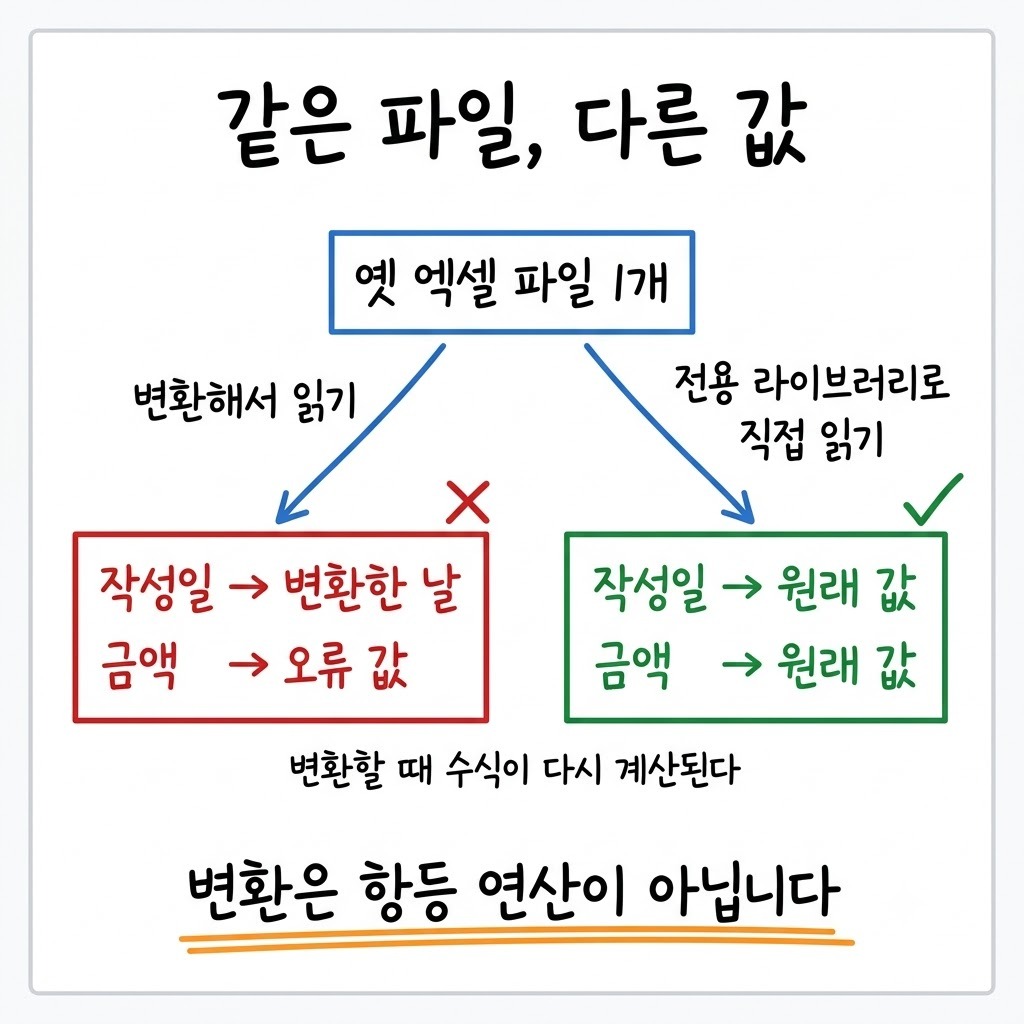
파서가 끝까지 성공을 보고하는 바람에 틀린 값이 조용히 내려앉는 패턴은 이번이 처음이 아니었습니다. 파일 변환이 엑셀 수식을 다시 계산해 숫자를 바꿔 놓았을 때도 변환기는 성공만 돌려줬습니다.
새 저장소를 만들 것인가, 상태 값 하나를 더할 것인가
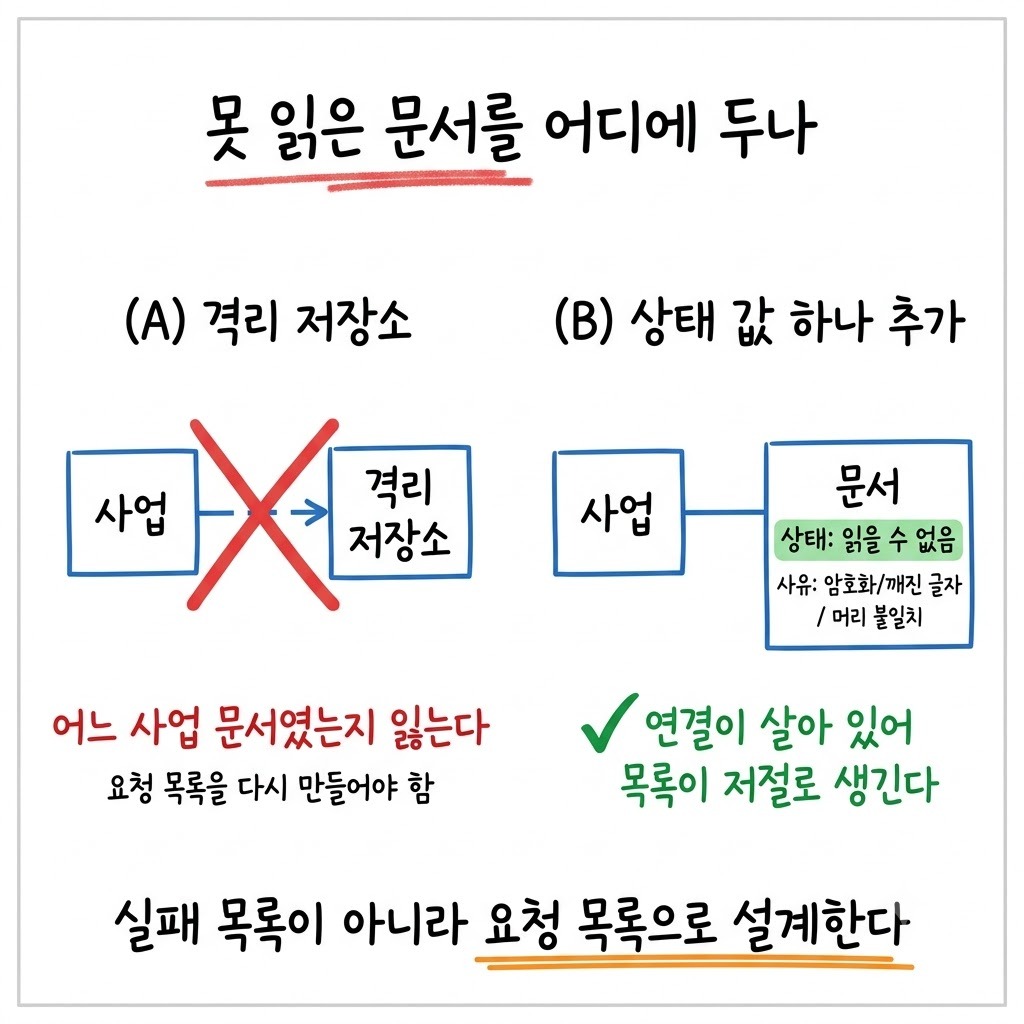
응급 처치로 4건을 삭제 API 로 빼고 벡터와 그래프 노드가 0인 것을 확인한 뒤, 설계 갈림길을 봤습니다. 못 읽은 문서를 어디에 둘지가 문제였습니다.
(A) 격리 저장소와 표를 새로 만든다 | (B) 문서 상태에 값 하나를 더한다 | |
|---|---|---|
재시도 차단 | 목록에서 빼면 되니 쉽습니다 | 완료 상태 목록에 넣어야 합니다 |
사업·문서 연결 | 끊깁니다. 어느 사업의 문서였는지 잃습니다 | 유지됩니다 |
관리 화면 | 화면을 새로 만들어야 합니다 | 기존 문서 화면에 탭 하나 |
복호화본이 왔을 때 | 격리본과 신규본을 잇는 로직이 필요합니다 | 해시가 달라 그냥 새 문서로 들어옵니다 |
(B)를 골랐습니다. 결정적인 이유는 재시도나 화면 비용이 아니었습니다. **연결을 끊지 않으면 목록이 저절로 생긴다**는 점이었습니다. '읽을 수 없음' 상태이면서 사업에 붙어 있는 문서를 모으면, 그게 그대로 고객에게 복호화본을 요청할 목록입니다. 격리 저장소로 뺐으면 그 목록을 다시 만들어야 했을 겁니다.
문서 상태에 '읽을 수 없음' 하나를 추가하고 사유를 같이 적게 했습니다. 암호화, 깨진 글자, 머리 바이트 불일치 셋입니다. 관리 화면은 그 상태를 눈에 띄는 색으로 칠하고 파일명 밑에 왜 못 읽었는지를 그대로 보여줍니다. 원본은 지우지 않습니다. 사람이 열어 확인할 수 있어야 하기 때문입니다.
검사는 한 겹으로 다 막지 않습니다
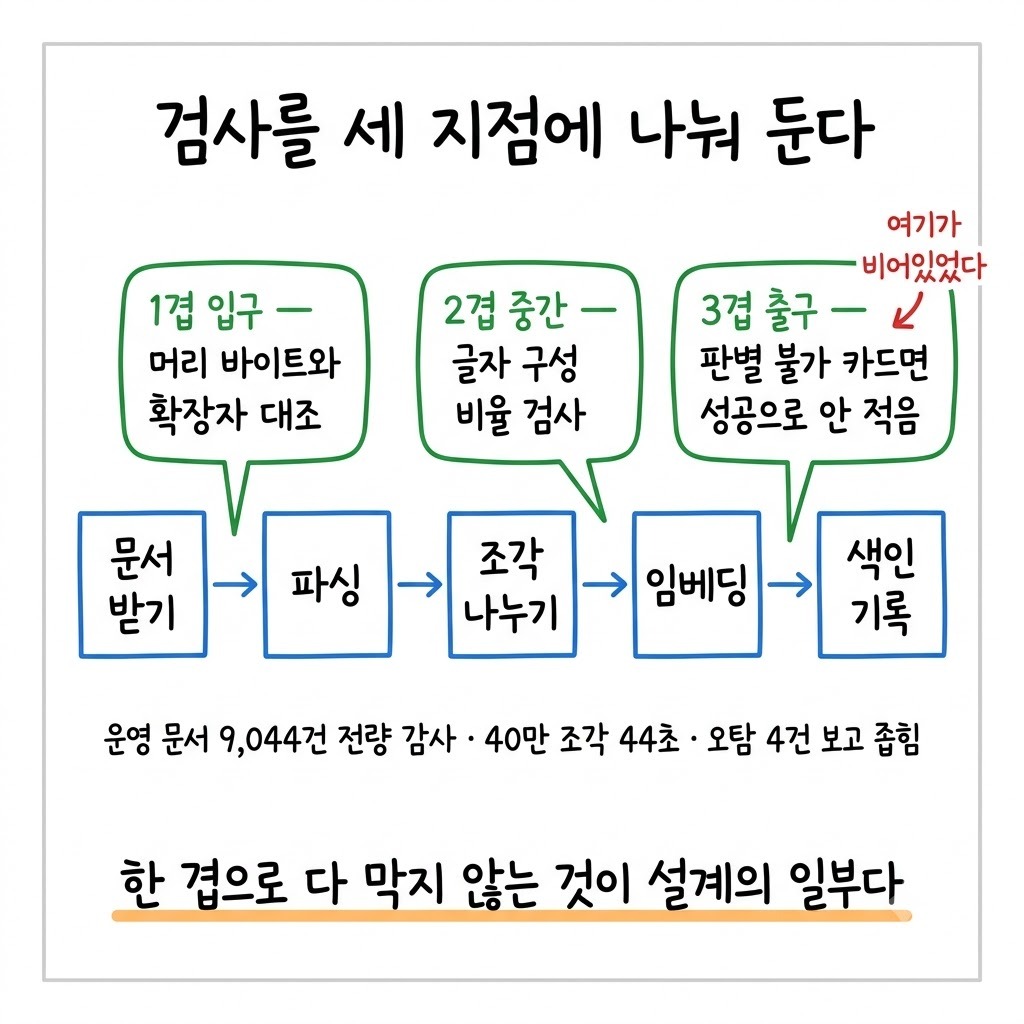
검사는 파이프라인의 서로 다른 세 지점에 넣었습니다. 한 겹으로 전부 막으려 하지 않는 것이 이 설계의 전제입니다.
입구(파싱 전) — 파일 머리 바이트와 확장자를 대조합니다. PDF 는 앞 1KB 안에서 찾습니다. 어긋나면 파싱도 문서 변환도 아예 안 탑니다
중간(임베딩 전) — 뽑힌 글자의 구성을 봅니다. 유니코드 사용자영역·미할당 코드포인트가 8% 이상이면서 한글과 영문이 40% 미만이거나, 한자가 30% 이상이면서 한글·영문이 각 20% 미만이면 걸러냅니다. 200자 미만은 아예 판정하지 않습니다
출구(기록 직전) — 요약 카드가 판별 불가류로 말하면 색인 성공으로 적지 않습니다. 이번에 비어 있던 자리가 여기입니다
왜 겹이 필요한지는 1겹의 한계가 설명합니다. 암호화된 파일이라도 겉이 표준 압축 컨테이너면 확장자와 머리 바이트가 맞습니다. 머리 검사로는 못 잡고, 그건 2겹이 받게 되어 있습니다.
상태를 하나 추가하면서 곁가지도 하나 만났습니다. 색인 작업이 읽을 수 없음으로 **종결되지 않으면** 진행 총계에 못 닿아, 폴더를 훑는 스캐너가 폴더째 실패로 적었습니다. 종결 상태 목록에도 같이 넣어야 했습니다. 그래서 새 상태를 도입할 때는 셋을 같이 정하는 것으로 정리했습니다. 완료로 칠 것인가, 재시도 정책은 무엇인가, 기존 관계를 끊나 유지하나입니다.
규칙은 운영 전량에 먼저 돌렸습니다
글자 구성 검사는 숫자 하나로 정상 문서를 대량으로 잡을 수 있는 종류의 규칙입니다. 그래서 배포 전에 운영 문서 9,044건 전체에 돌려 봤습니다. 감사 스크립트는 40만 조각을 44초에 훑었습니다. 이 정도 비용이면 안 돌릴 이유가 없습니다.
첫 규칙은 오탐 4건을 냈습니다. 기호 글머리가 많은 공문과 가이드북이었고, 특수문자 비율만 보면 깨진 문서와 똑같이 보였습니다. 그래서 한글과 영문 비율이 낮을 때만 판정하도록 조건을 더해 오탐을 없앴습니다. 실제 암호화 문서는 머리 바이트 검사에서 전부 걸렸습니다. 샘플로 만든 문턱은 이 오탐을 보여주지 못했을 겁니다.
테스트는 고치기 전 판에 대고도 돌렸습니다. 옛 코드에서 실패하는 테스트 8개를 붙였고 전체 896개가 통과했습니다. 옛 코드에서도 통과하는 테스트는 이 종류의 결함을 다음에도 못 잡습니다.
파이프라인을 가진 팀이 점검할 것
판정을 생산하는 단계가 있는데 그 값을 읽는 코드가 어디에도 없는 곳이 있는지 — 판정을 소비하는 자리를 생산 자리와 같이 그려 둡니다
상태가 성공과 실패 두 칸뿐인지 — 에러 없이 처리됐지만 결과가 쓸 수 없는 경우를 담을 칸이 있어야 합니다
새 상태를 넣을 때 완료 여부·재시도 정책·기존 관계 유지 여부 셋을 같이 정했는지
정리해야 할 대상을 실패 목록이 아니라 누군가 행동할 요청 목록으로 설계했는지
판정 규칙을 샘플이 아니라 운영 전량에 한 번 돌려 오탐을 본 뒤 배포하는지
새 테스트를 고치기 전 판에 대고도 돌려 실패하는 것을 확인했는지
이 설계에는 감수한 부분도 있습니다. 읽을 수 없음을 완료로 치는 순간 조용히 묻힐 위험이 같이 들어옵니다. 그래서 스캐너 요약에 읽을 수 없음 건수를 따로 세고, 성공 회차여도 0보다 크면 알림 한 줄을 내게 했습니다. 관리 화면 탭과 알림 한 줄이 같이 있어야 성립하는 설계입니다.
그리고 글자 구성 검사에는 언어 가정이 박혀 있습니다. 한글과 영문 비율이 낮으면 의심한다는 조건이 들어 있어서, 다국어 코퍼스에 그대로 옮기면 정상 문서를 대량으로 잡습니다. 다른 환경으로 가져갈 때 옮겨야 하는 것은 문턱이 아니라 그 가정입니다. 200자 미만을 판정하지 않기로 한 것도 통계가 흔들리는 쪽의 오탐이 더 비싸다고 봤기 때문이고, 표지만 있는 문서는 이 그물을 통과합니다.
파이프라인이 성공이라고 보고했는데 실제 결과가 비어 있던 사례도 같은 자리에 있습니다. 보고하는 쪽과 저장하는 쪽을 각각 확인해야 한다는 교훈이 그때와 같았습니다.
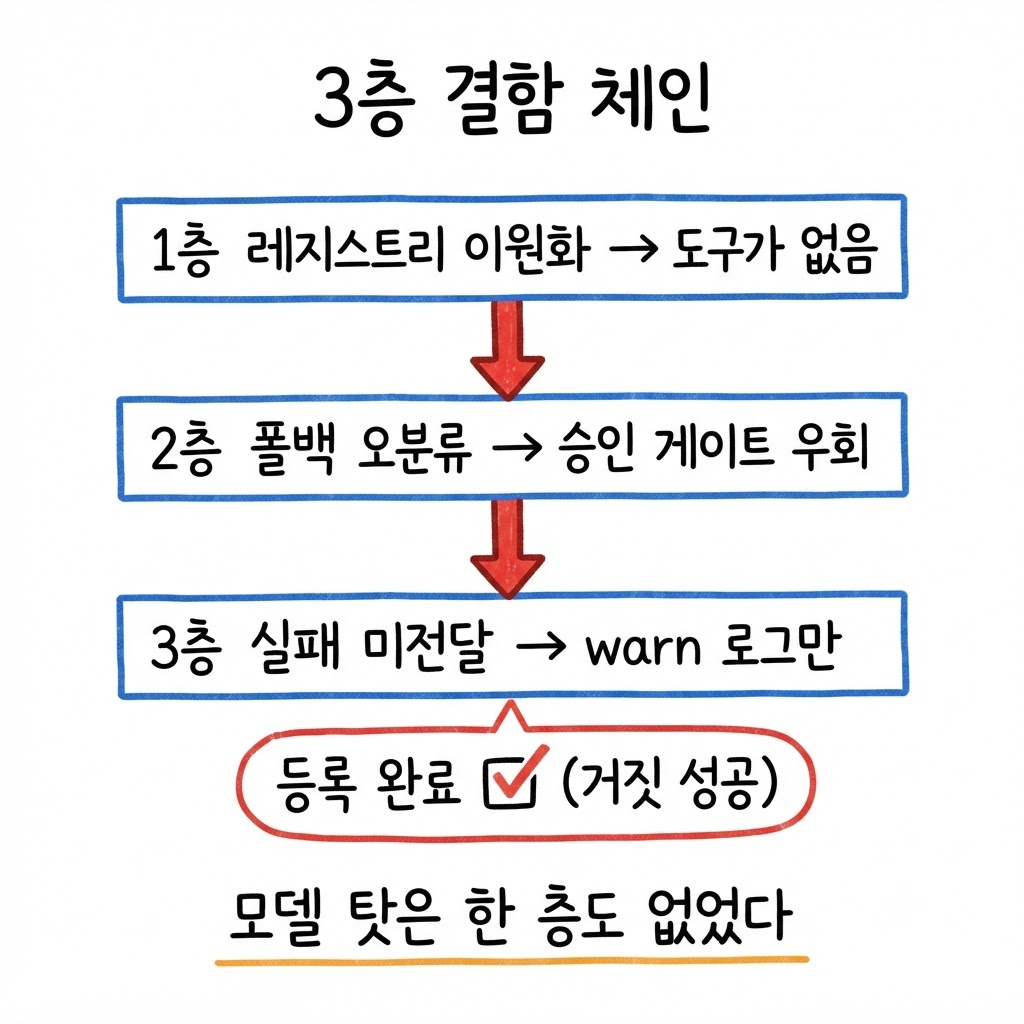
에러가 안 났다는 것은 제대로 됐다는 뜻이 아닙니다. 이번 건에서 우리 시스템은 이미 옳은 판정을 내려 놓고 있었고, 부족한 것은 탐지가 아니라 그 판정을 읽는 한 줄이었습니다. 파이프라인에 판정을 만드는 단계가 있다면, 그 값을 누가 어디서 읽는지를 한 번 따라가 보는 작업이 이번에 가장 도움이 됐습니다.