구독 LLM 한도를 태운 건 사람이 아니라 측정이었습니다 — 건수 7배 × 건당 5배 = 35배
사내 제안서 지식검색 도구의 채팅 답변 품질을 재는 4회차 측정이 끝났는데, 148문항 중 20문항이 비어 있었습니다. 에러가 아니라 사용 한도 안내였습니다. 답변 모델은 코덱스 구독이라 건당 과금이 0이었고, 그래서 '많이 돌려도 돈은 안 든다'고 여기고 있었습니다.
그 구독은 사람이 쓰는 채팅과 같은 통입니다. 열흘 전 문서 카드 배치가 535건에서 한도에 걸린 적이 있어, 배치가 돌면 채팅이 막힌다는 것은 이미 한 번 실측한 뒤였습니다. 이번엔 배치가 아니라 측정이 그 통을 비웠고, 그걸 늦게 알았습니다.
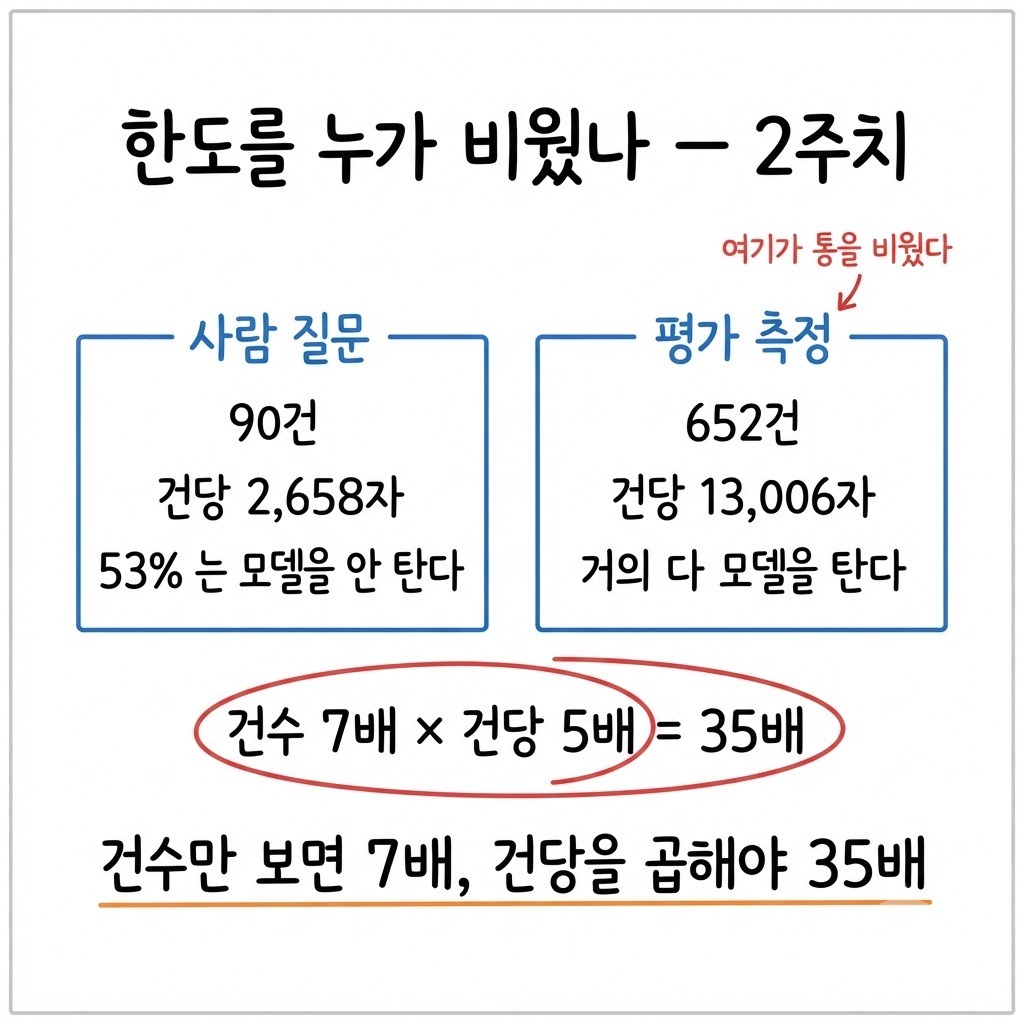
누가 한도를 썼나 — 사람은 2주에 90건이었습니다
한도 안내를 받고 처음 든 생각은 '채팅을 누가 이렇게 많이 썼나'였습니다. 로그를 2주치 세어 보니 사람이 쓴 질문은 90건이었습니다. 건당 입력은 2,658자였습니다. 그중 53% 는 모델을 타지도 않습니다. 목록 조회·참여자 찾기·회의 잡기는 도구가 DB 와 그래프만 읽고 끝납니다.
같은 기간 평가 측정은 652건이었습니다. 건당 입력은 13,006자였습니다. 평가 문항은 어려운 문서 질문만 모아 놓은 것이라 거의 다 모델을 탑니다. 건수로 7배, 건당 입력으로 5배, 곱하면 35배입니다. 한도를 비운 쪽은 사람이 아니라 측정이었습니다.
짐작으로 갔으면 사용자에게 채팅을 줄여 달라는 엉뚱한 안내가 나갔을 겁니다. 로그를 센 덕에 조일 곳이 측정 쪽이라는 것이 먼저 잡혔습니다.
구분 | 2주 건수 | 건당 입력 | 모델을 타는 비율 |
|---|---|---|---|
사람 질문 | 90건 | 2,658자 | 47% |
평가 측정 | 652건 | 13,006자 | 거의 전부 |
건당 입력을 키운 주범은 따로 있었습니다. 정답률을 42.4% 에서 60.3% 로 올리는 동안 답의 근거 칸을 8개에서 24개로 늘렸습니다. 칸마다 문서 원문 1,000자가 실리니 입력이 3배가 됩니다. 정답률을 올린 바로 그 변경이 한도를 당겼습니다.
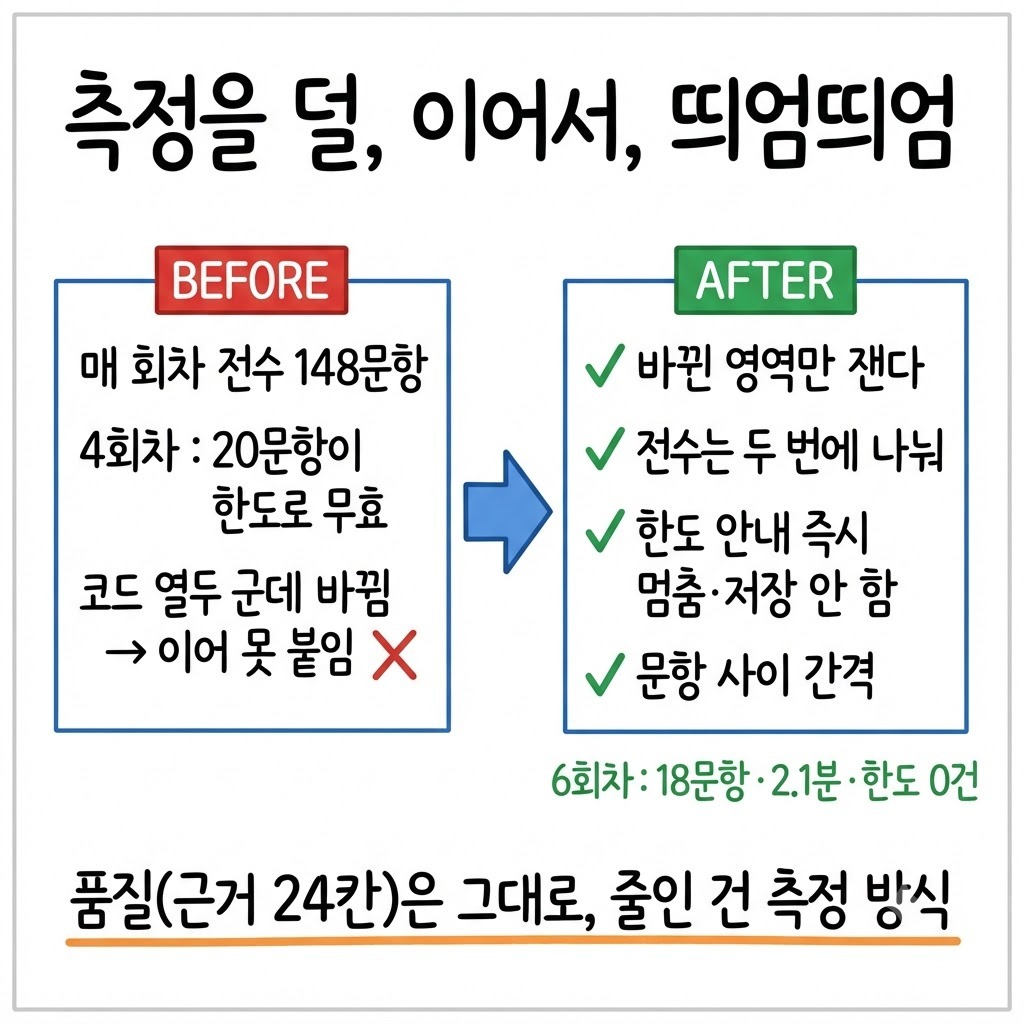
4회차의 빈 20문항은 그대로 버려졌습니다. 그 뒤 코드가 열두 군데 바뀌어, 그 20문항만 나중에 돌려 이어 붙일 수 없었습니다. 한 회차가 통째로 반쪽이 됐습니다.
줄일 곳은 둘이었습니다 — 답의 입력이냐, 측정의 방식이냐
비용을 줄일 자리는 둘로 보였습니다. 하나는 답 하나의 입력을 줄이는 쪽입니다. 근거 24칸을 8칸으로 되돌리거나, 재정렬로 칸 수를 줄이는 안입니다. 다른 하나는 측정의 횟수·범위·리듬을 줄이는 쪽입니다. '24칸은 과하다'는 말이 먼저 그럴듯하게 들려서, 그쪽부터 검증했습니다.
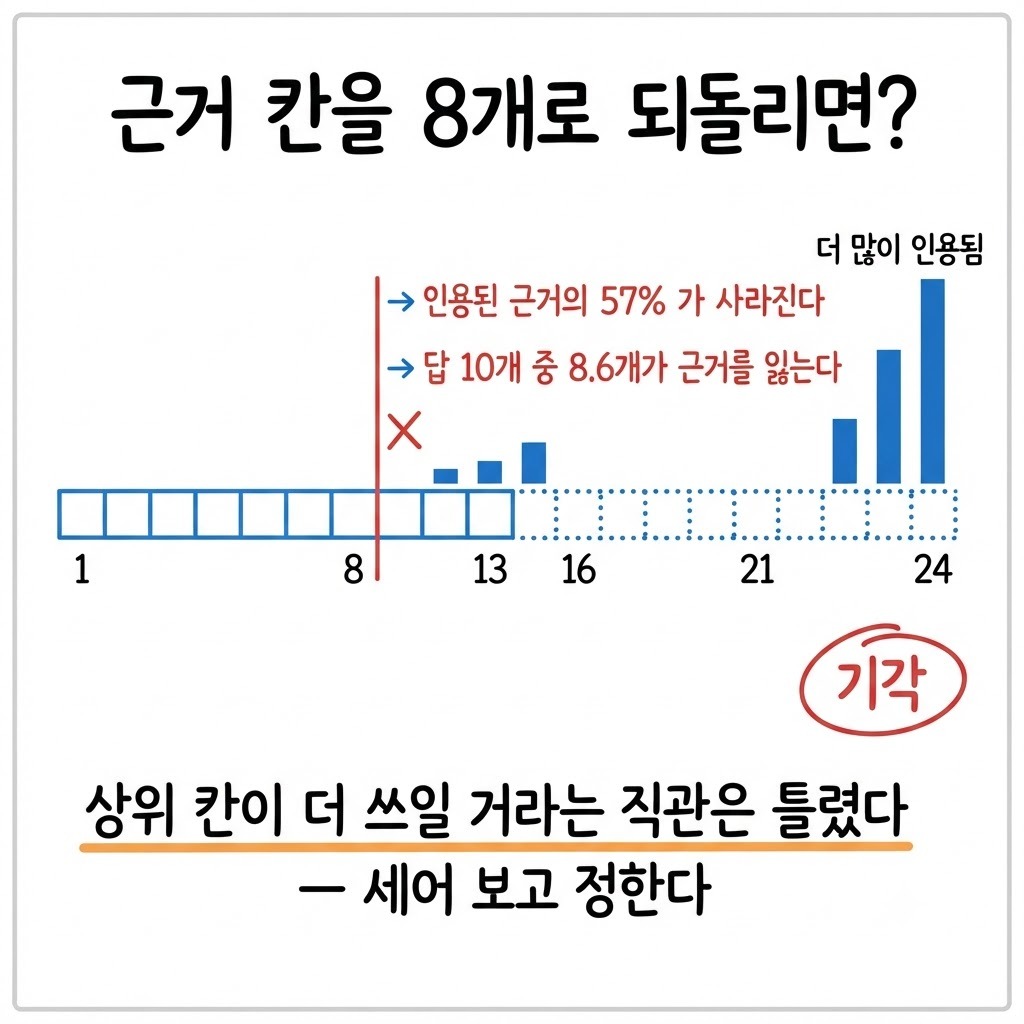
답변 204개의 인용 번호를 세어 봤습니다. 상위 칸이 더 많이 인용될 거라는 직관은 틀렸습니다. 21~24번 칸이 13~16번 칸보다 더 많이 인용됐습니다.
8칸으로 되돌리면 실제 인용된 근거의 57% 가 사라지고, 답 10개 중 8.6개가 근거를 잃습니다. 근거 조각끼리 겹치는 것도 12% 뿐이라 덜어낼 군살이 없었습니다.
재정렬로 칸을 줄이는 안도 시험했습니다. 8칸 기준 정답률이 43% 에서 37.9% 로 내려갔습니다. 지금의 벡터 검색 순서보다 나빴습니다. 답의 입력을 줄이는 안은 둘 다 기각했습니다.
측정을 덜, 이어서, 띄엄띄엄 돌립니다
남은 건 측정 쪽입니다. 기준은 하나였습니다. 코드가 바뀌는 속도가 측정 속도보다 빠르면 전수 측정은 이어 붙일 수 없습니다. 회귀는 바뀐 영역에서 나니, 전수는 마디에서만 확인하면 됩니다. 그 기준으로 넷을 바꿨습니다.
바뀐 영역만 잽니다. 전수 148문항은 큰 마디에서만 돌립니다. 35문항이면 비용이 1/5 이고 5분이면 끝납니다.
전수는 두 번에 나눠 돌립니다. 측정 스크립트가 이미 받은 문항을 건너뛰므로, 그냥 두 번 실행하면 이어집니다.
한도 안내를 받으면 즉시 멈춥니다. 빈 결과를 저장하지 않아야 다음 실행이 그 자리부터 이어받습니다.
문항 사이에 간격을 둡니다. 한도는 시간 창 단위라 몰아치는 쪽이 먼저 걸립니다.
이 넷 중 둘은 측정 스크립트가 문항별로 결과를 저장하는 구조라서 가능했습니다. 한 번에 다 돌리고 마지막에 쓰는 구조였으면 한도에 걸린 순간 전부 잃었을 겁니다.
대응 뒤 6회차는 바뀐 영역 18문항만 2.1분에 돌렸습니다. 한도에 안 걸렸고 내려간 문항은 0건이었습니다. 측정이 사람의 채팅을 막는 일은 다시 없었습니다. 채점 가능한 121문항 환산 정답률은 68.6% 까지 갔습니다.
상위 구독은 답이 아니었습니다
상위 구독으로 올리는 안도 있었습니다. 통이 커질 뿐 사람과 측정이 여전히 한 통을 나눠 씁니다. 측정이 커지는 속도가 통보다 빠르면 같은 자리에서 다시 걸립니다. 구독 등급은 '사람이 쓰는 양'이 모자랄 때 볼 일입니다.
종량제 API 키를 쓰면 이 사건은 '한도'가 아니라 '청구서'로 나타납니다. 통이 안 섞이니 사람이 막히지는 않습니다. 대신 35배가 그대로 돈이 됩니다. '바뀐 영역만 잰다'는 그쪽에서도 그대로 유효합니다.
근거 칸을 못 줄인 건 이 도구의 인용 분포가 그랬기 때문입니다. 상위 칸에 인용이 몰리는 시스템이면 답의 입력을 줄이는 쪽이 맞을 수 있습니다. '많이 주면 좋다'도 '많이 주면 과하다'도 세어 보기 전엔 직관입니다. 이 글의 결론을 옮길 게 아니라 세어 보고 정할 일입니다.
체크리스트
구독 LLM 을 사람과 자동화가 한 통으로 쓰고 있는지 확인합니다. 통이 같으면 배치·측정이 채팅을 막습니다
한도가 걸리면 '누가 썼나'를 건수 × 건당 입력으로 셉니다. 건수만 보면 7배인데 곱하니 35배였습니다
품질 파라미터를 되돌리는 안은 인용 분포부터 셉니다. '상위 칸이 더 쓰인다'는 직관은 여기서 틀렸습니다
측정 스크립트는 문항별로 저장하고, 한도에 걸리면 저장 없이 멈추게 둡니다. 재개가 되어야 한 회차가 안 날아갑니다
전수 측정과 부분 측정을 나눕니다. 회귀는 바뀐 영역에서 나고, 전수는 마디에서만 확인합니다
마무리
구독은 건당 과금이 없을 뿐, 시간 창 단위의 한도가 있습니다. 그 한도는 사람과 자동화가 나눠 쓰고, 통을 비우는 쪽은 대개 사람이 아닙니다. 지금은 쓰는 사람이 적어 사람 쪽이 유난히 가볍기도 합니다. 사용자가 늘면 이 비율은 바뀝니다.
남은 것도 있습니다. 전수 측정을 언제 돌릴지의 '큰 마디' 기준은 아직 감입니다. 그리고 이번에 뒤집힌 전제는 '구독이라 돈이 안 든다' 하나였고, 그 하나가 매 회차 전수 측정이라는 습관을 만들고 있었습니다.
운영자가 가져갈 계측 기준은 한 줄입니다. 한도가 걸리면 사람과 자동화를 갈라, 각각 건수 × 건당 입력으로 셉니다.
연작 '토큰은 어디로 갔나'
이 글은 다섯 편 중 3편입니다. 구독 LLM 을 운영하며 한도·토큰·인증이 어디서 새고 어디서 안 보였는지를 이어서 다룹니다.