밀리초를 자르자 테스트 35개가 버그를 숨겼다
자바(Spring Boot)로 돌던 한 개인 블로그 사이트의 백엔드를 Next.js 로 전량 옮기는 작업이었습니다. 엔드포인트 26개를 옮기면서 옛 구현과 새 구현을 나란히 세우고, 같은 요청을 양쪽에 보내 응답을 비교했습니다. 성적표는 좋았습니다. 차등 테스트 254 케이스가 3회 연속 전건 일치했고, 쓰기 테스트 280개가 통과했습니다.
이 글은 그 성적표 뒤에 있던 결함 하나에 대한 이야기입니다. 공통 코드 한 줄이 생성시각의 밀리초를 잘라내고 있었고, 그 절삭이 테스트의 눈을 가리고 있었습니다. 버그를 일부러 심어도 관련 테스트 35개가 전부 통과했습니다. 테스트가 안 보는 층에 결함이 있었던 게 아닙니다. 테스트는 그 자리를 보고 있었는데, 저장된 값이 구분을 잃어 보이지 않았습니다.
시각 필드가 미세하게 어긋났다
차등 테스트에서 처음 걸린 건 시각 필드였습니다. 같은 글을 조회했는데 옛 구현은 초 단위까지, 새 구현은 마이크로초까지 돌려주고 있었습니다. 값이 틀린 건 아니었습니다. 정밀도가 달랐습니다.
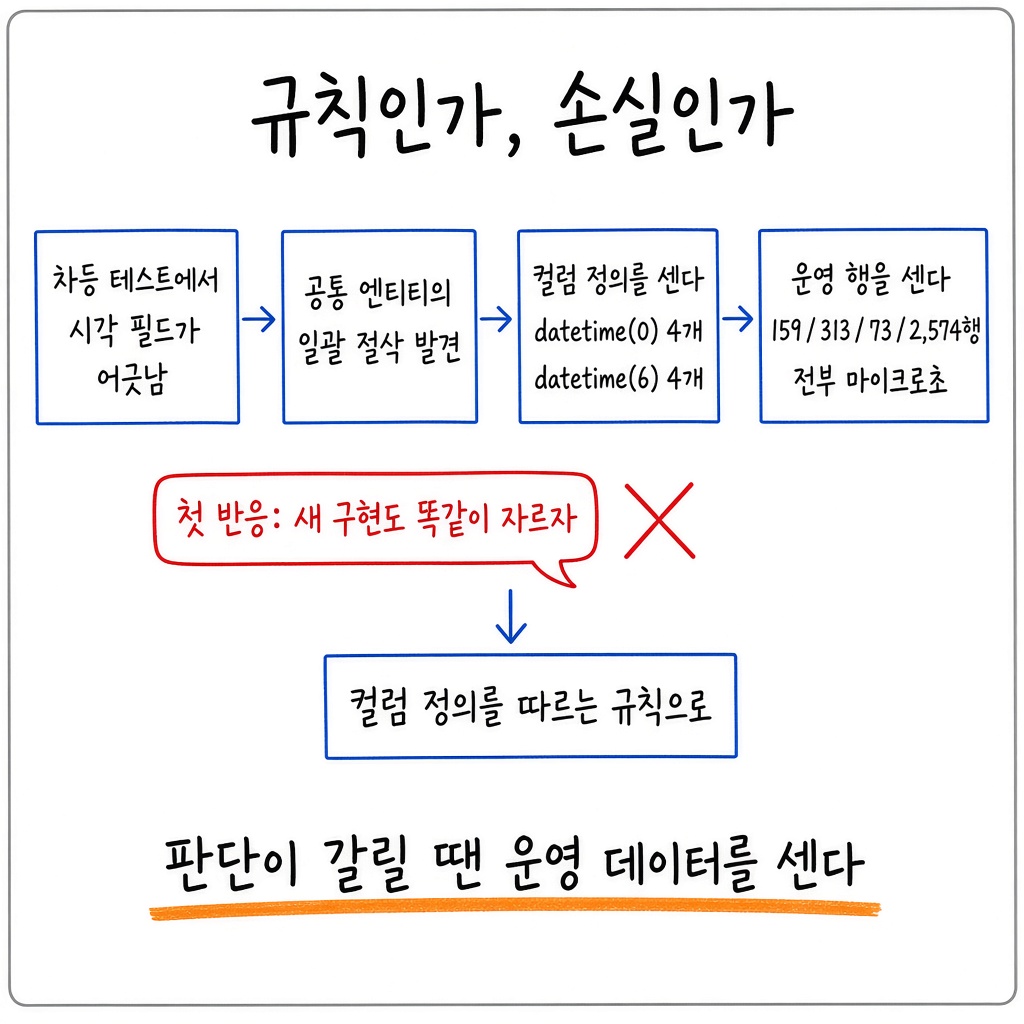
추적해 보니 원인은 자바 쪽 공통 엔티티였습니다. 모든 테이블이 상속하는 부모 클래스가 생성시각·수정시각 같은 감사 컬럼을 저장할 때 밀리초 이하를 잘라내고 있었습니다. 예외 없이 하나의 규칙이었습니다. 처음엔 「이 시스템의 규칙이겠지」로 읽었습니다. 옛 동작을 그대로 이식하면 차등이 사라지니, 새 구현에도 똑같이 절삭을 넣으려 했습니다.
넣기 전에 테이블별 컬럼 정의를 한 번 세어봤습니다. 그게 갈림길이었습니다. 스키마가 두 벌이었습니다.
스키마는 두 벌인데 규칙은 하나였다
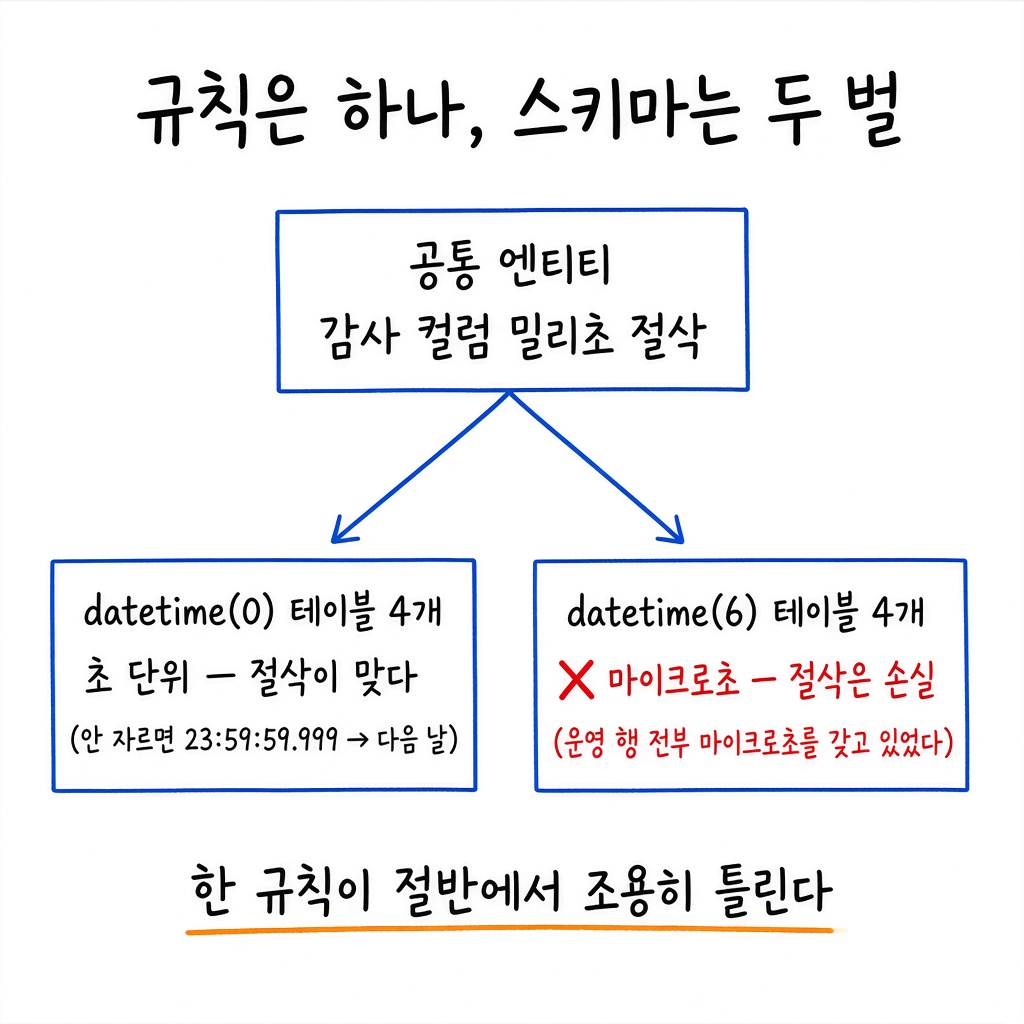
초 단위 컬럼(`datetime(0)`)을 쓰는 테이블 4개 — API 키 테이블, SNS 게시 관련 3종
마이크로초 컬럼(`datetime(6)`)을 쓰는 테이블 4개 — 글·이미지·초안·조회수
초 단위 컬럼은 자르는 쪽이 맞습니다. 안 자르면 MySQL 이 초 이하를 반올림합니다. `23:59:59.999` 가 다음 날 `00:00:00` 이 됩니다. 하루가 통째로 넘어갑니다. 여기서 절삭은 규칙이고, 반올림이 날짜 경계를 넘기는 것을 막는 유일한 방법입니다.
마이크로초 컬럼은 반대입니다. 컬럼이 마이크로초를 받을 수 있는데 저장하는 쪽이 잘라 버리면, 그건 규칙이 아니라 손실입니다. 같은 절삭 한 줄이 절반의 테이블에서는 맞고 절반에서는 틀리고 있었습니다. 에러는 한 번도 나지 않았습니다.
규칙인가 손실인가, 운영 데이터에 물었다
후보는 둘이었습니다.
A. 새 구현도 똑같이 자른다 | B. 컬럼 정의에 맞춰 가른다 | |
|---|---|---|
비용 | 가장 싸다. 옛 동작을 그대로 이식한다 | 테이블마다 정밀도를 확인해야 한다 |
차등 테스트 | 시각 필드의 차이가 바로 사라진다 | 시각 필드의 차이를 설명하고 넘어가야 한다 |
마이크로초 컬럼의 값 | 앞으로도 계속 잘린다 | 원본 정밀도로 저장된다 |
숨은 위험 | 손실까지 정확히 이식된다 | 초 단위 컬럼을 놓치면 반올림이 날짜를 넘긴다 |
판단을 데이터에 물었습니다. 마이크로초 컬럼을 쓰는 네 테이블의 운영 행을 전수 조회했습니다. 159행, 313행, 73행, 2,574행이었습니다. 전 행이 마이크로초를 갖고 있었습니다. 한 행도 예외가 없었습니다.
이 조회 한 번이 A 와 B 를 갈랐습니다. 운영 데이터가 이미 마이크로초로 차 있는데 A 를 고르면, 새 구현은 앞으로 저장하는 값마다 그 정밀도를 지우는 쪽이 됩니다. B 를 채택했습니다. 초 단위 컬럼만 자르고, 마이크로초 컬럼은 받은 값을 그대로 저장합니다. 절삭이 「엔티티 공통 규칙」에서 「컬럼 정의를 따르는 규칙」으로 바뀌었습니다.
정밀도가 돌아오자 숨어 있던 자리가 드러났다
규칙을 바꾸고 나서 확인하고 싶은 게 하나 있었습니다. 발행일시를 다루는 테스트들이 실제로 무엇을 지키고 있는지였습니다. 그래서 버그를 일부러 심었습니다. 「재발행할 때마다 발행일시가 갱신된다」는 변이입니다. 처음 발행한 시각이 유지되어야 하는 자리를, 다시 발행할 때마다 지금 시각으로 덮어쓰게 만들었습니다.
옛 절삭 규칙 아래에서는 관련 테스트 35개가 전부 통과했습니다. 절삭을 걷어낸 새 규칙 아래에서는 같은 변이가 테스트에 걸렸습니다. 심은 버그도 같고 테스트도 같은데, 저장되는 값의 정밀도만 달랐습니다.
이유는 정렬 타이였습니다. 테스트는 빠릅니다. 글 두 개를 만들고 하나를 다시 발행하는 시나리오가 1초 안에 끝납니다. 밀리초를 자르면 그 1초 안에서 일어난 일은 전부 같은 시각이 됩니다. 처음 발행한 시각과 다시 발행한 시각이 같은 값으로 저장되고, 두 글의 생성시각도 같아집니다. 정렬은 타이가 되고, 발행일시가 덮어써졌는지 아닌지를 정렬 결과로는 구분할 수 없습니다.
그러니 변이를 심어도 결과가 안 바뀝니다. 테스트는 「순서가 이래야 한다」를 분명히 확인하고 있었습니다. 다만 절삭이 그 순서를 결정하는 값을 지워 버려서, 맞는 코드와 틀린 코드가 같은 순서를 냈습니다. 가드가 있는 줄 알았는데, 통과시킨 건 테스트가 아니라 데이터의 우연이었습니다.
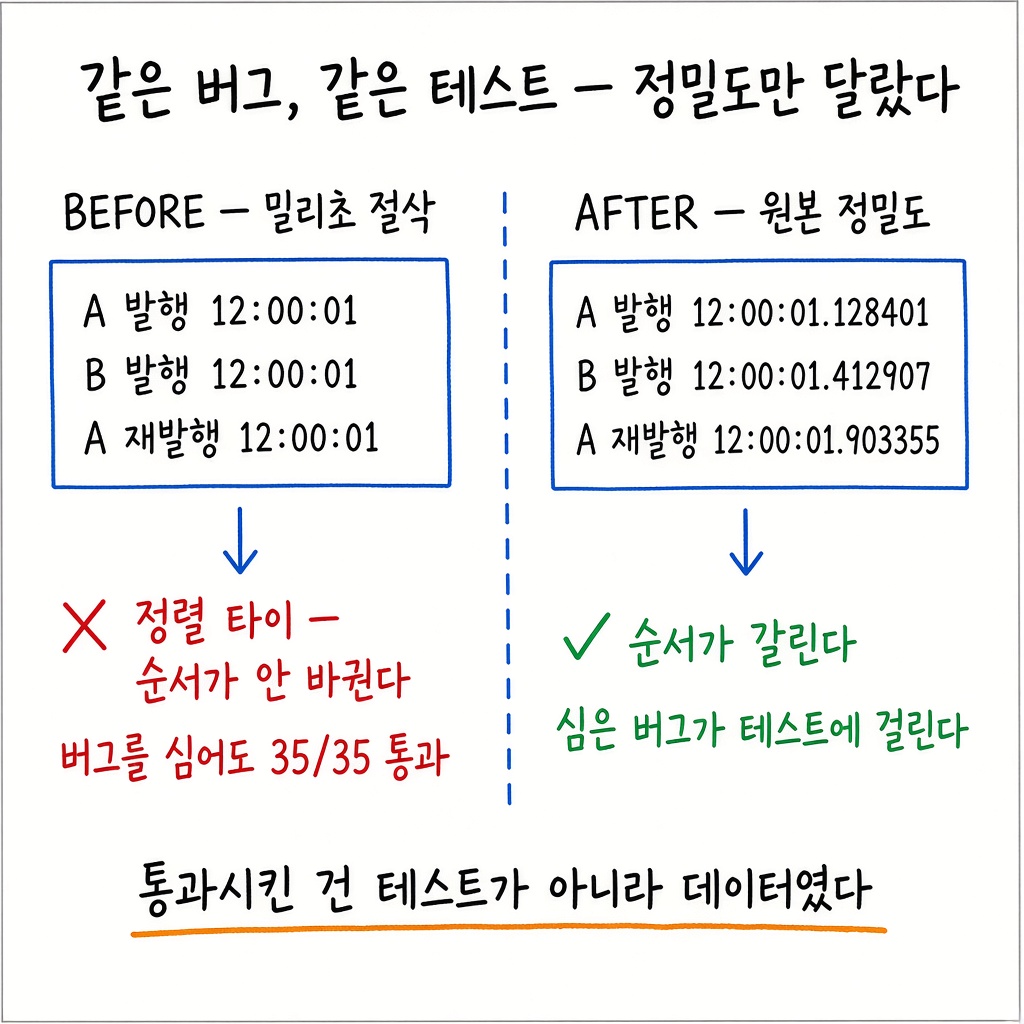
앞 편들에서 다룬 것은 테스트가 안 보는 층이었습니다. 이번은 다릅니다. 테스트는 그 자리를 보고 있었습니다. 공통 코드 한 줄이 비교 대상의 구분을 없애서 눈을 가린 경우입니다. 이 결함은 이관이 아니었으면 나오지 않았을 겁니다. 두 구현을 나란히 세운 것이 검출 장치였고, 한 벌만 있었으면 「테스트 전부 통과」로 계속 살아 있었을 겁니다.
손실이 지우는 것은 값이 아니라 구분이다
밀리초를 잘라도 값은 조금 뭉개질 뿐입니다. 그래서 손실이 작아 보입니다. 그런데 그 손실이 없애는 건 값의 크기가 아니라 「이 행과 저 행이 다르다」는 성질입니다. 유일성이 사라지면 정렬만 흔들리는 게 아닙니다. 중복 판정, 증분 커서, 페이징 커서가 같은 값에 기대고 있습니다. 손실의 크기가 아니라 손실이 없애는 성질을 봐야 판단이 섭니다.
같은 이유로 「테스트가 통과했다」는 「코드가 맞다」와 같은 말이 아닙니다. 「이 데이터에서는 안 갈렸다」일 수 있습니다. 통과의 이유를 코드가 아니라 데이터가 대주는 경우가 있고, 그때 초록불은 아무것도 보증하지 않습니다.
반대로 읽으면 안 되는 지점도 있습니다. 「정밀도는 언제나 살려라」가 아닙니다. 초 단위 컬럼에서는 자르는 게 맞고, 안 자르면 반올림이 날짜를 넘깁니다. 그리고 정렬 타이는 정밀도로 푸는 문제가 아닙니다. 근본 해법은 고유 ID 같은 2차 정렬키이고, 정밀도는 타이가 날 확률을 낮출 뿐입니다. 초당 생성량이 늘면 마이크로초에서도 타이가 납니다.
점검 항목
옛 구현을 옮기거나 공통 규칙이 여러 테이블에 걸려 있을 때, 한 번 세어볼 것들입니다.
공통 엔티티의 시각 처리 규칙이 걸리는 테이블의 컬럼 정밀도가 한 벌인지 세어봤는가
「이 동작이 규칙인가 손실인가」를 운영 데이터로 확인했는가. 조회 한 번이면 갈린다
정렬·중복 판정·커서가 시각 컬럼의 유일성에 기대고 있는가. 2차 정렬키가 있는가
가드라고 믿는 테스트에 버그를 일부러 심어봤는가. 전부 통과하면 통과시키는 건 데이터다
전수 확인이 가능한 규모인가. 표본으로 바꾸는 순간 「전부」라고 쓸 수 없다
마무리
이관은 차등 254 케이스 전건 일치 3회 연속, 쓰기 280 통과, 실행 전후 9개 테이블 행 수 동일로 마감했습니다. 그 숫자는 그대로였고, 그 뒤에 있던 절삭 한 줄만 컬럼 정의를 따르는 규칙으로 바뀌었습니다.
남은 건 확인 방법 하나입니다. 가드가 진짜 지키고 있는지 의심되는 자리에는 버그를 심어봅니다. 심었는데도 전부 통과하면, 그 테스트를 통과시키고 있는 건 코드가 아니라 데이터입니다. 모든 테스트에 걸 수는 없으니, 의심되는 자리에 선별해서 겁니다.
연작 「초록불이 거짓말한다」
이 글은 다섯 편 중 4편입니다. 테스트가 전부 통과했는데 실제로는 아무것도 지켜주지 않았거나 운영을 부순 사례를 이어서 다룹니다.